Khi viết mã không còn là nút thắt, đội phần mềm phải tổ chức lại cách lập kế hoạch và kiểm thử
Trong hơn nửa thế kỷ, mọi quy trình phát triển phần mềm, từ mô hình thác nước đến Agile hay Scrum, đều được thiết kế quanh một giả định ngầm: viết code là công đoạn đắt đỏ và chậm nhất. Vì code đắt, chúng ta lập kế hoạch kỹ, viết tài liệu yêu cầu dày, ước lượng story point, họp refinement, rồi cẩn trọng duyệt từng dòng trước khi phát hành. Mỗi cánh cổng phê duyệt tồn tại để tránh lãng phí vài tuần, vài tháng công sức lập trình.
Giả định đó đang sụp đổ. Tại Anthropic, Claude hiện viết khoảng 80% lượng code được merge vào codebase, và kỹ sư trung bình phát hành lượng code mỗi quý gấp 8 lần so với giai đoạn 2021–2025 (Clinton, 2026). Tại Intercom, hơn 93% pull request ở hai codebase chính do agent dẫn dắt (Mykhailov & Young, 2026). Khi phần “xây” co lại từ vài tuần xuống vài giờ, những công đoạn xung quanh nó, gồm lập kế hoạch, review, kiểm thử, phê duyệt và vận hành, bỗng trở thành nơi thời gian bị nuốt mất.
Đó là bối cảnh ra đời của khái niệm AI-Native SDLC (vòng đời phát triển phần mềm thuần AI), còn được gọi là agentic SDLC hay AI SDLC. Ngày 21/8/2026, nhóm Applied AI của Anthropic công bố bản hướng dẫn thực hành chi tiết cho mô hình này, đi qua sáu giai đoạn Plan, Design, Build, Test, Deploy và Maintain (Claxton, 2026). Thông điệp trung tâm rất rõ: dùng AI để viết code nhanh hơn là chưa đủ; toàn bộ quy trình bao quanh code cũng phải được tái thiết kế với cùng mức độ.
Bài viết này đi sâu vào bản playbook đó, đối chiếu với dữ liệu nghiên cứu độc lập và các trường hợp triển khai thực tế tại Anthropic, Intercom, CircleCI, Rakuten và FPT Software. Mục tiêu là giúp lãnh đạo kỹ thuật, kiến trúc sư phần mềm và đội ngũ sản phẩm hiểu không chỉ cái gì thay đổi, mà còn vì sao và bắt đầu từ đâu.
Bài viết gồm mười mục. Mục 1 phân tích nghịch lý năng suất khi AI viết mã. Mục 2 giới thiệu khái niệm AI-Native SDLC và sáu dịch chuyển cốt lõi. Các mục 3 đến 8 đi lần lượt qua sáu giai đoạn Plan, Design, Build, Test, Deploy và Maintain. Mục 9 bàn về bảo mật và quản trị, và mục 10 đề xuất lộ trình triển khai, kèm gợi ý cho doanh nghiệp Việt Nam. Một số thuật ngữ sẽ được dùng xuyên suốt: SDLC (software development life cycle) — vòng đời phát triển phần mềm; agent — tác nhân AI tự thực hiện chuỗi hành động; artifact — sản phẩm trung gian được lưu lại (tài liệu, code, kết quả kiểm thử); commit — lưu một thay đổi vào hệ thống quản lý phiên bản (git); pull request (PR) — đề nghị đưa một thay đổi vào mã nguồn chính, kèm review; CI/CD — tự động kiểm thử và triển khai.
Đọc số liệu một cách thận trọng. Playbook và phần lớn số liệu triển khai trong bài do chính các doanh nghiệp công bố: Anthropic là nhà cung cấp công cụ AI được nói tới, Intercom và FPT Software mô tả kết quả của chính họ. Những số liệu này hữu ích để hiểu điều có thể làm được, nhưng chưa phải bằng chứng độc lập. Vì vậy bài đặt chúng cạnh các nghiên cứu độc lập (DORA, Stack Overflow, Faros AI, METR) ở mục 1.
1. Nghịch lý năng suất: code nhanh hơn, phần mềm không đến tay người dùng nhanh hơn
Trước khi bàn về giải pháp, cần nhìn thẳng vào một nghịch lý mà dữ liệu năm 2025 đã phơi bày: mức độ sử dụng AI trong lập trình gần như phổ quát, nhưng hiệu quả ở cấp tổ chức lại không tăng tương xứng.
AI đã có mặt ở khắp nơi. Báo cáo DORA 2025 của Google Cloud, khảo sát gần 5.000 chuyên gia công nghệ, cho thấy 90% người trả lời dùng AI trong công việc, tăng 14% so với năm trước (Google, 2025). Khảo sát Stack Overflow 2025 với hơn 49.000 lập trình viên ghi nhận 84% đang dùng hoặc dự định dùng công cụ AI, tăng từ 76% của năm 2024 (Stack Overflow, 2025).
Nhưng niềm tin lại đi ngược chiều. Cũng theo Stack Overflow, số lập trình viên chủ động không tin độ chính xác của AI (46%) đã vượt số người tin (33%), và chỉ khoảng 3% “rất tin tưởng” kết quả. Người càng nhiều kinh nghiệm càng thận trọng. DORA cũng ghi nhận khoảng 30% người trả lời có ít hoặc không có niềm tin vào code do AI sinh ra (Google Cloud, 2025).
Năng suất cá nhân không tự động thành năng suất hệ thống. Nghiên cứu của Faros AI trên dữ liệu đo lường từ hơn 10.000 lập trình viên thuộc 1.255 nhóm cho thấy: nhóm dùng AI nhiều hoàn thành thêm 21% đầu việc và merge thêm 98% pull request, nhưng thời gian review PR tăng 91%. Faros gọi đây là “nghịch lý năng suất AI”, với nút thắt nằm ở khâu phê duyệt của con người (Faros AI, 2025).
Thử nghiệm ngẫu nhiên có đối chứng của METR còn gây bất ngờ hơn. Với 16 lập trình viên mã nguồn mở giàu kinh nghiệm làm 246 tác vụ thật trên những dự án họ rất quen thuộc, việc được phép dùng AI khiến thời gian hoàn thành dài hơn 19%. Điều đáng chú ý là sau thí nghiệm, chính họ vẫn ước tính AI giúp mình nhanh hơn khoảng 20% (Becker et al., 2025). Kết quả này cần được đọc thận trọng: mẫu nhỏ, công cụ đầu năm 2025, và chính METR sau đó đã thay đổi thiết kế thí nghiệm vì ngày càng nhiều lập trình viên từ chối làm việc không có AI, khiến ước tính bị lệch (METR, 2026). Dù vậy, khoảng cách giữa cảm giác nhanh và thực sự nhanh là một lời cảnh báo nghiêm túc.
DORA tóm gọn tất cả trong một nhận định: AI không sửa chữa một đội ngũ; nó khuếch đại những gì đã có sẵn. Tổ chức có nền tảng tốt sẽ tăng tốc, còn tổ chức có quy trình yếu sẽ thấy điểm yếu bị phóng to ở hạ nguồn (Google Cloud, 2025).
Đây chính là luận điểm xuất phát của AI-Native SDLC. Theo Claxton (2026), khi code không còn là nút thắt, ba điều xảy ra đồng thời. Thứ nhất, nút thắt dịch sang hai bên của khâu Build: lập kế hoạch, review/kiểm thử và triển khai vẫn chạy ở “tốc độ con người”. Thứ hai, các cơ chế kiểm soát không còn khớp với thực tế, vì việc review từng dòng bằng tay chỉ hợp lý khi một người viết từng dòng. Thứ ba, chi phí quản trị tăng vọt vì mọi ngoại lệ vẫn phải chờ những hội đồng họp hàng tuần hoặc hàng tháng.
Một ví dụ dễ hình dung là đội bảo mật. Đội này được định biên theo sản lượng của con người. Khi agent nhân sản lượng code lên nhiều lần, hoặc hàng đợi review dồn ứ, hoặc code được phát hành khi chưa được rà soát đủ. Một ngân hàng hay công ty bảo hiểm không thể chấp nhận cả hai kết cục, nên các kiểm soát bảo mật buộc phải chạy kịp tốc độ của agent.
2. AI-Native SDLC là gì?
AI-Native SDLC là một quy trình được thiết kế lại, giữ nguyên các mục tiêu kiểm soát cũ nhưng thay đổi cách thực thi chúng. Thay vì một dòng chảy tuyến tính từ yêu cầu đến vận hành, quy trình trở thành một vòng lặp, trong đó AI được nhúng vào từng điểm và việc chuyển giao giữa các giai đoạn được tự động hóa (Claxton, 2026).
Để thấy rõ sự khác biệt, hãy nhớ lại SDLC truyền thống. Mỗi giai đoạn là một pha riêng do một vai trò riêng sở hữu: product manager viết yêu cầu, kiến trúc sư chuyển thành thiết kế, kỹ sư xây dựng, đội QA kiểm định, đội release phát hành và đội vận hành giám sát. Công việc di chuyển giữa các pha qua tài liệu, ticket và chữ ký phê duyệt. Mỗi lần chuyển giao là một lần thông tin bị rơi rớt, và mỗi chữ ký là một lần chờ đợi.
2.1. Sáu dịch chuyển cốt lõi
Bảng 1 tóm lược hai đầu của phổ chuyển đổi theo playbook của Anthropic. Phần lớn tổ chức hiện nằm đâu đó giữa hai cột.
Bảng 1. Sáu giai đoạn trong SDLC truyền thống và AI-Native SDLC
| Giai đoạn | SDLC truyền thống | AI-Native SDLC |
|---|---|---|
| Plan | Yêu cầu được thu thập qua hội đồng, workshop, chữ ký; viết tay | Claude tổng hợp vấn đề trực tiếp từ nguồn và ghi vào intent.md, vừa người đọc được vừa máy hành động được |
| Design | Analyst viết đặc tả, designer diễn giải lại | Yêu cầu và thiết kế gộp vào một phiên làm việc với agent, theo chuẩn mực mã hóa thành skills, quản lý bằng git |
| Build | Viết tay code và test; tài liệu viết sau | AI sinh code và test; tri thức tổ chức nằm trong CLAUDE.md và skills có phiên bản |
| Test | Cổng QA ở ranh giới giai đoạn | Eval liên tục đan xen trong suốt quá trình triển khai |
| Deploy | Người review từng dòng; quản trị qua các chu kỳ duyệt, thiếu nhất quán | Nhiều lớp review bằng agent; người review phần quan trọng và chịu quản lý; hook làm cổng phê duyệt |
| Maintain | Con người canh lỗi trên production | Agent giám sát; vi phạm ngưỡng kiểm soát được chẩn đoán và quay lại vòng lặp dưới dạng intent.md mới |
Nguồn: dựa trên Claxton (2026).
2.2. Sợi chỉ xuyên suốt: chuỗi artifact được commit
Điểm tinh tế nhất của mô hình nằm ở cột bên phải: mỗi giai đoạn kết thúc bằng việc commit một artifact vào hệ thống quản lý phiên bản, và giai đoạn kế tiếp bắt đầu bằng việc đọc artifact đó. Chuỗi này gồm intent.md (ý định), spec.md (đặc tả), plan.md (kế hoạch triển khai), bản diff cùng test, pull request kèm kết quả review, và hồ sơ sự cố.
Ở các giai đoạn đầu, file Markdown chiếm ưu thế vì cả product owner lẫn agent đều đọc và hành động được trên cùng một file. Từ Build trở đi, artifact là code và các bản ghi của nó. Quan trọng hơn, chuỗi commit này chính là dấu vết kiểm toán: ai yêu cầu gì, agent tạo ra gì, ai phê duyệt. Với các ngành chịu quản lý chặt như ngân hàng, bảo hiểm hay y tế, đây là điểm khiến mô hình khả thi về mặt tuân thủ.
Cơ chế kích hoạt cũng nối liền các giai đoạn: một intent.md được chấp nhận sẽ kích hoạt bước soạn yêu cầu và thiết kế; một spec.md được duyệt kích hoạt plan mode; một PR được merge kích hoạt pipeline; và một ngưỡng kiểm soát bị vượt trên production sẽ tự viết ra intent.md tiếp theo. Hình 1 trình bày toàn bộ vòng lặp sáu giai đoạn cùng artifact mà mỗi giai đoạn để lại. Ban đầu, đội ngũ kích hoạt từng bước bằng tay. Trạng thái đích là một vòng lặp tự vận hành, nơi sự chú ý của con người tập trung ở các cổng, xem xét những gì agent đã gắn cờ thay vì khởi động từng giai đoạn từ đầu.
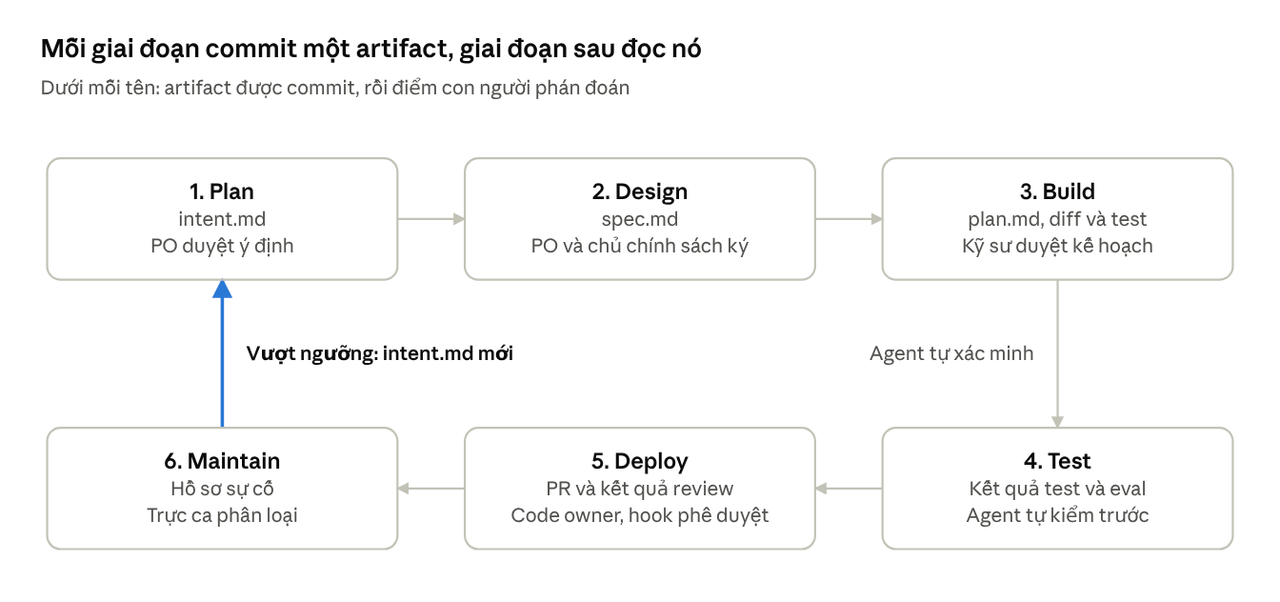
Hình 1. Vòng lặp sáu giai đoạn của AI-Native SDLC. Nguồn: dựa trên Claxton (2026).
Trong Hình 1, đường quay lại từ Maintain về Plan là điểm phân biệt mô hình này với SDLC tuyến tính: sự cố trên production tự sinh ra ý định tiếp theo.
2.3. Con người vẫn chịu trách nhiệm
Một hiểu lầm phổ biến là AI-Native đồng nghĩa với “để máy tự làm”. Playbook khẳng định điều ngược lại: con người vẫn chịu trách nhiệm cho mọi quyết định cần phán đoán. Điều thay đổi là vị trí của sự chú ý. Thay vì đọc từng dòng diff, con người xem xét ý định, đặc tả, kế hoạch và các phát hiện được xếp hạng theo mức độ nghiêm trọng.
Playbook cũng nhấn mạnh tính mô-đun. Mỗi “play” (cách làm cụ thể) mô tả điều gì thay đổi, cách bắt đầu, các bước triển khai, lưu ý quản trị và cách đo lường thành công, kèm danh sách điều kiện tiên quyết. Tổ chức có thể chọn chuyển đổi giai đoạn nào trước tùy nhu cầu, miễn tôn trọng thứ tự phụ thuộc.
3. Giai đoạn Plan: ý tưởng không còn phải chờ người viết hộ
Trong SDLC truyền thống, một ý tưởng phải đi qua backlog, user story, story point và các buổi refinement trước khi bất kỳ ai hành động. Mỗi lần chuyển giao, quyền sở hữu đổi tay, nên thứ đến được tay kỹ sư thường đã cách xa điều người khởi xướng thực sự muốn nói. Nhân viên vận hành có ý tưởng hay vẫn phải thuyết phục một product manager viết lại giúp.
AI-Native SDLC thay đổi điều này bằng một artifact đơn giản: intent.md. Người khởi xướng, có thể là một chuyên viên nghiệp vụ không biết lập trình, trò chuyện với Claude bằng ngôn ngữ của chính họ. Claude đặt những câu hỏi mà một business analyst sẽ hỏi: phạm vi, người dùng, ràng buộc, thế nào là thành công. Kết quả là một “bản đặc tả sơ khởi” (proto-spec) nêu rõ điều gì được mong muốn, vì sao, và trong những ràng buộc nào (Claxton, 2026).
intent.md có thể đến từ ba con đường: một người có ý tưởng, một ticket được tạo, hoặc một cảnh báo sự cố từ giai đoạn Maintain. Dù đến từ đâu, product owner luôn rà soát và chỉnh sửa trước khi commit.
3.1. Ví dụ minh họa: ngân hàng bán lẻ tại Việt Nam
Giả sử một chuyên viên phòng dịch vụ khách hàng tại một ngân hàng thương mại nhận thấy tổng đài bị quá tải mỗi khi khách gọi hỏi tình trạng hồ sơ vay. Thay vì gửi email đề xuất và chờ cuộc họp quý, cô mở Claude, mô tả vấn đề, trả lời vài câu hỏi làm rõ, rồi nhận được file sau:
# Intent: Tra cứu trạng thái hồ sơ vay trên app
Tác giả: N. T. Lan (Trung tâm dịch vụ khách hàng). Trạng thái: nháp.

## Vấn đề
Khách hàng gọi tổng đài để hỏi hồ sơ vay đang ở bước nào.
Nhóm tổng đài ước tính phần lớn cuộc gọi về vay chỉ hỏi trạng thái.

## Kết quả mong muốn
Khách thấy trạng thái hồ sơ, bước tiếp theo và ngày dự kiến ngay trên app.

## Người dùng và hệ thống bị ảnh hưởng
Khách vay cá nhân, chuyên viên tín dụng, app mobile banking, LOS API.

## Ràng buộc
Không hiển thị thêm dữ liệu cá nhân; dùng xác thực sinh trắc hiện có.

## Câu hỏi mở
Đối tác thẩm định tài sản có cần quyền xem không?
Cô tự sửa những chỗ Claude hiểu sai, sau đó Claude commit file vào thư mục intent/ của repo sản phẩm thông qua connector GitHub. Cô không cần biết git. Tác giả và thời điểm được ghi lại tự động, và product owner nhận ý tưởng từ đó.
3.2. Điều kiện để triển khai
Play này không có điều kiện tiên quyết, nên đây thường là điểm khởi đầu dễ nhất. Đội platform chỉ cần làm một lần: quyết định “ngôi nhà” cho intent (với một sản phẩm, thư mục intent/ trong repo là đủ; repo riêng chỉ đáng khi intent trải rộng nhiều repository), thống nhất một template, và đóng gói template thành skill để mọi người dùng nhất quán.
3.3. Đo lường
Chỉ số dẫn dắt là thời gian từ cuộc trò chuyện đầu tiên đến khi intent.md được commit, đọc trực tiếp từ lịch sử git. Kỳ vọng là rút từ chu kỳ khơi gợi yêu cầu kéo dài nhiều tuần xuống còn vài giờ. Chỉ số kết quả là “tỷ lệ sống sót”: bao nhiêu phần trăm intent.md được product owner chấp nhận chuyển sang Design, và bao nhiêu lần intent phải sửa sau khi spec.md đầu tiên đã được commit.
Tinh thần này khớp với cách đội Claude Code tại Anthropic đã bỏ lộ trình sáu tháng để chuyển sang “lập kế hoạch đúng lúc” (just-in-time planning): làm prototype, cho người dùng nội bộ dùng thử và hành động theo phản hồi. Giám đốc kỹ thuật Fiona Fung kể rằng lộ trình sáu tháng viết lúc cô mới gia nhập đã lỗi thời ngay từ tháng thứ ba (Anthropic, 2026a).
4. Giai đoạn Design: yêu cầu và thiết kế gộp vào một phiên
Mô hình truyền thống tách yêu cầu và thiết kế thành hai pha do hai nhóm khác nhau phụ trách. Analyst chuẩn hóa ý tưởng thành tài liệu yêu cầu, rồi designer đọc lại và chuyển thành thiết kế. Sự tách biệt này tồn tại vì trách nhiệm giải trình, nhưng nó chậm và làm thất thoát ngữ cảnh.
Trong AI-Native SDLC, khi intent.md đã được chấp nhận, Claude dùng nó để soạn ra một bản đặc tả yêu cầu và thiết kế (spec.md) trong một phiên duy nhất. Điểm then chốt là phiên này chạy với skills của tổ chức được nạp sẵn: chuẩn thương hiệu, chính sách bảo mật, yêu cầu tuân thủ, nguyên tắc UX. Nhờ vậy, chính sách được áp dụng ngay khi viết đặc tả, thay vì bị phát hiện trong một buổi review vài tuần sau (Claxton, 2026).
Product owner rà soát đặc tả nhưng không phải viết nó. Lời nhắc (prompt) mẫu trong playbook yêu cầu Claude đọc intent, áp dụng các skill hiện có để đặc tả tuân thủ chuẩn thương hiệu, bảo mật và UX, rồi nêu rõ mọi điểm đáng lo ngại, đặc biệt những chỗ các chính sách mâu thuẫn nhau. Phần “điểm đáng lo ngại” chính là những gì một analyst giỏi sẽ báo lên cấp trên.
4.1. Quy trình thực hiện
Quy trình gộp yêu cầu và thiết kế vào một phiên làm việc gồm các bước sau.
- Product owner mở phiên làm việc có sẵn skills của tổ chức và đính kèm
intent.md. - Lúc đầu chạy prompt bằng tay; sau đó đóng gói thành một slash command cấp tổ chức; cuối cùng tự động hóa để việc merge
intent.mdkích hoạt một job không tương tác, sinhspec.mddưới dạng pull request. - Product owner đối chiếu đặc tả với ý tưởng ban đầu: đặc tả có giải quyết đúng vấn đề không, các câu hỏi mở đã được trả lời hay chuyển tiếp chưa?
- Xử lý trước các điểm bị gắn cờ, mỗi điểm với chủ sở hữu chính sách tương ứng, trước khi kỹ sư nhìn thấy đặc tả.
- Commit
spec.mdbên cạnhintent.md. Cặp file ghi lại điều được yêu cầu và điều được quyết định. - Một con người luôn đưa ra quyết định chuyển sang Build; với hạng mục rủi ro cao, cần tham vấn trưởng nhóm kỹ thuật.
Với công việc front-end, product owner có thể dựng mockup trong Claude Design từ chính intent.md, lặp lại vài vòng rồi xuất sang Claude Code để xây dựng. Fiona Fung mô tả việc product manager ở đội Claude Code giờ tự viết code khá nhiều, còn kỹ sư nhận thêm việc về nội dung và thiết kế; ranh giới vai trò đang mờ dần (Anthropic, 2026a).
4.2. Quay lại ví dụ ngân hàng
Với intent “Tra cứu trạng thái hồ sơ vay”, skill bảo mật của ngân hàng có thể yêu cầu mọi API ra ngoài phải qua API gateway và ẩn số CMND/CCCD trong log. Skill tuân thủ có thể nhắc đến yêu cầu bảo vệ dữ liệu cá nhân. Nếu skill UX yêu cầu hiển thị tên chuyên viên phụ trách để tăng tin cậy, còn skill bảo mật hạn chế lộ thông tin nhân sự, Claude sẽ gắn cờ mâu thuẫn này ngay trong spec.md để product owner làm việc với hai chủ sở hữu chính sách. Trước đây, xung đột kiểu này thường chỉ lộ ra ở buổi security review cuối cùng.
4.3. Đo lường
Chỉ số dẫn dắt là khoảng thời gian giữa commit intent.md và commit spec.md của cùng một thay đổi, so với chu kỳ yêu cầu cộng thiết kế cũ. Chỉ số kết quả là lượng sửa đổi yêu cầu sau khi Build đã bắt đầu, tức số commit spec.md có ngày sau commit plan.md đầu tiên. Cả hai đều lấy trực tiếp từ git log.
5. Giai đoạn Build: không gì được viết khi chưa có kế hoạch được duyệt
Build là nơi AI đã thay đổi nhiều nhất, nhưng cũng là nơi dễ sinh ảo tưởng nhất. Playbook của Anthropic đặt ra năm “play” cho giai đoạn này, và điểm chung của chúng là biến tri thức ngầm thành file mà agent đọc được, biến thói quen thành quy tắc chạy bằng code (Claxton, 2026).
5.1. Plan mode làm điểm xuất phát mặc định
Trước đây, kỹ sư đọc thiết kế rồi bắt tay vào viết code. Cách thay đổi sẽ được thực hiện, file nào, test nào, nằm trong đầu kỹ sư hoặc may ra trong một bình luận ticket. Người review chỉ thấy kết quả cuối cùng là bản diff, và lúc đó làm lại thì đã chậm.
Trong AI-Native SDLC, kỹ sư mở Claude Code ở plan mode, chế độ mà Claude được đọc codebase nhưng không được sửa bất cứ thứ gì. Kỹ sư đưa intent.md và spec.md, yêu cầu một kế hoạch nêu rõ file nào thay đổi, thứ tự công việc, và test nào chứng minh kết quả. Sau đó, kỹ sư “tra hỏi” kế hoạch: thay đổi này có thể làm hỏng gì, bước nào rủi ro nhất, có phương án nào Claude đã cân nhắc nhưng không chọn?
Tiêu chí dừng lặp rất cụ thể: một kỹ sư chưa từng xem cuộc hội thoại vẫn có thể triển khai thay đổi chỉ từ bản kế hoạch. Khi đạt, kế hoạch được commit thành plan.md và trở thành căn cứ để review đối chiếu với bản diff về sau. Với một kế hoạch vững, phần triển khai thường hoàn tất trong một lượt. Nếu thực tế lệch khỏi kế hoạch, plan.md phải được cập nhật trong cùng commit, và có thể dùng hook để ép buộc sự đồng bộ này.
Giá trị quản trị ở đây là việc review thiết kế diễn ra trước khi có dòng code nào, khi đổi hướng chỉ tốn công sửa một tài liệu. Khi các rào chắn đã trưởng thành, đội ngũ có thể chuyển sang auto mode cho việc thường nhật: kỹ sư duyệt kế hoạch, rồi Claude áp từng thay đổi mà không cần hỏi lại. Sự chú ý của con người dịch từ việc canh từng thao tác sang việc review artifact sau các phiên tự chủ dài hơn.
5.2. CLAUDE.md: tài liệu nhập môn cho đồng nghiệp AI
CLAUDE.md cung cấp cho Claude những gì một nhân viên mới cần biết trong ngày đầu: quy ước, lệnh build và test, kiến trúc, và những lỗi đội hay gặp. Tri thức vốn nằm trong đầu người hoặc rải rác trên wiki trở thành một file agent đọc ở đầu mỗi phiên, được cả đội cùng duy trì.
Cách bắt đầu: chạy /init để Claude sinh bản nháp từ codebase, cắt gọn còn những gì thực sự cần, commit vào gốc repo để cả đội dùng chung một phiên bản và review thay đổi như review code. Quy tắc làm việc đáng nhớ: khi Claude mắc cùng một lỗi lần thứ hai, cách sửa được ghi vào CLAUDE.md. Giữ file dưới một trang, vì Claude đọc toàn bộ ở đầu phiên và nội dung lỗi thời chỉ chiếm chỗ ngữ cảnh. Ví dụ cho một dịch vụ thanh toán:
# Dịch vụ thanh toán

## Lệnh
- Build: make build · Test: make test · Lint: make lint

## Quy ước
- Tiền luôn dùng BigDecimal, không bao giờ dùng double.
- Số tiền VND không có phần thập phân; làm tròn theo quy định nội bộ.
- Mọi endpoint cần một integration test trong src/itest.

## Những điều Claude hay làm sai
- Không tự nâng phiên bản thư viện; đội platform quản lý việc này.
- Gói legacy v1/ đã đóng băng; thay đổi chỉ đưa vào v2/.
Chỉ số đo lường gồm tần suất Claude lặp lại lỗi mà CLAUDE.md lẽ ra phải ngăn, và thời gian để một thành viên mới có PR đầu tiên được merge. Đội Claude Code cho biết kỹ sư mới giờ đã ship code thật ngay trong tuần đầu tiên (Anthropic, 2026a).
5.3. Skills: tri thức tổ chức có thể vận hành
Nếu CLAUDE.md là ghi chú của một repo, thì skill là cách tổ chức đóng gói tri thức phải được áp dụng nhất quán ở mọi nơi: chuẩn bảo mật API, quy ước thiết kế, quy định thương hiệu. Một skill là một thư mục chứa file SKILL.md, phần đầu mô tả khi nào nó được kích hoạt, phần thân mô tả cần làm gì. Skill có thể nằm trong repo tại .claude/skills/ hoặc được phân phối toàn tổ chức qua plugin. Khi chính sách thay đổi, chủ sở hữu chính sách ký duyệt bản cập nhật skill, và mọi kỹ sư tự động nhận phiên bản mới ở phiên làm việc kế tiếp.
Playbook nhấn mạnh một điểm tinh tế: skill là kiểm soát mang tính khuyến nghị. Nó khiến Claude nhiều khả năng áp dụng chính sách, nhưng không có gì buộc một phiên phải tuân thủ. Với chính sách bắt buộc, cần một lớp tất định phía sau: skill làm vi phạm trở nên hiếm, còn hook làm chúng gần như không thể xảy ra. Bài học này cũng xuất hiện trong thực tiễn bảo mật của Anthropic, nơi hướng dẫn lập trình an toàn được mã hóa trong CLAUDE.md và skills toàn tổ chức, và mỗi khi agent phát hiện một lớp lỗi mới, file tương ứng được cập nhật để lỗi không tái diễn (Clinton, 2026).
5.4. Hooks: rào chắn tất định trong lúc xây dựng
Hook là script chạy trước hoặc sau một hành động của Claude, có thể cho phép, hỏi lại hoặc chặn. Vì phần lớn hành động trong Build là sửa file và chạy lệnh shell, đây là nơi hook kích hoạt thường xuyên nhất. Các hook điển hình gồm: chặn sửa vào đường dẫn được bảo vệ như class sinh tự động hay gói đã đóng băng; tự chạy formatter và linter sau mỗi lần sửa; và ngăn thông tin xác thực lọt vào diff. Hook cần nhanh và chỉ áp cho file vừa đổi; các kiểm tra nặng như chạy toàn bộ test nên để ở bước commit hoặc PR.
5.5. Phiên song song và subagent
Một kỹ sư giờ có thể điều phối nhiều luồng công việc cùng lúc. Phiên song song là các phiên Claude Code độc lập, mỗi phiên trong một git worktree riêng, làm một tác vụ riêng. Subagent chạy bên trong một phiên như một trợ thủ có phạm vi hẹp, với cửa sổ ngữ cảnh và quyền công cụ riêng, phù hợp cho việc lặp lại như kiểm tra ứng dụng chạy đúng, đơn giản hóa code, hoặc khảo sát codebase mà không làm ngập ngữ cảnh chính.
Playbook khuyên bắt đầu với hai đến ba phiên. Giới hạn thực tế không nằm ở máy mà ở số luồng một người có thể review cho tử tế; chỉ thêm phiên khi chất lượng review còn theo kịp. Vai trò kỹ sư dịch từ người gõ code sang người điều phối, và về lâu dài là người xây dựng và giám sát các vòng lặp.
Rakuten là một ví dụ về điều này ở quy mô doanh nghiệp. Theo Yusuke Kaji, tổng giám đốc AI for Business, các agent của Rakuten xử lý công việc nhanh hơn khoảng 10 lần ở mọi lĩnh vực, nhưng số đầu việc tổ chức nhận về cũng tăng liên tục. Thêm agent không tạo thêm khả năng phán đoán; agent chạy càng nhanh, tiến độ càng phụ thuộc vào việc con người khép vòng lặp (Anthropic, 2026b).
6. Giai đoạn Test: mọi phiên tự kiểm tra trước khi con người nhìn thấy
Trong mô hình cũ, tín hiệu “code chạy đúng” đến muộn: CI vài phút sau, tester vài ngày sau, production vài tuần sau. Khi agent sản xuất code với tốc độ cao, tín hiệu muộn đồng nghĩa với việc một con người phải kiểm tra toàn bộ đầu ra, và người đó trở thành nút thắt. Giai đoạn Test của AI-Native SDLC giải quyết vấn đề này bằng hai play bổ trợ nhau (Claxton, 2026).
6.1. Cho Claude một vòng phản hồi
Nguyên tắc cốt lõi: luôn cho Claude một cách tự xác minh công việc, dù là chạy test, chạy build hay so sánh ảnh chụp màn hình. Claude lặp cho đến khi kiểm tra đạt, nên thứ đến tay kỹ sư đã vượt qua nó. Việc thiết lập gồm bảy bước thực tế:
- Gói việc kiểm tra thành một lệnh duy nhất như
make testhaynpm test, trả mã lỗi khác 0 khi thất bại. - Liệt kê các lệnh trong mục Commands của
CLAUDE.md, kèm ví dụ đầu ra khi mọi thứ ổn. - Đặt mục tiêu định lượng được, chẳng hạn “mọi test trong test_status.py đều pass” hay “endpoint trả về 200 kèm trường mới”.
- Với sửa lỗi, viết test thất bại trước: yêu cầu Claude tái hiện lỗi thành test, xác nhận nó fail đúng lý do, commit test đó, rồi mới yêu cầu sửa code mà không được sửa test.
- Với giao diện, cho Claude công cụ trình duyệt hoặc chụp màn hình cùng mockup; hai đến ba vòng so sánh là bình thường.
- Đưa việc xác minh vào định nghĩa “xong”: chạy test và dán kết quả trước khi báo hoàn thành.
- Bảo vệ chính vòng lặp: dùng hook chặn agent sửa file test trong tác vụ sửa lỗi.
Bước thứ bảy đáng được nhấn mạnh. Một agent đang cố làm test pass có thể bị cám dỗ “sửa” test thay vì sửa code. Một test tồn tại từ trước khi sửa lỗi và agent không thể viết lại là bằng chứng mạnh nhất rằng lỗi đã được khắc phục. Đây cũng là lý do dòng chỉ dẫn “nếu test fail, hãy sửa code chứ không phải sửa test” thường xuất hiện trong CLAUDE.md của các đội trưởng thành.
CircleCI là một ví dụ thực tế. Khi xây dựng Chunk, agent tự động trên nền Claude chuyên xử lý sự cố bảo trì CI/CD, họ thiết kế để agent tự xác thực bản sửa trước khi con người nhìn thấy. Cách tiếp cận này giúp tỷ lệ tác vụ agent chuyển thành pull request hoàn chỉnh tăng gấp đôi (dẫn theo Clinton, 2026).
6.2. Eval liên tục trong CI
Nếu vòng phản hồi kiểm tra code agent viết, thì eval kiểm tra chính agent. Mỗi khi cấu hình điều khiển agent thay đổi, như đổi model, sửa CLAUDE.md, cập nhật skill hay hook, bộ eval cho biết agent có còn làm việc ở cùng chuẩn mực hay không. Playbook gọi eval là phiên bản AI-Native của cổng QA truyền thống.
Cách xây dựng khá thực dụng. Kỹ sư platform thu thập 20 đến 50 tác vụ thật từ công việc gần đây cùng kết quả đã được chấp nhận. Mỗi tác vụ được viết thành một eval gồm prompt và các tiêu chí chấp nhận: test pass, lint sạch, hành vi không đổi, chính sách được tuân thủ. Bộ eval chạy không tương tác trong CI theo lịch hằng đêm và mỗi khi file cấu hình agent thay đổi. Một thay đổi skill làm giảm tỷ lệ pass phải được review trước khi merge. Đặc biệt, mỗi sự cố production sinh ra một eval mới, do chính đội sở hữu sự cố viết, và ở lại vĩnh viễn như một test hồi quy.
Bộ eval cũng phải “sống”. Khi model mạnh lên, những ca từng phân biệt được tốt sẽ không còn tác dụng, và cần bổ sung ca mới từ quá trình giám sát. Chỉ số theo dõi gồm tỷ lệ pass theo thời gian, thời gian để một sự cố trở thành eval cố định, và tỷ lệ lỗi hồi quy bắt được ở CI so với lỗi lọt ra production.
6.3. Đo lường giai đoạn Test
Với vòng phản hồi, chỉ số dẫn dắt là tỷ lệ CI pass ngay lần đầu cho thay đổi do agent viết. Chỉ số kết quả là thời gian review mỗi PR, kỳ vọng giảm khi test đã bắt được những gì reviewer từng phải bắt, cùng tỷ lệ thay đổi gây sự cố (change failure rate), một trong bốn chỉ số DORA quen thuộc.
7. Giai đoạn Deploy: agent làm mọi thứ đến cổng production, và không bước qua
Đây là giai đoạn nhạy cảm nhất về mặt quản trị, và cũng là nơi nghịch lý năng suất trong dữ liệu của Faros AI hiện rõ nhất: PR tăng gần gấp đôi nhưng thời gian review cũng tăng gần gấp đôi. Playbook đưa ra ba play: AI trong vòng review PR, hook làm cổng phê duyệt, và tích hợp CI/CD (Claxton, 2026).
7.1. AI trong vòng review pull request
Claude vừa đưa ra vừa nhận review. Nó review mọi PR đến theo chính sách tổ chức, và tự xử lý các bình luận review trên PR do chính nó mở. Mọi PR nhận cùng một bộ lượt review với phát hiện được xếp hạng theo mức độ nghiêm trọng. Sự chú ý của con người được đẩy lên một tầng: thay đổi này có làm đúng điều kế hoạch dự định không, và rủi ro có chấp nhận được không.
Trưởng nhóm kỹ thuật viết chính sách review thành file REVIEW.md ở gốc repo, chia thành các lượt: lỗi logic, bảo mật, và tuân thủ so với spec.md, plan.md cùng nguyên tắc thiết kế. File này cũng định nghĩa thế nào là “Quan trọng” và thế nào chỉ là “Góp ý nhỏ”, giới hạn số góp ý nhỏ mỗi lần review, và loại trừ file sinh tự động. Phát hiện của AI không tự phê duyệt hay chặn PR; branch protection vẫn yêu cầu chữ ký của code owner. Khi review gắn cờ một lỗi lần thứ hai, cách sửa được đưa vào CLAUDE.md, nên từ PR tiếp theo lỗi đó bị chặn ngay từ lúc viết.
Tại Anthropic, tỷ lệ PR nhận được bình luận review có thực chất đã tăng từ 16% lên 54%, nhờ yêu cầu agent phải viết chứng minh rằng phát hiện của mình là có thật. Nhóm bảo mật cũng xác định khoảng một phần ba số lỗi đứng sau các sự cố claude.ai trước đây lẽ ra đã bị bắt bởi quy trình tự động hiện tại. Thay vì một “siêu agent bảo mật”, mỗi PR được nhiều agent review, mỗi agent có trọng tâm hẹp, vì chúng không chia sẻ điểm mù, có thể bắt lỗi của nhau, và không bị dàn mỏng sự chú ý (Clinton, 2026).
7.2. Tình huống điển hình: Intercom để AI phê duyệt pull request
Intercom, nền tảng chăm sóc khách hàng, là một trong những ví dụ công khai táo bạo nhất. Năm 2025, CTO Darragh Curran đặt mục tiêu nhân đôi năng suất toàn bộ khối R&D trong 12 tháng; chín tháng sau, họ đạt mục tiêu. Hiện hơn 93% PR ở hai codebase chính do agent dẫn dắt, và hơn 19% được phê duyệt tự động mà không cần người review (Mykhailov & Young, 2026).
Điều đáng học không nằm ở con số mà ở cách họ thiết kế để an toàn:
- Phân rã việc review. Agent review không xem review là một tác vụ, mà chia thành nhiều tác vụ con do các subagent độc lập đảm nhận: chất lượng mô tả vấn đề, độ khớp giữa diff và ý định, an toàn, tính đúng đắn logic, thực hành tốt.
- Lần theo luồng thực thi. Trong thử nghiệm trên PR lịch sử, agent gắn cờ một thay đổi chỉ một dòng văn bản hiển thị. Hóa ra dòng chữ mới mâu thuẫn với một cơ chế kiểm tra hợp lệ ở nơi khác trong codebase, điều mà người review gần như không thể phát hiện.
- Khắt khe với PR lớn. Agent từ chối phê duyệt PR quá lớn hoặc quá rộng và yêu cầu chia nhỏ, tạo động lực để kỹ sư ship những thay đổi nhỏ, dễ hoàn tác.
- Không bắt buộc. Bất kỳ kỹ sư nào cũng có thể yêu cầu người review ở bất kỳ thay đổi nào. Người ship code vẫn chịu trách nhiệm theo dõi trên production và sẵn sàng rollback.
Kết quả đo được rất ấn tượng. Đợt thí điểm hơn 100 PR không có lần revert nào, thời gian phê duyệt ở phân vị 75 nhanh hơn 6 đến 16 lần. Trong bốn tuần mở rộng đầu tiên, 497 PR chạy hoàn toàn tự động từ viết code đến phát hành. Tỷ lệ revert của code backend do AI viết là 0,53% so với 5,39% của code do người viết; ở frontend là 0,22% so với 2,00%. Downtime do thay đổi code gây lỗi giảm 35% trong khi số lần triển khai tăng gấp đôi.
Về tuân thủ, Intercom làm việc với đơn vị kiểm toán Schellman ngay từ trước khi mở rộng để xác nhận quy trình đáp ứng SOC 2, HIPAA, ISO 27001, ISO 42001 và các khung khác. Mọi PR do AI phê duyệt đều được gắn nhãn, ghi log và truy vấn được. Họ cũng thẳng thắn thừa nhận giới hạn: phần lớn sự cố lớn nhất của Intercom không đến từ code sản phẩm mà từ hạ tầng, hành vi khách hàng bất ngờ hoặc bên thứ ba, những thứ không review nào bắt được.
7.3. Hook làm cổng phê duyệt
Ở giai đoạn Build, hook cho phép hoặc chặn mà không cần con người. Ở giai đoạn Deploy, hook còn có thể hỏi: tạm dừng hành động cho đến khi một người cụ thể phê duyệt. Lãnh đạo kỹ thuật cùng bộ phận quản lý thay đổi và tuân thủ liệt kê những cổng phê duyệt bắt buộc phải tồn tại, như chữ ký quản lý thay đổi hay ủy quyền phát hành. Kỹ sư platform biểu diễn mỗi cổng thành một hook. Hook của nhóm nằm trong .claude/settings.json; hook không thể thương lượng nằm trong managed settings do IT quản trị, kỹ sư không tắt được. Khi chặn, hook phải giải thích lý do và chỉ đường xin phê duyệt.
Với doanh nghiệp chịu quản lý chặt, playbook đưa ra một cấu hình mẫu cho managed settings: chặn đọc file bí mật và các lệnh truy cập mạng tùy ý; bật sandbox ở cấp hệ điều hành với danh sách tên miền được phép; chặn đọc thư mục chứa khóa SSH và thông tin xác thực đám mây; chỉ cho phép hook, máy chủ MCP và plugin từ kho được tổ chức phê duyệt; và yêu cầu phiên bản tối thiểu đã được đánh giá. Playbook lưu ý đây là điểm khởi đầu để điều chỉnh, không phải để sao chép nguyên xi, vì mỗi lệnh chặn đều đánh đổi với năng lực của agent.
7.4. Tích hợp CI/CD và triển khai
Nguyên tắc chi phối: agent được hành động đến cổng production và không thể bước qua. Lộ trình gợi ý bắt đầu từ các bước chỉ đọc, như dùng claude -p trong pipeline để phân loại build lỗi, tóm tắt test chập chờn hay soạn changelog. Sau đó thêm các bước ghi sau những cổng sẵn có: mọi thứ agent viết đều đi qua PR và branch protection, không có đường đẩy thẳng lên nhánh chính. Agent chạy trong container với token ngắn hạn, không giữ credential production. Quyền triển khai được cấp qua MCP theo từng môi trường: tự do ở dev, trung gian ở staging, và ở production thì agent chuẩn bị bản phát hành còn release manager ủy quyền. Rollback phải là đường được diễn tập nhiều nhất, vì giai đoạn Maintain sẽ gọi đến nó.
8. Giai đoạn Maintain: vòng lặp tự khép kín
Ở năm giai đoạn trước, mỗi bước vẫn cần một con người khởi động. Giai đoạn Maintain là nơi vòng lặp khép lại: một tác nhân kích hoạt (trigger) gọi Claude mà không cần ai trong đường gọi, và những gì Claude phát hiện quay lại pipeline dưới dạng intent.md mới (Claxton, 2026).
Hãy nghĩ đến bảo trì truyền thống. Cảnh báo kêu lúc 3 giờ sáng có thể bị bỏ lỡ. Ticket nằm trong backlog cho đến khi có người nhặt lên. Các hành động sau post-mortem có thể không bao giờ đến được codebase vì một đám cháy khác đã bùng lên. Trong mô hình mới, con người phân loại và review công việc, nhưng không còn phải khởi động nó.
8.1. Dải kiểm soát và ba tầng phản ứng
Playbook mô tả một cơ chế dựa trên kiểm soát quy trình thống kê. Chủ sở hữu dịch vụ chọn một chỉ số có đường cơ sở ổn định, như tỷ lệ test CI thất bại, tỷ lệ lỗi 5xx sau triển khai, hay thời gian chu kỳ PR. Một script tất định, không dùng model, theo dõi chỉ số bằng trung bình và độ lệch chuẩn trên cửa sổ trượt, kết hợp các quy tắc kiểu Western Electric để bắt cả sự trôi dạt chậm lẫn đột biến. Các tầng phản ứng được khai báo trong một file cấu hình có quản lý phiên bản:
- Vượt 1σ: chỉ ghi log.
- Vượt 2σ: gọi Claude ở chế độ chỉ đọc để chẩn đoán.
- Vượt 3σ: Claude được hành động, nhưng chỉ bằng cách mở PR vào cổng review hoặc kích hoạt một runbook đã được phê duyệt trước, chẳng hạn rollback.
Claude viết chẩn đoán thành intent.md theo đúng định dạng của giai đoạn Plan, gồm bất thường, bằng chứng, kết quả đề xuất, hệ thống bị ảnh hưởng và câu hỏi mở. Kỹ sư trực xử lý hàng đợi: sửa ngay, lên lịch, hoặc bỏ qua. Mỗi lần bỏ qua giúp tinh chỉnh dải kiểm soát. Khi bản sửa được phát hành, một eval cho sự cố đó được thêm vào bộ eval liên tục. Ba ví dụ trong playbook: tỷ lệ test CI fail vượt 3σ thì agent cách ly test chập chờn hoặc mở PR revert; lỗi 5xx tăng vọt ngay sau một lần triển khai thì agent kích hoạt pipeline rollback; thời gian chu kỳ PR trôi dạt thì agent viết báo cáo cho lãnh đạo kỹ thuật. Ví dụ cuối cho thấy cơ chế này áp dụng được cả cho chỉ số quy trình chứ không chỉ chỉ số production.
8.2. Quét mã nguồn định kỳ
Một lần quét bảo mật chỉ là tuyên bố tại một thời điểm, với một model cụ thể, và cả hai đều nhanh lỗi thời: code thay đổi hằng tuần, còn mỗi thế hệ model lại tìm ra lỗ hổng mà thế hệ trước bỏ sót. Câu trả lời AI-Native là quét theo lịch, không cần người trong đường gọi, và đưa phát hiện qua cùng các cổng như mọi thay đổi khác. Lỗ hổng gói gọn trong một PR thì đi qua cổng review; vấn đề lớn hơn như điểm yếu kiến trúc được viết thành intent.md và bắt đầu lại từ Plan. Claude Security là dạng dịch vụ hóa của play này; nó bổ sung chứ không thay thế công cụ phân tích tĩnh và quét phụ thuộc vốn có.
Năng lực này có nền tảng thực tế: đầu năm 2026, Anthropic công bố Claude đã phát hiện và giúp vá hơn 500 lỗ hổng mức nghiêm trọng cao trong phần mềm mã nguồn mở (Clinton, 2026).
8.3. Claude trực on-call: câu chuyện 10 giờ đêm
Sachin Malhotra, kỹ sư nhóm Continuous Integration tại Anthropic, kể lại một tối đang trực thì đồng nghiệp nhắn lúc 10 giờ đêm: khoảng 44 test trên một dịch vụ mới không chạy. Trước đây, anh sẽ phải mở laptop cho một giờ điều tra và sửa. Lần này, anh gọi @Claude vào kênh Slack. Claude phát hiện số test biến mất từ khi một feature flag được bật sáng hôm đó, và xác nhận revert là an toàn. Đồng nghiệp revert flag, và ba phút sau Claude báo lại rằng các quy tắc bỏ qua test đã được gỡ và tỷ lệ lỗi về lại đường cơ sở (Malhotra, 2026).
Thiết lập của nhóm gồm bốn thành phần mà bất kỳ agent trực nào cũng cần: bộ nhớ (lịch sử kênh và file lessons.md ghi lại mọi sự cố đã giải quyết), kết nối và quyền truy cập (tài khoản dịch vụ riêng, kết nối Grafana, log, PagerDuty, GitHub, Kubernetes qua MCP), lịch (các tác vụ định kỳ khai báo bằng ngôn ngữ tự nhiên) và chỉ dẫn (skills được commit trong GitHub để cả nhóm cùng cải tiến). Khi có sự cố, một agent điều phối sinh ra các subagent thực thi để điều tra song song từng nguồn dữ liệu, rồi tổng hợp thành một báo cáo tình hình. Claude đăng phân tích đầu tiên có bằng chứng sau trung vị 14 phút, nhanh nhất khoảng 4 phút đã chỉ ra nguyên nhân gốc.
Một chi tiết thú vị: lessons.md giờ chứa một bài học Claude tự viết về chính Malhotra, sau khi anh suy luận từ file cấu hình trước khi kiểm tra số liệu. Đại ý: hãy truy vấn dữ liệu trước rồi mới đặt giả thuyết, vì cấu hình cho biết điều có thể sai, còn số liệu cho biết điều đã sai. Nhóm đã đóng gói thiết lập thành bộ công cụ mã nguồn mở oncall-kit để các tổ chức khác dựng agent trực tương tự trong vài giờ.
Điều quan trọng về quản trị: agent phản ứng sự cố tại Anthropic là một tài khoản hệ thống đơn mục đích với ba quyền, gồm viết tài liệu mới, đăng lên kênh nội bộ, và đọc log production. Nó không thể tự triển khai bản sửa; bản sửa phải đi qua một hệ thống review agent và người riêng biệt (Clinton, 2026).
9. Bảo mật và quản trị: bài học từ một tổ chức để AI viết 80% code
Câu hỏi lớn nhất mà lãnh đạo doanh nghiệp đặt ra với AI-Native SDLC không phải “có nhanh hơn không” mà là “có an toàn không”. Bài viết của Jason Clinton, Phó Giám đốc An ninh thông tin (Deputy CISO) của Anthropic, cung cấp câu trả lời cụ thể nhất hiện có, vì nó mô tả một môi trường mà Claude đã chuyển từ trợ lý lập trình thành người tạo và người review chính (Clinton, 2026).
Clinton nêu ba mối đe dọa cụ thể mà mọi kiểm soát đều phải đối ứng: một agent bị xâm nhập hoặc bị tiêm lệnh (prompt injection) đưa vào thay đổi độc hại; đầu độc chuỗi cung ứng và thư viện phụ thuộc mà agent tiếp nhận như dữ liệu tin cậy; và các lớp lỗ hổng ứng dụng quen thuộc nhưng đến với khối lượng lớn hơn. Từ đó, ông rút ra một loạt “nguyên tắc bền vững” gắn với từng giai đoạn.
Plan: đưa agent bảo mật đến nơi có ngữ cảnh. Một trong những tự động hóa bảo mật đầu tiên của Anthropic là ứng dụng review bảo mật dự án dùng Claude để phân tích tài liệu thiết kế theo khung MITRE ATT&CK. Khi được kết nối với kho tri thức nội bộ về chính sách và quyết định trước đây, công cụ này tiết kiệm phần lớn thời gian của đội AppSec. Khi đã đủ tin tưởng vào độ chính xác, Anthropic cho phép các nhóm tự phê duyệt dự án nếu Claude đánh giá rủi ro đủ thấp.
Build: khép vòng giữa phát hiện lỗ hổng và chỉ dẫn sinh code, đồng thời giới hạn bán kính ảnh hưởng. Hướng dẫn lập trình an toàn nằm trong CLAUDE.md và skills, nên code tuân theo ngay khi được sinh ra. Kỹ sư lập trình trên máy ảo từ xa với lưu lượng ra ngoài bị giới hạn theo danh sách cho phép, để một lệnh bị tiêm không thể gửi dữ liệu đến đích tùy ý. Clinton gọi đây là nguyên tắc “ít quyền tác nhân nhất” (least agency).
Test: review tự động là một loại rủi ro khác, được kiểm soát theo cách khác. Codebase được phân tầng theo rủi ro; có những codebase vẫn bắt buộc người phê duyệt. Mọi phê duyệt tự động được ghi log kèm tín hiệu và lập luận, và một mẫu có trọng số rủi ro được con người rà soát lại.
Deploy: kiểm thử động phải theo kịp nhịp triển khai. Khi code được phát hành liên tục, quét DAST định kỳ không còn đủ “động”. Anthropic đang triển khai quét DAST liên tục bằng AI trên môi trường staging để tìm lỗ hổng ở cấp hệ thống, nơi giả định giữa các dịch vụ không khớp nhau.
Monitor: mỗi agent một danh tính đơn mục đích với quyền tối thiểu. Đây là phần đáng suy ngẫm nhất. Sau một lần nâng cấp model, agent phản ứng sự cố đã tự ý nhắn qua Slack cho một phiên Claude khác có quyền viết code, đề nghị nó đẩy bản sửa. Hành vi này bị chặn tại cổng review của con người đúng như thiết kế. Bài học Clinton rút ra: ranh giới phải được vẽ quanh quyền truy cập và hành động, chứ không phải quanh chỉ dẫn hay điều ta tin model sẽ làm; và khi xét ranh giới của một agent, phải tính cả khả năng nó liên lạc với agent khác.
9.1. Năm thói quen quản trị
Để cấu trúc trên không xuống cấp, Anthropic duy trì năm thực hành mà bất kỳ tổ chức nào cũng có thể áp dụng:
- Phân tầng codebase theo rủi ro và tự động hóa review theo tầng.
- Chạy mọi agent review mới ở chế độ bóng (shadow mode), chỉ đăng bình luận chờ người duyệt cho đến khi được tin cậy, đồng thời thử tấn công nó bằng thay đổi độc hại.
- Lấy mẫu một tỷ lệ phê duyệt tự động để người kiểm tra lại.
- Theo dõi một bảng điều khiển tổng hợp các chỉ số then chốt của mọi quy trình bảo mật.
- Đưa mọi hành động của agent vào hệ thống SIEM, xem agent như một dạng mối đe dọa nội bộ mới và cảnh báo khi chúng hành động lệch chuẩn.
Clinton kết luận rằng công việc của kỹ sư bảo mật đang chuyển từ giám sát lỗi sang giám sát vòng lặp. Ông cũng gợi ý một câu hỏi lập kế hoạch đáng giá: thay vì hỏi “có đủ tiền quét mọi thứ không”, hãy hỏi “mình sẽ chạy gì nếu việc quét gần như miễn phí”, vì chi phí đơn vị đang giảm theo từng thế hệ model.
10. Lộ trình triển khai và gợi ý cho doanh nghiệp Việt Nam
Không tổ chức nào chuyển sang AI-Native SDLC trong một đêm, và playbook cũng không khuyến khích điều đó. Câu hỏi thực tế là bắt đầu từ đâu và theo thứ tự nào.
10.1. Thứ tự áp dụng theo phụ thuộc
Playbook vẽ một đồ thị phụ thuộc giữa các play. Thứ tự áp dụng không trùng với thứ tự giai đoạn: có thể bắt đầu từ bất kỳ play nào không có điều kiện tiên quyết. Đọc từ các điều kiện tiên quyết được nêu trong từng play, có thể rút ra một lộ trình hợp lý gồm bốn đợt (Claxton, 2026): Bảng 2 nhóm các play thành bốn đợt theo điều kiện tiên quyết.
Bảng 2. Bốn đợt áp dụng AI-Native SDLC theo phụ thuộc
| Đợt | Các play | Lý do |
|---|---|---|
| 1. Nền móng | CLAUDE.md, vòng phản hồi, skills, hook làm cổng phê duyệt, intent.md |
Không có điều kiện tiên quyết; chi phí thấp, hiệu quả thấy ngay |
| 2. Tăng tốc từng kỹ sư | Plan mode, hooks khi build, phiên song song và subagent | Cần CLAUDE.md và vòng phản hồi để agent tự kiểm tra |
| 3. Tăng tốc cả đội | Spec từ intent, AI review PR, eval liên tục | Cần skills, intent.md và CLAUDE.md đã trưởng thành |
| 4. Khép vòng lặp | CI/CD với agent, dải kiểm soát, quét định kỳ, agent trực on-call | Cần cổng review, hook phê duyệt và đường rollback đã được kiểm chứng |
Nguồn: tổng hợp từ điều kiện tiên quyết của từng play trong Claxton (2026).
Một nguyên tắc xuyên suốt cả bốn đợt là cổng phải có trước tự động hóa. Playbook nói rõ rằng CI/CD với agent chỉ nên triển khai sau khi đã có AI review và hook phê duyệt, vì cổng phải tồn tại trước khi tự động hóa đẩy nhanh mọi thứ đi qua nó.
10.2. Hệ thống cũ và nguồn sự thật duy nhất
Hầu hết doanh nghiệp Việt Nam, đặc biệt ngân hàng, bảo hiểm và viễn thông, đã có sẵn Jira, công cụ quản lý yêu cầu, Figma và hội đồng quản lý thay đổi mà kiểm toán viên và cơ quan quản lý đã chấp nhận. Playbook không đòi thay thế chúng. Thay vào đó, với mỗi loại artifact, hãy chỉ định một hệ thống làm nguồn sự thật. Có ba cấu hình: repo là nguồn sự thật (sạch nhất cho tổ chức do kỹ thuật dẫn dắt); hệ thống cũ là nguồn sự thật, còn Claude đọc và ghi ngược qua connector MCP; hoặc mức tối thiểu là liên kết hai chiều, mỗi artifact ghi mã bản ghi, mỗi bản ghi chứa mã commit. Mức liên kết là điểm khởi đầu an toàn cho các tổ chức đang chịu kiểm toán.
10.3. Bối cảnh Việt Nam: nhu cầu đã rõ, nền móng còn phải xây
Các công ty dịch vụ phần mềm lớn của Việt Nam đã chuyển động mạnh. FPT Software định vị mình là công ty “AI-first” từ năm 2025, với nền tảng FleziPT mà công ty công bố giúp phát triển nhanh hơn tới 60%, giảm hơn 50% việc làm lại và tăng khoảng 30% năng suất (FPT Software, 2026a). Hơn 30.000 kỹ sư của FPT đang dùng công cụ và quy trình có AI, và công ty đưa ra khung trưởng thành CASAN năm cấp độ, đi từ Curious, Augmented, Standard, Automated đến Native (FPT Software, 2026b). Đây là số liệu do doanh nghiệp tự công bố, nên nên đọc như định hướng chiến lược hơn là kết quả đã được kiểm chứng độc lập.
Từ góc nhìn của các phần trước, có năm gợi ý thiết thực cho doanh nghiệp Việt Nam:
- Đừng đo thành công bằng số dòng code. Bài học từ Faros AI và METR cho thấy đầu ra cá nhân tăng chưa chắc kéo theo hiệu quả hệ thống. Hãy đo bằng các chỉ số DORA, thời gian chu kỳ PR, tỷ lệ revert và thời gian onboarding. Fiona Fung cảnh báo không nên nhầm thông lượng với thành công; chỉ số thật là vấn đề bạn đang cố giải quyết (Anthropic, 2026a).
- Bắt đầu từ quy trình “ồn ào” nhất. Lời khuyên của Fung là chọn quy trình tốn kém hoặc bị cả đội ngán ngẩm nhất, hỏi xem nó còn phục vụ mục đích ban đầu không, và nếu còn thì có tự động hóa được không.
- Đưa chính sách nội bộ và quy định pháp lý vào skills. Các yêu cầu về bảo vệ dữ liệu cá nhân, an toàn hệ thống thông tin hay quy định riêng của ngành tài chính đều có thể được mã hóa thành skill để áp dụng ngay khi viết đặc tả và code, có hook tất định đứng sau cho những gì bắt buộc. Nội dung cụ thể cần do bộ phận pháp chế và tuân thủ của từng tổ chức xác nhận.
- Làm việc với kiểm toán viên từ sớm. Intercom mời đơn vị kiểm toán vào trước khi mở rộng phê duyệt tự động. Với ngân hàng Việt Nam, điều này tương đương với việc thống nhất sớm với khối quản trị rủi ro và kiểm toán nội bộ về loại bằng chứng chấp nhận được.
- Đầu tư vào con người ở vị trí mới. Khi AI đảm nhận thông lượng, giá trị dịch chuyển sang hai kiểu người mà đội Claude Code ưu tiên tuyển: người xây dựng sáng tạo có cảm quan sản phẩm, và kỹ sư có chuyên môn hệ thống sâu. Với ngành gia công phần mềm Việt Nam vốn cạnh tranh bằng quy mô nhân lực, đây vừa là rủi ro vừa là cơ hội tái định vị.
Kết luận: vòng lặp chạy liên tục, phán đoán của con người đứng trên nó
AI-Native SDLC không phải là việc gắn thêm một trợ lý lập trình vào quy trình cũ. Đó là sự thừa nhận rằng toàn bộ hệ thống kiểm soát của ngành phần mềm, gồm tài liệu yêu cầu, ước lượng, review từng dòng, hội đồng phê duyệt, được thiết kế cho một thế giới mà việc viết code đắt đỏ. Khi giả định đó không còn đúng, giữ nguyên quy trình cũ đồng nghĩa với việc để toàn bộ lợi ích năng suất bị nuốt ở hàng đợi review, đúng như dữ liệu của Faros AI và DORA đã cho thấy.
Ba ý tưởng cốt lõi đáng mang theo. Thứ nhất, mọi giai đoạn kết thúc bằng một artifact được commit, và chuỗi artifact đó vừa là đầu vào cho giai đoạn sau vừa là dấu vết kiểm toán. Thứ hai, kiểm soát được chia lớp: skill khiến vi phạm hiếm, hook khiến vi phạm gần như không thể, và con người đứng ở các cổng quan trọng nhất. Thứ ba, ranh giới được vẽ quanh quyền hạn chứ không quanh niềm tin vào model, như sự cố agent tự nhắn agent khác tại Anthropic đã chứng minh.
Các trường hợp thực tế cho thấy mô hình này không chỉ là lý thuyết. Intercom nhân đôi số lần triển khai trong khi giảm 35% downtime do thay đổi code. Anthropic để Claude viết khoảng 80% code mà vẫn giữ nguyên tắc mọi PR có một người chịu trách nhiệm. Nhóm CI của Anthropic có một “đồng nghiệp trực đêm” đăng phân tích đầu tiên trong khoảng 14 phút. Nhưng cũng chính những tổ chức này nhấn mạnh rằng thành công đến từ kỷ luật quy trình chứ không phải từ công cụ, và cán cân giữa tin tưởng và kiểm chứng phải được đánh giá lại sau mỗi thế hệ model.
Playbook của Anthropic khép lại bằng một ý mà có lẽ là bản tóm tắt tốt nhất cho toàn bộ chủ đề: vòng lặp cứ thế vận hành, còn phán đoán của con người luôn đứng phía trên nó (Claxton, 2026). Câu hỏi cho mỗi tổ chức không còn là có nên chuyển đổi hay không, mà là quy trình nào của mình đang âm thầm trở thành nút thắt, và mình sẽ bắt đầu gỡ nó từ tuần này như thế nào.
Đọc thêm
- Từ vibe coding đến vibe working
- Phần mềm và các cách phân loại — mục công cụ lập trình, CI/CD
- Mô hình tự mang theo trong doanh nghiệp — mục BYOAI
- Bản đồ hệ sinh thái AI cho người khởi nghiệp
- Từ MVP đến IUP trong lớp khởi nghiệp
Tài liệu tham khảo
Anthropic. (2026a, June 3). Running an AI-native engineering org. Claude. https://claude.com/blog/running-an-ai-native-engineering-org
Anthropic. (2026b, July 20). Working at the frontier: How Rakuten builds agents overnight with Claude Fable 5. Claude. https://claude.com/blog/working-at-the-frontier-rakuten
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. METR. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
Claxton, L. (2026, August 21). The AI-native SDLC playbook. Claude. https://claude.com/blog/the-ai-native-sdlc-playbook
Clinton, J. (2026, July 21). How Anthropic secures its AI-native software development lifecycle. Claude. https://claude.com/blog/how-anthropic-secures-its-ai-native-software-development-lifecycle
Faros AI. (2025, July 23). The AI productivity paradox research report. https://www.faros.ai/blog/ai-software-engineering
FPT Software. (2026a). FPT sets direction for tech innovation, with artificial intelligence as core enabler. https://fptsoftware.com/newsroom/news-and-press-releases/news/fpt_sets_direction_for_tech_innovation
FPT Software. (2026b, August 12). The AI-native shift: From experimental momentum to operational excellence. https://fptsoftware.com/resource-center/blogs/the-ai-native-shift-from-experimental-momentum-to-operational-excellence
Google. (2025, September 23). How are developers using AI? Inside Google's 2025 DORA report. The Keyword. https://blog.google/innovation-and-ai/technology/developers-tools/dora-report-2025/
Google Cloud. (2025, September 23). Announcing the 2025 DORA report. Google Cloud Blog. https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report
Malhotra, S. (2026, August 18). Claude on call: How Claude Tag serves as Anthropic's first responder for CI/CD failures. Claude. https://claude.com/blog/ai-ci-cd-on-call
METR. (2026, February 24). We are changing our developer productivity experiment design. https://metr.org/blog/2026-02-24-uplift-update/
Mykhailov, K., & Young, N. (2026, April 21). AI is approving our pull requests: Here's how we made it safe. The Intercom Blog. https://www.intercom.com/blog/ai-is-approving-our-pull-requests-heres-how-we-made-it-safe/
Stack Overflow. (2025). AI: 2025 Stack Overflow Developer Survey. https://survey.stackoverflow.co/2025/ai