Bốn cấp độ đo lường, thang Likert và câu hỏi đảo chiều quyết định kỹ thuật phân tích nào được phép dùng
Bài nên đọc trước
Khi khai báo biến trong SPSS, bạn phải chọn cột Measure là Nominal, Ordinal hay Scale. Khi chọn kỹ thuật kiểm định, bạn cần biết biến của mình thuộc loại nào để quyết định dùng T-test, Chi-bình phương hay hồi quy. Cả hai quyết định đều dựa trên một kiến thức nền: cấp độ đo lường của từng biến.
Bài viết này trình bày bốn cấp độ đo lường cơ bản, cách khai báo trong SPSS, những điểm cần biết về thang đo Likert và cách cấp độ đo lường quyết định kỹ thuật phân tích. Bài thuộc nhóm nền tảng của chuỗi, nối tiếp bài "Quy trình nghiên cứu định lượng 7 bước".
"Thang đo" có hai nghĩa
Trong tiếng Việt, từ "thang đo" được dùng cho hai khái niệm khác nhau và người mới học thường nhầm lẫn:
- Cấp độ đo lường (level of measurement): một biến được đo ở dạng định danh, thứ bậc, khoảng hay tỷ lệ. Đây là nội dung chính của bài này.
- Bộ thang đo của một khái niệm (multi-item scale): tập hợp nhiều câu hỏi cùng đo một khái niệm tiềm ẩn, ví dụ thang đo "Sự hài lòng" gồm 4 câu hỏi trong đề tài mẫu về ý định mua lại trên sàn thương mại điện tử. Khi nói "kiểm định độ tin cậy thang đo" bằng Cronbach's Alpha, ta đang nói theo nghĩa này.
Trong bài, "thang đo" được dùng theo nghĩa thứ nhất, trừ khi ghi rõ khác.
1. Bốn cấp độ đo lường
Cách phân loại phổ biến nhất được Stevens (1946) đề xuất, gồm bốn cấp độ xếp từ thấp đến cao. Mỗi cấp độ cao hơn giữ mọi tính chất của cấp độ thấp hơn và bổ sung thêm một tính chất mới, như Hình 1 tóm tắt.
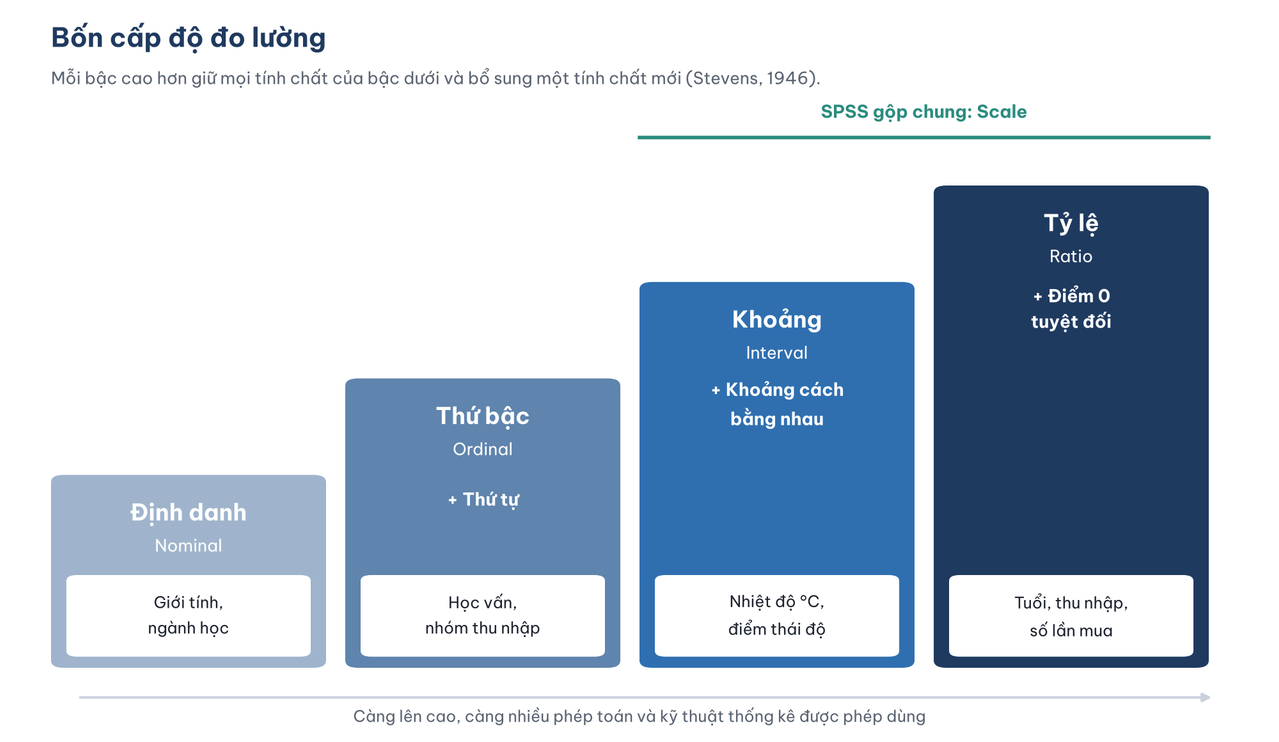
Hình 1. Mỗi cấp độ cao hơn bổ sung một tính chất. Cấp độ càng cao, càng có nhiều phép toán và kỹ thuật thống kê được phép sử dụng.
Thang đo định danh (nominal)
Các con số chỉ dùng để phân loại, không có thứ tự. Ví dụ: giới tính (1 = Nam, 2 = Nữ), ngành học, tỉnh thành nơi sinh sống. Mã số 2 không "lớn hơn" mã số 1; đổi mã cho nhau không làm thay đổi thông tin. Với biến định danh, ta chỉ đếm tần số, tính tỷ lệ phần trăm và xác định yếu vị (mode).
Thang đo thứ bậc (ordinal)
Các giá trị có thứ tự, nhưng khoảng cách giữa các bậc không nhất thiết bằng nhau. Ví dụ: trình độ học vấn (trung học, đại học, sau đại học), xếp hạng mức độ ưu tiên, nhóm thu nhập. Ta biết "sau đại học" cao hơn "đại học", nhưng không thể nói khoảng cách giữa hai bậc này bằng khoảng cách giữa "trung học" và "đại học". Thống kê phù hợp là trung vị (median), phân vị và các kiểm định phi tham số.
Thang đo khoảng (interval)
Khoảng cách giữa các giá trị bằng nhau và có ý nghĩa, nhưng điểm 0 là quy ước, không phải "không có gì". Ví dụ kinh điển là nhiệt độ °C: từ 20 °C lên 30 °C tăng bằng từ 30 °C lên 40 °C, nhưng 0 °C không có nghĩa là không có nhiệt và 40 °C không "nóng gấp đôi" 20 °C. Với biến khoảng, ta tính được trung bình, độ lệch chuẩn và dùng các kiểm định tham số.
Thang đo tỷ lệ (ratio)
Có đủ các tính chất của thang khoảng và có thêm điểm 0 tuyệt đối, nên phép chia có ý nghĩa. Ví dụ: tuổi, thu nhập, số lần mua hàng trong tháng, số giờ sử dụng mạng xã hội mỗi ngày. Người có thu nhập 20 triệu đồng có thu nhập gấp đôi người có 10 triệu đồng.
Bảng 1 tổng hợp tính chất, ví dụ và thống kê mô tả phù hợp với từng cấp độ.
Bảng 1. Bốn cấp độ đo lường: tính chất, ví dụ và thống kê mô tả phù hợp.
| Cấp độ | Phân loại | Thứ tự | Khoảng đều | Điểm 0 thật | Ví dụ trong bảng hỏi | Thống kê mô tả phù hợp |
|---|---|---|---|---|---|---|
| Định danh | Có | Giới tính, ngành học | Tần số, tỷ lệ %, mode | |||
| Thứ bậc | Có | Có | Học vấn, nhóm thu nhập | Thêm trung vị, phân vị | ||
| Khoảng | Có | Có | Có | Nhiệt độ, điểm thái độ | Thêm trung bình, độ lệch chuẩn | |
| Tỷ lệ | Có | Có | Có | Có | Tuổi, thu nhập, số lần mua | Thêm tỷ số, hệ số biến thiên |
2. Khai báo cấp độ đo lường trong SPSS
SPSS gộp thang khoảng và thang tỷ lệ thành một loại là Scale, vì các kỹ thuật thống kê cho hai loại này gần như giống nhau (Field, 2024). Như vậy, trong cột Measure của Variable View:
- Nominal: biến định danh (giới tính, ngành học).
- Ordinal: biến thứ bậc (học vấn, nhóm tuổi).
- Scale: biến khoảng và tỷ lệ (tuổi tính bằng năm, thu nhập, điểm trung bình của một thang đo Likert).
Khai báo đúng giúp SPSS gợi ý biểu đồ và thủ tục phù hợp, đồng thời tránh lỗi trong một số thủ tục có kiểm tra cấp độ đo lường. Thao tác chi tiết sẽ được hướng dẫn trong bài "Khai báo và mã hóa biến trong SPSS".
3. Thang đo Likert
Thang đo Likert là dạng câu hỏi phổ biến nhất trong luận văn kinh tế và quản trị. Người trả lời chọn mức độ đồng ý với một phát biểu, ví dụ từ 1 = Hoàn toàn không đồng ý đến 5 = Hoàn toàn đồng ý. Hình 2 phân biệt một mục hỏi Likert với cả thang đo Likert.
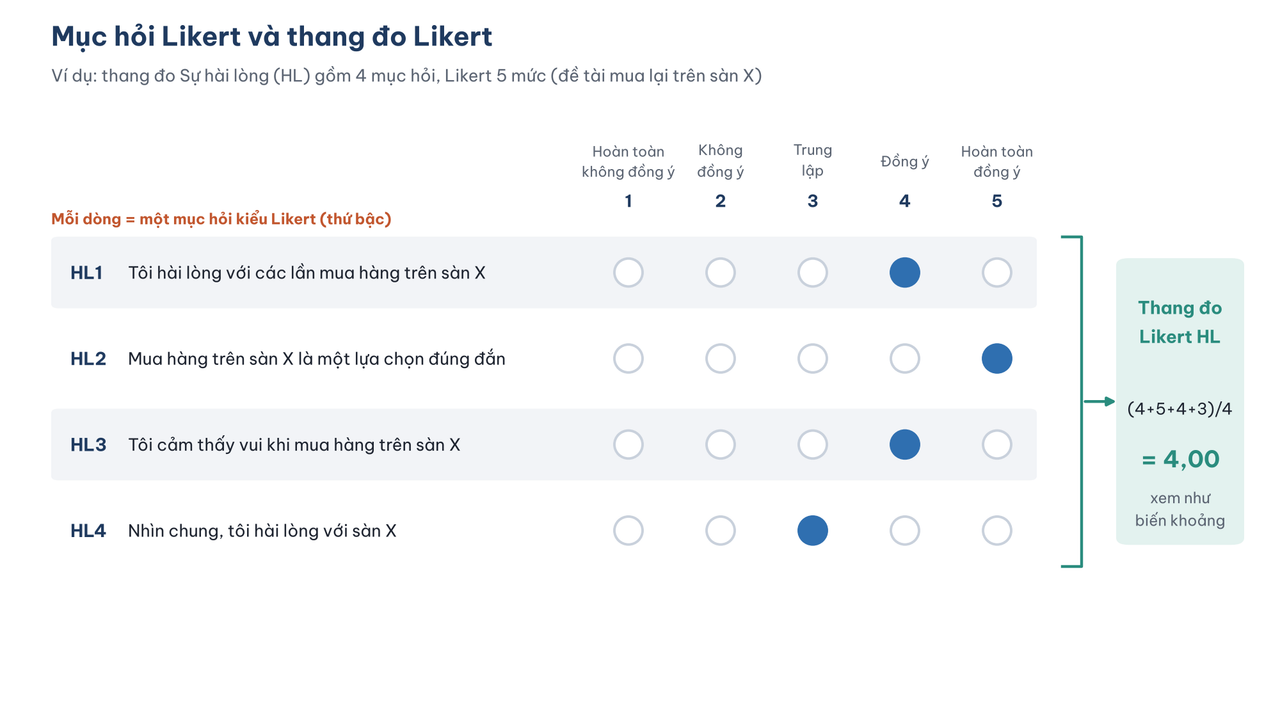
Hình 2. Mỗi câu hỏi là một mục hỏi Likert. Nhiều mục hỏi cùng đo một khái niệm tạo thành thang đo Likert, thường được tổng hợp bằng điểm trung bình.
Mục hỏi Likert khác thang đo Likert
Trong công trình gốc, Likert (1932) xây dựng thang đo thái độ bằng cách cộng điểm của nhiều phát biểu cùng đo một thái độ. Vì vậy cần phân biệt:
- Mục hỏi kiểu Likert (Likert-type item): một câu hỏi đơn lẻ với các mức trả lời có thứ tự.
- Thang đo Likert (Likert scale): tổng hoặc trung bình của nhiều mục hỏi cùng đo một khái niệm.
Sự phân biệt này quan trọng khi quyết định kỹ thuật phân tích (Carifio & Perla, 2007).
Likert là thứ bậc hay khoảng?
Đây là một tranh luận kéo dài. Về nguyên tắc, một mục hỏi Likert là biến thứ bậc: không có gì bảo đảm khoảng cách giữa "đồng ý" và "hoàn toàn đồng ý" bằng khoảng cách giữa "trung lập" và "đồng ý". Một số tác giả vì vậy cho rằng không nên tính trung bình hay dùng kiểm định tham số cho dữ liệu Likert (Jamieson, 2004).
Quan điểm ngược lại cho rằng điểm tổng hợp từ nhiều mục hỏi có thể xem là biến khoảng và các kiểm định tham số như T-test, ANOVA, tương quan Pearson vẫn cho kết quả vững với loại dữ liệu này, kể cả khi phân phối không chuẩn (Carifio & Perla, 2007; Norman, 2010). Thực hành phổ biến trong nghiên cứu kinh tế và quản trị đi theo hướng này: phân tích điểm trung bình của thang đo nhiều mục hỏi như một biến khoảng, đồng thời thận trọng hơn khi phân tích từng mục hỏi riêng lẻ.
Gợi ý thực hành: khi khai báo trong SPSS, các mục hỏi Likert riêng lẻ có thể để Ordinal, còn biến điểm trung bình được tạo ra bằng Compute thì để Scale.
Nên dùng 5 mức hay 7 mức?
Không có câu trả lời duy nhất. Thí nghiệm của Preston và Colman (2000) cho thấy thang có quá ít mức (2 đến 4 mức) có độ tin cậy và độ giá trị kém hơn, trong khi thang khoảng 7 đến 10 mức được người trả lời đánh giá tốt và cho chỉ số tin cậy cao. Trong thực tế, nên ưu tiên:
- Giữ nguyên số mức của thang đo gốc khi kế thừa, để kết quả so sánh được với nghiên cứu trước.
- Dùng 5 mức khi người trả lời có trình độ đa dạng hoặc bảng hỏi dài, vì dễ hiểu và nhanh trả lời.
- Dùng 7 mức khi cần phân biệt mức độ tinh hơn và người trả lời quen với khảo sát.
- Nhất quán số mức và chiều của thang trong toàn bộ bảng hỏi.
Câu hỏi đảo chiều
Câu hỏi đảo chiều là phát biểu có nghĩa ngược với khái niệm cần đo, ví dụ "Tôi thấy thất vọng sau các lần mua hàng trên sàn X" trong thang đo sự hài lòng. Loại câu hỏi này giúp phát hiện người trả lời theo quán tính, nhưng cũng có thể gây nhầm lẫn và làm giảm độ tin cậy, thậm chí khiến EFA tách thành một nhân tố riêng chỉ gồm các câu đảo chiều (Weijters và cộng sự, 2013).
Nếu dùng câu hỏi đảo chiều, hãy viết rõ ràng, tránh phủ định kép và mã hóa lại (ví dụ 1 thành 5, 2 thành 4) trước khi tính Cronbach's Alpha hay điểm trung bình. Thao tác này sẽ được hướng dẫn trong bài "Mã hóa lại biến (Recode) và tính biến đại diện".
4. Một số dạng thang đo khác
Ngoài Likert, bảng hỏi trong kinh tế và quản trị còn dùng một số dạng thang đo khác. Ba dạng dưới đây thường gặp nhất.
- Thang đo đối nghĩa (semantic differential): đặt hai tính từ trái nghĩa ở hai đầu, ví dụ "Rẻ ... Đắt", người trả lời chọn vị trí ở giữa (Osgood và cộng sự, 1957). Phù hợp để đo hình ảnh thương hiệu hoặc cảm nhận về sản phẩm.
- Thang đánh giá số: ví dụ chấm điểm từ 0 đến 10. Câu hỏi về khả năng giới thiệu sản phẩm cho người khác thường dùng dạng này.
- Thang xếp hạng (ranking): người trả lời sắp xếp các lựa chọn theo thứ tự ưu tiên. Kết quả là dữ liệu thứ bậc và các giá trị phụ thuộc lẫn nhau, nên không phân tích như các mục Likert độc lập.
5. Cấp độ đo lường quyết định kỹ thuật phân tích
Khi chọn kỹ thuật kiểm định, hãy xác định cấp độ đo lường của biến phụ thuộc và biến độc lập trước (Field, 2024; Hair và cộng sự, 2019). Hình 3 tóm tắt các trường hợp thường gặp trong luận văn.
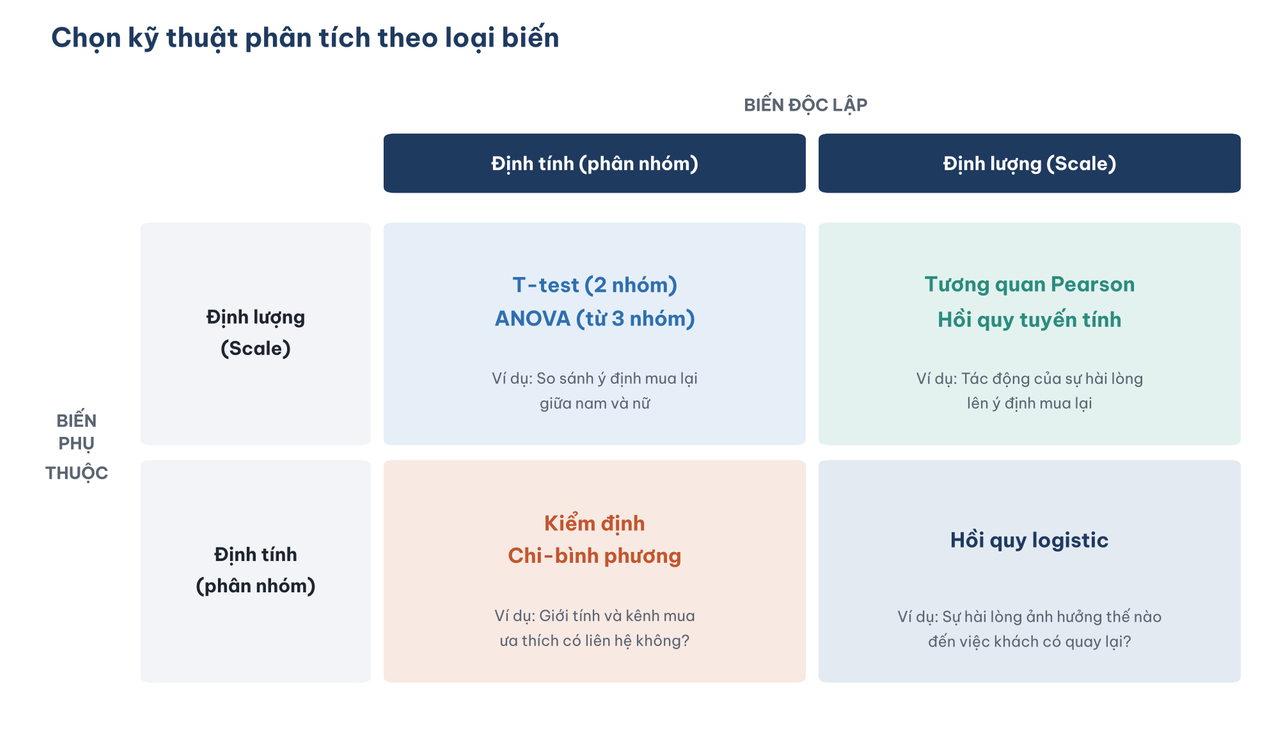
Hình 3. "Định tính" gồm biến định danh và thứ bậc có ít nhóm; "định lượng" gồm biến khoảng và tỷ lệ (Scale trong SPSS). Mỗi kỹ thuật còn có các giả định riêng cần kiểm tra.
Một nguyên tắc thiết kế quan trọng: thu thập dữ liệu ở cấp độ đo lường cao nhất có thể. Bạn luôn có thể chuyển tuổi tính bằng năm (tỷ lệ) thành nhóm tuổi (thứ bậc), nhưng không thể làm ngược lại. Hỏi "Bạn bao nhiêu tuổi?" cho nhiều lựa chọn phân tích hơn hỏi "Bạn thuộc nhóm tuổi nào?", trừ khi câu hỏi về con số chính xác khiến người trả lời ngại trả lời, như thu nhập.
Bốn lỗi thường gặp
Các lỗi về thang đo thường không làm phần mềm báo lỗi. Phần mềm vẫn cho ra con số, chỉ là con số đó không có nghĩa.
- Tính trung bình cho biến định danh. Ví dụ "giới tính trung bình là 1,56" không có ý nghĩa; hãy báo cáo tỷ lệ phần trăm.
- Để mọi biến ở chế độ Scale trong SPSS. Hãy khai báo đúng Measure ngay từ đầu.
- Quên mã hóa lại câu hỏi đảo chiều. Lỗi này làm Cronbach's Alpha thấp bất thường và có thể cho ra hệ số tương quan biến tổng âm.
- Thu thập biến liên tục dưới dạng nhóm khi không cần thiết, làm mất thông tin và giới hạn kỹ thuật phân tích.
Tài liệu tham khảo
Carifio, J., & Perla, R. J. (2007). Ten common misunderstandings, misconceptions, persistent myths and urban legends about Likert scales and Likert response formats and their antidotes. Journal of Social Sciences, 3(3), 106–116. https://doi.org/10.3844/jssp.2007.106.116
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Jamieson, S. (2004). Likert scales: How to (ab)use them. Medical Education, 38(12), 1217–1218. https://doi.org/10.1111/j.1365-2929.2004.02012.x
Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
Norman, G. (2010). Likert scales, levels of measurement and the "laws" of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
Osgood, C. E., Suci, G. J., & Tannenbaum, P. H. (1957). The measurement of meaning. University of Illinois Press. https://www.press.uillinois.edu/books/?id=p745393
Preston, C. C., & Colman, A. M. (2000). Optimal number of response categories in rating scales: Reliability, validity, discriminating power, and respondent preferences. Acta Psychologica, 104(1), 1–15. https://doi.org/10.1016/S0001-6918(99)00050-5
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121