Phân tích công suất, quy tắc của Green và phương pháp căn bậc hai nghịch đảo cho EFA, hồi quy và SEM
Bài nên đọc trước
"Cỡ mẫu bao nhiêu là đủ?" có lẽ là câu hỏi được hỏi nhiều nhất khi viết đề cương. Câu trả lời thường gặp, kiểu "200 là được" hay "cứ 5 lần số biến quan sát", có thể đúng với đề tài này nhưng sai với đề tài khác. Cỡ mẫu không có một con số chung, vì nó phụ thuộc vào kỹ thuật phân tích bạn sẽ dùng, độ phức tạp của mô hình và độ lớn của hiệu ứng bạn muốn phát hiện.
Bài viết này trình bày các phương pháp xác định cỡ mẫu cho từng kỹ thuật thường dùng trong luận văn, rồi áp dụng tất cả vào mô hình mẫu của chuỗi bài: ý định mua lại của khách hàng trên sàn X, với 5 khái niệm và 6 giả thuyết (xem bài "Quy trình nghiên cứu định lượng 7 bước"). Mọi con số trong bài được tính bằng một script Python đi kèm, để bạn tự kiểm tra và tính lại cho đề tài của mình.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
04-co-mau-bao-nhieu-la-ducủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Vì sao cỡ mẫu quan trọng?
Cỡ mẫu quá nhỏ gây ra ba vấn đề:
- Bỏ sót tác động có thật. Mẫu nhỏ làm giảm công suất thống kê (statistical power), tức xác suất phát hiện được một tác động khi tác động đó thực sự tồn tại. Một giả thuyết bị bác bỏ có thể chỉ vì mẫu không đủ lớn, chứ không phải vì mối quan hệ không tồn tại.
- Ước lượng không ổn định. Hệ số hồi quy, hệ số tải nhân tố và hệ số đường dẫn dao động mạnh giữa các mẫu nhỏ.
- Mô hình không hội tụ. Với CB-SEM, mẫu nhỏ dễ làm thuật toán không hội tụ hoặc cho ra ước lượng vô lý, như phương sai âm (Kline, 2023).
Mẫu quá lớn cũng có mặt trái: tốn chi phí và hầu như mọi tác động dù rất nhỏ đều có ý nghĩa thống kê. Vì vậy, khi mẫu lớn, việc báo cáo độ lớn hiệu ứng càng quan trọng.
2. Bốn yếu tố quyết định cỡ mẫu
Về nguyên tắc, cỡ mẫu được xác định từ bốn yếu tố (Cohen, 1992):
- Mức ý nghĩa (α): xác suất kết luận có tác động khi thực tế không có. Thường chọn α = 0,05.
- Công suất (1 − β): xác suất phát hiện tác động khi tác động có thật. Mức thường dùng là 0,80.
- Độ lớn hiệu ứng kỳ vọng: tác động càng nhỏ, càng cần mẫu lớn để phát hiện. Cohen (1992) đề xuất các mức quy ước nhỏ, trung bình và lớn cho từng loại kiểm định; với hồi quy bội, ba mức tương ứng là f² = 0,02; 0,15; và 0,35.
- Độ phức tạp của mô hình: số biến độc lập, số khái niệm, số tham số cần ước lượng.
Các "quy tắc kinh nghiệm" như 5:1 hay 10:1 thực chất là cách ước lượng thô thay cho việc tính toán từ bốn yếu tố trên. Chúng hữu ích để kiểm tra nhanh, nhưng không nên là căn cứ duy nhất.
3. Quy trình xác định cỡ mẫu
Thay vì chọn một con số rồi tìm lý do biện minh, cỡ mẫu nên được xác định theo năm bước trong Hình 1.
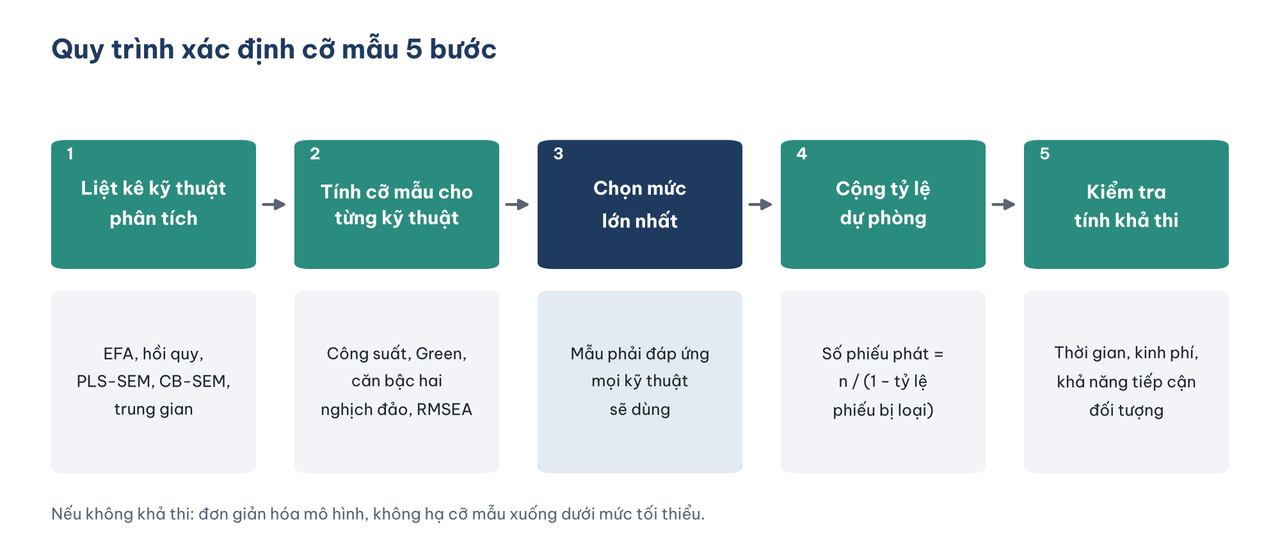
Hình 1. Cỡ mẫu được xác định từ kỹ thuật phân tích, không phải chọn trước rồi mới tìm kỹ thuật phù hợp.
- Liệt kê kỹ thuật phân tích sẽ dùng, đã xác định ở bước xây dựng mô hình (ví dụ: EFA, hồi quy, PLS-SEM).
- Tính cỡ mẫu tối thiểu cho từng kỹ thuật theo phương pháp phù hợp ở mục 4.
- Chọn mức lớn nhất trong các yêu cầu, vì mẫu phải đáp ứng được mọi kỹ thuật.
- Cộng thêm tỷ lệ dự phòng cho phiếu không hợp lệ. Nếu dự kiến loại 15% số phiếu, số phiếu cần phát là n / (1 − 0,15).
- Kiểm tra tính khả thi: thời gian, kinh phí và khả năng tiếp cận đối tượng khảo sát. Nếu không khả thi, hãy cân nhắc đơn giản hóa mô hình chứ không hạ cỡ mẫu xuống dưới mức tối thiểu.
4. Phương pháp theo từng kỹ thuật
Mỗi kỹ thuật phân tích có cách xác định cỡ mẫu riêng. Phần này đi lần lượt từ ước lượng tỷ lệ đến phân tích trung gian.
4.1. Ước lượng tỷ lệ hoặc trung bình: công thức Cochran và Yamane
Hai công thức này rất phổ biến trong luận văn ở Việt Nam, nhưng thường bị dùng sai mục đích. Chúng được thiết kế để ước lượng một tỷ lệ của tổng thể với sai số cho trước, ví dụ tỷ lệ khách hàng hài lòng (Cochran, 1977; Yamane, 1967):
- Cochran (tổng thể lớn): n = z² × p(1 − p) / e². Với độ tin cậy 95% (z = 1,96), p = 0,5 và sai số e = 5%, n ≈ 385.
- Yamane (khi biết quy mô tổng thể N): n = N / (1 + N × e²). Với e = 5%, N = 2.000 cho n = 334; N = 100.000 cho n = 399.
Các công thức này không tính đến số biến, số giả thuyết hay độ lớn hiệu ứng, nên không phải là căn cứ phù hợp cho mục tiêu kiểm định mô hình. Nếu đề tài của bạn có cả mục tiêu mô tả (ước lượng tỷ lệ) và mục tiêu kiểm định mô hình, hãy tính cả hai và lấy mức lớn hơn. Lưu ý thêm: công thức Yamane giả định chọn mẫu ngẫu nhiên đơn giản; áp dụng nó cho một mẫu thuận tiện không làm mẫu trở nên đại diện.
4.2. Phân tích nhân tố khám phá (EFA)
Hair và cộng sự (2019) khuyến nghị cỡ mẫu tối thiểu là 50, tốt hơn là từ 100 trở lên, với tỷ lệ ít nhất 5 quan sát cho mỗi biến quan sát và tốt hơn là 10 quan sát cho mỗi biến.
Áp dụng cho mô hình mẫu: 5 khái niệm × 4 biến quan sát = 20 biến. Tỷ lệ 5:1 cho 100 quan sát; tỷ lệ 10:1 cho 200 quan sát.
4.3. Hồi quy bội: quy tắc của Green và phân tích công suất
Quy tắc của Green (1991) cho hai con số, tùy mục đích kiểm định:
- Kiểm định toàn bộ mô hình (R²): N ≥ 50 + 8m, với m là số biến độc lập.
- Kiểm định từng biến độc lập: N ≥ 104 + m.
Nên lấy con số lớn hơn, vì luận văn thường kiểm định cả hai.
Phân tích công suất bằng G*Power cho kết quả chính xác hơn, vì tính trực tiếp từ bốn yếu tố ở mục 2 (Faul và cộng sự, 2009). Bảng 1 liệt kê các thiết lập trong G*Power.
Bảng 1. Thiết lập phân tích công suất cho hồi quy bội trong G*Power.
| Thiết lập | Giá trị |
|---|---|
| Test family | F tests |
| Statistical test | Linear multiple regression: Fixed model, R² deviation from zero |
| Type of power analysis | A priori |
| Effect size f² | 0,15 (trung bình), hoặc giá trị từ nghiên cứu trước |
| α err prob | 0,05 |
| Power (1 − β err prob) | 0,80 |
| Number of predictors | Số biến độc lập |
Áp dụng cho mô hình mẫu: các bài hướng dẫn SPSS trong loạt bài này hồi quy ý định mua lại theo 3 biến độc lập (nhận thức hữu ích, sự hài lòng, niềm tin), nên m = 3. Bảng 2 so sánh cỡ mẫu tối thiểu theo hai cách.
Bảng 2. Cỡ mẫu tối thiểu cho hồi quy với ba biến độc lập.
| Phương pháp | Cỡ mẫu tối thiểu |
|---|---|
| Green: 50 + 8m | 74 |
| Green: 104 + m | 107 |
| G*Power, f² = 0,35 (lớn) | 36 |
| G*Power, f² = 0,15 (trung bình) | 77 |
| G*Power, f² = 0,02 (nhỏ) | 550 |
Bảng cho thấy độ lớn hiệu ứng ảnh hưởng mạnh thế nào: cùng một mô hình, cỡ mẫu tối thiểu dao động từ 36 đến 550. Vì vậy, hãy chọn độ lớn hiệu ứng dựa trên kết quả của các nghiên cứu trước, không chọn mức "lớn" chỉ để có cỡ mẫu nhỏ.
4.4. PLS-SEM: bỏ quy tắc 10 lần, dùng phương pháp căn bậc hai nghịch đảo
Quy tắc 10 lần (cỡ mẫu bằng 10 lần số mũi tên nhiều nhất trỏ vào một khái niệm) từng rất phổ biến. Tuy nhiên, các tác giả PLS-SEM khuyến nghị không dùng quy tắc này, vì nó không tính đến độ lớn hiệu ứng và thường cho ra cỡ mẫu quá nhỏ (Hair và cộng sự, 2022). Với mô hình mẫu, khái niệm ý định mua lại nhận 3 mũi tên, nên quy tắc 10 lần chỉ cho 30 quan sát, một con số rõ ràng là không đủ.
Phương pháp căn bậc hai nghịch đảo (inverse square root) của Kock và Hadaya (2018) được khuyến nghị thay thế. Với mức ý nghĩa 5% và công suất 80%:
nmin > (2,486 / |pmin|)²
trong đó pmin là hệ số đường dẫn nhỏ nhất mà bạn kỳ vọng có ý nghĩa thống kê. Giá trị này nên lấy từ các nghiên cứu trước dùng mô hình tương tự. Hình 2 vẽ đường cong cỡ mẫu theo công thức trên và Bảng 3 ghi một số điểm trên đường cong đó.
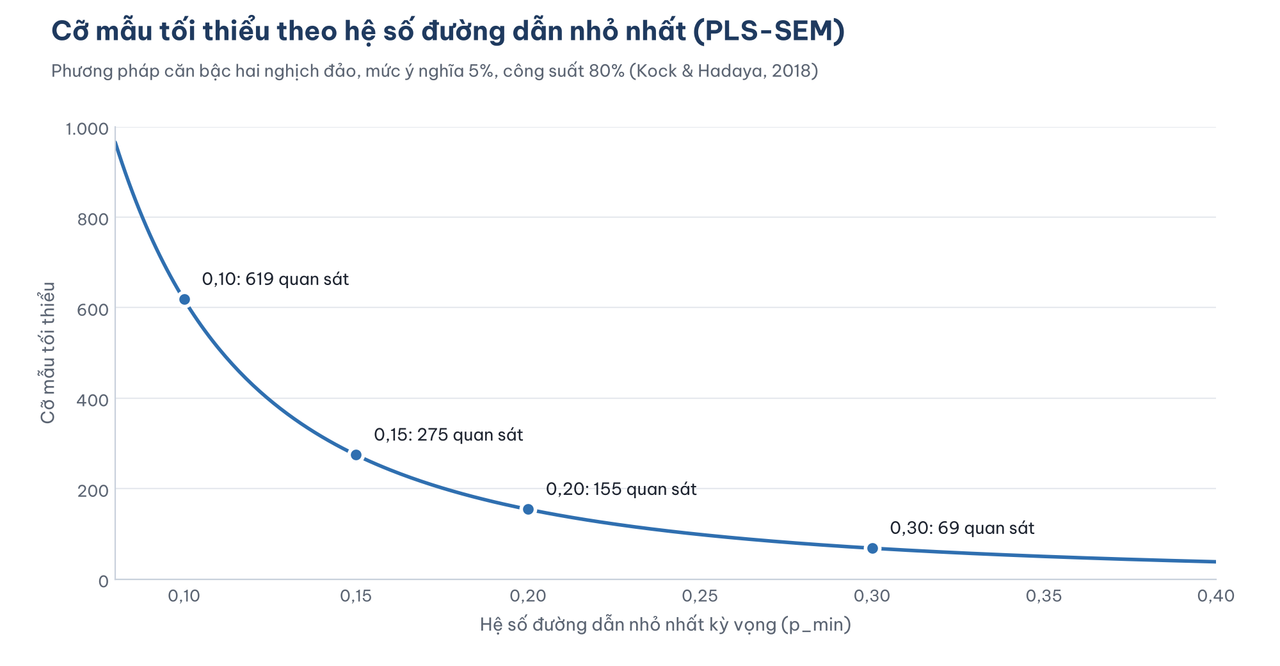
Hình 2. Hệ số đường dẫn nhỏ nhất càng nhỏ, cỡ mẫu cần thiết tăng càng nhanh. Đường cong được tính theo công thức của Kock và Hadaya (2018).
Bảng 3. Cỡ mẫu tối thiểu theo hệ số đường dẫn nhỏ nhất.
| pmin | 0,10 | 0,15 | 0,20 | 0,25 | 0,30 |
|---|---|---|---|---|---|
| Cỡ mẫu tối thiểu | 619 | 275 | 155 | 99 | 69 |
Áp dụng cho mô hình mẫu: giả sử trong các nghiên cứu trước, hệ số đường dẫn nhỏ nhất của các mối quan hệ tương tự là khoảng 0,20 (giá trị giả định để minh họa). Cỡ mẫu tối thiểu là 155 quan sát.
4.5. CB-SEM: từ quy tắc kinh nghiệm đến phân tích công suất
Với CB-SEM, có ba cách tiếp cận, từ đơn giản đến chặt chẽ:
Tỷ lệ quan sát trên tham số (N:q). Kline (2023) nhắc đến tỷ lệ lý tưởng 20 quan sát cho mỗi tham số tự do, hoặc 10:1 ở mức kém hơn, nhưng cũng lưu ý đây chỉ là quy tắc kinh nghiệm thô. Mô hình CFA với 5 khái niệm và 20 biến quan sát có 50 tham số tự do (15 hệ số tải, 20 phương sai sai số, 5 phương sai nhân tố, 10 hiệp phương sai giữa các nhân tố). Tỷ lệ 10:1 cho 500 quan sát, 20:1 cho 1.000 quan sát, cao hơn nhiều so với khả năng của phần lớn luận văn.
Gợi ý theo đặc điểm mô hình. Hair và cộng sự (2019) gợi ý mô hình có từ 5 khái niệm trở xuống, mỗi khái niệm đo bằng hơn 3 biến quan sát và có hệ số communality cao, có thể ước lượng với mẫu khoảng 100 đến 150; trong khi mô hình nhiều khái niệm (trên 6), communality thấp có thể cần trên 500.
Phân tích công suất dựa trên RMSEA. MacCallum và cộng sự (1996) đề xuất tính cỡ mẫu để kiểm định mô hình có phù hợp gần đúng hay không: so sánh giả thuyết RMSEA = 0,05 với RMSEA = 0,08. Cỡ mẫu phụ thuộc vào bậc tự do (df) của mô hình. Với mô hình CFA mẫu (df = 160), cỡ mẫu tối thiểu để đạt công suất 0,80 là 97 quan sát. Mô hình càng nhiều bậc tự do thì cỡ mẫu cần cho kiểm định này càng nhỏ, nên con số này cần được đặt cạnh các yêu cầu khác.
Kết quả mô phỏng của Wolf và cộng sự (2013) cho thấy cỡ mẫu cần thiết cho SEM dao động rất rộng, từ khoảng 30 đến 460 tùy cấu trúc mô hình, số biến quan sát, độ lớn hệ số tải và sự có mặt của biến trung gian. Đây là lý do không nên áp một con số cố định cho mọi mô hình.
4.6. Phân tích trung gian
Mô hình mẫu có sự hài lòng làm biến trung gian. Tác động gián tiếp bằng tích hai hệ số đường dẫn (a × b), nên thường nhỏ hơn mỗi tác động thành phần và cần mẫu lớn hơn để phát hiện. Mô phỏng của Fritz và MacKinnon (2007) với phương pháp bootstrap percentile, loại bootstrap mặc định trong nhiều phần mềm, cho thấy để đạt công suất 0,80:
- Khi cả hai đường a và b ở mức trung bình: khoảng 78 quan sát.
- Khi cả hai đường ở mức nhỏ: khoảng 558 quan sát.
Như vậy, nếu các nghiên cứu trước cho thấy tác động qua sự hài lòng là nhỏ, cỡ mẫu vài trăm quan sát vẫn có thể chưa đủ để phát hiện tác động gián tiếp.
5. Tổng hợp cho mô hình mẫu
Áp dụng các phương pháp trên cho mô hình ý định mua lại trên sàn X, Hình 3 và Bảng 4 cho thấy cỡ mẫu tối thiểu theo từng kỹ thuật.
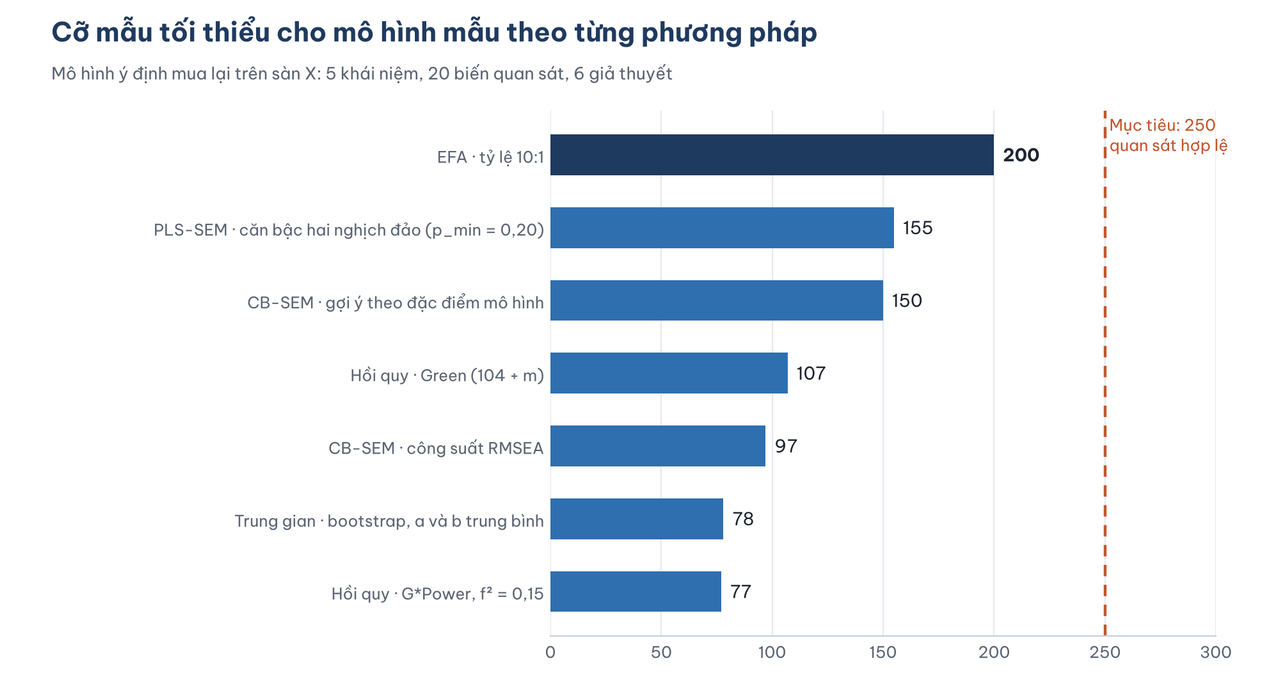
Hình 3. Cỡ mẫu tối thiểu theo từng phương pháp cho mô hình ý định mua lại trên sàn X. Đường nét đứt là cỡ mẫu mục tiêu 250 quan sát hợp lệ.
Bảng 4. Cỡ mẫu tối thiểu theo kỹ thuật cho mô hình mẫu.
| Kỹ thuật | Phương pháp | Cỡ mẫu tối thiểu |
|---|---|---|
| EFA | Tỷ lệ 10:1 (Hair và cộng sự, 2019) | 200 |
| PLS-SEM | Căn bậc hai nghịch đảo, pmin = 0,20 | 155 |
| CB-SEM | Gợi ý theo đặc điểm mô hình (Hair và cộng sự, 2019) | 150 |
| Hồi quy | Green (1991): 104 + m | 107 |
| CB-SEM | Công suất RMSEA (MacCallum và cộng sự, 1996) | 97 |
| Trung gian | Bootstrap, a và b trung bình (Fritz & MacKinnon, 2007) | 78 |
| Hồi quy | G*Power, f² = 0,15 | 77 |
Áp dụng quy trình ở mục 3:
- Mức lớn nhất trong các yêu cầu là 200 (EFA với tỷ lệ 10:1).
- Chọn cỡ mẫu mục tiêu 250 quan sát hợp lệ để có thêm biên an toàn. Với 250 quan sát, PLS-SEM phát hiện được hệ số đường dẫn nhỏ nhất khoảng 0,16, tức nhỏ hơn mức giả định 0,20.
- Dự kiến loại 15% số phiếu do không đạt câu gạn lọc hoặc trả lời qua loa: số phiếu cần phát là 250 / 0,85 ≈ 295, làm tròn thành 300 phiếu.
6. Viết phần cỡ mẫu trong Chương 3
Hội đồng thường không chỉ hỏi "cỡ mẫu bao nhiêu" mà hỏi "căn cứ vào đâu". Một đoạn trình bày tốt nêu rõ kỹ thuật, phương pháp tính, tham số đầu vào và kết quả. Ví dụ:
Nghiên cứu sử dụng EFA và PLS-SEM. Với 20 biến quan sát, EFA cần tối thiểu 200 quan sát theo tỷ lệ 10:1 (Hair và cộng sự, 2019). Với PLS-SEM, áp dụng phương pháp căn bậc hai nghịch đảo (Kock & Hadaya, 2018) với hệ số đường dẫn nhỏ nhất kỳ vọng là 0,20, dựa trên các nghiên cứu trước, cỡ mẫu tối thiểu là 155. Nghiên cứu chọn cỡ mẫu mục tiêu là 250 quan sát hợp lệ. Dự kiến 15% phiếu không hợp lệ, tác giả phát ra 300 phiếu.
Năm lỗi thường gặp
Phần lớn sai sót về cỡ mẫu đến từ việc dùng một quy tắc đúng cho sai kỹ thuật.
- Dùng công thức Yamane hoặc Cochran làm căn cứ duy nhất cho đề tài kiểm định mô hình. Các công thức này phục vụ ước lượng tỷ lệ, không tính đến số biến hay độ lớn hiệu ứng.
- Áp dụng quy tắc 10 lần cho PLS-SEM. Quy tắc này thường cho cỡ mẫu quá nhỏ và không còn được khuyến nghị.
- Chọn độ lớn hiệu ứng "lớn" để có cỡ mẫu nhỏ, trong khi các nghiên cứu trước cho thấy tác động chỉ ở mức trung bình hoặc nhỏ.
- Tính cỡ mẫu cho số phiếu phát ra thay vì số phiếu hợp lệ. Cỡ mẫu tối thiểu là số quan sát còn lại sau khi làm sạch dữ liệu.
- Cho rằng mẫu lớn bù được cho mẫu không đại diện. Một mẫu thuận tiện 1.000 người vẫn là mẫu thuận tiện. Cỡ mẫu giải quyết vấn đề công suất, không giải quyết vấn đề tính đại diện.
Tài liệu tham khảo
Cochran, W. G. (1977). Sampling techniques (3rd ed.). Wiley. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160. https://doi.org/10.3758/BRM.41.4.1149
Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x
Green, S. B. (1991). How many subjects does it take to do a regression analysis? Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227–261. https://doi.org/10.1111/isj.12131
MacCallum, R. C., Browne, M. W., & Sugawara, H. M. (1996). Power analysis and determination of sample size for covariance structure modeling. Psychological Methods, 1(2), 130–149. https://doi.org/10.1037/1082-989X.1.2.130
Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237
Yamane, T. (1967). Statistics: An introductory analysis (2nd ed.). Harper & Row.