Vì sao độ chính xác 96% có thể vô nghĩa, và cách chọn ngưỡng của một mô hình AI theo chi phí của từng loại sai lầm
Giả sử đội dữ liệu báo cáo với ban giám đốc: "Mô hình phát hiện đơn hàng gian lận của chúng ta đạt độ chính xác 96,2%." Cả phòng họp gật đầu hài lòng. Nhưng con số ấy tốt hay tệ? Không thể trả lời nếu chưa biết thêm hai điều: gian lận hiếm đến mức nào, và mỗi loại sai lầm của mô hình tốn bao nhiêu tiền. Một mô hình không làm gì cả, chỉ đơn giản kết luận "không có đơn nào gian lận", có thể đạt độ chính xác còn cao hơn thế.
Người quản lý không cần biết cách huấn luyện mô hình, nhưng cần biết cách đọc con số đánh giá mô hình, vì đó là thứ họ dựa vào để quyết định mua, triển khai hay dừng một hệ thống AI. Công cụ để đọc những con số ấy là ma trận nhầm lẫn (confusion matrix), một bảng hai hàng hai cột đơn giản nhưng chứa gần như mọi thông tin cần thiết.
Bài viết gồm năm mục. Mục 1 giới thiệu ma trận nhầm lẫn qua một ví dụ cụ thể. Mục 2 giải thích nghịch lý độ chính xác. Mục 3 trình bày các chỉ số thay thế: độ chuẩn xác, độ phủ, cùng cặp độ nhạy và độ đặc hiệu quen thuộc trong y khoa. Mục 4 cho thấy chọn ngưỡng của mô hình là một quyết định kinh doanh, có thể tính bằng tiền. Mục 5 tách ma trận theo nhóm khách hàng để kiểm tra công bằng, rồi tổng kết các câu hỏi nên đặt khi nhà cung cấp chào một mô hình.
1. Ma trận nhầm lẫn
Ví dụ xuyên suốt bài là Nhà Vui Home, một chuỗi bán lẻ nội thất giả định có kênh bán trực tuyến. Trong một tháng, họ có 10.000 đơn hàng trực tuyến, trong đó 200 đơn là gian lận (2%). Mô hình gắn cờ 500 đơn đáng ngờ để nhân viên kiểm tra; trong 500 đơn ấy có 160 đơn gian lận thật. Mọi kết quả của một mô hình phân loại hai lớp rơi vào một trong bốn ô như Hình 1.
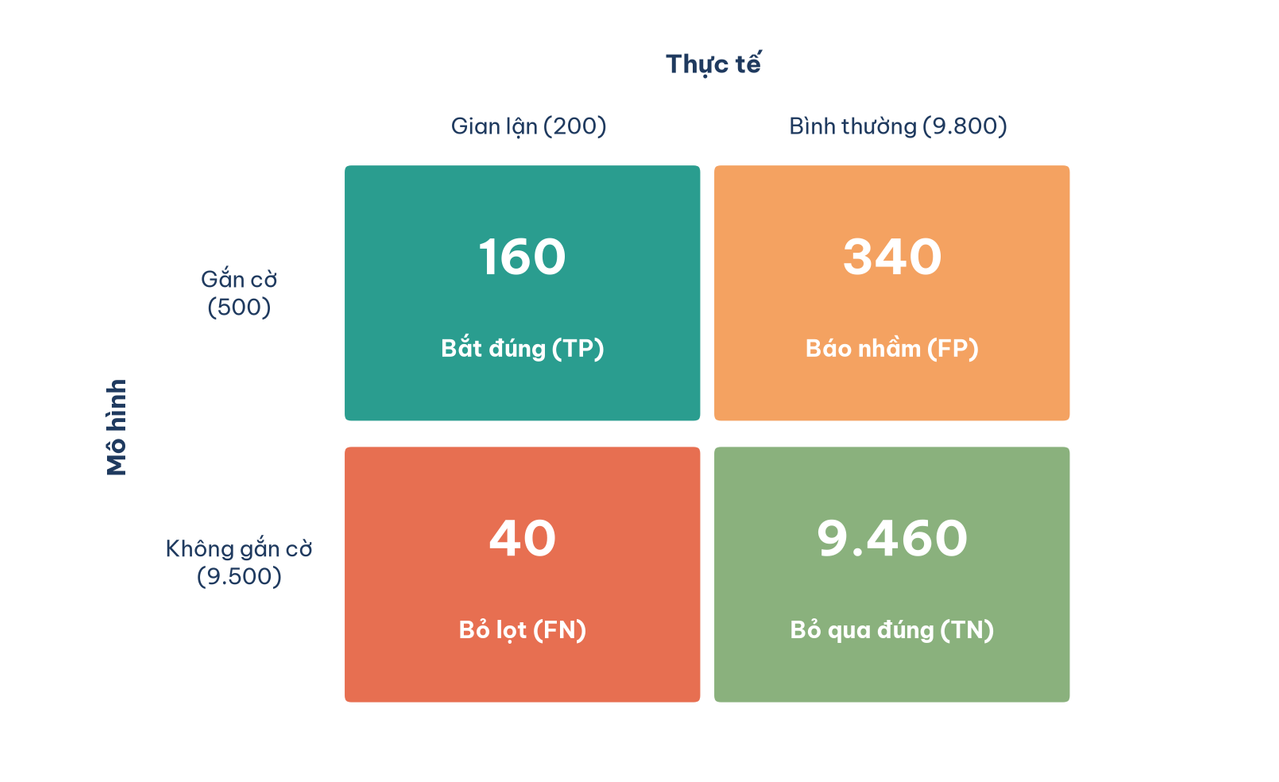
Hình 1. Ma trận nhầm lẫn của mô hình phát hiện đơn gian lận (số liệu giả định).
Bốn ô của Hình 1 có bốn tên gọi. Bắt đúng (true positive, TP) là đơn gian lận bị gắn cờ: 160 đơn. Báo nhầm (false positive, FP) là đơn bình thường bị gắn cờ: 500 − 160 = 340 đơn. Bỏ lọt (false negative, FN) là đơn gian lận không bị gắn cờ: 200 − 160 = 40 đơn. Bỏ qua đúng (true negative, TN) là đơn bình thường không bị gắn cờ: 9.800 − 340 = 9.460 đơn. Điểm quan trọng nhất là hai loại sai lầm, báo nhầm và bỏ lọt, thường có chi phí rất khác nhau. Gộp chúng lại thành một con số "sai" là đánh mất thông tin quan trọng nhất.
2. Nghịch lý độ chính xác
Độ chính xác tổng thể (accuracy) là tỉ lệ dự đoán đúng trên tổng số trường hợp: (160 + 9.460) / 10.000 = 96,2%. Đây chính là con số trong phòng họp ở đầu bài.
Bây giờ hãy xét một "mô hình" lười biếng không gắn cờ đơn nào. Nó đúng với cả 9.800 đơn bình thường và sai với 200 đơn gian lận, nên độ chính xác là 9.800 / 10.000 = 98%, cao hơn mô hình thật. Đó là nghịch lý độ chính xác: khi một lớp rất hiếm, độ chính xác tổng thể bị lớp phổ biến chi phối và gần như vô nghĩa. Gian lận, khách rời bỏ, máy móc hỏng hóc, bệnh hiếm, những bài toán doanh nghiệp quan tâm nhất lại thường đúng là loại bài toán có lớp hiếm. Bài Bài học thống kê từ một tấm meme có thêm ví dụ về việc tỉ lệ nền bị bỏ quên dẫn đến kết luận sai thế nào.
3. Độ chuẩn xác, độ phủ, độ nhạy và độ đặc hiệu
Các chỉ số dưới đây khắc phục nghịch lý bằng cách nhìn riêng vào từng cột hoặc từng hàng của ma trận nhầm lẫn thay vì gộp cả bốn ô. Chúng trả lời những câu hỏi khác nhau mà những nhóm người khác nhau trong doanh nghiệp quan tâm.
3.1. Hai công thức, hai mẫu số
Độ chuẩn xác (precision) và độ phủ (recall) được tính như sau:
Độ chuẩn xác = TP / (TP + FP)
Độ phủ = TP / (TP + FN)
Độ chuẩn xác trả lời câu hỏi "trong những đơn bị gắn cờ, bao nhiêu phần là gian lận thật?"; ở ví dụ là 160 / 500 = 32%. Độ phủ trả lời câu hỏi "trong những đơn gian lận thật, mô hình bắt được bao nhiêu phần?"; ở ví dụ là 160 / 200 = 80%. Mẫu số là chỗ khác biệt then chốt: độ chuẩn xác chia cho số đơn mô hình gắn cờ, độ phủ chia cho số đơn thực sự gian lận. Nhân viên kiểm tra cảm nhận độ chuẩn xác, tức bao nhiêu lần họ phải gọi điện cho một khách hoàn toàn trung thực. Giám đốc tài chính cảm nhận độ phủ, tức bao nhiêu tiền vẫn bị mất.
3.2. Độ nhạy và độ đặc hiệu
Trong y khoa và thống kê, người ta thường mô tả một phép kiểm tra bằng một cặp chỉ số khác. Độ nhạy (sensitivity) là tỉ lệ trường hợp dương tính thật được phát hiện; nó chính là độ phủ dưới một tên khác, còn gọi là tỉ lệ dương tính thật (true positive rate). Độ đặc hiệu (specificity) là tỉ lệ trường hợp âm tính thật được nhận đúng là âm tính:
Độ nhạy = TP / (TP + FN)
Độ đặc hiệu = TN / (TN + FP)
Ở ví dụ, độ nhạy là 160 / 200 = 80%, và độ đặc hiệu là 9.460 / 9.800 ≈ 96,5%: trong 9.800 đơn bình thường, mô hình để yên 9.460 đơn. Phần bù của độ đặc hiệu là tỉ lệ báo nhầm (false positive rate), 340 / 9.800 ≈ 3,5%, tức xác suất một khách trung thực bị gắn cờ oan.
Cặp chỉ số này có một tính chất quan trọng: cả hai đều chia cho số trường hợp thực tế của từng lớp (cột của ma trận), nên không phụ thuộc vào tỉ lệ nền. Một mô hình có độ nhạy 80% và độ đặc hiệu 96,5% sẽ giữ nguyên hai con số đó dù gian lận chiếm 2% hay 10% số đơn. Độ chuẩn xác thì khác: nó chia cho số đơn bị gắn cờ (hàng của ma trận), nên giảm mạnh khi lớp cần tìm hiếm đi. Đó là lý do một phép xét nghiệm có độ nhạy và độ đặc hiệu đều cao vẫn có thể cho rất nhiều kết quả dương tính giả khi bệnh hiếm, và cũng là lý do độ chuẩn xác chỉ 32% trong ví dụ dù độ đặc hiệu tới 96,5%. Bài Bài học thống kê từ một tấm meme cho thêm ví dụ về vai trò của tỉ lệ nền.
Khi vẽ độ nhạy theo tỉ lệ báo nhầm (bằng 1 trừ độ đặc hiệu) ở mọi ngưỡng có thể, ta được đường cong ROC (receiver operating characteristic), một cách phổ biến để so sánh các mô hình mà không phải chọn trước một ngưỡng; diện tích dưới đường cong (AUC) càng gần 1 thì mô hình phân biệt hai lớp càng tốt (Fawcett, 2006). Mục 4 sẽ cho thấy vì sao cuối cùng doanh nghiệp vẫn phải chọn một ngưỡng cụ thể.
3.3. Chọn chỉ số theo câu hỏi kinh doanh
Không có chỉ số nào tốt nhất cho mọi trường hợp. Bảng 1 tóm tắt bốn chỉ số và tình huống mà mỗi chỉ số quan trọng nhất.
Bảng 1. Bốn chỉ số đánh giá và câu hỏi mỗi chỉ số trả lời
| Chỉ số | Câu hỏi trả lời | Ở ví dụ | Quan trọng nhất khi |
|---|---|---|---|
| Độ chính xác tổng thể (accuracy) | Mô hình đúng bao nhiêu phần trên tất cả? | 96,2% | Các lớp có kích thước tương đương và hai loại sai tốn như nhau |
| Độ chuẩn xác (precision) | Trong số bị gắn cờ, bao nhiêu là thật? | 32% | Báo nhầm tốn kém: làm phiền khách tốt, tốn công kiểm tra |
| Độ phủ hay độ nhạy (recall, sensitivity) | Trong số trường hợp thật, bắt được bao nhiêu? | 80% | Bỏ lọt tốn kém: mất tiền, bỏ sót bệnh, bỏ sót lỗi an toàn |
| Độ đặc hiệu (specificity) | Trong số trường hợp bình thường, để yên được bao nhiêu? | 96,5% | Cần bảo đảm người vô tội ít bị làm phiền, như sàng lọc hàng loạt |
Bảng 1 cho thấy chọn sai chỉ số là đang tối ưu cho câu hỏi mà doanh nghiệp không hỏi. Một hệ thống lọc thư rác nên ưu tiên độ chuẩn xác, vì đẩy nhầm một email quan trọng vào thư rác tốn kém hơn để lọt một thư quảng cáo. Một hệ thống sàng lọc lỗi an toàn sản phẩm nên ưu tiên độ phủ, vì bỏ sót một lỗi có thể gây tai nạn. Bài Học máy qua chuyện Tấm Cám giải thích bằng ví dụ dân gian vì sao một mô hình có thể đúng nhiều mà vẫn sai đúng chỗ quan trọng.
4. Ngưỡng quyết định là một quyết định kinh doanh
Mô hình không trực tiếp nói "gian lận" hay "không". Nó cho mỗi đơn một xác suất, rồi một ngưỡng (threshold) quyết định từ xác suất bao nhiêu trở lên thì gắn cờ. Hạ ngưỡng thì gắn cờ nhiều hơn: độ phủ tăng, độ chuẩn xác giảm. Nâng ngưỡng thì ngược lại. Không có ngưỡng "đúng" về mặt kỹ thuật; ngưỡng đúng là ngưỡng có tổng chi phí thấp nhất.
4.1. Tính chi phí theo từng ngưỡng
Với Nhà Vui Home, mỗi vụ gian lận lọt lưới tốn trung bình 3 triệu đồng (giá vốn hàng và phí giao), còn kiểm tra thủ công một đơn bị gắn cờ tốn 50.000 đồng. Ở ngưỡng 0,5 như trên, tổng chi phí là 40 × 3 triệu + 500 × 50.000 = 145 triệu đồng, so với 600 triệu đồng nếu không dùng mô hình (200 vụ gian lận lọt hết). Bảng 2 lặp lại phép tính cho năm ngưỡng.
Bảng 2. Cùng một mô hình, năm ngưỡng gắn cờ (số liệu giả định)
| Ngưỡng | Số đơn gắn cờ | Bắt đúng | Độ chuẩn xác | Độ nhạy (độ phủ) | Độ đặc hiệu | Độ chính xác tổng thể | Tổng chi phí (triệu đồng) |
|---|---|---|---|---|---|---|---|
| 0,9 | 60 | 50 | 83,3% | 25,0% | 99,9% | 98,4% | 453 |
| 0,7 | 180 | 120 | 66,7% | 60,0% | 99,4% | 98,6% | 249 |
| 0,5 | 500 | 160 | 32,0% | 80,0% | 96,5% | 96,2% | 145 |
| 0,3 | 1.200 | 185 | 15,4% | 92,5% | 89,6% | 89,7% | 105 |
| 0,1 | 3.000 | 196 | 6,5% | 98,0% | 71,4% | 71,9% | 162 |
Hai cột độ nhạy và độ đặc hiệu trong Bảng 2 cho thấy đánh đổi cốt lõi: hạ ngưỡng từ 0,9 xuống 0,1 kéo độ nhạy từ 25% lên 98% nhưng đẩy độ đặc hiệu từ 99,9% xuống 71,4%. Hình 2 đặt hai cột cuối của Bảng 2 lên cùng một biểu đồ để thấy chúng đi ngược chiều nhau ra sao.
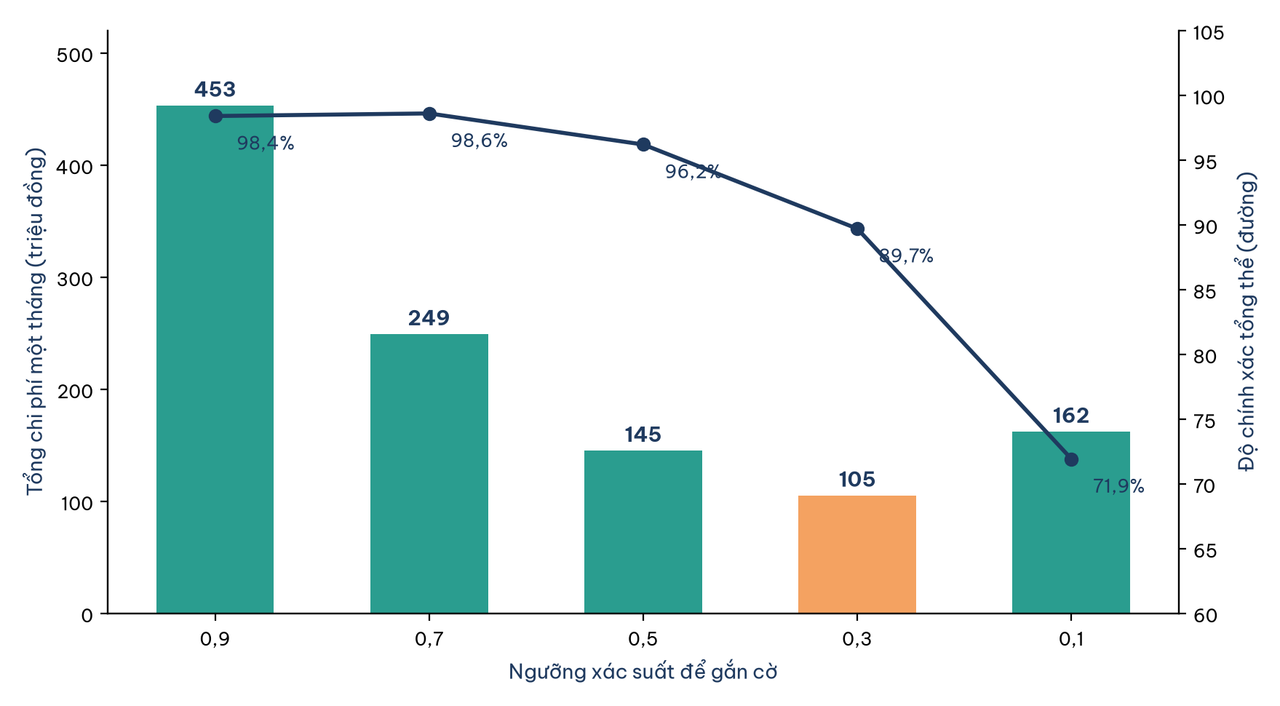
Hình 2. Tổng chi phí và độ chính xác tổng thể theo ngưỡng gắn cờ (số liệu giả định).
4.2. Ngưỡng tốt nhất không phải ngưỡng chính xác nhất
Kết quả ở Hình 2 trái trực giác ở hai điểm. Thứ nhất, ngưỡng 0,7 có độ chính xác tổng thể cao nhất (98,6%) nhưng tốn 249 triệu đồng, gần gấp rưỡi ngưỡng 0,5. Thứ hai, ngưỡng rẻ nhất là 0,3, với độ chính xác tổng thể chỉ 89,7% và độ chuẩn xác khoảng 15%, tức cứ bảy đơn bị kiểm tra thì sáu đơn là khách tốt. Lựa chọn này hợp lý chỉ vì bỏ lọt một vụ đắt gấp 60 lần kiểm tra một đơn. Nếu chi phí kiểm tra tăng, chẳng hạn vì mỗi lần kiểm tra phải gọi điện làm phiền khách và có thể mất khách, ngưỡng tối ưu sẽ dịch lên.
Đây là một ví dụ cụ thể của cách phân biệt dự đoán và phán đoán mà Agrawal, Gans và Goldfarb đề xuất: máy cung cấp dự đoán, còn con người cung cấp phán đoán về hậu quả của từng lựa chọn (Agrawal và cộng sự, 2022). Mô hình cho xác suất; chọn ngưỡng là phán đoán, vì nó phụ thuộc vào chi phí của từng loại sai lầm, thứ mà chỉ doanh nghiệp biết. Giao việc chọn ngưỡng cho đội kỹ thuật, những người thường mặc định 0,5 hoặc tối ưu độ chính xác tổng thể, là giao một quyết định kinh doanh cho người không có thông tin để ra quyết định đó. Bài Đo giá trị dự án AI trước khi đầu tư mở rộng cách tính này thành một business case đầy đủ.
5. Tách ma trận theo nhóm để kiểm tra công bằng
Một ma trận nhầm lẫn tổng có thể che giấu khác biệt lớn giữa các nhóm khách hàng. Mục này tách ma trận của Nhà Vui Home theo hai nhóm, rồi đúc kết thành những câu hỏi nên đặt cho bất kỳ mô hình phân loại nào.
5.1. Cùng một mô hình, hai nhóm khách
Trong một quý, mô hình xem xét 8.000 đơn từ các thành phố lớn và 2.000 đơn từ các tỉnh. Đơn bị gắn cờ sẽ bị giữ lại chờ xác minh, khiến khách thật phải chờ thêm vài ngày. Tỉ lệ gian lận thật khác nhau giữa hai nhóm: 2% ở thành phố, 6% ở tỉnh, chẳng hạn vì giao hàng xa khó xác minh hơn. Bảng 3 tách các chỉ số theo hai nhóm.
Bảng 3. Chỉ số của mô hình gian lận theo hai nhóm khách (số liệu giả định)
| Chỉ số | Thành phố (8.000 đơn) | Tỉnh (2.000 đơn) | Câu hỏi công bằng đằng sau |
|---|---|---|---|
| Độ phủ (độ nhạy) | 80% | 80% | Người thật sự gian lận có bị bắt như nhau? |
| Độ chuẩn xác | 45,7% | 45,7% | Cờ đỏ có đáng tin như nhau ở mọi nhóm? |
| Độ đặc hiệu | 98,1% | 93,9% | Khách trung thực có được để yên như nhau? |
| Tỉ lệ báo nhầm (1 − độ đặc hiệu) | 1,9% | 6,1% | Khách trung thực có bị làm phiền như nhau? |
| Tỉ lệ bị gắn cờ | 3,5% | 10,5% | Mọi nhóm có bị đối xử như nhau về kết quả? |
Bảng 3 cho thấy mô hình bắt gian lận tốt như nhau (cùng độ nhạy) và gắn cờ chính xác như nhau ở hai nhóm, nhưng độ đặc hiệu ở nhóm tỉnh thấp hơn, nên một khách tỉnh trung thực bị giữ đơn nhầm với xác suất gấp ba khách thành phố. Mô hình "công bằng" hay không tùy theo định nghĩa công bằng nào được chọn.
Có thể sửa mô hình để đạt cả bốn định nghĩa không? Câu trả lời, được chứng minh độc lập bởi hai nhóm nghiên cứu năm 2016–2017, là không, trừ những trường hợp rất đặc biệt. Chouldechova chỉ ra rằng khi tỉ lệ nền khác nhau giữa các nhóm, các tiêu chí công bằng phổ biến không thể cùng lúc được thỏa mãn (Chouldechova, 2017). Kleinberg, Mullainathan và Raghavan chứng minh kết quả tương tự cho điểm rủi ro: không phương pháp nào thỏa đồng thời ba điều kiện công bằng, trừ khi mô hình dự đoán hoàn hảo hoặc tỉ lệ nền bằng nhau (Kleinberg và cộng sự, 2016). Vì vậy công bằng là một lựa chọn có lý do, không phải một phép tính. Trong ví dụ này, một cách giảm hại hiệu quả là đổi hành động từ "giữ đơn ba ngày" sang "gọi xác minh trong hai giờ": thiệt hại cho khách trung thực giảm mạnh mà không phải bỏ lọt thêm vụ gian lận nào. Bài Thiên kiến trong trí tuệ nhân tạo bàn rộng hơn về các nguồn gây bất công của AI.
5.2. Năm câu hỏi khi nhà cung cấp chào một mô hình
Hai nhà cung cấp chào hai mô hình, một báo "độ chính xác 98%", một báo "độ phủ 90%". Người mua dễ chọn con số lớn hơn. Cơ chế của sai lầm là hai con số đo hai thứ khác nhau, có thể trên hai bộ dữ liệu khác nhau, nhưng đều được trình bày như "điểm chất lượng" nên ta so chúng trên cùng một thang. Năm câu hỏi dưới đây giúp tránh bẫy này:
- Ma trận nhầm lẫn đầy đủ trên tập dữ liệu kiểm tra của chính doanh nghiệp mình trông thế nào?
- Tỉ lệ nền của lớp hiếm trong tập kiểm tra có giống thực tế không?
- Mô hình dùng ngưỡng nào, và tổng chi phí thay đổi ra sao khi đổi ngưỡng?
- Các chỉ số có khác nhau giữa các nhóm khách hàng quan trọng không?
- Kết quả được đo khi nào, và mô hình sẽ được theo dõi lại thế nào khi dữ liệu thay đổi?
Câu hỏi thứ năm nhắc rằng một ma trận nhầm lẫn chỉ đúng tại thời điểm đo. Khi hành vi gian lận thay đổi, các con số cũng thay đổi; đó là lý do các chỉ số như tỉ lệ báo nhầm theo nhóm nên nằm trong sổ đăng ký rủi ro, như bài Quản trị rủi ro AI trong doanh nghiệp trình bày.
Kết luận
Một con số độ chính xác cao chưa nói được gì nếu chưa biết lớp cần tìm hiếm đến đâu và mỗi loại sai lầm tốn bao nhiêu. Ma trận nhầm lẫn tách kết quả của mô hình thành bốn ô, trong đó hai loại sai, báo nhầm và bỏ lọt, thường có chi phí rất khác nhau. Độ chuẩn xác, độ phủ (cũng là độ nhạy) và độ đặc hiệu đo những mặt khác nhau của hai loại sai ấy; độ nhạy và độ đặc hiệu không phụ thuộc tỉ lệ nền, còn độ chuẩn xác thì có, và mỗi chỉ số phục vụ một câu hỏi kinh doanh khác nhau.
Bài học thực dụng nhất là ngưỡng của mô hình là một quyết định kinh doanh. Với chi phí bỏ lọt gấp 60 lần chi phí kiểm tra, ngưỡng rẻ nhất trong ví dụ lại có độ chính xác tổng thể thấp nhất nhì. Tách ma trận theo nhóm khách hàng còn cho thấy cùng một mô hình có thể công bằng theo định nghĩa này và bất công theo định nghĩa khác, và đôi khi cách giảm hại tốt nhất không nằm ở mô hình mà ở cách doanh nghiệp dùng kết quả của nó. Nhà quản lý không cần tự xây mô hình, nhưng cần đòi xem ma trận nhầm lẫn và tự nhân nó với bảng chi phí của mình.
Đọc thêm
- Học máy qua chuyện Tấm Cám
- Đo giá trị dự án AI trước khi đầu tư
- Thiên kiến trong trí tuệ nhân tạo
- Định luật Benford trong phát hiện gian lận
- Hồi quy trong thống kê và học máy
- Quản trị rủi ro AI trong doanh nghiệp
Tài liệu tham khảo
Agrawal, A., Gans, J., & Goldfarb, A. (2022). Prediction machines: The simple economics of artificial intelligence (Updated and expanded ed.). Harvard Business Review Press. https://store.hbr.org/product/prediction-machines-updated-and-expanded-the-simple-economics-of-artificial-intelligence/10598
Chouldechova, A. (2017). Fair prediction with disparate impact: A study of bias in recidivism prediction instruments. Big Data, 5(2), 153–163. https://doi.org/10.1089/big.2016.0047
Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
Kleinberg, J., Mullainathan, S., & Raghavan, M. (2016). Inherent trade-offs in the fair determination of risk scores (arXiv:1609.05807). arXiv. https://arxiv.org/abs/1609.05807