Đo khái niệm không quan sát được như hài lòng, niềm tin rồi kiểm tra cách chúng tác động lẫn nhau
Bộ phận marketing của một hãng túi xách cao cấp nói rằng phần lớn khách mua túi của hãng là người "quan tâm đến thời trang" và "coi trọng vật chất". Nghe hợp lý, nhưng ban giám đốc muốn kiểm chứng và muốn biết mỗi đặc điểm quan trọng đến đâu. Khó khăn đầu tiên không nằm ở phân tích mà ở đo lường: "quan tâm đến thời trang" là gì, đo bằng thước nào? Không có cột nào trong cơ sở dữ liệu tên là "mức coi trọng vật chất". Đây là những biến tiềm ẩn (latent variable), khái niệm có thật nhưng không quan sát trực tiếp được, chỉ có thể suy ra từ câu trả lời cho nhiều câu hỏi khảo sát.
Mô hình cấu trúc tuyến tính (structural equation modeling, SEM) được tạo ra cho đúng loại bài toán này. Nó vừa xây dựng biến tiềm ẩn từ các câu hỏi đo lường, vừa ước lượng quan hệ nhân quả giả định giữa các biến tiềm ẩn. Ở Việt Nam, SEM gần như là phương pháp mặc định trong luận văn thạc sĩ và nhiều bài báo ngành quản trị kinh doanh, marketing, hệ thống thông tin. Haughton và cộng sự (2026) dành một chương cho SEM trong cuốn sách về phân tích nhân quả trong kinh doanh và nhìn nó từ góc độ nhân quả: SEM có thể nói gì và không thể nói gì về quan hệ nhân quả.
Bài viết gồm tám phần. Mục 1 giới thiệu cấu trúc hai tầng của SEM và quy ước vẽ sơ đồ. Mục 2 bàn về mô hình đo lường và phân biệt biến tiềm ẩn phản ánh với biến tiềm ẩn cấu tạo. Mục 3 trình bày mô hình cấu trúc, kể cả biến điều tiết. Mục 4 so sánh hai trường phái CB-SEM và PLS-SEM. Mục 5 tóm tắt các tiêu chí đánh giá mô hình. Mục 6 bàn về quan hệ giữa SEM và nhân quả. Mục 7 tổng hợp lỗi thường gặp trong luận văn và mục 8 điểm qua phần mềm.
1. SEM là gì?
SEM thường gồm hai phần. Mô hình đo lường (mô hình ngoài) mô tả cách mỗi biến tiềm ẩn được đo bằng các biến quan sát (manifest variable), thường là câu hỏi khảo sát theo thang Likert. Mô hình cấu trúc (mô hình trong) mô tả và lượng hóa quan hệ giữa các biến tiềm ẩn với nhau và với kết quả quan tâm. Hair và cộng sự (2021) gọi SEM là kỹ thuật "thế hệ thứ hai", phân biệt với các kỹ thuật thế hệ đầu như hồi quy bội hay hồi quy logistic, vốn chỉ làm việc với biến đo trực tiếp.
SEM được biểu diễn bằng sơ đồ đường dẫn (path diagram) với quy ước thống nhất: biến quan sát vẽ trong hình chữ nhật, biến tiềm ẩn và sai số vẽ trong hình bầu dục, mũi tên chỉ hướng tác động giả định và con số trên mũi tên là hệ số đường dẫn. Hình 1 là một mô hình điển hình về hiệu quả công việc của nhân viên, phỏng theo Haughton và cộng sự (2026). Hai biến tiềm ẩn ngoại sinh là sự hài lòng với công việc và động lực làm việc; biến tiềm ẩn nội sinh là hiệu quả công việc, được quyết định bên trong mô hình.
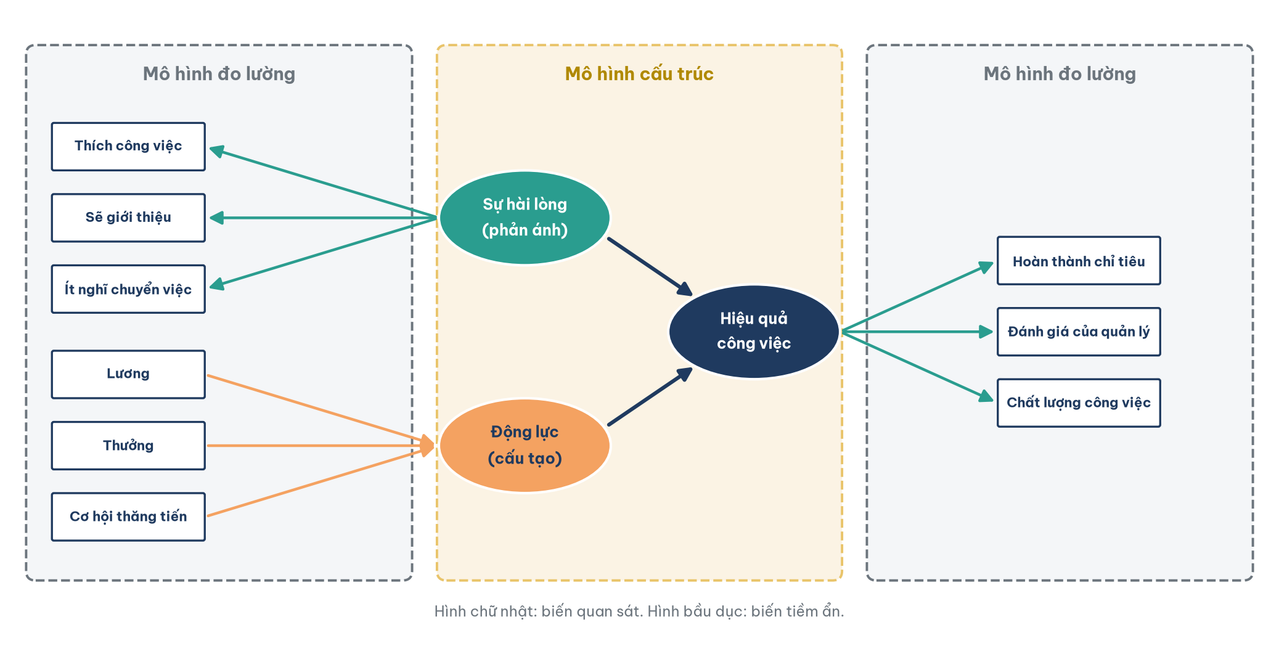
Hình 1. Mô hình đo lường và mô hình cấu trúc trong SEM. Nguồn: dựa trên Haughton và cộng sự (2026).
Haughton và cộng sự (2026) nhấn mạnh rằng ở mức căn bản nhất, SEM là một cách tư duy: nó buộc người phân tích viết rõ biến nào liên quan đến biến nào và theo chiều nào. Sách trích lời một người làm tư vấn rằng thuật toán khai phá dữ liệu cho câu trả lời tốt nhưng gần như vô dụng khi trình bày với khách hàng muốn hiểu vấn đề của họ, còn SEM giúp khách hàng hiểu khách hàng của chính họ.
2. Biến tiềm ẩn và mô hình đo lường
Mô hình đo lường là nền móng của SEM: nếu biến tiềm ẩn đo sai, mọi quan hệ cấu trúc phía sau đều vô nghĩa. Phần này trình bày hai cách quan niệm về biến tiềm ẩn và mối liên hệ với phân tích nhân tố.
2.1. Biến phản ánh và biến cấu tạo
Xét sự hài lòng với công việc, đo bằng ba câu hỏi theo thang năm điểm: "Tôi thích công việc hiện tại", "Tôi sẽ giới thiệu nơi làm việc này cho bạn bè", "Tôi ít khi nghĩ đến việc chuyển chỗ làm". Chiều nhân quả ở đây đi từ biến tiềm ẩn ra câu hỏi: người hài lòng thì trả lời cao ở cả ba câu; câu trả lời không tạo ra sự hài lòng mà chỉ đo nó. Đây là biến tiềm ẩn phản ánh (reflective). Các câu hỏi phải tương quan chặt với nhau và có thể bỏ bớt một câu mà ý nghĩa của khái niệm không đổi.
Động lực làm việc lại khác. Nó được tạo thành từ lương, thưởng và cơ hội thăng tiến: lương cao hơn không phải là biểu hiện của động lực mà là một phần cấu thành động lực. Chiều mũi tên đi từ các thành phần vào biến tiềm ẩn và đây là biến tiềm ẩn cấu tạo (formative). Các thành phần không cần tương quan với nhau (một công ty có thể trả lương cao mà ít cơ hội thăng tiến) và bỏ một thành phần là thay đổi chính khái niệm. Bảng 1 tóm tắt khác biệt.
Bảng 1. Biến tiềm ẩn phản ánh và cấu tạo
| Tiêu chí | Phản ánh (reflective) | Cấu tạo (formative) |
|---|---|---|
| Chiều mũi tên | Từ biến tiềm ẩn ra chỉ báo | Từ chỉ báo vào biến tiềm ẩn |
| Ví dụ | Sự hài lòng, niềm tin, ý định mua | Động lực vật chất, chỉ số địa vị kinh tế xã hội |
| Tương quan giữa các chỉ báo | Phải cao | Không bắt buộc |
| Bỏ một chỉ báo | Ý nghĩa khái niệm giữ nguyên | Ý nghĩa khái niệm thay đổi |
| Kiểm tra độ tin cậy kiểu Cronbach alpha | Phù hợp | Không phù hợp |
| Hỗ trợ trong phần mềm | CB-SEM và PLS-SEM | Chủ yếu PLS-SEM |
Nguồn: tổng hợp từ Haughton và cộng sự (2026) và Hair và cộng sự (2021).
Dòng thứ năm của Bảng 1 là chỗ nhiều luận văn mắc lỗi: tính Cronbach alpha cho một khái niệm cấu tạo rồi loại bớt chỉ báo vì alpha thấp, tức là cắt mất một phần định nghĩa của khái niệm.
2.2. Phân tích nhân tố khám phá và khẳng định
Để hiểu cách SEM ước lượng mô hình đo lường, Haughton và cộng sự (2026) đi đường vòng qua phân tích nhân tố. Ví dụ là phiếu đánh giá môn học cuối kỳ với khoảng 20 câu hỏi. Nhiều câu gần như trùng nhau, nên có thể gom thành vài nhân tố. Phân tích nhân tố khám phá (EFA) để dữ liệu tự quyết định số nhân tố và câu nào thuộc nhân tố nào, thường dùng phương pháp thành phần chính kèm phép xoay Varimax để mỗi câu chỉ "tải" mạnh lên một nhân tố. Kết quả có thể là hai nhân tố, một gồm các câu về việc giảng viên tổ chức lớp tốt ("tổ chức"), một gồm các câu về độ vững kiến thức ("năng lực chuyên môn"). EFA chỉ mô tả và tóm tắt, không kiểm định được gì.
Phân tích nhân tố khẳng định (CFA) đi theo chiều ngược lại: người nghiên cứu chỉ định trước số nhân tố và câu nào đo nhân tố nào, rồi dùng dữ liệu để kiểm tra cấu trúc đó có phù hợp không. Mô hình đo lường của CB-SEM về bản chất chính là một CFA. Trình tự thường gặp trong luận văn (EFA để khám phá, rồi CFA và SEM trên cùng bộ dữ liệu) cần được dùng thận trọng, vì kiểm định một cấu trúc trên chính dữ liệu đã dùng để tìm ra nó không còn là kiểm định thật sự.
3. Mô hình cấu trúc
Mô hình cấu trúc là nơi chứa giả định nhân quả của nghiên cứu. Phần này giải thích vì sao cần áp đặt cấu trúc, cách đọc một mô hình cấu trúc và vai trò của biến điều tiết.
3.1. Vì sao phải áp đặt cấu trúc
Giả sử có ba biến: chất lượng sản phẩm, sự hài lòng của khách và giá trị mua lại. Nếu cho phép mọi biến tác động lên mọi biến khác, mô hình không xác định được, tức không thể ước lượng các hệ số một cách duy nhất. Muốn tiến lên, phải áp đặt cấu trúc, ví dụ chất lượng tác động lên hài lòng, hài lòng tác động lên mua lại. Haughton và cộng sự (2026) phân biệt hai loại giả định. Giả định nhân quả mạnh là đặt một hệ số bằng không, tức khẳng định không có tác động trực tiếp (chất lượng không tác động trực tiếp lên mua lại mà chỉ qua hài lòng). Giả định nhân quả yếu là cho phép hệ số khác không và dữ liệu sẽ cho biết nó lớn đến đâu; giả định yếu kiểm định được. Mô hình cũng phải là đệ quy: các mũi tên đi một chiều, không có vòng phản hồi.
Hình 2 là mô hình của ví dụ túi xách, phỏng theo MacLean và Gray qua trình bày của Haughton và cộng sự (2026): hai biến tiềm ẩn ngoại sinh "quan tâm đến thời trang" và "coi trọng vật chất" cùng tác động lên biến tiềm ẩn nội sinh "khả năng mua túi xách cao cấp". Mỗi biến tiềm ẩn có mô hình đo lường riêng, ví dụ "quan tâm đến thời trang" được đo bằng mức đồng ý với các câu như "Tôi thường mua trang phục theo xu hướng mới nhất".
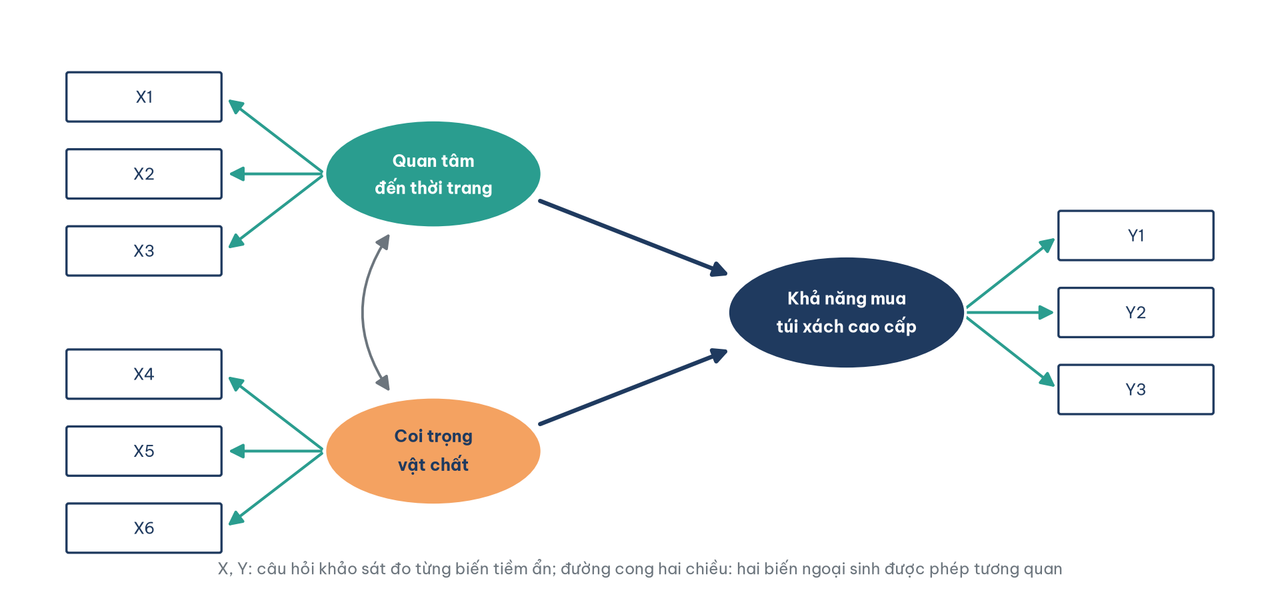
Hình 2. Mô hình SEM cho ví dụ khách hàng túi xách cao cấp. Nguồn: dựa trên MacLean và Gray, dẫn theo Haughton và cộng sự (2026).
3.2. Biến trung gian và biến điều tiết
Hai loại quan hệ hay gặp trong mô hình cấu trúc là trung gian và điều tiết. Biến trung gian nằm trên đường tác động: chất lượng tác động lên mua lại thông qua hài lòng. Biến điều tiết làm thay đổi độ mạnh của một tác động. Haughton và cộng sự (2026) trích nghiên cứu của Vij và Farooq tại khu vực thủ đô Ấn Độ, dựa trên 240 phiếu khảo sát cấp quản lý, về tác động của định hướng chia sẻ tri thức lên kết quả kinh doanh. Định hướng chia sẻ tri thức được đo qua bốn nhân tố (xu hướng chia sẻ ý tưởng, bầu không khí tổ chức, sự ủng hộ của lãnh đạo, văn hóa chia sẻ), kết quả kinh doanh qua ba nhân tố so với đối thủ chính (sự hài lòng, khả năng sinh lời, đổi mới). Hệ số chuẩn hóa của tác động là 0,742 ở doanh nghiệp lớn (trên 250 nhân viên) và 0,678 ở doanh nghiệp nhỏ: quy mô là biến điều tiết. Ngược lại, tác động không khác nhau giữa sản xuất và dịch vụ. Kỹ thuật dùng ở đây là phân tích đa nhóm: ước lượng mô hình riêng cho từng nhóm rồi kiểm định chênh lệch hệ số.
4. Hai trường phái: CB-SEM và PLS-SEM
Người mới học SEM thường bối rối vì có hai họ phương pháp với phần mềm, tiêu chí và cả "trường phái" học thuật khác nhau. Phần này so sánh chúng.
SEM dựa trên hiệp phương sai (covariance-based SEM, CB-SEM) là dạng truyền thống, bắt nguồn từ công trình của Jöreskog. Nó giả định các biến có phân phối chuẩn nhiều chiều và quan hệ tuyến tính, nên có thể ước lượng bằng hợp lý cực đại chỉ từ ma trận hiệp phương sai của các chỉ báo và cho phép kiểm định thống kê mô hình như một tổng thể. Mục tiêu của CB-SEM là xác định xem mô hình đề xuất trước có phù hợp với dữ liệu hay không, chứ không phải đi tìm một mô hình phù hợp. Điểm yếu là giả định phân phối chuẩn có thể không thực tế, mô hình có thể không hội tụ và khó xử lý biến tiềm ẩn cấu tạo.
SEM bình phương tối thiểu từng phần (partial least squares SEM, PLS-SEM) bắt nguồn từ công trình của Wold, thầy của Jöreskog. Nó không cần giả định phân phối chuẩn, ước lượng quan hệ trong mô hình bằng một thuật toán lặp dựa trên hồi quy bình phương tối thiểu, xử lý được biến cấu tạo, mô hình nhiều biến và mẫu nhỏ hơn. PLS-SEM trở nên phổ biến trong quản trị từ khoảng năm 2000. Hair và cộng sự (2012) khảo sát 204 bài báo trên 24 tạp chí marketing hàng đầu và cho thấy mức độ sử dụng tăng nhanh, kèm nhiều vấn đề trong cách báo cáo. Bảng 2 so sánh hai trường phái.
Bảng 2. So sánh CB-SEM và PLS-SEM
| Tiêu chí | CB-SEM | PLS-SEM |
|---|---|---|
| Mục tiêu chính | Kiểm định lý thuyết, khẳng định mô hình | Dự đoán, khám phá, giải thích phương sai của biến kết quả |
| Giả định phân phối | Chuẩn nhiều chiều | Không cần |
| Ước lượng | Hợp lý cực đại trên ma trận hiệp phương sai | Thuật toán lặp với hồi quy bình phương tối thiểu |
| Biến cấu tạo | Khó | Dễ |
| Chỉ số phù hợp tổng thể | Có (chi bình phương, CFI, RMSEA, SRMR) | Không có chỉ số được chấp nhận rộng rãi |
| Mô hình có vòng phản hồi | Có thể (trong một số điều kiện) | Không |
| Phần mềm tiêu biểu | AMOS, lavaan, Mplus, Stata | SmartPLS, seminr, ADANCO |
Nguồn: tổng hợp từ Haughton và cộng sự (2026) và Hair và cộng sự (2021).
Cần nói rõ rằng hai trường phái có quan điểm khác nhau về vai trò của PLS-SEM. Haughton và cộng sự (2026) cho rằng PLS-SEM dùng được cho dự đoán và khám phá nhưng không dùng để kiểm định một lý thuyết có đúng hay không, vì thuật toán mang tính kinh nghiệm, không có tối ưu toàn cục và phân phối mẫu của các hệ số chưa được hiểu đầy đủ. Hair và cộng sự (2021) thì nhấn mạnh rằng PLS-SEM cho ước lượng vững với cả dữ liệu phân phối chuẩn lẫn rất lệch và đặc biệt phù hợp với nghiên cứu muốn đưa ra khuyến nghị thực tiễn cho nhà quản trị. Lời khuyên thực dụng: chọn phương pháp theo mục tiêu nghiên cứu và bản chất biến, nói rõ lý do chọn trong luận văn và diễn giải kết quả theo đúng khả năng của phương pháp đã chọn.
5. Đánh giá mô hình
Một mô hình SEM được đánh giá theo hai tầng: mô hình đo lường trước, mô hình cấu trúc sau. Bảng 3 tổng hợp các tiêu chí phổ biến nhất và ngưỡng thường được dùng.
Bảng 3. Các tiêu chí đánh giá mô hình SEM thường dùng
| Tầng | Tiêu chí | Ngưỡng thường dùng | Áp dụng cho |
|---|---|---|---|
| Đo lường | Hệ số tải của chỉ báo | ≥ 0,70 (0,40–0,70 cân nhắc giữ) | Biến phản ánh |
| Đo lường | Độ tin cậy tổng hợp, Cronbach alpha | ≥ 0,70 | Biến phản ánh |
| Đo lường | Phương sai trích trung bình (AVE) | ≥ 0,50 | Biến phản ánh |
| Đo lường | Giá trị phân biệt (Fornell-Larcker, HTMT) | Căn bậc hai AVE lớn hơn tương quan; HTMT < 0,85 hoặc 0,90 | Biến phản ánh |
| Đo lường | Đa cộng tuyến của chỉ báo (VIF), ý nghĩa của trọng số | VIF < 3 đến 5 | Biến cấu tạo |
| Cấu trúc | Chỉ số phù hợp CFI, TLI | ≥ 0,95 | CB-SEM |
| Cấu trúc | RMSEA, SRMR | ≤ 0,06; ≤ 0,08 | CB-SEM |
| Cấu trúc | R², f², Q² dự đoán, hệ số đường dẫn qua bootstrap | Tùy lĩnh vực; Q² > 0 | PLS-SEM |
Nguồn: tổng hợp từ Fornell và Larcker (1981), Hu và Bentler (1999), Henseler và cộng sự (2015) và Hair và cộng sự (2021).
Các ngưỡng trong Bảng 3 là quy ước, không phải định luật. Hu và Bentler (1999) đề xuất ngưỡng CFI và RMSEA từ nghiên cứu mô phỏng với điều kiện cụ thể và chính các tác giả cảnh báo không nên áp dụng máy móc. Tiêu chí Fornell và Larcker (1981) cho giá trị phân biệt từng là chuẩn mực, nhưng Henseler và cộng sự (2015) cho thấy nó kém nhạy trong nhiều tình huống và đề xuất tỷ số HTMT thay thế. Báo cáo tốt nêu đầy đủ các chỉ số, kể cả những chỉ số không đạt, thay vì chỉ chọn chỉ số đẹp.
6. SEM và nhân quả
Từ "cấu trúc" và các mũi tên trong sơ đồ dễ khiến người đọc nghĩ SEM chứng minh được quan hệ nhân quả. Phần này giải thích vì sao điều đó không đúng và SEM thực sự đóng góp gì cho suy luận nhân quả.
6.1. Dữ liệu có thể bác bỏ, không thể chứng minh
Haughton và cộng sự (2026) dùng ví dụ hồi quy đơn giản để giải thích. Khi đặt y là kết quả và X là biến giải thích, ta đã giả định chiều nhân quả. Nếu hệ số có ý nghĩa, giả định không bị mâu thuẫn; nếu hệ số không khác không, đó là bằng chứng chống lại một phần giả định. Ước lượng không thể xác lập nhân quả, nhưng có thể bác bỏ giả định nhân quả. SEM cũng vậy: một mô hình CB-SEM phù hợp tốt với dữ liệu chỉ nói rằng dữ liệu không mâu thuẫn với mô hình và thường có nhiều mô hình khác, với các mũi tên khác chiều, phù hợp với dữ liệu tốt ngang nhau. Theo các tác giả, PLS-SEM thậm chí không làm được việc kiểm định này vì thiếu chỉ số phù hợp tổng thể.
Bollen và Pearl (2013) phân tích "tám ngộ nhận" về nhân quả và SEM và chỉ ra rằng cả hai cực đều sai: SEM không chứng minh được nhân quả từ dữ liệu, nhưng cũng không phải chỉ là mô hình tương quan. SEM là cách biểu diễn và kiểm tra hệ quả của một tập giả định nhân quả do người nghiên cứu đưa vào. Giá trị nhân quả của kết quả phụ thuộc vào độ tin cậy của các giả định đó.
6.2. Mô hình từ đâu ra?
Vì vậy, câu hỏi quan trọng nhất của một nghiên cứu SEM là mô hình đến từ đâu. Haughton và cộng sự (2026) nhấn mạnh rằng mọi CB-SEM đều cần một mô hình xác định trước, xây từ lý thuyết, hoặc từ một sơ đồ nhân quả học từ dữ liệu, hoặc kết hợp cả hai. Bài Sơ đồ nhân quả trong phân tích dữ liệu trình bày cách dựng sơ đồ đó; khi sơ đồ đã đầy đủ, việc ước lượng nó chính là ước lượng một SEM. Với dữ liệu khảo sát cắt ngang (mọi biến đo cùng một lúc, từ cùng một người trả lời), chiều của mũi tên gần như hoàn toàn do lý thuyết quyết định và còn thêm rủi ro thiên lệch do phương pháp chung: người trả lời có tâm trạng tốt hôm đó sẽ chấm cao mọi câu, tạo ra tương quan giữa các khái niệm.
7. Những lỗi thường gặp trong luận văn
SEM mạnh nhưng không dễ. Hair và cộng sự (2012) đưa ra danh sách 36 thực hành tốt khi tiến hành và báo cáo PLS-SEM, cho thấy có bao nhiêu chỗ có thể sai. Dưới đây là những lỗi hay gặp nhất trong luận văn và bài báo ở Việt Nam, sắp theo trình tự nghiên cứu.
Lỗi thứ nhất là mô hình lắp ghép: ghép năm sáu khái niệm từ các nghiên cứu khác nhau, vẽ mũi tên từ mọi biến độc lập tới biến phụ thuộc mà không lập luận vì sao có hoặc không có mỗi mũi tên. Lỗi thứ hai là nhầm biến cấu tạo thành biến phản ánh, rồi loại chỉ báo theo Cronbach alpha như đã nói ở mục 2. Lỗi thứ ba là chạy theo chỉ số phù hợp: thêm các đường tương quan sai số theo gợi ý của phần mềm cho đến khi CFI vượt 0,9, biến một nghiên cứu khẳng định thành khám phá mà không nói ra. Lỗi thứ tư là kết luận nhân quả từ dữ liệu cắt ngang bằng ngôn ngữ chắc chắn ("X làm tăng Y 0,35 đơn vị"), trong khi thiết kế chỉ cho phép nói "kết quả nhất quán với giả thuyết X tác động lên Y". Lỗi thứ năm là dùng PLS-SEM để "kiểm định lý thuyết" chỉ vì mẫu nhỏ hoặc dữ liệu không chuẩn, mà không thảo luận giới hạn của phương pháp. Lỗi thứ sáu là bỏ qua thiên lệch do phương pháp chung dù mọi biến đều đến từ một phiếu khảo sát.
Hầu hết các lỗi này không nằm ở thao tác phần mềm mà ở thiết kế nghiên cứu. Một mô hình SEM tốt bắt đầu từ một lập luận lý thuyết chặt chẽ cho từng mũi tên, thang đo đã được kiểm chứng, cỡ mẫu đủ lớn so với độ phức tạp của mô hình và cách diễn giải khiêm tốn đúng với thiết kế.
8. Phần mềm
Lựa chọn phần mềm phụ thuộc vào trường phái và mức độ quen thuộc với lập trình. Cho CB-SEM, AMOS (tích hợp với SPSS) có giao diện kéo thả quen thuộc với sinh viên Việt Nam; gói lavaan trong R miễn phí và mạnh; Mplus và Stata được dùng nhiều trong nghiên cứu chuyên sâu. Cho PLS-SEM, SmartPLS là phần mềm phổ biến nhất; gói seminr trong R miễn phí và được Hair và cộng sự (2021) dùng trong cuốn sách hướng dẫn truy cập mở của họ. Dù dùng phần mềm nào, nên lưu lại toàn bộ mô hình dưới dạng mã hoặc tệp dự án để người khác có thể kiểm tra và lặp lại kết quả.
Kết luận
Mô hình cấu trúc tuyến tính giải quyết một vấn đề mà hồi quy thông thường không làm được: đo các khái niệm không quan sát trực tiếp như sự hài lòng, niềm tin hay động lực, đồng thời ước lượng quan hệ giữa chúng. Hai tầng của SEM, mô hình đo lường và mô hình cấu trúc, buộc người nghiên cứu nói rõ mỗi khái niệm được đo thế nào và tác động lên khái niệm nào. Phân biệt biến phản ánh với biến cấu tạo và hiểu khác biệt giữa CB-SEM với PLS-SEM, là hai việc quyết định phần lớn chất lượng của một nghiên cứu.
Từ góc nhìn nhân quả mà Haughton và cộng sự (2026) đề xuất, SEM không chứng minh được nhân quả; dữ liệu chỉ có thể bác bỏ hoặc không bác bỏ những giả định mà người nghiên cứu đưa vào. Giá trị của một mô hình SEM vì thế nằm ở chất lượng của lập luận đằng sau mỗi mũi tên nhiều hơn ở độ đẹp của các chỉ số phù hợp. Khi được dùng với thiết kế nghiêm túc và cách diễn giải khiêm tốn, SEM là công cụ mạnh để hiểu khách hàng, nhân viên và tổ chức, đúng như những người làm tư vấn đã nhận ra.
Đọc thêm
- Sơ đồ nhân quả trong phân tích dữ liệu
- Suy luận nhân quả từ dữ liệu
- Tương quan không phải nhân quả và 5 bẫy cần tránh
- Hồi quy trong thống kê và học máy
- Các công cụ AI cho nghiên cứu như Consensus và Elicit
Tài liệu tham khảo
Bollen, K. A., & Pearl, J. (2013). Eight myths about causality and structural equation models. In S. L. Morgan (Ed.), Handbook of causal analysis for social research (pp. 301–328). Springer. https://doi.org/10.1007/978-94-007-6094-3_15
Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
Hair, J. F., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7
Hair, J. F., Sarstedt, M., Ringle, C. M., & Mena, J. A. (2012). An assessment of the use of partial least squares structural equation modeling in marketing research. Journal of the Academy of Marketing Science, 40(3), 414–433. https://doi.org/10.1007/s11747-011-0261-6
Haughton, D., Haughton, J., & Lo, V. S. Y. (2026). Cause and effect business analytics and data science. CRC Press. https://doi.org/10.1201/9780429172588
Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118