Vì sao cùng một bộ dữ liệu cho hai kết luận trái ngược khi gộp và tách nhóm và cách tránh bị lừa
Hãy hình dung bạn là giám đốc một bệnh viện. Báo cáo trên bàn so sánh hai phương pháp điều trị sỏi thận: phương pháp A thành công 78%, phương pháp B thành công 83%. Lựa chọn có vẻ đã rõ: chọn B.
Rồi một bác sĩ trong hội đồng đề nghị tách số liệu theo kích thước sỏi. Kết quả khiến cả phòng im lặng: với sỏi nhỏ, A tốt hơn B; với sỏi lớn, A cũng tốt hơn B. Vậy làm sao A có thể thắng ở từng nhóm mà vẫn thua khi gộp lại?
Đó là nghịch lý Simpson (Simpson's paradox). Hiện tượng này từng làm đảo ngược kết luận trong y học, giáo dục, thể thao, kinh doanh và cả các vụ kiện. Bài viết lần lượt trả lời bốn câu hỏi: nghịch lý Simpson là gì và vì sao nó xảy ra; nó xuất hiện ở đâu trong thực tế; khi gặp nó, nên tin số liệu gộp hay số liệu tách nhóm; và làm thế nào để phát hiện, xử lý, phòng tránh nó một cách có hệ thống. Mục 1 định nghĩa nghịch lý và điểm lại lịch sử. Mục 2 giải phẫu ví dụ sỏi thận, mục 3 trình bày năm tình huống thực tế. Mục 4 bàn về câu hỏi then chốt: gộp hay tách, kèm một ví dụ kinh doanh đọc bằng sơ đồ nhân quả. Ba mục tiếp theo lần lượt trình bày cách phòng tránh từ khâu thiết kế, cách nhận diện khi phân tích, và cách xử lý đúng sau khi phát hiện. Mục 8 tổng hợp những tình huống dễ gặp theo từng ngành, và mục 9 trả lời một số thắc mắc thường gặp.
1. Nghịch lý Simpson là gì?
Nghịch lý Simpson là hiện tượng một xu hướng xuất hiện nhất quán trong từng nhóm dữ liệu, nhưng yếu đi, biến mất hoặc đảo ngược khi các nhóm được gộp lại (Simpson, 1951; Blyth, 1972).
Đây không phải một mâu thuẫn logic. Số liệu gộp và số liệu tách nhóm đều đúng về mặt số học. Thứ bị đánh lừa là trực giác: ta mặc định rằng nếu A tốt hơn B ở mọi nhóm thì A cũng tốt hơn B nói chung. Trực giác ấy chỉ sai trong một hoàn cảnh cụ thể, khi các phương án được so sánh có cơ cấu nhóm khác nhau. Phần sau sẽ chỉ ra chính xác hoàn cảnh đó.
1.1. Một chút lịch sử
Nghịch lý mang tên Simpson nhưng không phải do Simpson phát hiện đầu tiên. Bốn mốc dưới đây cho thấy hiện tượng đã được nhận ra từ cuối thế kỷ 19.
- 1899: Pearson và cộng sự lưu ý rằng trộn các nhóm không đồng nhất có thể tạo ra tương quan giả (Pearson et al., 1899).
- 1903: Yule phân tích những trường hợp tương tự khi nghiên cứu sự kết hợp giữa các thuộc tính (Yule, 1903). Vì vậy hiện tượng này đôi khi được gọi là hiệu ứng Yule–Simpson.
- 1951: Edward H. Simpson công bố phân tích chi tiết trên bảng ngẫu nhiên (contingency table) nhiều chiều (Simpson, 1951).
- 1972: Colin Blyth gọi nó là "nghịch lý Simpson", và cái tên này được dùng phổ biến từ đó (Blyth, 1972).
2. Giải phẫu một ví dụ: điều trị sỏi thận
Tình huống mở đầu dựa trên số liệu thật. Charig và cộng sự (1986) so sánh các phương pháp điều trị sỏi thận; Julious và Mullee (1994) sau đó dùng phần so sánh giữa phẫu thuật mở (A) và tán sỏi qua da (B) để minh họa nghịch lý Simpson. Đây là một nghiên cứu quan sát: bác sĩ tự chọn phương pháp cho từng bệnh nhân, không có phân bổ ngẫu nhiên (Bảng 1).
Bảng 1. Tỷ lệ điều trị sỏi thận thành công theo loại sỏi. Nguồn: dựa trên Charig và cộng sự (1986), Julious và Mullee (1994).
| Loại sỏi | Phương pháp A | Phương pháp B | Bên tốt hơn |
|---|---|---|---|
| Sỏi nhỏ | 81/87 = 93,1% | 234/270 = 86,7% | A |
| Sỏi lớn | 192/263 = 73,0% | 55/80 = 68,8% | A |
| Tổng thể | 273/350 = 78,0% | 289/350 = 82,6% | B |
2.1. Bước 1: nhìn vào cơ cấu ca bệnh
Chìa khóa nằm ở việc mỗi phương pháp nhận loại bệnh nhân nào (Bảng 2):
Bảng 2. Cơ cấu ca bệnh của hai phương pháp
| Cơ cấu ca bệnh | Phương pháp A | Phương pháp B |
|---|---|---|
| Sỏi lớn (ca khó) | 263/350 = 75% | 80/350 = 23% |
| Sỏi nhỏ (ca dễ) | 87/350 = 25% | 270/350 = 77% |
Hình 1 đặt các tỷ lệ của Bảng 1 cạnh nhau: A cao hơn B ở cả hai nhóm sỏi nhưng thấp hơn ở cột tổng thể.
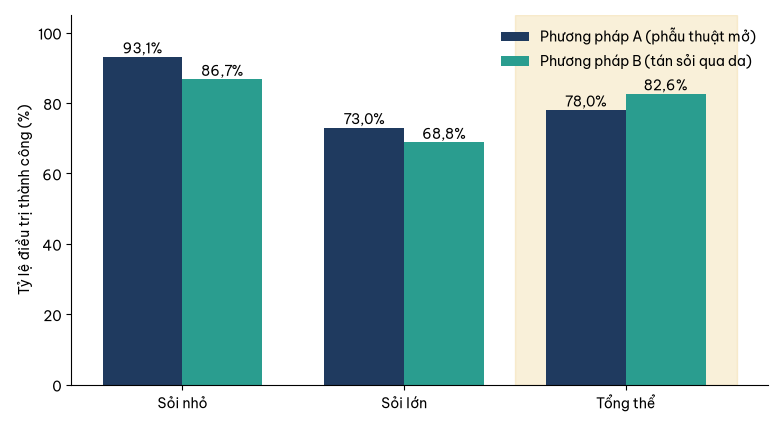
Hình 1. Tỷ lệ điều trị sỏi thận thành công theo loại sỏi và tổng thể. Nguồn: dựa trên Charig và cộng sự (1986), Julious và Mullee (1994).
Phương pháp A chủ yếu được dùng cho ca khó, còn B chủ yếu cho ca dễ. Sỏi lớn vốn khó chữa hơn bất kể dùng phương pháp nào, nên tỷ lệ chung của A bị kéo xuống. B làm chủ yếu ca dễ nên con số chung trông đẹp, dù thực ra kém hơn A ở cả hai loại sỏi.
Kích thước sỏi là biến ẩn: nó ảnh hưởng đồng thời đến việc bác sĩ chọn phương pháp nào và đến khả năng điều trị thành công.
2.2. Bước 2: tỷ lệ chung là trung bình có trọng số
Tỷ lệ tổng thể của mỗi phương án là trung bình của các tỷ lệ trong từng nhóm, có trọng số theo tỷ trọng của nhóm đó trong phương án:
Tỷ lệ tổng thể = Σ (tỷ lệ của nhóm i × tỷ trọng của nhóm i)
Áp vào sỏi thận:
- A: 93,1% × 25% + 73,0% × 75% ≈ 78,0%
- B: 86,7% × 77% + 68,8% × 23% ≈ 82,6%
A đặt 75% trọng số vào nhóm có tỷ lệ nền thấp; B đặt 77% trọng số vào nhóm có tỷ lệ nền cao. Khác biệt về trọng số lớn đến mức lấn át ưu thế của A trong từng nhóm. Đây là cơ chế chung của mọi trường hợp nghịch lý Simpson trong bài.
2.3. Ba điều kiện cần
Nghịch lý chỉ có thể xảy ra khi đồng thời có đủ ba điều kiện:
- Có một biến phân nhóm Z (ở đây là kích thước sỏi).
- Z ảnh hưởng mạnh đến kết quả, tức các nhóm có tỷ lệ nền khác nhau rõ rệt.
- Phân bổ của Z khác nhau giữa các phương án được so sánh.
Thiếu một điều kiện, nghịch lý không thể xảy ra. Đặc biệt, nếu hai phương án có cùng cơ cấu nhóm thì trọng số như nhau và số liệu gộp không thể đảo chiều. Toàn bộ chiến lược phòng tránh ở phần sau đều xoay quanh ý này: làm cho cơ cấu nhóm giống nhau, bằng thiết kế nghiên cứu hoặc bằng điều chỉnh thống kê.
3. Nghịch lý Simpson trong thực tế
Cùng một cơ chế trọng số ấy xuất hiện ở rất nhiều lĩnh vực. Năm ví dụ dưới đây đi từ tuyển sinh, thể thao, kinh doanh đến dịch tễ học, và kết thúc bằng phiên bản dành cho biến liên tục.
3.1. Tuyển sinh sau đại học tại Berkeley (1973)
Kỳ tuyển sinh mùa thu năm 1973, Đại học California, Berkeley bị nghi phân biệt đối xử với nữ giới. Số liệu tổng thể có vẻ rất rõ (Bickel et al., 1975) (Bảng 3):
Bảng 3. Tỷ lệ trúng tuyển sau đại học tại Berkeley năm 1973. Nguồn: dựa trên Bickel và cộng sự (1975).
| Nhóm | Số hồ sơ | Tỷ lệ trúng tuyển |
|---|---|---|
| Nam | khoảng 8.442 | khoảng 44% |
| Nữ | khoảng 4.321 | khoảng 35% |
Chênh lệch 9 điểm phần trăm trên hơn 12.000 hồ sơ khó có thể là ngẫu nhiên. Nhưng khi Bickel và cộng sự phân tích theo từng khoa, phần lớn các khoa không cho thấy thiên vị chống lại nữ; tính chung trên các khoa, dữ liệu còn nghiêng nhẹ về phía nữ.
Lời giải nằm ở nơi nộp đơn. Nữ giới tập trung vào các khoa cạnh tranh cao, tỷ lệ nhận thấp. Nam giới tập trung vào các khoa dễ vào hơn, tỷ lệ nhận cao. Khoảng cách tổng thể phản ánh cơ cấu lựa chọn ngành, không phải cách từng khoa xét hồ sơ.
Câu chuyện chưa dừng ở đó. Vì sao nữ giới lại tập trung vào các ngành khó vào? Câu trả lời có thể nằm ở yếu tố xã hội, giáo dục và định kiến từ trước khi nộp đơn, điều chính Bickel và cộng sự cũng lưu ý. Phân tích theo khoa cho thấy các hội đồng xét tuyển không phân biệt đối xử, nhưng không loại trừ bất bình đẳng ở khâu khác. Chọn cách chia nhóm vì thế luôn là một quyết định diễn giải, không thuần túy kỹ thuật.
3.2. Chỉ số đánh bóng trong bóng chày
Ross (2004) minh họa nghịch lý bằng hai cầu thủ Derek Jeter và David Justice qua ba mùa giải (Bảng 4):
Bảng 4. Chỉ số đánh bóng của Derek Jeter và David Justice. Nguồn: dựa trên Ross (2004).
| Mùa giải | Derek Jeter | David Justice | Bên cao hơn |
|---|---|---|---|
| 1995 | 12/48 = .250 | 104/411 = .253 | Justice |
| 1996 | 183/582 = .314 | 45/140 = .321 | Justice |
| 1997 | 190/654 = .291 | 163/495 = .329 | Justice |
| Tổng 3 mùa | 385/1.284 = .300 | 312/1.046 = .298 | Jeter |
Justice cao hơn Jeter trong cả ba mùa, nhưng gộp lại thì Jeter nhỉnh hơn. Lý do vẫn là trọng số: mùa 1995 chỉ chiếm khoảng 4% số lượt đánh của Jeter, nên mùa kém nhất của anh gần như không ảnh hưởng đến con số chung. Với Justice, mùa 1995 chiếm khoảng 39% số lượt đánh, và đó cũng là mùa có chỉ số thấp nhất của anh, nên con số chung bị kéo xuống.
3.3. A/B test trong thương mại điện tử
Giả sử một cửa hàng trực tuyến thử hai thiết kế trang thanh toán (số liệu minh họa) (Bảng 5):
Bảng 5. Tỷ lệ chuyển đổi của hai thiết kế trang thanh toán theo thiết bị (số liệu minh họa)
| Thiết bị | Thiết kế A | Thiết kế B | Bên tốt hơn |
|---|---|---|---|
| Máy tính | 60/200 = 30% | 140/500 = 28% | A |
| Điện thoại | 40/800 = 5% | 40/1.000 = 4% | A |
| Tổng thể | 100/1.000 = 10% | 180/1.500 = 12% | B |
Nhìn số chung, B thắng. Nhưng trên cả hai loại thiết bị, A đều có tỷ lệ chuyển đổi cao hơn. Nguyên nhân: 80% lượt xem của A đến từ điện thoại, so với 67% của B, mà người dùng điện thoại vốn ít mua hơn. Chọn B theo số chung đồng nghĩa với bỏ đi phương án tốt hơn.
Đáng chú ý, đây là một thí nghiệm, không phải dữ liệu quan sát. Một dấu hiệu bất thường lẽ ra phải bị phát hiện từ sớm: A nhận 1.000 lượt xem, B nhận 1.500, trong khi một A/B test thường được thiết kế chia đều. Lỗi phân bổ lưu lượng như vậy có thể làm méo kết quả ngay cả khi có ngẫu nhiên hóa (Fabijan et al., 2019; Kohavi et al., 2020).
3.4. Tỷ lệ tử vong do COVID-19
Ở giai đoạn đầu đại dịch năm 2020, tỷ lệ tử vong trên số ca nhiễm được ghi nhận (CFR) của Ý cao hơn Trung Quốc khi tính chung. Tuy vậy, von Kügelgen và cộng sự (2021) cho thấy khi tách theo nhóm tuổi, CFR của Ý lại thấp hơn Trung Quốc ở mọi nhóm tuổi trong dữ liệu họ so sánh.
Lời giải là cơ cấu tuổi của các ca nhiễm. Ở Ý, người cao tuổi chiếm tỷ trọng lớn hơn hẳn trong số ca được ghi nhận, mà nhóm này có nguy cơ tử vong cao hơn nhiều. Chiến lược xét nghiệm khác nhau giữa hai nước cũng góp phần tạo ra khác biệt đó.
Ví dụ này còn cho thấy một điểm tinh tế sẽ được bàn kỹ ở phần sau. Các tác giả không coi tuổi đơn thuần là biến gây nhiễu, mà phân tích nó như một biến trung gian: quốc gia ảnh hưởng đến việc ai bị nhiễm và được xét nghiệm, và qua đó ảnh hưởng đến tỷ lệ tử vong. Con số nào "đúng" phụ thuộc vào câu hỏi đặt ra. Muốn so sánh chất lượng điều trị, cần so theo từng nhóm tuổi hoặc dùng tỷ lệ chuẩn hóa theo tuổi, cách làm tiêu chuẩn của dịch tễ học khi so sánh các quần thể.
3.5. Phiên bản với biến liên tục
Nghịch lý không chỉ xảy ra với tỷ lệ phần trăm, mà cả với tương quan giữa hai biến liên tục. Xét quan hệ giữa số giờ tập thể dục mỗi tuần và mức cholesterol (ví dụ giả định):
- Nhìn toàn bộ dữ liệu, xu hướng đi lên: ai tập nhiều hơn dường như có cholesterol cao hơn.
- Tách theo nhóm tuổi, mỗi nhóm lại cho xu hướng đi xuống: trong cùng độ tuổi, ai tập nhiều hơn thì cholesterol thấp hơn.
Nguyên nhân là người lớn tuổi vừa tập nhiều hơn (theo lời khuyên của bác sĩ), vừa có cholesterol cao hơn do tuổi tác. Tuổi là biến gây nhiễu, kéo đường xu hướng chung dốc lên. Hình 2 minh họa tình huống này bằng dữ liệu mô phỏng. Dạng này dễ nhận ra trên biểu đồ phân tán tô màu theo nhóm: mỗi đám điểm dốc xuống, nhưng đường nối tâm các đám lại dốc lên.
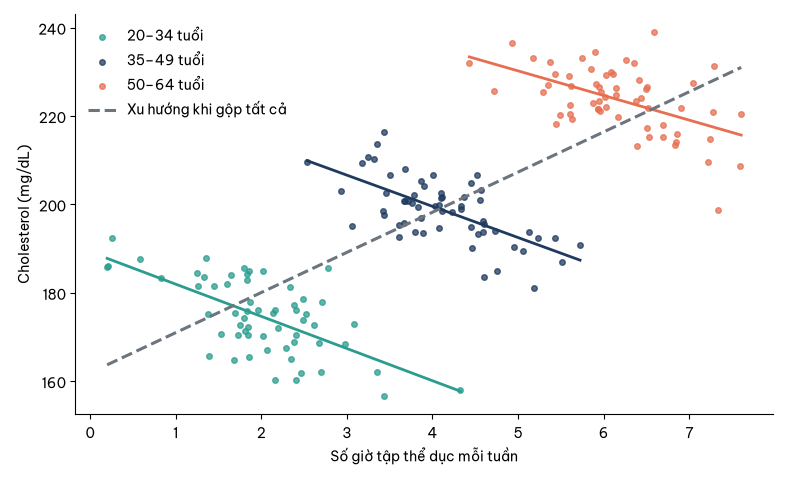
Hình 2. Xu hướng đi xuống trong từng nhóm tuổi nhưng đi lên khi gộp (số liệu mô phỏng).
4. Nên tin số liệu gộp hay số liệu tách nhóm?
Đây là câu hỏi cốt lõi, và câu trả lời gây bất ngờ: chỉ dữ liệu thôi thì không trả lời được. Hai bộ dữ liệu có thể giống hệt nhau về con số nhưng đòi hỏi hai cách đọc ngược nhau, tùy vào cấu trúc nhân quả đã sinh ra chúng. Pearl (2014) làm rõ điều này bằng sơ đồ nhân quả (causal diagram); các nhà dịch tễ học cũng đi đến kết luận tương tự (Hernán et al., 2011).
Gọi X là phương án được so sánh, Y là kết quả và Z là biến dùng để chia nhóm. Vai trò của Z quyết định nên đọc con số nào (Bảng 6).
Bảng 6. Ba vai trò của biến phân nhóm Z
| Gây nhiễu (confounder) | Trung gian (mediator) | Hệ quả chung (collider) | |
|---|---|---|---|
| Cấu trúc | Z → X, Z → Y, X → Y | X → Z → Y | X → Z ← Y |
| Nên dùng | Số liệu tách nhóm | Số liệu gộp | Số liệu gộp |
| Ví dụ về Z | Kích thước sỏi | Huyết áp sau điều trị | Được nhận vào trường |
4.1. Trường hợp 1: Z là biến gây nhiễu (confounder)
Z ảnh hưởng đến cả việc chọn X lẫn kết quả Y. Ví dụ: kích thước sỏi ảnh hưởng đến việc bác sĩ chọn phương pháp nào và đến khả năng thành công. Khi đó nên dùng số liệu tách nhóm hoặc số liệu đã điều chỉnh theo Z, vì Z làm lệch phép so sánh. Ví dụ sỏi thận và ví dụ tuổi–cholesterol thuộc trường hợp này.
4.2. Trường hợp 2: Z là biến trung gian (mediator)
Z nằm trên chính con đường mà X tác động đến Y. Ví dụ: thuốc làm giảm huyết áp, và huyết áp thấp làm giảm nguy cơ đột quỵ. Nếu tách nhóm theo huyết áp sau điều trị, ta vô tình chặn mất con đường tác động của thuốc, và thuốc trông như vô dụng. Nếu muốn biết tác động tổng của thuốc, nên dùng số liệu gộp.
4.3. Trường hợp 3: Z là hệ quả chung (collider)
Z chịu ảnh hưởng của cả X lẫn Y. Kiểm soát Z sẽ tạo ra một mối liên hệ giả giữa X và Y. Ví dụ: nếu chỉ xét những người được nhận vào một trường danh tiếng, ta có thể thấy điểm thi và năng khiếu thể thao tương quan âm, dù ngoài đời hai thứ này không liên quan; trường nhận người giỏi ở mặt này hoặc mặt kia. Trường hợp này cũng nên dùng số liệu gộp.
4.4. Tổng hợp ba trường hợp
Có thể tóm gọn ba trường hợp trên thành một nguyên tắc chọn số liệu theo vai trò của Z (Bảng 7).
Bảng 7. Nên dùng số liệu gộp hay tách nhóm theo vai trò của Z
| Vai trò của Z | Nên dùng | Lý do |
|---|---|---|
| Biến gây nhiễu (confounder) | Số liệu tách nhóm hoặc đã điều chỉnh | Z làm lệch phép so sánh |
| Biến trung gian (mediator) | Số liệu gộp (nếu hỏi tác động tổng) | Z là một phần của cơ chế tác động |
| Hệ quả chung (collider) | Số liệu gộp | Kiểm soát Z tạo ra tương quan giả |
Ví dụ COVID-19 ở trên cho thấy cùng một biến có thể được hiểu theo nhiều vai trò, tùy câu hỏi. Vì vậy bước đầu tiên luôn là nói rõ câu hỏi nhân quả mình đang muốn trả lời. Để tìm hiểu cách dựng và đọc sơ đồ nhân quả, có thể tham khảo Greenland và cộng sự (1999) hoặc Pearl và cộng sự (2016).
4.5. Một chiến dịch bán ba lô và sơ đồ nhân quả
Haughton và cộng sự (2026) đưa ra một tình huống kinh doanh cho thấy sơ đồ nhân quả giúp gì khi gặp nghịch lý. Một công ty chạy chiến dịch quảng cáo ba lô. Trước chiến dịch, 2% khách hàng mua ba lô; sáu tháng sau, con số là 2,2%, và phòng marketing tuyên bố chiến dịch thành công. Nhưng khi tách theo giới tính, tỷ lệ mua ở khách nam giảm từ 4% xuống 3,5%, ở khách nữ giảm từ 1% xuống 0,7%. Tỷ lệ chung tăng chỉ vì cơ cấu khách hàng đã dịch chuyển về phía nhóm vốn mua nhiều hơn.
Sơ đồ nhân quả cho tình huống này có ba biến: giới tính (G), chiến dịch (C) và doanh số ba lô (S). Giới tính ảnh hưởng tới việc ai được chiến dịch tiếp cận (G → C) và tới nhu cầu mua ba lô (G → S); chiến dịch tác động lên doanh số (C → S). Như vậy giới tính là biến gây nhiễu, và đường G → C tạo ra một "đường cửa sau" giữa chiến dịch và doanh số mà ta phải chặn lại bằng cách tách nhóm hoặc đưa giới tính vào mô hình. Theo trường hợp 1 ở trên, số liệu tách nhóm mới là số liệu nên đọc, và chúng gợi ý chiến dịch không hiệu quả, ít nhất là chưa có bằng chứng hiệu quả. Cần thêm một lưu ý: đây là so sánh trước và sau không có nhóm đối chứng, nên xu hướng chung của thị trường trong sáu tháng cũng có thể giải thích cho sự sụt giảm.
Ví dụ này mở rộng thành hai nguyên tắc dùng được cho mọi mô hình hồi quy. Thứ nhất, hệ số hồi quy không có ý nghĩa nhân quả nếu không nói rõ cấu trúc nhân quả đứng sau nó. Thứ hai, một mô hình chỉ đo đúng một tác động: hệ số của chiến dịch trong mô hình có cả giới tính đo tác động của chiến dịch, nhưng hệ số của giới tính trong cùng mô hình chỉ đo phần tác động trực tiếp của giới tính, không gồm phần đi qua chiến dịch. Đọc mọi hệ số trong một bảng hồi quy như thể chúng đều là tác động tổng là lỗi phổ biến đến mức giới dịch tễ học đặt tên riêng cho nó (Westreich & Greenland, 2013). Muốn đo nhiều tác động thì thường cần nhiều mô hình, mỗi mô hình được dựng theo sơ đồ cho đúng câu hỏi của nó.
Khi bài toán có hàng chục biến, sơ đồ có thể được vẽ từ hiểu biết chuyên môn hoặc ước lượng từ dữ liệu bằng các thuật toán học cấu trúc. Dù theo cách nào, kết luận chỉ đáng tin khi người phân tích lập luận được rằng không có biến quan trọng nào bị bỏ sót, vì một biến gây nhiễu không đo được vẫn làm lệch kết quả dù sơ đồ có đẹp đến đâu.
5. Phòng tránh từ khâu thiết kế
Hãy coi nghịch lý Simpson là rủi ro mặc định mỗi khi so sánh các nhóm bằng số liệu gộp. Cách xử lý gồm ba giai đoạn: phòng ngừa khi thiết kế, nhận diện khi phân tích, và xử lý đúng sau khi phát hiện. Giai đoạn đầu rẻ nhất, vì nó phá vỡ điều kiện thứ ba trước khi nghịch lý kịp hình thành.
5.1. Phân bổ ngẫu nhiên
Khi bệnh nhân hoặc người dùng được gán ngẫu nhiên vào các phương án, mọi biến khác, kể cả những biến chưa ai nghĩ tới, có phân bổ xấp xỉ như nhau giữa các nhóm. Điều kiện thứ ba của nghịch lý bị loại bỏ.
Nếu nghiên cứu sỏi thận gán ngẫu nhiên, mỗi phương pháp sẽ nhận một tỷ lệ sỏi lớn gần với tỷ lệ chung của toàn bộ bệnh nhân, khoảng 49% (343/700), thay vì 75% và 23% như thực tế. Khi đó so sánh số liệu gộp mới công bằng.
Lưu ý: ngẫu nhiên hóa chỉ bảo đảm cân bằng theo kỳ vọng. Với mẫu nhỏ, mất cân bằng vẫn có thể xảy ra do may rủi.
5.2. Ngẫu nhiên hóa phân tầng
Nếu đã biết trước một biến quan trọng (mức độ nặng của bệnh, loại thiết bị, quốc gia), hãy ngẫu nhiên hóa riêng trong từng tầng: trong nhóm sỏi lớn chia ngẫu nhiên 50/50 giữa A và B, nhóm sỏi nhỏ cũng vậy. Cách này bảo đảm cơ cấu nhóm giống nhau thay vì chỉ trông đợi. Trong A/B test, điều này tương đương chia lưu lượng 50/50 riêng cho từng loại thiết bị.
5.3. Ghi nhận đủ các biến có thể gây nhiễu
Không thể điều chỉnh cho một biến không được đo. Trước khi thu thập dữ liệu, hãy hỏi chuyên gia lĩnh vực hai câu: điều gì khiến người ta chọn phương án A thay vì B, và điều gì khác ảnh hưởng đến kết quả. Sau đó bảo đảm các biến ấy được ghi lại (Bảng 8).
Bảng 8. Biến gây nhiễu thường gặp theo lĩnh vực
| Lĩnh vực | Biến gây nhiễu thường gặp |
|---|---|
| Y tế | Tuổi, giới, mức độ nặng của bệnh, bệnh nền, bệnh viện |
| Marketing, sản phẩm | Thiết bị, kênh thu hút, quốc gia, người dùng mới hay cũ, mùa vụ |
| Giáo dục | Trình độ đầu vào, thu nhập gia đình, trường, giáo viên |
| Nhân sự | Phòng ban, cấp bậc, thâm niên, địa điểm làm việc |
| Tài chính, tín dụng | Phân khúc khách hàng, loại sản phẩm, kỳ hạn |
5.4. Kiểm tra lệch tỷ lệ mẫu (SRM)
Trong A/B test, nếu thiết kế chia 50/50 mà dữ liệu thực tế là 53/47, đó là cảnh báo đỏ. Lỗi kỹ thuật như bot, lỗi tải trang hay cơ chế lưu đệm có thể đang làm lệch phân bổ, và nghịch lý Simpson có thể ẩn bên trong. Fabijan và cộng sự (2019) mô tả lệch tỷ lệ mẫu (sample ratio mismatch, SRM) là một trong những sự cố phổ biến và nghiêm trọng nhất của thí nghiệm trực tuyến.
Cách kiểm tra thông dụng là dùng kiểm định chi bình phương so sánh số lượng thực tế với số lượng kỳ vọng. Nếu giá trị p rất nhỏ (thường lấy ngưỡng dưới 0,001), hãy tìm nguyên nhân trước khi đọc kết quả (Kohavi et al., 2020).
6. Nhận diện khi phân tích dữ liệu
Với dữ liệu quan sát, không có ngẫu nhiên hóa che chắn, người phân tích phải chủ động săn tìm nghịch lý. Các công cụ dưới đây được sắp từ đơn giản đến phức tạp.
6.1. So sánh cơ cấu nhóm trước tiên
Trước khi tính bất kỳ tỷ lệ nào, hãy lập bảng tỷ trọng của từng nhóm con trong mỗi phương án. Ở ví dụ sỏi thận, riêng bảng cơ cấu (A: 75% ca khó, B: 23% ca khó) đã là tín hiệu cảnh báo mạnh.
Quy tắc kinh nghiệm: nếu cơ cấu nhóm giữa hai phương án chênh nhau hơn khoảng 10 điểm phần trăm ở một biến có ảnh hưởng đến kết quả, hãy coi số liệu gộp là chưa đáng tin cho đến khi kiểm tra theo nhóm. Đây là một ngưỡng thực hành để cảnh giác, không phải quy chuẩn thống kê.
6.2. Phân tích phân tầng
Tách dữ liệu theo từng biến nghi ngờ rồi so sánh lại, lần lượt từng biến, sau đó đến các tổ hợp quan trọng. Kết quả rơi vào một trong ba trường hợp (Bảng 9):
Bảng 9. Ba kết quả có thể gặp khi rà soát nhiều biến
| Kết quả quan sát | Ý nghĩa |
|---|---|
| Kết luận giống nhau ở mọi nhóm và ở tổng thể | Kết quả vững |
| Kết luận giống nhau ở mọi nhóm nhưng ngược ở tổng thể | Nghịch lý Simpson |
| Kết luận khác nhau giữa các nhóm | Hiệu ứng tương tác, không phải nghịch lý |
Phân biệt trường hợp cuối rất quan trọng. Nếu A tốt hơn với sỏi nhỏ nhưng kém hơn với sỏi lớn, câu trả lời đúng là "tùy loại sỏi", không phải "A tốt hơn".
6.3. Chuẩn hóa trực tiếp
Chuẩn hóa đưa các phương án về cùng một cơ cấu nhóm để so sánh công bằng. Với sỏi thận, chọn quần thể chuẩn là toàn bộ 700 bệnh nhân: 357 ca sỏi nhỏ (87 + 270) và 343 ca sỏi lớn (263 + 80). Sau đó tính số ca thành công nếu mỗi phương pháp điều trị đúng quần thể này (Bảng 10):
Bảng 10. Chuẩn hóa trực tiếp tỷ lệ thành công trong ví dụ sỏi thận
| Sỏi nhỏ (357 ca) | Sỏi lớn (343 ca) | Tỷ lệ chuẩn hóa | Tỷ lệ thô | |
|---|---|---|---|---|
| Phương pháp A | 93,1% × 357 ≈ 332,4 | 73,0% × 343 ≈ 250,4 | 582,8 / 700 ≈ 83,3% | 78,0% |
| Phương pháp B | 86,7% × 357 ≈ 309,4 | 68,8% × 343 ≈ 235,8 | 545,2 / 700 ≈ 77,9% | 82,6% |
Sau chuẩn hóa, thứ hạng đảo lại và khớp với kết quả trong từng nhóm. Đây là con số nên trình lên hội đồng bệnh viện, kèm con số thô và lời giải thích vì sao hai con số khác nhau.
6.4. Tỷ số chênh Mantel–Haenszel
Với dữ liệu phân tầng dạng nhiều bảng 2×2, phương pháp Mantel–Haenszel tính một tỷ số chênh (odds ratio, OR) chung đã điều chỉnh theo tầng (Mantel & Haenszel, 1959). Với sỏi thận, so A với B:
- OR thô: khoảng 0,75, tức A có vẻ kém hơn B.
- OR Mantel–Haenszel, điều chỉnh theo kích thước sỏi: khoảng 1,45, tức A tốt hơn B.
Việc OR chuyển từ dưới 1 sang trên 1 là dấu hiệu định lượng của nghịch lý Simpson. Khi ước lượng thô và ước lượng điều chỉnh chênh nhau đáng kể (nhiều nghiên cứu dùng ngưỡng khoảng 10%), biến đang xét đáng được nghi là biến gây nhiễu. Có hai điểm cần cẩn trọng. Thứ nhất, OR có tính không thu gọn được (non-collapsibility): OR thô và OR điều chỉnh có thể khác nhau ngay cả khi không có gây nhiễu, nhất là khi kết quả phổ biến như ở đây. Thứ hai, OR chung chỉ có ý nghĩa khi hiệu ứng tương đối đồng nhất giữa các tầng; kiểm định Breslow–Day giúp kiểm tra điều này.
6.5. Hồi quy đa biến và quy tắc thay đổi 10%
Hồi quy cho phép điều chỉnh đồng thời nhiều biến, kể cả biến liên tục. Quy trình sàng lọc gồm ba bước:
- Xây mô hình chỉ có biến phương án X, ghi lại hệ số của X.
- Lần lượt thêm từng biến nghi ngờ Z vào mô hình.
- Nếu hệ số của X thay đổi hơn 10% hoặc đổi dấu, Z có thể là biến gây nhiễu và nên được cân nhắc giữ lại.
Với sỏi thận, trong hồi quy logistic, hệ số của B so với A là dương ở mô hình thô (B có vẻ tốt hơn) nhưng âm sau khi thêm kích thước sỏi. Việc đổi dấu xác nhận kích thước sỏi là biến gây nhiễu.
Cảnh báo: quy tắc 10% chỉ là công cụ sàng lọc, và cũng chịu ảnh hưởng của tính không thu gọn được nêu trên. Đừng đưa một biến trung gian hay collider vào mô hình chỉ vì nó làm hệ số thay đổi. Vai trò nhân quả của biến phải được xác định bằng sơ đồ nhân quả trước (Greenland et al., 1999).
6.6. Rà soát hệ thống trên nhiều biến
Với dữ liệu nhiều chiều, lặp lại phép kiểm tra sau cho từng biến phân nhóm (thiết bị, quốc gia, kênh, nhóm tuổi):
- Xác định phương án thắng ở mức tổng thể.
- Xác định phương án thắng trong từng nhóm của biến đó.
- Gắn cờ những biến mà phương án thắng ở mọi nhóm khác với phương án thắng tổng thể.
Danh sách biến bị gắn cờ là danh sách ưu tiên để chuyên gia lĩnh vực xem xét.
6.7. Điểm xu hướng và trọng số nghịch đảo
Khi có quá nhiều biến nhiễu để phân tầng thủ công, có thể dùng điểm xu hướng (propensity score): xác suất một cá thể được gán vào phương án A, ước lượng từ các đặc điểm của cá thể đó (Rosenbaum & Rubin, 1983). Có hai hướng dùng chính:
- Ghép cặp (matching): với mỗi cá thể ở nhóm A, tìm cá thể ở nhóm B có điểm xu hướng gần nhất, rồi so sánh kết quả giữa các cặp.
- Trọng số nghịch đảo xác suất (inverse probability weighting): gán trọng số để hai nhóm có phân bổ đặc điểm tương đương.
Sau khi ghép hoặc gán trọng số, cần kiểm tra độ cân bằng của từng biến trước khi so sánh kết quả; chênh lệch chuẩn hóa dưới 0,1 là ngưỡng thường dùng (Austin, 2011).
Giới hạn quan trọng: các kỹ thuật này chỉ điều chỉnh được cho biến đã đo. Để đánh giá một biến chưa đo cần mạnh đến đâu mới lật ngược được kết luận, hãy bổ sung phân tích độ nhạy, chẳng hạn chỉ số E-value (VanderWeele & Ding, 2017).
6.8. Trực quan hóa
Mắt người nhận ra mẫu hình qua hình ảnh nhanh hơn qua bảng số. Ba loại biểu đồ đặc biệt hữu ích:
- Biểu đồ cột nhóm: mỗi nhóm con một cụm cột, các phương án đứng cạnh nhau.
- Biểu đồ phân tán tô màu theo nhóm, kèm đường hồi quy riêng cho từng nhóm và một đường cho toàn bộ dữ liệu. Khi các đường nhóm dốc ngược với đường chung, bạn đang nhìn thấy nghịch lý Simpson.
- Biểu đồ cột chồng 100% hoặc biểu đồ mosaic: cho thấy cơ cấu nhóm của từng phương án.
7. Xử lý đúng sau khi phát hiện
Phát hiện nghịch lý mới là một nửa công việc. Nửa còn lại gồm bốn bước:
- Vẽ sơ đồ nhân quả để xác định Z là biến gây nhiễu, biến trung gian hay hệ quả chung. Chỉ khi Z là biến gây nhiễu mới nên ưu tiên số liệu tách nhóm hoặc đã điều chỉnh (Pearl, 2014).
- Hỏi chuyên gia lĩnh vực để kiểm chứng các giả định nhân quả. Thống kê không thay thế được hiểu biết về cơ chế thực tế.
- Báo cáo cả hai con số, gộp và tách nhóm (hoặc đã điều chỉnh), kèm giải thích vì sao chúng khác nhau.
- Chọn con số khớp với câu hỏi. Hai câu hỏi sau cần hai con số khác nhau:
- Bệnh nhân này có sỏi lớn, nên dùng phương pháp nào? → số liệu tách nhóm.
- Cách phân bổ phương pháp hiện nay của bệnh viện cho kết quả chung ra sao? → số liệu gộp mô tả đúng điều này.
7.1. Những cái bẫy khi xử lý
Phòng tránh nghịch lý không có nghĩa là chia dữ liệu càng nhỏ càng tốt (Bảng 11).
Bảng 11. Những cái bẫy khi xử lý nghịch lý Simpson
| Bẫy | Biểu hiện | Cách tránh |
|---|---|---|
| Chia quá nhỏ | Mỗi nhóm quá ít dữ liệu, kết quả nhiễu | Đặt cỡ mẫu tối thiểu; dùng hồi quy thay vì chia thủ công |
| Săn nhóm con | Thử hàng chục cách chia cho đến khi ra kết quả "mong muốn" | Xác định trước biến phân tầng; hiệu chỉnh cho đa so sánh |
| Kiểm soát nhầm biến | Điều chỉnh theo biến trung gian hoặc collider làm méo kết quả | Vẽ sơ đồ nhân quả trước khi đưa biến vào mô hình |
| Tin tuyệt đối vào tách nhóm | Coi số liệu tách nhóm luôn đúng | Xác định vai trò nhân quả của biến phân nhóm |
| Bỏ sót biến ẩn | Đã điều chỉnh nhưng vẫn còn biến gây nhiễu chưa đo | Thu thập dữ liệu tốt hơn, phân tích độ nhạy, ưu tiên thí nghiệm ngẫu nhiên |
| Nhầm với hiệu ứng tương tác | Gọi sai một kết quả khác nhau giữa các nhóm là nghịch lý | Kiểm tra hướng hiệu ứng có giống nhau ở mọi nhóm không |
7.2. Checklist trước khi tin một so sánh gộp
Thiết kế
- Việc gán phương án có ngẫu nhiên không? Nếu không, ai quyết định và dựa trên tiêu chí nào?
- Các biến có thể ảnh hưởng đến cả lựa chọn phương án lẫn kết quả đã được ghi nhận chưa?
- Với A/B test: tỷ lệ phân bổ thực tế có khớp thiết kế không (SRM)?
Dữ liệu
- Cơ cấu nhóm (tuổi, thiết bị, khu vực...) giữa các phương án có tương đương không?
- Có nhóm nào chiếm tỷ trọng lệch hẳn ở một phương án không?
- Mỗi nhóm con có đủ cỡ mẫu để kết luận không?
Phân tích
- Đã xem kết quả theo từng nhóm con quan trọng chưa?
- Hướng kết luận ở tổng thể và ở từng nhóm có nhất quán không?
- Đã so sánh ước lượng thô với ước lượng đã điều chỉnh chưa?
- Các biến phân tầng có được chọn trước, tránh săn nhóm con không?
Diễn giải
- Đã xác định biến phân nhóm là biến gây nhiễu, trung gian hay hệ quả chung chưa?
- Chuyên gia lĩnh vực đã xác nhận giả định nhân quả chưa?
- Báo cáo có trình bày cả số liệu gộp lẫn tách nhóm, kèm giải thích không?
- Con số được chọn có khớp với câu hỏi quyết định (cho một cá nhân hay cho chính sách chung) không?
8. Nghịch lý Simpson ẩn ở đâu trong từng ngành?
Nghịch lý không chỉ là chuyện của sách giáo khoa thống kê. Hầu như ngành nào so sánh tỷ lệ giữa các nhóm có cơ cấu khác nhau cũng có thể gặp nó (Bảng 12).
Bảng 12. Tình huống dễ gặp nghịch lý Simpson theo ngành
| Ngành | Tình huống dễ gặp | Biến phân nhóm cần kiểm tra |
|---|---|---|
| Y tế | So sánh tỷ lệ sống sót giữa các bệnh viện | Mức độ nặng của bệnh, tuổi, bệnh nền |
| Giáo dục | So sánh điểm thi giữa các trường | Trình độ đầu vào, thu nhập gia đình |
| Marketing | So sánh tỷ lệ chuyển đổi giữa các chiến dịch | Kênh, thiết bị, người dùng mới hay cũ |
| Nhân sự | So sánh lương giữa nam và nữ | Phòng ban, cấp bậc, thâm niên |
| Tín dụng | So sánh tỷ lệ nợ xấu giữa hai quy trình thẩm định | Phân khúc khách hàng, loại sản phẩm |
| Vận hành | So sánh tỷ lệ giao hàng đúng hạn giữa các đối tác | Khu vực, loại hàng, mùa cao điểm |
Nhân sự (ví dụ giả định). Công ty X thấy lương trung bình của nữ thấp hơn nam 8%. Tách theo phòng ban, trong từng phòng lương nữ lại bằng hoặc cao hơn nam; khoảng cách chung đến từ việc nữ tập trung ở các phòng ban trả lương thấp. Kết luận đúng không phải "không có vấn đề", mà là vấn đề nằm ở phân bổ vị trí công việc chứ không ở chính sách lương trong từng phòng. Hướng xử lý vì thế cũng khác, giống bài học từ vụ Berkeley.
Y tế. Khi xếp hạng bệnh viện theo tỷ lệ tử vong, bệnh viện tuyến cuối nhận nhiều ca nặng thường có tỷ lệ thô cao hơn, dù chất lượng điều trị không kém. Vì vậy các bảng xếp hạng nghiêm túc đều phải điều chỉnh theo mức độ nặng của ca bệnh trước khi so sánh.
9. Những thắc mắc thường gặp
Phần này trả lời ngắn gọn sáu thắc mắc hay gặp khi lần đầu tiếp xúc với nghịch lý Simpson.
Nghịch lý Simpson có hay xảy ra không? Dạng đảo chiều hoàn toàn tương đối hiếm. Pavlides và Perlman (2009) ước tính rằng với bảng 2×2×2 có số liệu được chọn ngẫu nhiên, xác suất đảo chiều chỉ khoảng 1/60. Nhưng dạng méo một phần, khi kết luận bị lệch rõ mà không đảo chiều, lại rất phổ biến trong dữ liệu quan sát.
Dữ liệu lớn có giúp tránh được nghịch lý không? Không. Vấn đề nằm ở cấu trúc của dữ liệu, không phải số lượng. Dữ liệu càng lớn, khoảng tin cậy càng hẹp, và ta càng tự tin vào một kết luận có thể sai.
Vậy cứ chọn số liệu tách nhóm là an toàn? Không. Nếu biến phân nhóm là biến trung gian hoặc hệ quả chung, tách nhóm sẽ dẫn đến kết luận sai (Hernán et al., 2011; Pearl, 2014).
Nghịch lý Simpson khác gì hiệu ứng tương tác? Với nghịch lý Simpson, hướng hiệu ứng giống nhau ở mọi nhóm nhưng ngược với hướng ở tổng thể. Với hiệu ứng tương tác, hướng hiệu ứng khác nhau giữa các nhóm, và câu trả lời đúng là "tùy nhóm".
Thí nghiệm ngẫu nhiên có loại bỏ hoàn toàn nghịch lý không? Gần như vậy, nếu được thiết kế và vận hành đúng, vì phân bổ ngẫu nhiên làm các nhóm tương đương về kỳ vọng. Tuy nhiên lỗi kỹ thuật như SRM vẫn có thể phá vỡ tính ngẫu nhiên, nên luôn cần kiểm tra (Fabijan et al., 2019).
Không có dữ liệu để vẽ sơ đồ nhân quả thì sao? Sơ đồ nhân quả được dựng từ hiểu biết chuyên môn, không phải từ dữ liệu. Hãy phác một bản nháp cùng chuyên gia lĩnh vực, rồi hoàn thiện dần.
Kết luận
Nghịch lý Simpson không phải lỗi của toán học, mà là lời nhắc về cách con người đọc dữ liệu. Một con số trung bình có thể là hỗn hợp của nhiều câu chuyện khác nhau; nếu không tách chúng ra, ta có thể đi đến kết luận ngược hẳn với thực tế. Nhưng tách ra một cách máy móc cũng có thể sai. Dữ liệu không tự nói lên sự thật; chính cách ta hiểu cơ chế sinh ra dữ liệu mới quyết định ta đọc nó đúng hay sai (Pearl, 2014).
Ba điều cần ghi nhớ:
- Gộp dữ liệu có thể đảo ngược xu hướng khi cơ cấu nhóm giữa các phương án không đồng đều.
- Gộp hay tách phải dựa trên cấu trúc nhân quả và câu hỏi cần trả lời, không dựa trên con số.
- Luôn tìm hiểu bối cảnh đằng sau dữ liệu trước khi kết luận.
Với nhà quản lý, điều đó có nghĩa là đừng ra quyết định chỉ dựa trên một chỉ số tổng hợp như KPI trung bình hay tỷ lệ chuyển đổi chung. Hãy yêu cầu số liệu theo phân khúc kèm giải thích về cơ cấu nhóm, và hỏi "điều gì khiến các nhóm này khác nhau?" trước khi hỏi "phương án nào tốt hơn?".
Lần tới khi thấy một báo cáo kết luận "X tốt hơn Y", hãy dừng lại và hỏi: con số trung bình này đang che giấu điều gì?
Đọc thêm
- Suy luận nhân quả từ dữ liệu
- Tương quan không phải nhân quả và 5 bẫy cần tránh
- Bài học thống kê từ một tấm meme
- Định luật Benford trong phát hiện gian lận
- Năm đòn bẩy tăng trưởng lợi nhuận doanh nghiệp: mục "5 biến không độc lập"
- Sơ đồ nhân quả trong phân tích dữ liệu
Tài liệu tham khảo
Austin, P. C. (2011). An introduction to propensity score methods for reducing the effects of confounding in observational studies. Multivariate Behavioral Research, 46(3), 399–424. https://doi.org/10.1080/00273171.2011.568786
Bickel, P. J., Hammel, E. A., & O'Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
Blyth, C. R. (1972). On Simpson's paradox and the sure-thing principle. Journal of the American Statistical Association, 67(338), 364–366. https://doi.org/10.1080/01621459.1972.10482387
Charig, C. R., Webb, D. R., Payne, S. R., & Wickham, J. E. (1986). Comparison of treatment of renal calculi by open surgery, percutaneous nephrolithotomy, and extracorporeal shockwave lithotripsy. British Medical Journal (Clinical Research Ed.), 292(6524), 879–882. https://doi.org/10.1136/bmj.292.6524.879
Fabijan, A., Gupchup, J., Gupta, S., Omhover, J., Qin, W., Vermeer, L., & Dmitriev, P. (2019). Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners. In Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 2156–2164). Association for Computing Machinery. https://doi.org/10.1145/3292500.3330722
Greenland, S., Pearl, J., & Robins, J. M. (1999). Causal diagrams for epidemiologic research. Epidemiology, 10(1), 37–48. https://doi.org/10.1097/00001648-199901000-00008
Haughton, D., Haughton, J., & Lo, V. S. Y. (2026). Cause and effect business analytics and data science. CRC Press. https://doi.org/10.1201/9780429172588
Hernán, M. A., Clayton, D., & Keiding, N. (2011). The Simpson's paradox unraveled. International Journal of Epidemiology, 40(3), 780–785. https://doi.org/10.1093/ije/dyr041
Julious, S. A., & Mullee, M. A. (1994). Confounding and Simpson's paradox. BMJ, 309(6967), 1480–1481. https://doi.org/10.1136/bmj.309.6967.1480
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
Pavlides, M. G., & Perlman, M. D. (2009). How likely is Simpson's paradox? The American Statistician, 63(3), 226–233. https://doi.org/10.1198/tast.2009.09007
Pearl, J. (2014). Understanding Simpson's paradox. The American Statistician, 68(1), 8–13. https://doi.org/10.1080/00031305.2014.876829
Pearl, J., Glymour, M., & Jewell, N. P. (2016). Causal inference in statistics: A primer. Wiley. https://www.wiley.com/en-us/Causal+Inference+in+Statistics:+A+Primer-p-9781119186847
Pearson, K., Lee, A., & Bramley-Moore, L. (1899). Mathematical contributions to the theory of evolution. VI. Genetic (reproductive) selection: Inheritance of fertility in man, and of fecundity in thoroughbred racehorses. Philosophical Transactions of the Royal Society of London. Series A, 192, 257–330. https://doi.org/10.1098/rsta.1899.0006
Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
Ross, K. (2004). A mathematician at the ballpark: Odds and probabilities for baseball fans. Pi Press. https://www.amazon.com/s?k=A+mathematician+at+the+ballpark+Ross&i=stripbooks
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/M16-2607
von Kügelgen, J., Gresele, L., & Schölkopf, B. (2021). Simpson's paradox in COVID-19 case fatality rates: A mediation analysis of age-related causal effects. IEEE Transactions on Artificial Intelligence, 2(1), 18–27. https://doi.org/10.1109/TAI.2021.3073088
Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412
Yule, G. U. (1903). Notes on the theory of association of attributes in statistics. Biometrika, 2(2), 121–134. https://doi.org/10.1093/biomet/2.2.121