Thử nghiệm A/B đáng tin bắt đầu từ giả thuyết rõ ràng và đủ mẫu, không phải từ công cụ
Một cửa hàng trực tuyến đổi nút "Mua ngay" từ màu xám sang màu cam, chạy thử ba ngày và thấy tỷ lệ đặt hàng tăng 15%. Cả nhóm ăn mừng, áp dụng cho toàn bộ website. Một tháng sau, doanh số không khác gì trước. Không ai làm sai công thức nào; vấn đề nằm ở chỗ ba ngày là quá ít, mức tăng 15% nằm trong biên độ dao động ngẫu nhiên, và tuần chạy thử lại trùng đợt lương về. Thử nghiệm A/B nghe đơn giản: chia khách thành hai nhóm, cho mỗi nhóm xem một phiên bản, so sánh kết quả. Nhưng giữa ý tưởng đơn giản đó và một kết luận đáng tin có nhiều quyết định nhỏ, và mỗi quyết định sai đều có thể biến thử nghiệm thành một màn tung đồng xu tốn kém.
Bài Suy luận nhân quả từ dữ liệu đã giải thích vì sao chia nhóm ngẫu nhiên là "tiêu chuẩn vàng" để đo tác động. Bài này đi vào phần thực hành: làm thế nào để một thử nghiệm A/B trong kinh doanh thực sự trả lời được câu hỏi đặt ra. Nội dung dựa nhiều vào chương về chiến lược "thử và học" (test and learn) trong cuốn sách của Haughton và cộng sự (2026), kết hợp với kinh nghiệm thử nghiệm trực tuyến quy mô lớn được Kohavi và cộng sự (2020) tổng kết.
Bài viết gồm tám phần. Mục 1 giới thiệu thử nghiệm A/B và vị trí của nó trong vòng thử và học. Mục 2 bàn về cách viết giả thuyết và chọn chỉ số. Mục 3 trình bày cách tính cỡ mẫu và thời gian chạy. Mục 4 nói về cách chia nhóm, kể cả ngẫu nhiên theo khối và kiểm tra lệch tỷ lệ mẫu. Mục 5 mở rộng sang thử nhiều yếu tố cùng lúc bằng thiết kế giai thừa. Mục 6 hướng dẫn đọc kết quả. Mục 7 tổng hợp bảy lỗi thường gặp, và mục 8 điểm qua các công cụ.
1. Thử nghiệm A/B và vòng thử và học
Thử nghiệm A/B so sánh hai phương án: phương án hiện tại (nhóm đối chứng, thường gọi là A) và phương án mới (nhóm can thiệp, B). Mỗi khách hàng hoặc mỗi lượt truy cập được gán ngẫu nhiên vào một nhóm. Nhờ gán ngẫu nhiên, hai nhóm giống nhau về mọi đặc điểm, kể cả những đặc điểm ta không đo được như tâm trạng hay mức độ vội vàng, nên chênh lệch kết quả giữa hai nhóm có thể quy cho chính sự thay đổi. Nhóm A đóng vai "điều sẽ xảy ra nếu không thay đổi gì", thứ mà ta không bao giờ quan sát trực tiếp được trên cùng một khách hàng.
1.1. Từ A/B đến A/B/n
Khi có nhiều hơn hai phương án của cùng một yếu tố, ví dụ ba mức giá hoặc bốn tiêu đề email, thử nghiệm được gọi là A/B/n. Nguyên tắc vẫn vậy: mỗi phương án một nhóm ngẫu nhiên, cùng chạy trong cùng khoảng thời gian. Điều cần nhớ là thử nghiệm A/B chỉ tách được tác động của một yếu tố. Haughton và cộng sự (2026) đưa ví dụ một cửa hàng giày muốn thử thông điệp mới nhấn vào tính đa năng thay cho thông điệp cũ về độ bền, và tiện thể hạ giá ở nhóm thông điệp mới. Nếu nhóm mới bán chạy hơn, không ai biết là nhờ thông điệp hay nhờ giá. Muốn tách hai tác động, cần thiết kế ở mục 5.
1.2. Thử nghiệm là một bước trong chu trình lớn hơn
Thử nghiệm A/B hiếm khi đứng riêng. Haughton và cộng sự (2026) đặt nó trong một chiến lược "thử và học" gồm bảy bước, được giới làm marketing dùng nhiều dù ít được bàn trong sách giáo khoa. Hình 1 mô tả chu trình này: bắt đầu từ tiếng nói khách hàng (nghiên cứu định tính, khảo sát) và tiếng nói của ngành (phân tích đối thủ, thị trường), rút ra cơ hội và mục tiêu kinh doanh, lập danh sách đề xuất giá trị cần thử, rồi mới đến thử, đo và học. Kết quả học được quay lại làm đầu vào cho vòng sau.
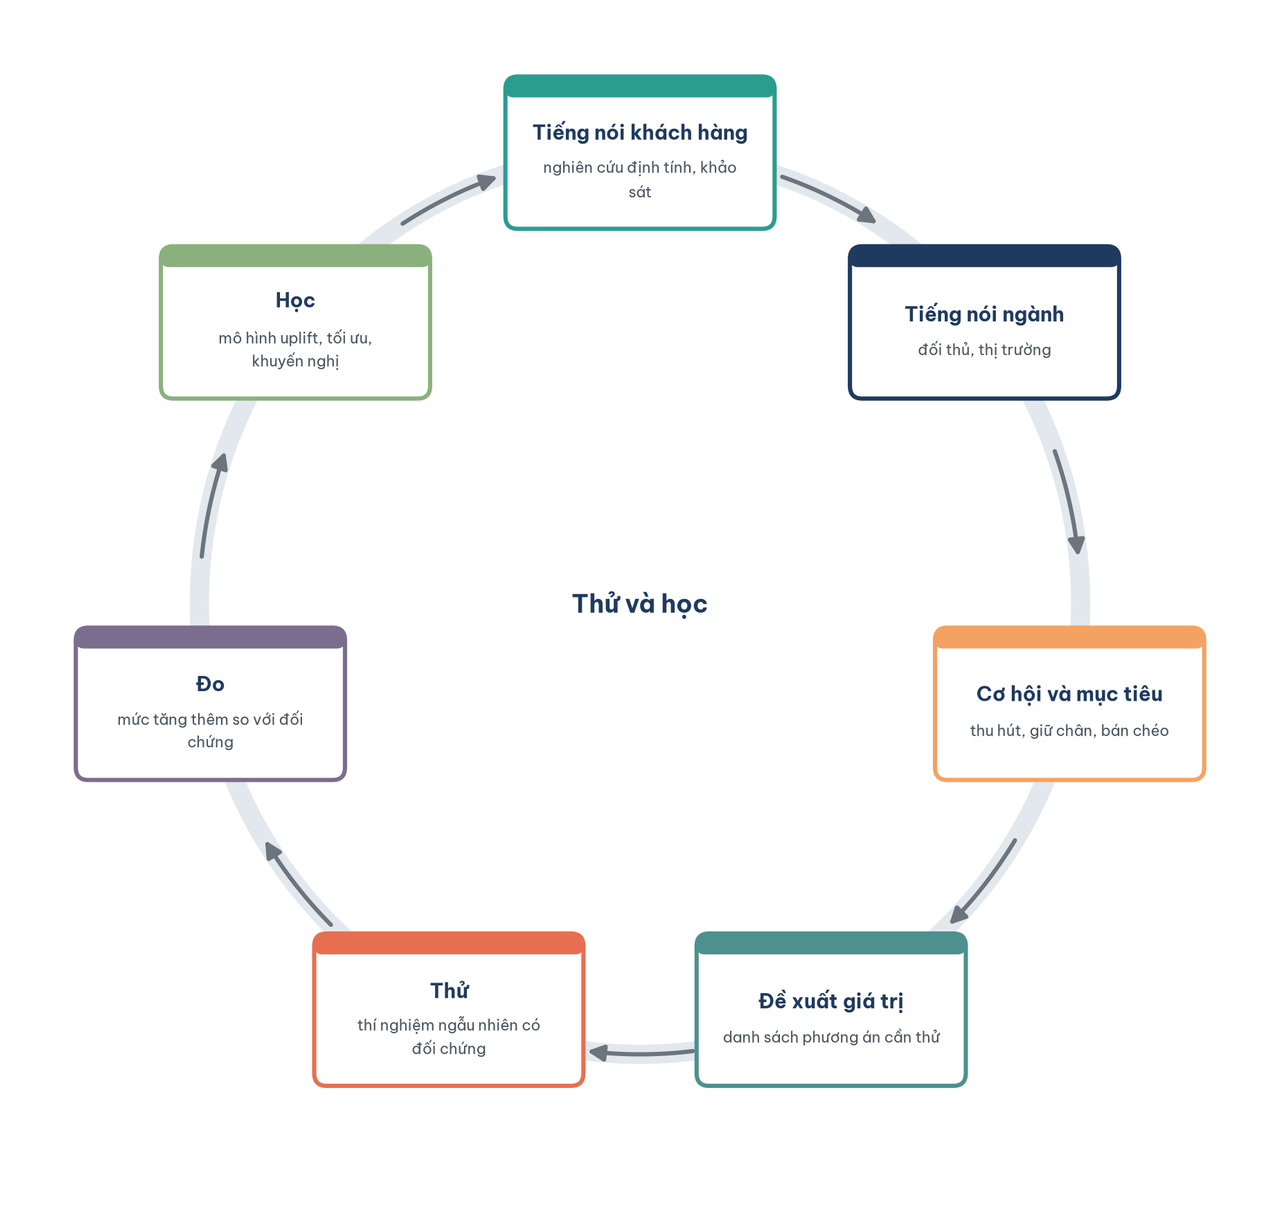
Hình 1. Chiến lược thử và học. Nguồn: dựa trên Haughton và cộng sự (2026).
Chu trình này nhắc một điều hay bị bỏ qua: danh sách phương án đem đi thử phải đến từ hiểu biết về khách hàng, không phải từ ý thích của người có chức vụ cao nhất trong phòng họp. Một nhóm chạy hàng chục thử nghiệm đổi màu nút trong khi chưa hiểu vì sao khách bỏ giỏ hàng là nhóm bận rộn mà không học được gì.
2. Bắt đầu bằng giả thuyết và chỉ số
Trước khi chạm vào công cụ, cần viết ra hai thứ: giả thuyết và chỉ số. Hai thứ này quyết định thử nghiệm cần bao nhiêu mẫu, chạy bao lâu và kết quả được đọc thế nào. Viết chúng ra trước còn có tác dụng chặn một thói quen nguy hiểm: chạy xong rồi mới tìm chỉ số nào "đẹp" để báo cáo.
2.1. Viết giả thuyết thành câu kiểm chứng được
Một giả thuyết tốt có ba phần: thay đổi gì, kỳ vọng chỉ số nào thay đổi bao nhiêu, và vì sao. Ví dụ: "Nếu hiển thị phí giao hàng ngay ở trang sản phẩm thay vì ở bước thanh toán, tỷ lệ hoàn tất đơn sẽ tăng ít nhất 10%, vì khảo sát cho thấy nhiều khách bỏ giỏ khi bất ngờ thấy phí giao hàng." Phần "vì sao" nối thử nghiệm với hiểu biết về khách hàng; phần "ít nhất 10%" là mức tác động tối thiểu đáng quan tâm, dùng để tính cỡ mẫu ở mục 3. Một giả thuyết kiểu "đổi giao diện sẽ tốt hơn" không kiểm chứng được, vì chẳng nói tốt hơn ở đâu và bao nhiêu thì đủ.
2.2. Chọn chỉ số chính, chỉ số phụ và chỉ số bảo vệ
Mỗi thử nghiệm nên có một chỉ số chính, gắn trực tiếp với mục tiêu kinh doanh và được chọn trước. Bên cạnh đó là vài chỉ số phụ giúp giải thích cơ chế, và các chỉ số bảo vệ (guardrail) để chắc rằng phương án mới không gây hại ở chỗ khác, ví dụ tốc độ tải trang, tỷ lệ hoàn hàng hay số cuộc gọi khiếu nại. Kohavi và cộng sự (2020) gọi chỉ số chính tổng hợp là "tiêu chí đánh giá tổng thể" và khuyên doanh nghiệp đầu tư thời gian để thống nhất nó, vì một chỉ số ngắn hạn như lượt nhấp có thể tăng trong khi giá trị dài hạn của khách hàng giảm.
Haughton và cộng sự (2026) sắp xếp các chỉ số theo phễu AIDA (nhận biết, quan tâm, mong muốn, hành động) và lưu ý một điểm quan trọng: với mỗi chỉ số đều có hai phiên bản, mức gốc (ví dụ tỷ lệ mua của nhóm can thiệp) và mức tăng thêm (tỷ lệ mua của nhóm can thiệp trừ nhóm đối chứng). Chỉ mức tăng thêm mới đo tác động của chiến dịch. Bảng 1 tóm tắt các chỉ số thường dùng và vai trò của chúng.
Bảng 1. Các chỉ số đo lường trong thử và học
| Chỉ số gốc | Phiên bản tăng thêm | Vai trò chính |
|---|---|---|
| Tỷ lệ mở email | Tỷ lệ mở tăng thêm so với đối chứng | Đo lường; mô hình hóa khi dữ liệu mua quá ít |
| Tỷ lệ hỏi thông tin hoặc ghé thăm | Mức tăng thêm của tỷ lệ hỏi, ghé thăm | Đo lường, mô hình hóa |
| Tỷ lệ nhấp | Tỷ lệ nhấp tăng thêm | Đo lường, mô hình hóa |
| Tỷ lệ mua (chuyển đổi) | Tỷ lệ mua tăng thêm; chi phí trên mỗi lượt mua tăng thêm | Chỉ số chính phổ biến nhất |
| Số tiền chi tiêu, doanh thu | Doanh thu tăng thêm; chi phí trên doanh thu tăng thêm | Đo lường, mô hình hóa |
| Tỷ lệ giữ chân | Tỷ lệ giữ chân tăng thêm | Đo lường, mô hình hóa |
| Doanh thu thuần, ROI | ROI tăng thêm (ROI marketing) | Ra quyết định |
| Giá trị vòng đời khách hàng | Giá trị vòng đời tăng thêm | Ra quyết định, xếp ưu tiên |
Nguồn: dựa trên Haughton và cộng sự (2026).
Bảng 1 cho thấy càng xuống cuối phễu, chỉ số càng gần mục tiêu thật nhưng càng hiếm và càng nhiễu, nên cần nhiều mẫu hơn. Đó là lý do nhiều nhóm chọn chỉ số giữa phễu như tỷ lệ nhấp làm chỉ số chính. Cách làm này chấp nhận được nếu đã có bằng chứng rằng chỉ số giữa phễu thực sự dẫn tới chỉ số cuối phễu; nếu chưa, thử nghiệm có thể tối ưu thứ không quan trọng.
3. Cỡ mẫu và thời gian chạy
Câu hỏi "chạy bao lâu thì đủ" là câu hỏi về cỡ mẫu, và cỡ mẫu phải được tính trước khi bắt đầu, không phải khi thấy kết quả đã "có ý nghĩa". Phần này giải thích bốn đại lượng quyết định cỡ mẫu và cách quy cỡ mẫu ra số ngày chạy.
3.1. Hai loại sai lầm và lực kiểm định
Mọi kiểm định thống kê đều có thể sai theo hai cách. Sai lầm loại I là kết luận phương án mới tốt hơn trong khi thực ra không phải; xác suất này là mức ý nghĩa α, thường đặt 5%. Sai lầm loại II là bỏ lỡ một cải tiến có thật; xác suất này là β, và 1 − β được gọi là lực kiểm định, thường đặt 80%. Đặt α thấp và lực cao thì kết luận chắc chắn hơn nhưng cần nhiều mẫu hơn.
Hai đại lượng còn lại là tỷ lệ gốc của nhóm đối chứng (lấy từ dữ liệu lịch sử) và mức tác động tối thiểu cần phát hiện, chính là con số "ít nhất 10%" trong giả thuyết. Đại lượng cuối cùng có ảnh hưởng mạnh nhất: cỡ mẫu tỷ lệ nghịch với bình phương mức chênh lệch, nên muốn phát hiện mức tăng nhỏ bằng một nửa thì cần gấp bốn lần mẫu. Bảng 2 minh họa với tỷ lệ chuyển đổi gốc 3%, mức ý nghĩa 5% hai phía và lực 80%.
Bảng 2. Cỡ mẫu cần thiết theo mức tăng tối thiểu muốn phát hiện (tỷ lệ gốc 3%)
| Mức tăng tương đối | Tỷ lệ nhóm mới | Số khách mỗi nhóm | Số ngày nếu có 2.000 lượt mỗi ngày |
|---|---|---|---|
| 5% | 3,15% | khoảng 208.000 | khoảng 208 ngày |
| 10% | 3,30% | khoảng 53.200 | khoảng 53 ngày |
| 20% | 3,60% | khoảng 13.900 | khoảng 14 ngày |
| 30% | 3,90% | khoảng 6.450 | khoảng 7 ngày |
Ghi chú: tính theo công thức chuẩn cho hai tỷ lệ; số ngày giả định 2.000 lượt truy cập mỗi ngày chia đều cho hai nhóm.
Bảng 2 giải thích câu chuyện mở đầu bài. Một website nhỏ với 2.000 lượt mỗi ngày gần như không thể phát hiện mức tăng 5% trong thời gian hợp lý. Nếu doanh nghiệp chỉ quan tâm đến những thay đổi lớn (từ 20% trở lên), hai tuần là đủ; nếu muốn tối ưu từng chi tiết nhỏ, cần lượng truy cập của một sàn thương mại điện tử lớn. Biết điều này từ trước giúp nhóm chọn thử những thay đổi đủ táo bạo thay vì đổi màu nút.
Phép tính trong Bảng 2 chỉ cần vài dòng Python. Đoạn mã dưới đây tính cỡ mẫu cho mỗi nhóm khi muốn phát hiện mức tăng từ 3% lên 3,6%:
from scipy.stats import norm

def co_mau(p_a, p_b, alpha=0.05, luc=0.8):
    z_a = norm.ppf(1 - alpha / 2)
    z_b = norm.ppf(luc)
    phuong_sai = p_a * (1 - p_a) + p_b * (1 - p_b)
    return (z_a + z_b) ** 2 * phuong_sai / (p_b - p_a) ** 2

print(round(co_mau(0.03, 0.036)))
Kết quả in ra là 13.911 khách mỗi nhóm. Khi chưa có dữ liệu lịch sử để ước tính tỷ lệ gốc, Haughton và cộng sự (2026) khuyên chạy phép tính với một khoảng giá trị hợp lý rồi chọn cỡ mẫu lớn nhất trong khoảng đó.
3.2. Quy cỡ mẫu ra thời gian, và vì sao không dừng sớm
Có cỡ mẫu rồi, chia cho lượng truy cập mỗi ngày để ra số ngày, sau đó làm tròn lên thành số tuần trọn vẹn. Hành vi mua sắm khác nhau giữa ngày thường và cuối tuần, giữa đầu tháng và cuối tháng; chạy đúng bội số của tuần giúp hai nhóm cùng trải qua đủ các chu kỳ đó. Cũng nên tránh các dịp đặc biệt như Tết, ngày đôi 11.11 hay đợt khuyến mãi lớn, trừ khi chính dịp đó là đối tượng cần thử.
Lỗi phổ biến nhất là xem kết quả liên tục và dừng ngay khi thấy có ý nghĩa. Nếu mỗi ngày đều kiểm tra và dừng ở lần đầu tiên p-value xuống dưới 0,05, xác suất kết luận sai thực tế cao hơn 5% rất nhiều, vì ta đã cho ngẫu nhiên nhiều cơ hội để tạo ra một ngày "đẹp". Nếu tổ chức cần theo dõi sớm, hãy dùng các phương pháp kiểm định tuần tự được thiết kế cho việc nhìn nhiều lần, thay vì dùng kiểm định thông thường.
Một hiện tượng khác cũng làm kết quả ngắn hạn sai lệch là hiệu ứng mới lạ: khách quen nhấp vào giao diện mới chỉ vì nó lạ, rồi vài tuần sau trở lại hành vi cũ. Ngược lại, có thay đổi cần thời gian để khách quen dần. Theo dõi mức chênh lệch theo từng tuần giúp nhận ra hai hiện tượng này.
4. Chia nhóm đúng cách
Gán ngẫu nhiên là nền móng của thử nghiệm, và cũng là chỗ dễ hỏng mà không ai nhận ra. Phần này nói về đơn vị chia nhóm, ngẫu nhiên theo khối khi mẫu nhỏ, và một phép kiểm tra đơn giản để phát hiện chia nhóm hỏng.
4.1. Chọn đơn vị ngẫu nhiên
Đơn vị được gán ngẫu nhiên có thể là lượt truy cập, người dùng, cửa hàng hay khu vực. Nguyên tắc là chọn đơn vị sao cho một người không vô tình thấy cả hai phương án. Nếu gán theo lượt truy cập, cùng một khách có thể thấy giá A buổi sáng và giá B buổi chiều, vừa gây khó chịu vừa làm hai nhóm "nhiễm" lẫn nhau. Với thử nghiệm giá hay chính sách, nên gán theo người dùng; với thay đổi tại điểm bán, đơn vị là cửa hàng. Khi đơn vị là cửa hàng hay khu vực, số đơn vị thường nhỏ và cần đến kỹ thuật ở mục 4.2.
4.2. Ngẫu nhiên theo khối khi mẫu nhỏ
Haughton và cộng sự (2026) đưa ví dụ một chuỗi bán lẻ có 1.000 cửa hàng trải khắp 50 bang, muốn thử màu xanh thay cho màu vàng chủ đạo (tường, đồng phục nhân viên) ở 20 cửa hàng thí điểm. Nếu chọn hoàn toàn ngẫu nhiên 10 cửa hàng nhận màu xanh, rất có thể chúng dồn về một vùng, và chênh lệch doanh số phản ánh khác biệt vùng miền chứ không phải màu sắc. Giải pháp là ngẫu nhiên theo khối (randomized block design, còn gọi là ngẫu nhiên phân tầng): chia cửa hàng thành bốn vùng, rồi trong mỗi vùng mới gán ngẫu nhiên xanh hoặc vàng. Nếu việc thử phải trải qua ba tháng, có thể thêm tháng làm biến chia khối, thành 12 khối.
Ở Việt Nam, một chuỗi cà phê muốn thử thực đơn mới ở 20 cửa hàng có thể chia khối theo miền (Bắc, Trung, Nam) và theo vị trí (văn phòng, khu dân cư), rồi gán ngẫu nhiên trong từng khối. Kỹ thuật này đặc biệt hữu ích khi số đơn vị ít; với hàng trăm nghìn người dùng trực tuyến, ngẫu nhiên đơn giản đã đủ cân bằng.
4.3. Kiểm tra lệch tỷ lệ mẫu
Nếu thiết kế chia đôi 50:50 mà kết quả là 50.000 người ở nhóm A và 48.500 người ở nhóm B, có thể có lỗi kỹ thuật: phiên bản B tải chậm khiến một số người rời đi trước khi được ghi nhận, hoặc bộ lọc chặn máy quét tự động hoạt động khác nhau giữa hai nhóm. Hiện tượng này gọi là lệch tỷ lệ mẫu (sample ratio mismatch, SRM). Fabijan và cộng sự (2019) cho thấy SRM xuất hiện khá thường xuyên trong thử nghiệm trực tuyến và gần như luôn báo hiệu kết quả không đáng tin. Kiểm tra rất đơn giản: dùng kiểm định khi bình phương so sánh số lượng thực tế với tỷ lệ thiết kế. Nếu có SRM, đừng phân tích tiếp mà hãy tìm nguyên nhân trước. Bài Nghịch lý Simpson trong phân tích dữ liệu cho thấy SRM kết hợp với khác biệt cơ cấu nhóm có thể đảo ngược cả kết luận.
5. Thử nhiều yếu tố cùng lúc
Khi muốn thử nhiều yếu tố, cách tự nhiên là thử lần lượt: tháng này thử giá, tháng sau thử phí, tháng sau nữa thử nội dung. Phần này giải thích vì sao cách đó vừa chậm vừa có thể bỏ lỡ phương án tốt nhất, và thiết kế giai thừa giải quyết vấn đề ra sao.
5.1. Vì sao thử từng yếu tố một là chưa đủ
Thử từng yếu tố một mất nhiều thời gian, nhất là với thư gửi qua bưu điện cần vài tuần mỗi đợt. Nghiêm trọng hơn, nó ngầm giả định các yếu tố không ảnh hưởng lẫn nhau: mức giá tốt nhất của đợt một được giữ cố định khi thử phí ở đợt hai. Nếu tác động của phí phụ thuộc vào giá, ta có thể không bao giờ tìm ra tổ hợp tốt nhất (Haughton và cộng sự, 2026). Thiết kế cho phép thử mọi yếu tố trong một chiến dịch được giới kinh doanh gọi là thử nghiệm đa biến (multivariate testing). Các ngân hàng phát hành thẻ tín dụng ở Mỹ dùng cách này từ những năm 1990, và nhiều thư mời mở thẻ mà các hộ gia đình nhận được thực chất là một ô trong một thí nghiệm lớn.
5.2. Thiết kế giai thừa và hiệu ứng tương tác
Ví dụ của Haughton và cộng sự (2026) là một hãng hàng không bán gói hội viên ưu tiên với phí 99 đô la mỗi năm, giúp giảm trung bình 5 phút làm thủ tục. Hãng muốn biết khách có sẵn lòng trả nhiều hơn để được nhanh hơn không, nên thử hai mức phí (69 và 99 đô la) và hai mức rút ngắn thời gian (5 và 15 phút). Thiết kế giai thừa đầy đủ gồm 2 × 2 = 4 ô, khách được chọn ngẫu nhiên vào từng ô. Bảng 3 là một kết quả có thể gặp.
Bảng 3. Tỷ lệ chấp nhận gói hội viên theo phí và thời gian rút ngắn
| Phí 69 đô la | Phí 99 đô la | |
|---|---|---|
| Rút ngắn 5 phút | 3% | 2% |
| Rút ngắn 15 phút | 6% | 3% |
Nguồn: dựa trên ví dụ minh họa của Haughton và cộng sự (2026).
Từ bốn ô này có thể tính ba tác động. Tác động chính của phí là trung bình hai ô phí cao trừ trung bình hai ô phí thấp: (3% + 2%)/2 − (6% + 3%)/2 = −2 điểm phần trăm. Tác động chính của thời gian là (6% + 3%)/2 − (3% + 2%)/2 = +2 điểm. Hiệu ứng tương tác cho biết tác động của một yếu tố có phụ thuộc vào mức của yếu tố kia không: khi chỉ rút ngắn 5 phút, giảm phí chỉ thêm 1 điểm (3% so với 2%); khi rút ngắn 15 phút, giảm phí thêm tới 3 điểm (6% so với 3%). Hình 2 thể hiện điều này bằng hai đường không song song.
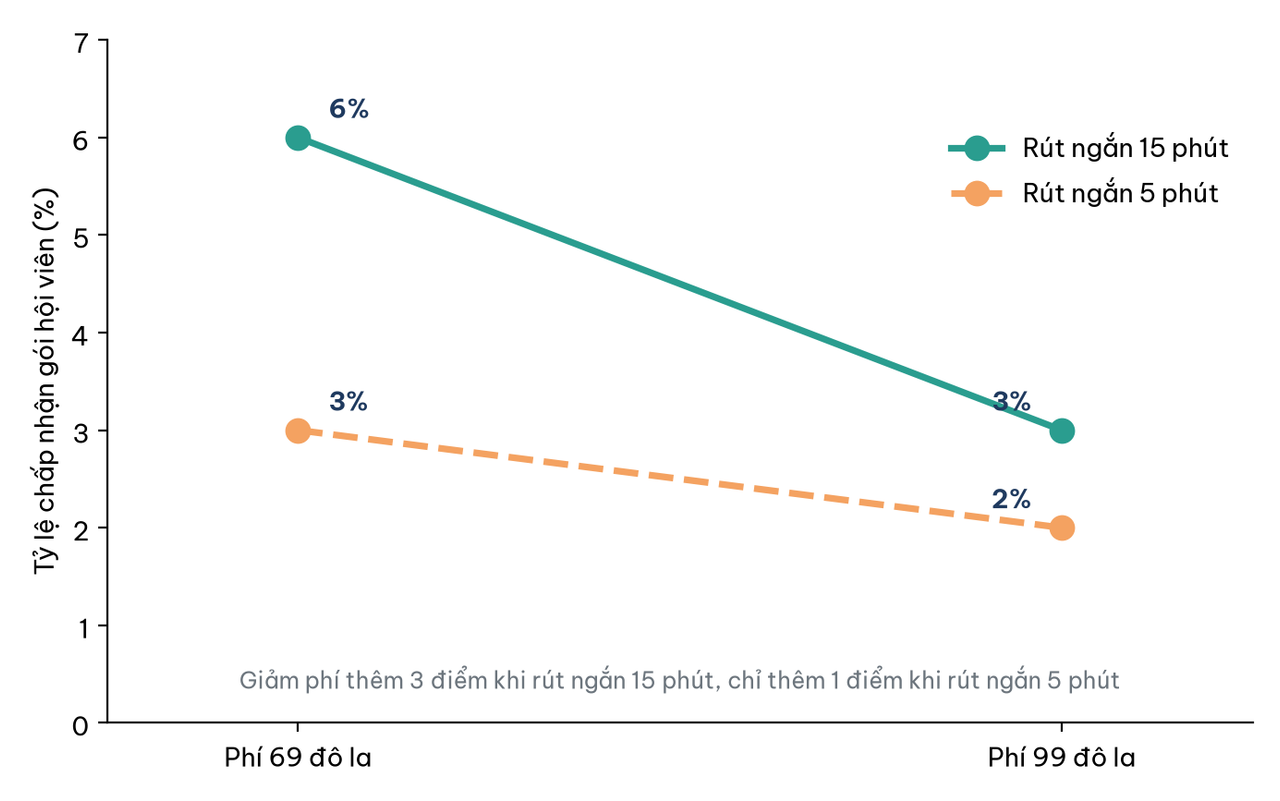
Hình 2. Hai đường không song song là dấu hiệu của hiệu ứng tương tác. Nguồn: dựa trên số liệu minh họa của Haughton và cộng sự (2026).
Ý nghĩa kinh doanh của Hình 2 là hai thay đổi bổ trợ nhau: khách chỉ thực sự nhạy với giá khi lợi ích đủ lớn. Nếu hãng thử lần lượt (trước thử phí ở mức 5 phút, sau thử thời gian ở mức phí đã chọn), hãng sẽ đánh giá thấp tác động của giảm phí. Thiết kế giai thừa còn có lợi thế về hiệu quả: mỗi khách tham gia đóng góp thông tin cho cả hai yếu tố, nên tổng cỡ mẫu nhỏ hơn hai thử nghiệm riêng.
5.3. Khi có quá nhiều tổ hợp: thiết kế giai thừa từng phần
Số ô tăng rất nhanh. Một nhà bán lẻ muốn thử ba yếu tố, mỗi yếu tố hai mức (mức giảm giá 20% hay 30%, gửi một hay hai lần mỗi tháng, bưu thiếp hay thư), đã có 2³ = 8 ô. Một ngân hàng thử lãi suất, phí thường niên, quyền lợi và màu thẻ, mỗi thứ vài mức, có thể có hàng trăm tổ hợp. Thiết kế giai thừa từng phần chỉ chạy một phần được chọn có hệ thống của các tổ hợp, chấp nhận hy sinh một số hiệu ứng tương tác bậc cao (thường ít quan trọng) để vẫn ước lượng được các tác động chính.
Khái niệm then chốt ở đây là độ phân giải (resolution) của thiết kế. Ở thiết kế độ phân giải III, các tác động chính không lẫn với nhau nhưng có thể lẫn với tương tác hai yếu tố. Ở độ phân giải IV, tác động chính không lẫn với tương tác hai yếu tố, nhưng các tương tác hai yếu tố có thể lẫn với nhau. Trên thực tế, thiết kế được sinh bằng phần mềm (SAS, JMP, R), có thể thêm ràng buộc kinh doanh như "không bao giờ kết hợp lãi suất thấp nhất với phí bằng không", rồi kiểm tra lại xem mọi tác động cần thiết có ước lượng được không (Haughton và cộng sự, 2026). Với người mới, nguyên tắc thực dụng là: nếu có lý do kinh doanh để nghi hai yếu tố tương tác (ví dụ giá và chất lượng), hãy chọn thiết kế cho phép ước lượng tương tác đó.
6. Đọc kết quả
Khi thử nghiệm chạy đủ thời gian đã định, việc đọc kết quả gồm ba câu hỏi: chênh lệch có vượt quá dao động ngẫu nhiên không, chênh lệch lớn đến đâu, và có đáng để hành động không. Phần này đi qua từng câu hỏi bằng một ví dụ.
6.1. p-value và khoảng tin cậy
Giả sử mỗi nhóm có 15.000 khách; nhóm A có 450 đơn (3,0%), nhóm B có 540 đơn (3,6%). Kiểm định hai tỷ lệ cho z ≈ 2,91 và p-value ≈ 0,004. P-value có nghĩa là: nếu hai phương án thực ra như nhau, xác suất thấy chênh lệch lớn cỡ này hoặc hơn chỉ khoảng 0,4%. Nó không có nghĩa là "xác suất B tốt hơn là 99,6%". Thông tin hữu ích hơn là khoảng tin cậy 95% của chênh lệch: từ khoảng 0,2 đến 1,0 điểm phần trăm. Khoảng này nói rằng B tốt hơn, nhưng mức cải thiện có thể chỉ khiêm tốn 0,2 điểm hoặc lớn tới 1 điểm.
6.2. Ý nghĩa thống kê và ý nghĩa kinh doanh
Ý nghĩa thống kê chỉ cho biết chênh lệch khó là ngẫu nhiên; nó không cho biết chênh lệch có đáng tiền. Với lượng khách rất lớn, một mức tăng 0,01 điểm phần trăm cũng có thể "có ý nghĩa" mà không bù nổi chi phí triển khai. Vì vậy hãy quy khoảng tin cậy ra tiền: nếu mỗi đơn lãi 100.000 đồng và có một triệu khách mỗi tháng, mức tăng 0,2 điểm tương ứng 2.000 đơn và 200 triệu đồng mỗi tháng; nếu chi phí triển khai và duy trì phương án mới thấp hơn nhiều so với con số ở đầu dưới của khoảng, quyết định khá an toàn. Theo Bảng 1, chỉ số dùng để ra quyết định cuối cùng nên là doanh thu hoặc ROI tăng thêm, không chỉ tỷ lệ chuyển đổi.
6.3. Cẩn thận khi chia nhỏ theo phân khúc
Sau khi có kết quả chung, ai cũng muốn xem theo phân khúc: khách mới hay cũ, điện thoại hay máy tính, miền Bắc hay miền Nam. Việc này hữu ích để hiểu cơ chế, nhưng mỗi lần chia là một lần kiểm định mới, và với 20 phân khúc thì gần như chắc chắn có một phân khúc "có ý nghĩa" do ngẫu nhiên. Phát hiện theo phân khúc nên được coi là giả thuyết cho thử nghiệm sau, trừ khi phân khúc đó đã được định trước và cỡ mẫu được tính cho nó. Muốn khai thác một cách có hệ thống chuyện "phương án nào hợp với ai", cần đến Mô hình uplift trong marketing.
7. Bảy lỗi thường gặp
Phần lớn thử nghiệm thất bại không phải vì công thức sai mà vì quy trình sai. Bảng 4 tổng hợp bảy lỗi gặp nhiều nhất, dấu hiệu nhận biết và cách phòng tránh.
Bảng 4. Bảy lỗi thường gặp khi làm thử nghiệm A/B
| Lỗi | Dấu hiệu | Cách phòng tránh |
|---|---|---|
| 1. Không có giả thuyết, chọn chỉ số sau | Báo cáo chỉ số nào "đẹp" nhất | Viết giả thuyết, chỉ số chính và mức tác động tối thiểu trước khi chạy |
| 2. Cỡ mẫu quá nhỏ | Kết quả dao động mạnh, đảo chiều khi chạy thêm | Tính cỡ mẫu trước (Bảng 2); thử thay đổi đủ lớn |
| 3. Xem liên tục và dừng sớm | Dừng ngay khi p < 0,05 | Chạy đủ số tuần đã định hoặc dùng kiểm định tuần tự |
| 4. Gộp nhiều thay đổi vào một phiên bản | Không biết thay đổi nào tạo tác động | Một yếu tố cho A/B; nhiều yếu tố thì dùng thiết kế giai thừa |
| 5. Chia nhóm hỏng | Lệch tỷ lệ mẫu, một khách thấy cả hai phiên bản | Gán theo người dùng; kiểm tra SRM; ngẫu nhiên theo khối khi mẫu nhỏ |
| 6. Đọc p-value sai | "99% chắc chắn B tốt hơn" | Báo cáo khoảng tin cậy và quy ra tiền |
| 7. Đào bới phân khúc | Tìm thấy phân khúc "thắng" sau khi chung không thắng | Định trước phân khúc; coi phát hiện mới là giả thuyết |
Nguồn: tổng hợp từ Kohavi và cộng sự (2020) và Haughton và cộng sự (2026).
Ngoài bảy lỗi kỹ thuật, còn một lỗi về đạo đức: thử nghiệm trên khách hàng những thay đổi có thể gây hại, như giá phân biệt theo đặc điểm cá nhân hay thông điệp gây lo sợ. Bài Suy luận nhân quả từ dữ liệu đã bàn về ranh giới này qua thí nghiệm cảm xúc của Facebook năm 2014. Một thử nghiệm đúng phương pháp nhưng làm mất lòng tin của khách hàng vẫn là thử nghiệm thất bại.
8. Công cụ
Công cụ chỉ thực hiện những quyết định ở các mục trên; nó không quyết định thay. Có thể chia công cụ thành ba nhóm theo vai trò.
Nhóm thứ nhất là nền tảng thử nghiệm lo phần chia nhóm, hiển thị phiên bản và ghi nhận kết quả trên website hoặc ứng dụng, như Optimizely, VWO, hay các lựa chọn mã nguồn mở như GrowthBook. Google Optimize, công cụ miễn phí từng phổ biến, đã ngừng hoạt động năm 2023, nên những hướng dẫn cũ dựa trên nó không còn áp dụng được. Nhóm thứ hai là công cụ của kênh marketing: phần mềm gửi email và nền tảng quảng cáo thường có sẵn chức năng chia thử nội dung. Nhóm thứ ba là công cụ phân tích: Excel đủ cho tính cỡ mẫu và kiểm định hai tỷ lệ, Python hay R cần cho thiết kế giai thừa và phân tích sâu hơn.
Dù dùng công cụ nào, nên lưu một "hồ sơ thử nghiệm" cho mỗi lần chạy: giả thuyết, chỉ số, cỡ mẫu dự kiến, ngày bắt đầu và kết thúc, kết quả, quyết định và bài học. Theo thời gian, hồ sơ này trở thành tài sản tri thức của doanh nghiệp và là đầu vào cho bước "học" trong Hình 1.
Kết luận
Thử nghiệm A/B là cách mạnh nhất để biết một thay đổi có thực sự tạo ra kết quả, vì gán ngẫu nhiên tạo ra nhóm so sánh mà không phương pháp phân tích dữ liệu quan sát nào sánh được. Nhưng sức mạnh đó chỉ đến khi quy trình đúng: giả thuyết và chỉ số được viết ra trước, cỡ mẫu được tính dựa trên mức tác động tối thiểu đáng quan tâm, thời gian chạy tròn tuần và không dừng sớm, việc chia nhóm được kiểm tra, và kết quả được đọc bằng khoảng tin cậy quy ra tiền chứ không chỉ bằng p-value.
Khi có nhiều yếu tố cần thử, thiết kế giai thừa cho phép học nhanh hơn và phát hiện được những tương tác mà thử từng yếu tố một sẽ bỏ lỡ, như ví dụ phí và thời gian của hãng hàng không. Và khi mục tiêu chuyển từ "phương án nào tốt hơn cho mọi người" sang "phương án nào tốt hơn cho từng người", thử nghiệm A/B trở thành nguồn dữ liệu cho mô hình uplift. Điểm chung của mọi bước là tinh thần thử và học: mỗi thử nghiệm, kể cả thử nghiệm "thua", đều đáng giá nếu nó cho ta biết thêm một điều chắc chắn về khách hàng.
Đọc thêm
- Suy luận nhân quả từ dữ liệu
- Tương quan không phải nhân quả và 5 bẫy cần tránh
- Nghịch lý Simpson trong phân tích dữ liệu
- Mô hình uplift trong marketing
- Từ bài toán kinh doanh đến giải pháp dữ liệu
- Ra quyết định dựa trên dữ liệu
Tài liệu tham khảo
Fabijan, A., Gupchup, J., Gupta, S., Omhover, J., Qin, W., Vermeer, L., & Dmitriev, P. (2019). Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners. In Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 2156–2164). Association for Computing Machinery. https://doi.org/10.1145/3292500.3330722
Haughton, D., Haughton, J., & Lo, V. S. Y. (2026). Cause and effect business analytics and data science. CRC Press. https://doi.org/10.1201/9780429172588
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985