
ĐO CHẤT LƯỢNG DỮ LIỆU
Sáu chiều chất lượng, bảng điều khiển bằng SQL, thứ tự làm sạch đúng và quản trị để dữ liệu không xuống cấp
Chuỗi siêu thị mini giả định Sen Vàng Mart ra mắt ứng dụng di động cho khách đăng ký thành viên. Sau tuần đầu, 500 lượt đăng ký được nhập thẳng vào một bảng tạm, chưa qua ràng buộc nào. Phòng marketing muốn gửi ngay một chương trình chào mừng qua email và tin nhắn. Trước khi gửi, một chuyên viên chạy vài phép kiểm đơn giản và thấy chỉ 282 lượt đăng ký, tức 56,4%, không có lỗi gì. Gần một nửa còn lại thiếu ngày sinh, sai số điện thoại, sai email, hoặc là cùng một người đăng ký hai lần.
Một doanh nghiệp nội thất giả định tên Nhà Vui Home gặp chuyện tương tự theo hướng khác. Hệ thống báo có 30 khách hàng, nhưng đọc từng dòng chỉ có 21 người: một khách xuất hiện ba lần ở ba hệ thống, sáu người khác mỗi người hai lần. Mọi chỉ số tính trên đầu khách, như chi tiêu bình quân hay tỉ lệ quay lại, đều sai theo và không ai biết vì báo cáo vẫn chạy bình thường.
Hai tình huống cho thấy câu hỏi "dữ liệu của ta có tốt không?" không có câu trả lời chung mà phải được đo. Bài viết gồm năm mục. Mục 1 định nghĩa chất lượng dữ liệu và sáu chiều đo. Mục 2 dựng một bảng điều khiển chất lượng trên 500 lượt đăng ký. Mục 3 chỉ ra vì sao cộng các lỗi lại cho số sai. Mục 4 trình bày thứ tự làm sạch đúng. Mục 5 bàn quản trị dữ liệu, để chất lượng không xuống cấp trở lại sau khi làm sạch.
1. Chất lượng dữ liệu và sáu chiều đo
Chất lượng dữ liệu (data quality) là mức độ dữ liệu phù hợp với mục đích sử dụng của người dùng dữ liệu, chứ không chỉ là độ chính xác (Wang & Strong, 1996). Một bảng khách hàng thiếu email hoàn toàn đủ tốt để dự báo nhu cầu theo khu vực, nhưng vô dụng cho một chiến dịch email cá nhân hóa. Wang và Strong (1996) khảo sát chính người dùng dữ liệu và gom các chiều chất lượng thành bốn nhóm: nội tại (chính xác, khách quan), theo ngữ cảnh (đầy đủ, kịp thời, liên quan), về cách biểu diễn (dễ hiểu, nhất quán) và về khả năng truy cập. Jukić (2025) rút gọn thành sáu chiều đo được bằng truy vấn, như Bảng 1.
Bảng 1. Sáu chiều chất lượng dữ liệu và cách đo
| Chiều | Câu hỏi | Ví dụ phép đo | Ứng dụng bị ảnh hưởng |
|---|---|---|---|
| Chính xác (accuracy) | Dữ liệu có phản ánh đúng thực tế không? | Ngày sinh sau ngày đăng ký là không thể | Phân khúc theo tuổi |
| Đầy đủ (completeness) | Có thiếu giá trị cần thiết không? | Đếm ô ngày sinh trống | Chương trình sinh nhật |
| Nhất quán (consistency) | Cùng một thứ có được ghi giống nhau không? | Hạng thành viên ngoài danh mục ba giá trị | Ghép dữ liệu giữa hệ thống |
| Duy nhất (uniqueness) | Một đối tượng có bị ghi nhiều lần không? | Số điện thoại đã có; dòng lặp lại | Đếm khách, giá trị vòng đời |
| Kịp thời (timeliness) | Dữ liệu có kịp lúc cần không? | Khoảng cách giữa ngày đăng ký và ngày nhập | Chào mừng khách mới |
| Đúng định dạng (conformity) | Có theo quy cách đã định không? | Số điện thoại mười chữ số; email; ngày YYYY-MM-DD | Gửi tin, gửi email |
Nguồn: dựa trên Jukić (2025) và Wang & Strong (1996).
Mỗi chiều trong Bảng 1 trả lời một câu hỏi khác và cần một phép đo khác; một tập dữ liệu có thể tốt ở chiều này mà tệ ở chiều kia. Cột cuối nhắc rằng mỗi chiều làm hỏng một loại ứng dụng khác nhau, nên mức "đủ tốt" phải đặt theo mục đích: chương trình sinh nhật cần chiều đầy đủ của ngày sinh, còn đếm khách cần chiều duy nhất.
2. Bảng điều khiển chất lượng
Dữ liệu sinh ra bên trong một cơ sở dữ liệu có ràng buộc tốt thường gần như sạch: không có giá âm, không có khuyến mãi kết thúc trước khi bắt đầu. Dữ liệu đến từ bên ngoài thì khác và 500 lượt đăng ký từ ứng dụng là tình huống điển hình khi một hệ thống mới được nối vào hệ thống cũ. Cách đo hiệu quả là dựng một bảng điều khiển chất lượng: mỗi dòng là một phép đo, viết bằng một câu truy vấn đếm số dòng vi phạm, rồi ghép các câu lại bằng UNION ALL. Hình 1 là kết quả của chín phép đo.
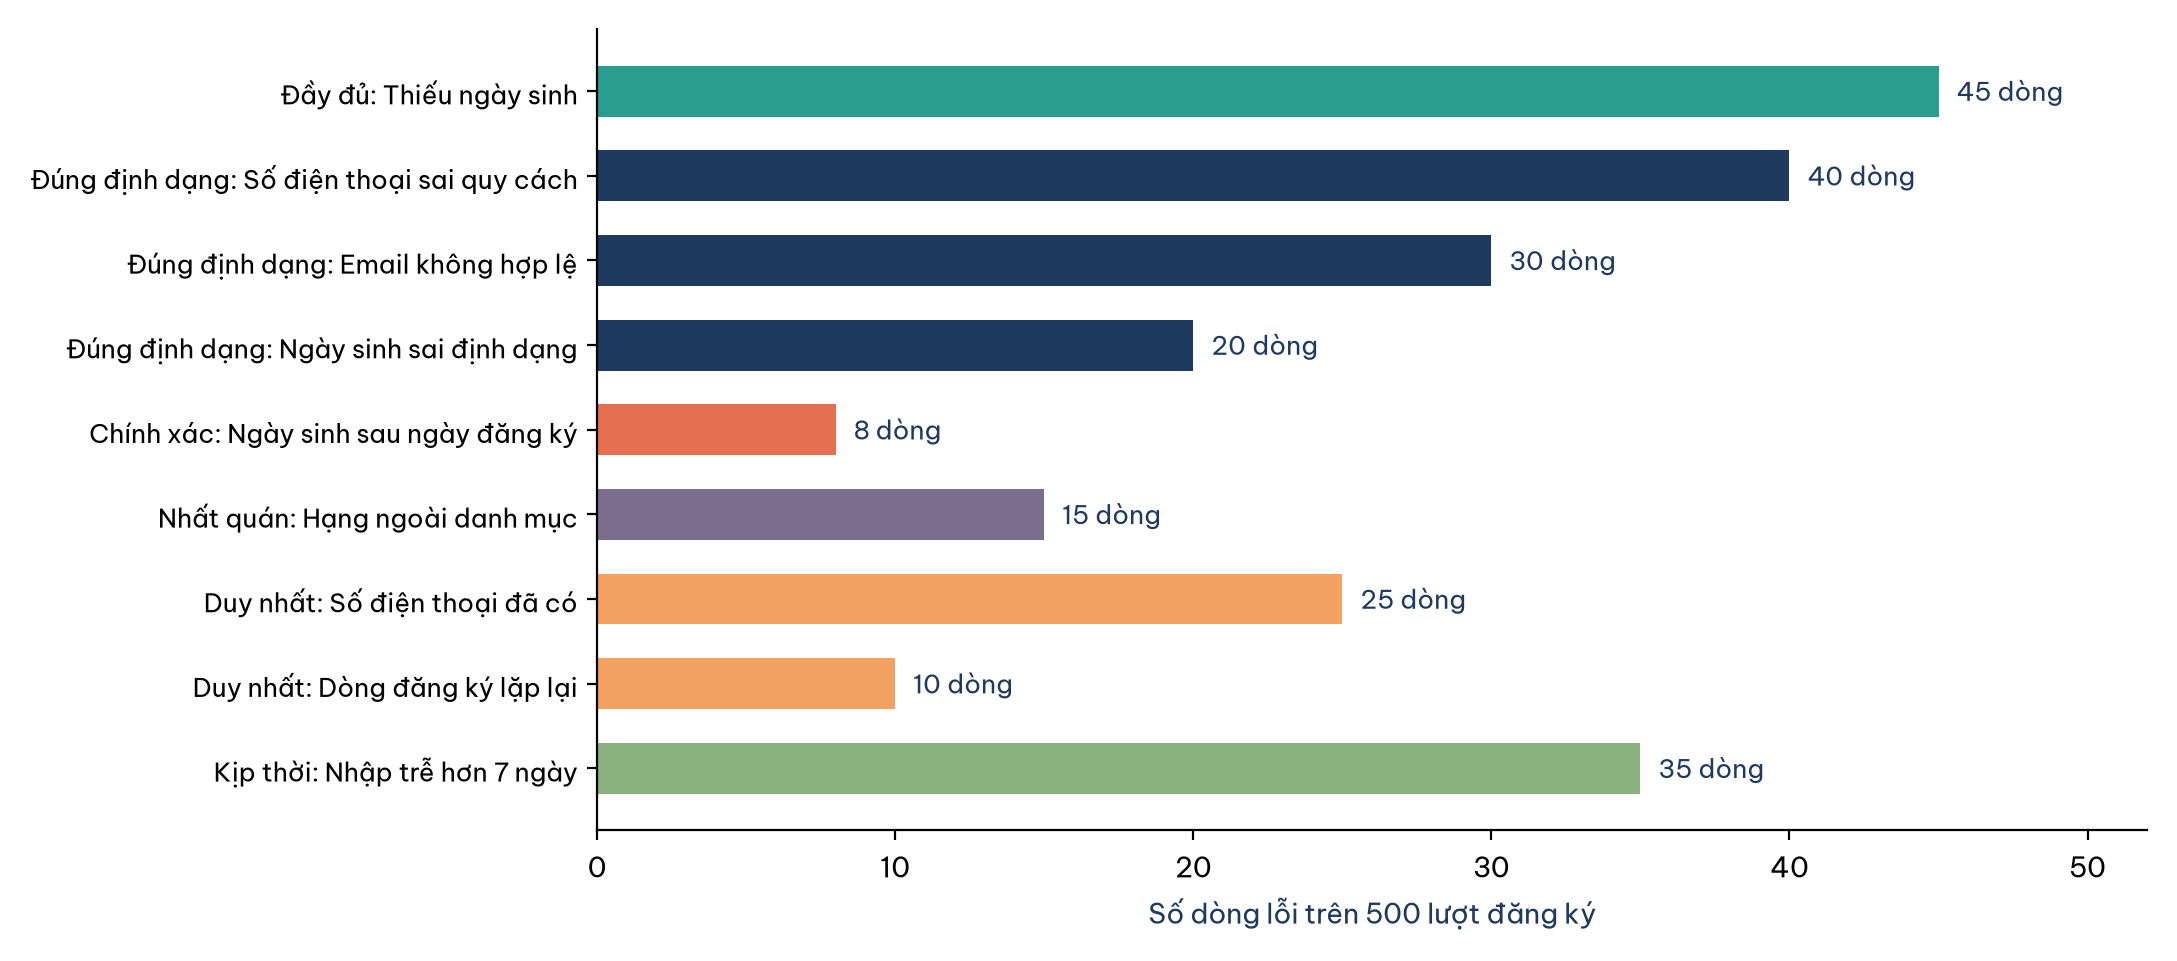
Hình 1. Bảng điều khiển chất lượng trên 500 lượt đăng ký từ ứng dụng (tình huống giả định). Nguồn: dựa trên Jukić (2025).
Hình 1 cho thấy lỗi phân bố ở cả sáu chiều chứ không dồn vào một chỗ. Chiều đúng định dạng có nhiều lỗi nhất, với 90 dòng ở ba phép đo, phần lớn do ô nhập trên ứng dụng không kiểm tra quy cách. Lỗi chính xác ít nhất, 8 dòng ngày sinh sau ngày đăng ký, nhưng là loại khó sửa nhất vì không có cách nào biết ngày sinh đúng là gì. 35 dòng nhập trễ hơn bảy ngày nghĩa là chương trình chào mừng đến tay những khách này khi họ đã quên mình vừa đăng ký.
Đo chất lượng không chỉ dành cho dữ liệu bên ngoài. Ngay trong bảng khách hàng chính thức, đã qua mọi ràng buộc, một phép đo trùng lặp tìm thấy hai cặp khách dùng chung một số điện thoại. Có thể là vợ chồng dùng chung một số, có thể là một người đăng ký hai lần. Lược đồ không đặt ràng buộc duy nhất trên số điện thoại và không nên đặt, vì trường hợp thứ nhất là hợp lệ. Chất lượng dữ liệu vì thế không giao hết được cho ràng buộc: một phần của nó là phán đoán nghiệp vụ, cần người xem xét.
3. Vì sao cộng các lỗi lại cho số sai
Cộng chín con số ở Hình 1 được 228 lỗi. Một phép đo khác đếm thẳng số dòng không vi phạm phép kiểm nào cho kết quả 282 dòng sạch, tức 218 dòng có lỗi. Bảng 2 đặt các con số cạnh nhau.
Bảng 2. Tổng số lỗi và số dòng có lỗi trên 500 lượt đăng ký (tình huống giả định)
| Phép đếm | Kết quả |
|---|---|
| Tổng số lỗi theo chín phép đo | 228 |
| Số dòng sạch | 282 (56,4%) |
| Số dòng có ít nhất một lỗi | 218 |
| Chênh lệch | 10 |
Chênh lệch 10 trong Bảng 2 không phải sai số làm tròn: nó đúng bằng 10 dòng đăng ký lặp lại. Lỗi trùng lặp không thuộc về một dòng nào mà thuộc về quan hệ giữa hai dòng, nên không phép kiểm tra theo từng dòng nào bắt được nó; mỗi dòng trong cặp lặp đều trông hoàn toàn hợp lệ khi đứng một mình. Đây là lý do chiều duy nhất cần những phép đo riêng, như gom nhóm theo số điện thoại hay so khớp với bảng khác.
Bảng 2 còn chứa một bài học thứ hai: tổng số lỗi và số dòng có lỗi trả lời hai câu hỏi khác nhau. Một dòng có thể vừa thiếu ngày sinh vừa sai email, nên cộng lỗi thường lớn hơn số dòng có lỗi; trùng lặp lại kéo theo hướng ngược lại. Muốn biết "bao nhiêu khách gửi được chương trình chào mừng", phải đếm thẳng dòng sạch, không suy ra từ tổng lỗi.
4. Thứ tự làm sạch đúng
Quay lại Nhà Vui Home với 30 bản ghi gom từ ba hệ thống: phần mềm bán hàng tại cửa hàng, website và tổng đài chăm sóc khách hàng. Một phép kiểm trùng số điện thoại báo có 20 số khác nhau, nhưng con số đúng thấp hơn. Lý do nằm ở số "+84900000101": đó là số của chính khách xuất hiện ba lần, viết theo định dạng quốc tế ở một hệ thống, trong khi hai hệ thống kia ghi "0900000101". Phép kiểm trùng coi đó là hai số khác nhau. Thêm vào đó, 23% bản ghi không có email gửi được, nên kế hoạch cá nhân hóa khuyến mãi qua email phải xét lại.
Bài học rút ra là chuẩn hóa phải đi trước khử trùng. Một quy trình làm sạch đi đúng thứ tự gồm bốn bước, như Hình 2.
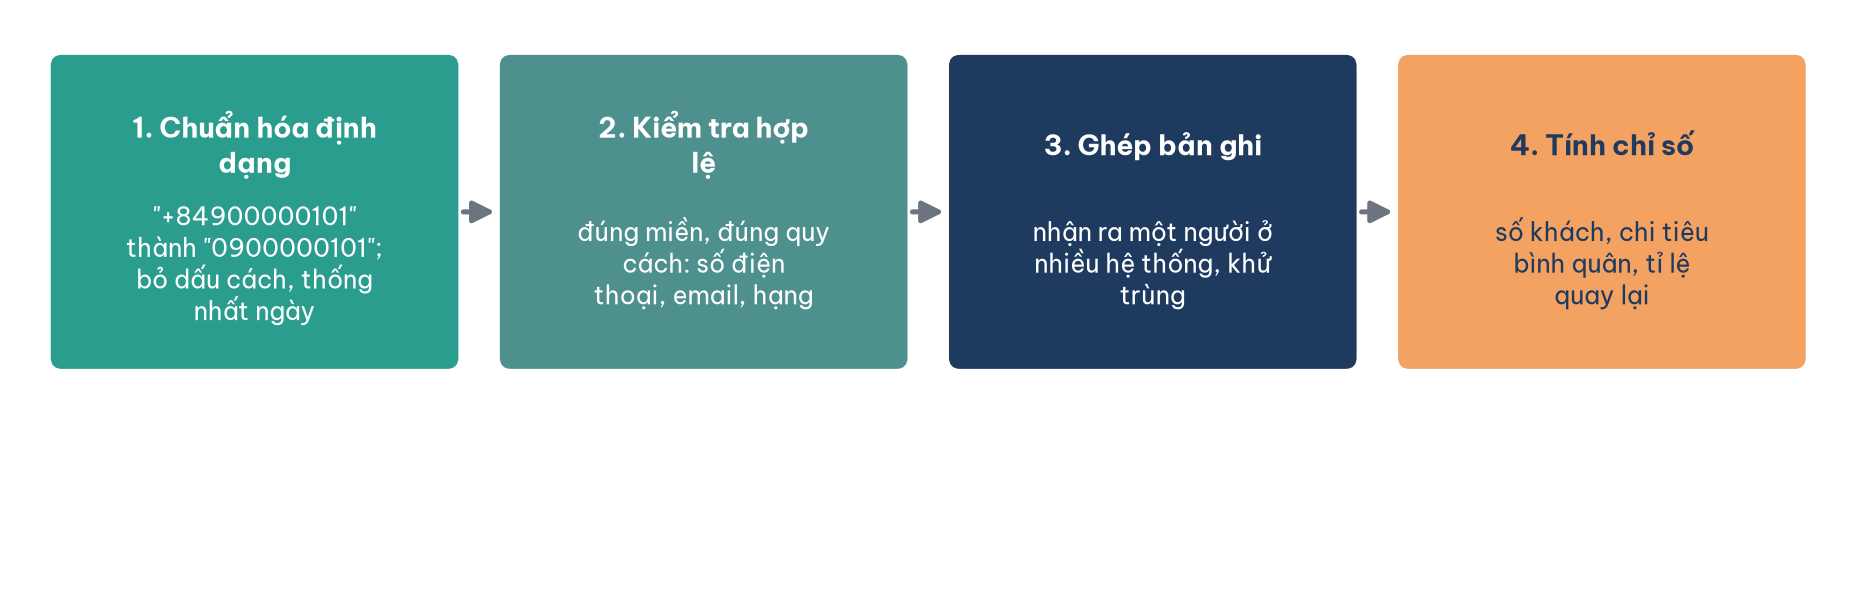
Hình 2. Thứ tự bốn bước làm sạch dữ liệu.
Thứ tự trong Hình 2 không tùy ý; mỗi bước dùng kết quả của bước trước. Kiểm tra hợp lệ trên dữ liệu chưa chuẩn hóa sẽ đánh dấu "+84900000101" là sai quy cách dù nó là một số đúng. Ghép bản ghi trước khi chuẩn hóa sẽ bỏ sót các cặp chỉ khác nhau ở cách viết, đúng như phép kiểm trùng ở Nhà Vui Home. Và tính chỉ số trước khi ghép sẽ cho số khách là 30 thay vì 21. Trong kho dữ liệu, bốn bước này nằm trong khâu biến đổi của ETL, như bài Kho dữ liệu là gì và khi nào doanh nghiệp cần nó mô tả.
Bước ghép bản ghi là bước cần phán đoán nhiều nhất. Hai bản ghi trùng số điện thoại có thể là một người, hoặc hai người chung một số; hai bản ghi khác số có thể vẫn là một người đã đổi số. Quy tắc ghép nên được viết ra, có ngưỡng rõ ràng và các trường hợp nằm giữa nên được đưa cho người xem xét thay vì để máy quyết định. Đây cũng là chỗ mà sai lệch trong dữ liệu bắt đầu, như bài Năm nguồn thiên kiến trong dữ liệu phân tích.
Cạm bẫy ở mục này là tin rằng "dữ liệu nhiều là đủ". Doanh nghiệp bán lẻ thường tự tin vì có hàng triệu dòng giao dịch. Nhưng lỗi hệ thống, như mỗi hệ thống ghi số điện thoại một kiểu, không giảm khi dữ liệu nhiều lên mà nhân lên theo. Mô hình AI học từ dữ liệu trùng lặp sẽ đánh giá sai cả khách lẫn hành vi mua, như bài Đo giá trị dự án AI trước khi đầu tư cảnh báo. Cách tránh là chạy các phép kiểm trên một mẫu vài trăm bản ghi trước khi bàn tới mô hình; kết quả thường đủ để biết cần đầu tư bao nhiêu vào làm sạch.
5. Quản trị dữ liệu
Làm sạch một lần không giữ được dữ liệu sạch. Cạm bẫy phổ biến nhất là đo chất lượng một lần rồi thôi: bảng điều khiển ở Hình 1 chỉ là một bức ảnh chụp tại một thời điểm, trong khi ứng dụng gửi thêm lượt đăng ký mỗi ngày và một bản cập nhật ứng dụng có thể đột ngột làm tăng số email sai. Cơ chế của cạm bẫy là coi chất lượng dữ liệu như một dự án có điểm kết thúc, thay vì một chỉ số vận hành cần theo dõi. Cách làm đúng là lưu các câu đo thành view, chạy định kỳ, theo dõi xu hướng của từng phép đo và đưa chúng vào quy trình nạp như một bước kiểm thử bắt buộc.
Theo dõi đòi hỏi có người chịu trách nhiệm. Quản trị dữ liệu (data governance) là hệ thống quyết định ai được làm gì với dữ liệu nào, theo quy tắc nào. Với doanh nghiệp vừa, không cần một bộ máy lớn mà cần bốn thành phần tối thiểu, mỗi thành phần chặn một loại lỗi, như Bảng 3.
Bảng 3. Bốn thành phần tối thiểu của quản trị dữ liệu
| Thành phần | Nội dung | Lỗi được chặn |
|---|---|---|
| Chủ sở hữu dữ liệu | Một người thuộc nghiệp vụ, không phải phòng công nghệ, chịu trách nhiệm định nghĩa và chất lượng của mỗi tập dữ liệu quan trọng | Chỉ số không đạt mà không có ai để giao việc |
| Danh mục dữ liệu | Nơi tra cứu: có những tập dữ liệu nào, mỗi cột nghĩa là gì, lấy từ đâu, cập nhật khi nào | Mỗi nhóm hiểu từ "doanh thu" theo một kiểu |
| Phân quyền và nhật ký | Ai được xem dữ liệu cá nhân, ai được xuất ra ngoài; mọi lượt truy cập được ghi lại | Dữ liệu cá nhân bị dán vào công cụ AI hoặc rò ra ngoài |
| Bảng mô tả tập dữ liệu | Tập dữ liệu tạo ra để làm gì, gồm những gì, thu thập và xử lý thế nào, nên và không nên dùng cho việc gì | Người dùng sau dùng dữ liệu vượt quá giới hạn mà họ không biết |
Nguồn: dựa trên Gebru et al. (2021).
Thành phần thứ ba trong Bảng 3 có thêm sức nặng pháp lý: Luật Bảo vệ dữ liệu cá nhân có hiệu lực từ ngày 1/1/2026 ghi nhận các quyền của chủ thể dữ liệu như được biết, đồng ý, truy cập, chỉnh sửa, xóa và rút lại sự đồng ý. Hệ quả cho kiến trúc dữ liệu là phải tìm được và xóa được mọi bản ghi của một người, điều không làm được nếu một khách nằm rải rác ở ba hệ thống mà không ai ghép lại. Bước ghép bản ghi ở Mục 4 vì thế không chỉ phục vụ phân tích mà còn là điều kiện để tuân thủ.
Thành phần thứ tư đến từ đề xuất của Gebru et al. (2021): mỗi tập dữ liệu dùng để huấn luyện mô hình nên đi kèm một bảng mô tả (datasheet), giống bảng thông số đi kèm linh kiện điện tử. Bảng mô tả buộc người tạo dữ liệu ghi ra những giới hạn mà người dùng sau không tự đoán được, chẳng hạn dữ liệu đổi trả chỉ có từ năm 2023 nên chưa có mùa Tết của năm trước đó.
AI hỗ trợ đo chất lượng ở hai việc. Từ từ điển dữ liệu, một trợ lý AI có thể đề xuất danh sách phép kiểm cho từng cột và viết câu truy vấn đếm vi phạm. Nhưng mỗi phép kiểm AI đề xuất phải được chạy thử trên dữ liệu thật và đối chiếu với nghiệp vụ, vì AI dễ đề xuất ràng buộc duy nhất trên số điện thoại, đúng ràng buộc sẽ chặn nhầm các cặp vợ chồng dùng chung số. Ngoài ra, không dán dữ liệu khách hàng thật vào công cụ AI công cộng; chỉ dán cấu trúc cột và vài dòng mẫu đã được thay bằng dữ liệu hư cấu.
Kết luận
Chất lượng dữ liệu không phải tính từ chung chung mà là một tập số đo, đặt theo mục đích sử dụng. Với 500 lượt đăng ký của Sen Vàng Mart, sáu chiều chất lượng cho chín phép đo và chỉ 56,4% số dòng không có lỗi nào. Cộng các lỗi lại cho con số sai vì lỗi trùng lặp nằm ở quan hệ giữa các dòng, nên phải đếm thẳng số dòng sạch và đo trùng lặp bằng phép đo riêng.
Làm sạch phải đi đúng thứ tự: chuẩn hóa định dạng, kiểm tra hợp lệ, ghép bản ghi, rồi mới tính chỉ số; đảo thứ tự là đếm 30 khách thay vì 21. Và vì dữ liệu mới đổ về mỗi ngày, chất lượng phải được theo dõi như một chỉ số vận hành, với chủ sở hữu, danh mục, phân quyền và bảng mô tả để nó không xuống cấp trở lại.
Đọc thêm
- Kho dữ liệu là gì và khi nào doanh nghiệp cần nó
- Lược đồ hình sao, bảng sự kiện và bảng chiều
- Năm nguồn thiên kiến trong dữ liệu
- Đo giá trị dự án AI trước khi đầu tư
- Trí tuệ nhân tạo cho dữ liệu văn phòng
Tài liệu tham khảo
Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé III, H., & Crawford, K. (2021). Datasheets for datasets. Communications of the ACM, 64(12), 86–92. https://doi.org/10.1145/3458723
Jukić, N. (2025). Database systems: Introduction to databases and data warehouses (3rd ed.). Prospect Press. https://www.prospectpressvt.com/textbooks/jukic-database-systems-introduction-to-databases-and-data-warehouses-3-0
Wang, R. Y., & Strong, D. M. (1996). Beyond accuracy: What data quality means to data consumers. Journal of Management Information Systems, 12(4), 5–33. https://doi.org/10.1080/07421222.1996.11518099