
NĂM NGUỒN THIÊN KIẾN TRONG DỮ LIỆU
Một bảng dữ liệu sạch hoàn hảo vẫn có thể ghi lệch thế giới, nếu cách dữ liệu được sinh ra đã lệch từ đầu
Một công cụ chấm hồ sơ tuyển dụng của Amazon được huấn luyện trên hồ sơ của mười năm trước đó, trong một ngành vốn đông nam giới. Dữ liệu không có lỗi chính tả, không thiếu dòng, không trùng lặp. Vậy mà công cụ tự học cách hạ điểm những hồ sơ có từ "women's", như "đội trưởng câu lạc bộ cờ vua nữ" và cuối cùng phải bị dừng (Dastin, 2018). Không có bước làm sạch dữ liệu nào phát hiện được vấn đề này, vì dữ liệu không sai: nó ghi lại rất chính xác những gì đã xảy ra.
Làm sạch dữ liệu, như sửa định dạng, loại trùng, xử lý giá trị thiếu, sửa được lỗi trong bảng dữ liệu, nhưng không sửa được sai lệch nằm trong cách dữ liệu được sinh ra. Một bảng sạch hoàn hảo vẫn có thể ghi lệch thế giới một cách có hệ thống. Vì vậy, trước khi làm sạch, người phân tích nên hỏi ba câu: dữ liệu này do ai hoặc cái gì tạo ra, nhằm mục đích gì và điều gì không bao giờ được ghi vào đây.
Bài viết điểm năm nguồn thiên kiến hay gặp nhất ở bước thu thập dữ liệu. Mục 1 đặt năm nguồn vào bức tranh chung. Mục 2 đến mục 5 lần lượt trình bày thiên kiến lịch sử, thiên kiến gán nhãn, thiên kiến ghi nhận và hai thiên kiến sinh ra khi dữ liệu đến từ con người là thiên kiến nhớ lại và hiệu ứng người quan sát. Mục 6 tổng hợp năm nguồn thành một bảng tự kiểm và đề xuất một thói quen cho từ điển dữ liệu.
1. Năm nguồn thiên kiến trong bức tranh chung
Thiên kiến có thể xuất hiện ở nhiều bước của một phân tích. Các thiên kiến sinh ra khi rút mẫu, như thiên kiến chọn mẫu, không phản hồi hay sống sót, thuộc về thống kê; bài Bài học thống kê từ một tấm meme bàn kỹ thiên kiến sống sót. Thiên kiến trong cách đặt câu hỏi được bàn trong bài Đặt đúng câu hỏi phân tích. Bài này tập trung vào bước thu thập dữ liệu trong mô hình SOAR, nơi năm nguồn thiên kiến sinh ra từ chính quá trình dữ liệu được tạo ra, như Hình 1.
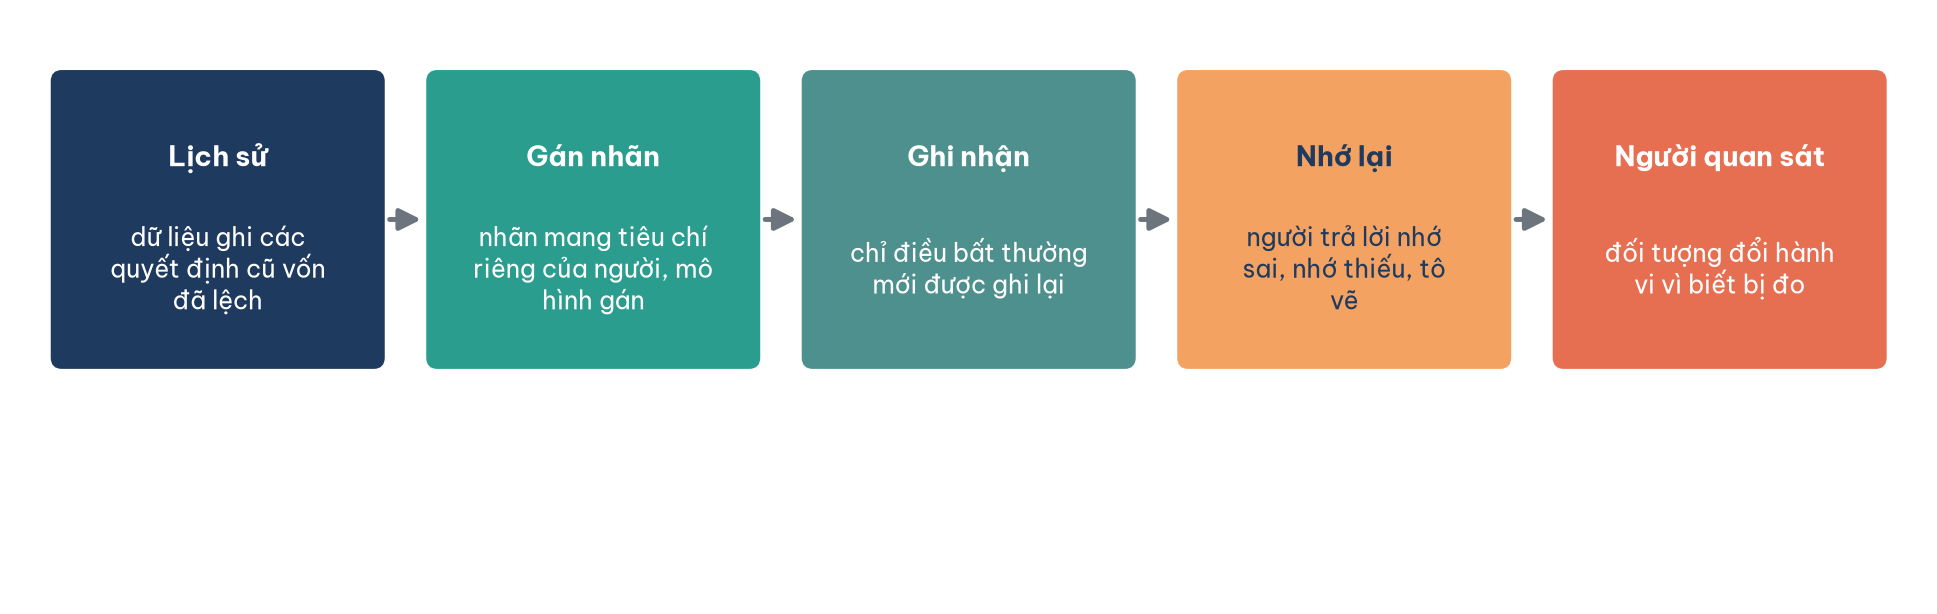
Hình 1. Năm nguồn thiên kiến trong cách dữ liệu được sinh ra.
Điểm chung của năm nguồn trong Hình 1 là không có bước làm sạch nào phát hiện được chúng; chúng chỉ lộ ra khi người phân tích hỏi về quá trình sinh ra dữ liệu. Bài Thiên kiến trong trí tuệ nhân tạo cho thấy khi những dữ liệu như vậy được dùng để huấn luyện mô hình AI, thiên kiến còn được khuếch đại.
2. Thiên kiến lịch sử
Dữ liệu nội bộ của doanh nghiệp phần lớn là bản ghi các quyết định trong quá khứ: ai được tuyển, khoản vay nào được duyệt, khách nào được chăm sóc, hàng nào được trưng bày ở vị trí đẹp. Thiên kiến lịch sử (historical bias) xảy ra khi dữ liệu ghi đúng một quá khứ vốn đã lệch, rồi được dùng để định hình tương lai. Nó đặc biệt khó nhận ra vì dữ liệu không sai: nó mô tả chính xác điều đã xảy ra. Công cụ tuyển dụng của Amazon ở đầu bài là ví dụ điển hình.
Bỏ cột nhạy cảm như giới tính ra khỏi dữ liệu thường không đủ, vì các cột khác, như khu vực sinh sống, trường đã học, thời gian gián đoạn công việc, có thể đứng thay cho nó. Câu tự kiểm ở bước thu thập là: dữ liệu này ghi lại thế giới, hay ghi lại các quyết định của chính ta về thế giới? Nếu là vế sau, mọi mô hình học từ nó sẽ học cả cách ta đã quyết định. Một ví dụ quen thuộc trong bán lẻ: dữ liệu bán hàng chỉ cho biết khách mua gì trong số những món được trưng bày; món không được trưng bày thì không bao giờ có cơ hội xuất hiện trong dữ liệu và mô hình gợi ý học từ đó sẽ tiếp tục không gợi ý chúng.
3. Thiên kiến gán nhãn
Nhiều bảng dữ liệu có một cột không do hệ thống ghi tự động mà do người, hoặc một mô hình, gán: phân loại khiếu nại, cờ gian lận, cảm xúc của một đánh giá, lý do nghỉ việc. Mục này mô tả thiên kiến sinh ra ở cột ấy và cách giữ nhãn đáng tin.
3.1. Nhãn mang tiêu chí của người gán
Thiên kiến gán nhãn (label bias) xảy ra khi nhãn mang tiêu chí riêng của người gán, không nhất quán giữa người này với người khác, hoặc lệch có hệ thống với một nhóm. Một nghiên cứu cho thấy các bộ dữ liệu dùng để huấn luyện công cụ phát hiện ngôn từ độc hại gán nhãn "độc hại" cho các câu viết bằng phương ngữ của người Mỹ gốc Phi nhiều hơn hẳn và mô hình học lại đúng độ lệch ấy (Sap và cộng sự, 2019). Trong doanh nghiệp, nhãn "khiếu nại nghiêm trọng" do từng tổng đài viên tự quyết, hay nhãn "gian lận" chỉ có ở những giao dịch đã từng bị điều tra, đều là những cột cần đọc với con mắt ấy. Nhãn "gian lận" là trường hợp tinh vi: giao dịch không bị điều tra thì không bao giờ có nhãn gian lận, nên dữ liệu đánh đồng "không bị phát hiện" với "không gian lận".
3.2. Ba thói quen giữ nhãn đáng tin
Có ba thói quen giúp giữ nhãn đáng tin. Một là viết hướng dẫn gán nhãn thành văn bản, có ví dụ cho các trường hợp ranh giới. Hai là cho hai người gán độc lập trên cùng một mẫu và đo mức đồng thuận vượt trên mức may rủi, thường bằng hệ số kappa (Cohen, 1960); kappa thấp nghĩa là hướng dẫn chưa đủ rõ hoặc khái niệm chưa được định nghĩa thống nhất. Ba là ghi trong từ điển dữ liệu ai, hay mô hình nào và phiên bản nào, đã gán nhãn. Nhãn do AI gán ngày càng phổ biến, chẳng hạn dùng AI phân loại cảm xúc của hàng nghìn bình luận và đòi hỏi đúng phép kiểm ấy: đối chiếu với một mẫu do người gán tay. Bài Đọc ma trận nhầm lẫn cho nhà quản lý giới thiệu công cụ để đo độ khớp giữa nhãn của máy và nhãn của người.
4. Thiên kiến ghi nhận
Thiên kiến ghi nhận (reporting bias) xảy ra khi chỉ những điều bất thường, nổi bật hay đáng kể mới được ghi lại, còn điều bình thường thì không. Hệ thống quản lý sự cố chỉ có dòng khi máy hỏng; nhật ký chăm sóc khách hàng chỉ có dòng khi khách gọi đến; báo chí chỉ viết về chuyến bay khi có tai nạn.
Đánh giá sản phẩm trực tuyến là ví dụ rõ nhất. Người rất hài lòng và người rất bực bội viết đánh giá nhiều hơn hẳn người thấy bình thường, nên phân phối số sao thường có hình chữ J: dồn ở năm sao, một ít ở một sao, thưa ở giữa. Điểm trung bình của các đánh giá vì thế không phải mức hài lòng của khách hàng nói chung (Hu và cộng sự, 2009). Hình 2 minh họa khác biệt giữa hai phân phối.
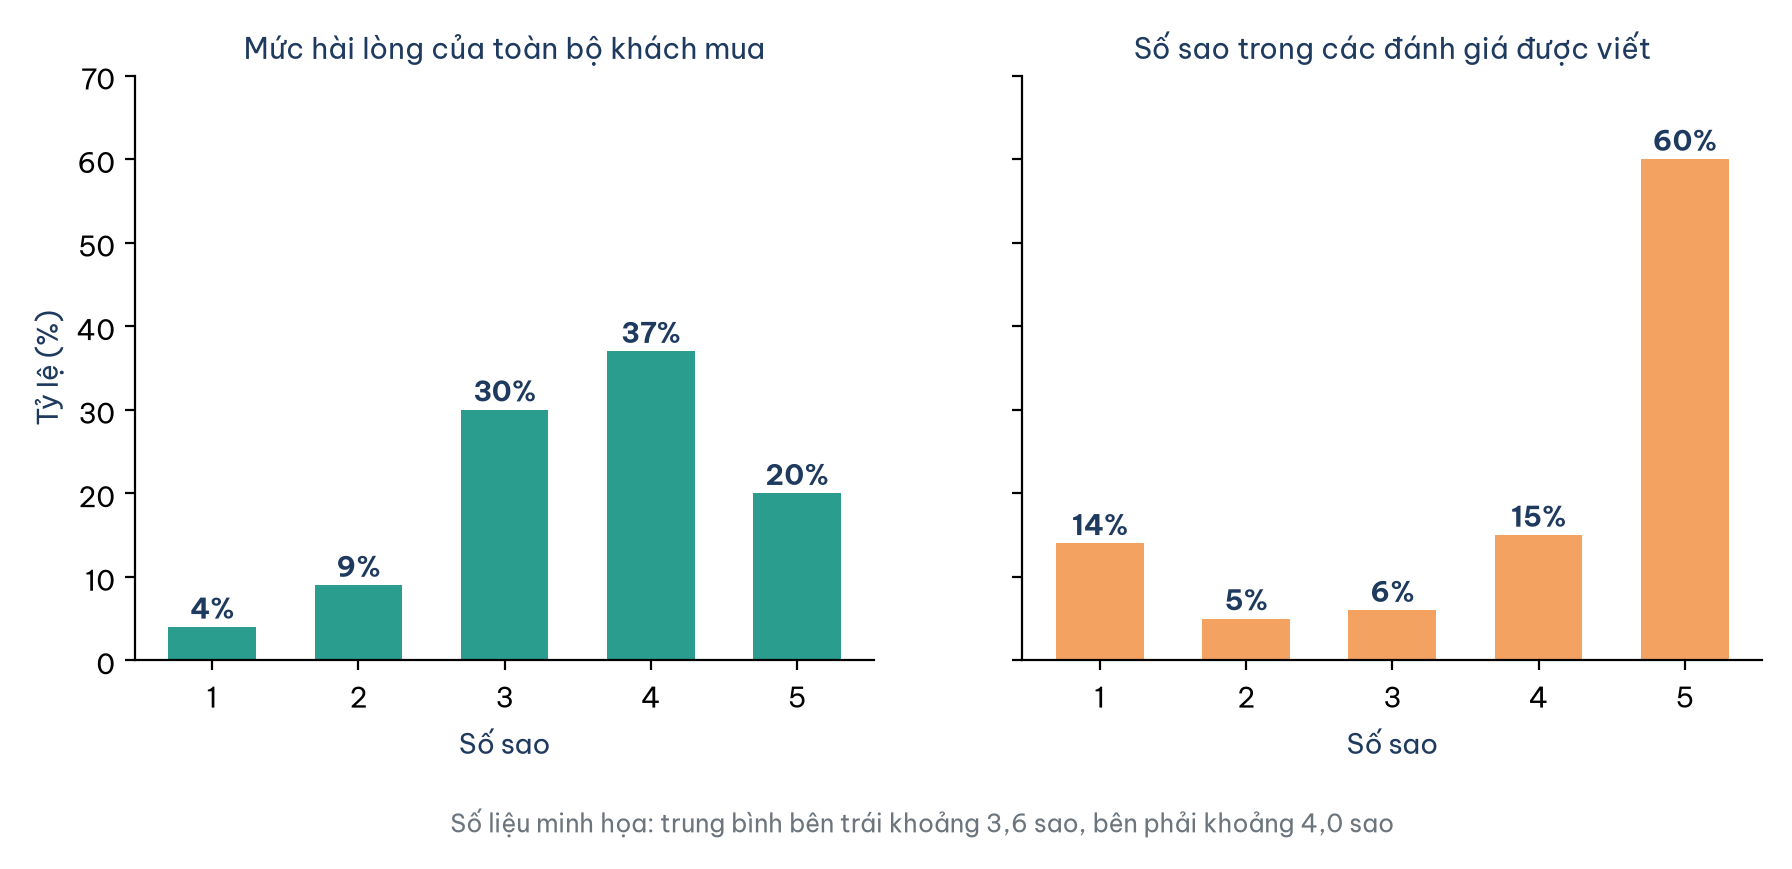
Hình 2. Mức hài lòng của toàn bộ khách và số sao trong các đánh giá được viết (số liệu minh họa). Nguồn: dựa trên Hu và cộng sự (2009).
Hình 2 cho thấy hai cách đọc rất khác nhau về cùng một sản phẩm: đánh giá trực tuyến cho trung bình khoảng 4,0 sao và gợi ý khách gần như ai cũng rất hài lòng, trong khi phần lớn khách thật ra chỉ thấy tạm được. Thiên kiến này đặc biệt mạnh với dữ liệu văn bản và với AI tạo sinh, vốn học từ chính những gì con người chọn viết ra. Cách chống là đặt dữ liệu "được kể lại" cạnh dữ liệu hành vi, như tỷ lệ mua lại hay tỷ lệ trả hàng và luôn hỏi: điều gì xảy ra hằng ngày mà không ai ghi lại? Bài Phân nhóm khách hàng theo RFM là một ví dụ dùng dữ liệu hành vi thay cho lời kể.
5. Khi dữ liệu đến từ con người
Hai thiên kiến cuối sinh ra khi dữ liệu đến từ con người: một do trí nhớ, một do việc biết mình đang bị đo. Mục này trình bày lần lượt.
5.1. Thiên kiến nhớ lại
Thiên kiến nhớ lại (recall bias) xảy ra khi người trả lời nhớ sai, nhớ thiếu hay tô vẽ lại chuyện đã qua. Một khảo sát hỏi "trong sáu tháng qua anh/chị mua cà phê mang đi bao nhiêu lần" sẽ nhận về con số mà người trả lời ước đoán, thường bị kéo về phía những lần gần đây hoặc đáng nhớ. Trí nhớ còn bị chính câu hỏi định hình: trong một thí nghiệm kinh điển, người xem cùng một đoạn phim tai nạn ước lượng tốc độ xe cao hơn khi câu hỏi dùng động từ "đâm sầm" thay vì "va chạm" (Loftus & Palmer, 1974). Khi có thể, hãy dùng dữ liệu giao dịch thay cho dữ liệu hồi tưởng; khi buộc phải hỏi, hãy hỏi khung thời gian ngắn và cụ thể, như "tuần vừa rồi" thay cho "sáu tháng qua".
5.2. Hiệu ứng người quan sát
Hiệu ứng người quan sát (Hawthorne effect) xảy ra khi đối tượng thay đổi hành vi vì biết mình đang bị đo. Nhân viên biết đang bị bấm giờ thao tác sẽ làm nhanh hơn nhịp thường; cửa hàng biết sắp có kiểm tra sẽ trưng bày đẹp hơn mọi ngày. Tên gọi đến từ các thí nghiệm ở nhà máy Hawthorne thập niên 1920–1930, dù phân tích lại dữ liệu gốc cho thấy hiệu ứng ở đó yếu hơn nhiều so với câu chuyện thường được kể (Levitt & List, 2011). Bài học vẫn đứng vững cho người thu thập dữ liệu: một định mức đo trong tuần có người đứng xem cần được kiểm lại bằng dữ liệu do hệ thống tự ghi, hoặc ít nhất bằng một phép thử độ nhạy, chẳng hạn tính lại kết quả với định mức thấp hơn và cao hơn 10%.
6. Bảng tự kiểm và từ điển dữ liệu
Năm nguồn thiên kiến có thể gom lại thành một bảng tự kiểm dùng ở bước thu thập dữ liệu, như Bảng 1.
Bảng 1. Năm nguồn thiên kiến và câu hỏi tự kiểm
| Thiên kiến | Dữ liệu dễ mắc | Câu hỏi tự kiểm |
|---|---|---|
| Lịch sử | Dữ liệu ghi quyết định cũ: tuyển dụng, tín dụng, khuyến mãi, chăm sóc khách | Dữ liệu ghi lại thế giới hay ghi lại quyết định của chính ta? |
| Gán nhãn | Cột phân loại do người hay mô hình gán: khiếu nại, gian lận, cảm xúc | Ai gán, theo hướng dẫn nào, hai người gán có khớp nhau không? |
| Ghi nhận | Đánh giá trực tuyến, nhật ký sự cố, cuộc gọi tổng đài, văn bản | Điều gì xảy ra hằng ngày mà không ai ghi lại? |
| Nhớ lại | Khảo sát hỏi về hành vi trong quá khứ | Có bản ghi giao dịch thay được câu hỏi hồi tưởng không? |
| Người quan sát | Định mức đo bằng bấm giờ, kiểm tra báo trước, thử nghiệm mà đối tượng biết | Đối tượng có biết mình đang bị đo và hành vi lúc không bị đo ra sao? |
Bảng 1 dẫn tới một thói quen đơn giản: từ điển dữ liệu của một tổ chức nên có thêm một dòng mô tả dữ liệu được tạo ra thế nào, tức bởi hệ thống nào, ai nhập, vào lúc nào và những trường hợp nào không bao giờ có mặt. Dòng ấy tốn vài phút để viết nhưng giúp người phân tích sau này không phải đoán. Bài Quy trình phát triển hệ thống cơ sở dữ liệu bàn cách xây từ điển dữ liệu trong một dự án cơ sở dữ liệu.
Kết luận
Năm nguồn thiên kiến trong bài, gồm lịch sử, gán nhãn, ghi nhận, nhớ lại và người quan sát, có chung một đặc điểm: chúng không phải lỗi trong bảng dữ liệu mà là lỗi trong cách bảng dữ liệu được sinh ra. Vì thế không bước làm sạch nào phát hiện được chúng và một bảng dữ liệu đúng kiểu, không trùng, không thiếu vẫn có thể dẫn đến kết luận lệch.
Cách phòng không nằm ở công cụ mà ở thói quen đặt câu hỏi về nguồn gốc dữ liệu: ai hoặc cái gì tạo ra nó, nhằm mục đích gì và điều gì không bao giờ được ghi vào. Đặt dữ liệu được kể lại cạnh dữ liệu hành vi, đo độ khớp của nhãn, hỏi khung thời gian ngắn, kiểm lại định mức bằng dữ liệu tự ghi và ghi lại cách dữ liệu được tạo ra trong từ điển dữ liệu là những việc nhỏ giúp người phân tích nhìn ra thế giới thật phía sau những con số.
Đọc thêm
- Mô hình SOAR trong phân tích kinh doanh
- Đặt đúng câu hỏi phân tích
- Thiên kiến trong trí tuệ nhân tạo
- Bài học thống kê từ một tấm meme
- Nghịch lý Simpson trong phân tích dữ liệu
- Dự đoán giới tính từ dữ liệu
Tài liệu tham khảo
Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
Dastin, J. (2018, October 10). Amazon scraps secret AI recruiting tool that showed bias against women. Reuters. https://www.reuters.com/article/us-amazon-com-jobs-automation-insight-idUSKCN1MK08G
Hu, N., Pavlou, P. A., & Zhang, J. (2009). Overcoming the J-shaped distribution of product reviews. Communications of the ACM, 52(10), 144–147. https://doi.org/10.1145/1562764.1562800
Levitt, S. D., & List, J. A. (2011). Was there really a Hawthorne effect at the Hawthorne plant? An analysis of the original illumination experiments. American Economic Journal: Applied Economics, 3(1), 224–238. https://doi.org/10.1257/app.3.1.224
Loftus, E. F., & Palmer, J. C. (1974). Reconstruction of automobile destruction: An example of the interaction between language and memory. Journal of Verbal Learning and Verbal Behavior, 13(5), 585–589. https://doi.org/10.1016/S0022-5371(74)80011-3
Sap, M., Card, D., Gabriel, S., Choi, Y., & Smith, N. A. (2019). The risk of racial bias in hate speech detection. In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 1668–1678). Association for Computational Linguistics. https://doi.org/10.18653/v1/P19-1163