
ETL LÀ GÌ
Trích xuất, biến đổi và nạp dữ liệu vào kho sao cho chạy lại bao nhiêu lần thì con số vẫn đúng
Sáng thứ Năm đầu năm mới, bảng điều khiển của giám đốc chuỗi siêu thị Sen Vàng Mart báo doanh thu ngày 1/1 là 149,4 triệu đồng, gấp đôi con số thật. Không có thông báo lỗi nào. Đêm trước, người kỹ sư dữ liệu viết vài câu lệnh để đưa tuần bán hàng mới vào kho dữ liệu; lần chạy đầu bị ngắt giữa chừng vì mất mạng, anh chạy lại từ đầu. Câu lệnh nào cũng đúng; chỉ là phần đã chạy xong ở lần đầu được chèn thêm một lần nữa.
Câu chuyện này là chuyện thường ngày của mọi kho dữ liệu. Phần khó nhất của một dự án kho dữ liệu hiếm khi là thiết kế lược đồ hay vẽ biểu đồ, mà là quy trình đưa dữ liệu từ các hệ thống nguồn vào kho mỗi ngày, gọi là ETL (extract, transform, load: trích xuất, biến đổi, nạp). Kimball và Caserta (2004) ước tính quy trình này thường chiếm phần lớn công sức và ngân sách của một dự án kho dữ liệu, vì nó phải hòa giải mọi khác biệt giữa các nguồn với kho. Một quy trình ETL tốt không chỉ chép dữ liệu; nó phải chạy lại được mà không làm sai số, biết được dòng nào ở nguồn đã bị sửa hay bị xóa, dọn dữ liệu bẩn mà không xóa dấu vết và tự từ chối khi số liệu trong kho không khớp với nguồn.
Bài viết đi theo trình tự sau. Mục 1 định nghĩa ba bước của ETL và so sánh với ELT. Mục 2 và mục 3 bàn về phần biến đổi: làm sạch và tích hợp. Mục 4 là trọng tâm của bài: nạp gia tăng và tính lũy đẳng, minh họa bằng một mô phỏng chạy thật trên dữ liệu của Sen Vàng Mart, một chuỗi siêu thị giả định có 939.668 dòng hàng bán trong hai năm. Mục 5 trình bày bộ kiểm thử sau mỗi lần nạp và mục 6 bàn về công cụ.
1. Ba bước của ETL và biến thể ELT
Mục này định nghĩa từng bước và chỉ ra vì sao thứ tự của chúng không cố định.
Trích xuất là lấy từ các nguồn những dữ liệu có ích cho phân tích: cơ sở dữ liệu bán hàng, phần mềm kế toán, tệp đăng ký từ ứng dụng di động, các tệp Excel do cửa hàng tự lập. Biến đổi là làm cho dữ liệu khớp với cấu trúc của kho và bảo đảm chất lượng: làm sạch, thống nhất mã, đổi đơn vị, tra khóa thay thế của các bảng chiều, gộp theo độ mịn của bảng sự kiện. Nạp là ghi dữ liệu đã biến đổi vào kho. Lần nạp đầu tiên dựng kho từ toàn bộ lịch sử; các lần sau, đưa thay đổi của nguồn vào kho theo chu kỳ, thường là mỗi đêm (Jukić, 2025).
Thứ tự ba bước không cố định. Trong ELT, dữ liệu được nạp gần như nguyên trạng vào một khu vực tạm (staging area) ngay trong hệ quản trị của kho, rồi mới được biến đổi bằng SQL ở đó. Bảng 1 so sánh hai cách.
Bảng 1. ETL và ELT
| Tiêu chí | ETL | ELT |
|---|---|---|
| Nơi biến đổi | Một máy chủ hoặc công cụ riêng, trước khi nạp | Trong hệ quản trị của kho, sau khi nạp vào khu vực tạm |
| Ngôn ngữ biến đổi | Công cụ ETL có giao diện kéo thả, Python, Java | Chủ yếu là SQL |
| Dữ liệu thô | Thường không giữ | Giữ ở khu vực tạm, biến đổi lại được khi đổi quy tắc |
| Phù hợp khi | Kho yếu, hoặc dữ liệu phải được làm sạch trước khi được phép lưu | Kho phân tích mạnh (kho đám mây, DuckDB); đội ngũ quen SQL |
Nguồn: dựa trên Jukić (2025), Kimball và Ross (2013).
ELT phổ biến dần cùng các kho đám mây, vì sức tính toán của kho đủ để biến đổi hàng trăm triệu dòng bằng SQL và giữ được dữ liệu thô giúp sửa quy tắc rồi chạy lại mà không phải trích xuất lại từ nguồn. Dù chọn cách nào, cấu trúc của một quy trình tốt đều giống nhau, như Hình 1.
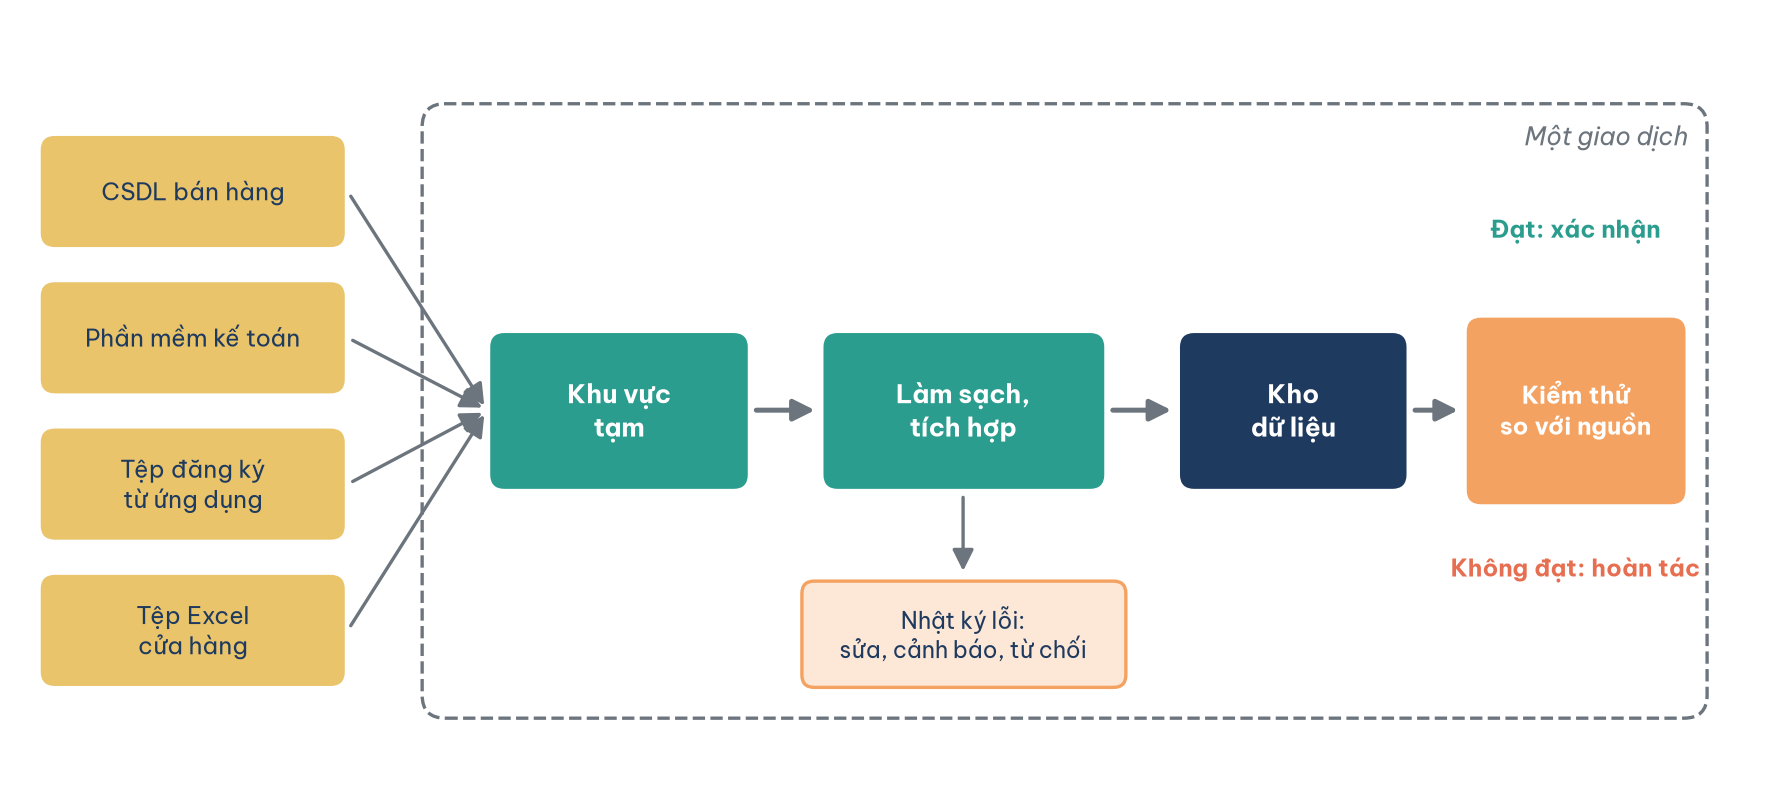
Hình 1. Một quy trình nạp có khu vực tạm, nhật ký lỗi và kiểm thử nằm trong cùng một giao dịch.
Ba chi tiết trong Hình 1 phân biệt một quy trình chuyên nghiệp với vài câu lệnh chép dữ liệu. Mọi quyết định làm sạch để lại dấu vết trong một bảng nhật ký lỗi. Bộ kiểm thử chạy trước khi xác nhận, không phải sau. Và cả quy trình nằm trong một giao dịch, nên kho không bao giờ ở trạng thái nửa đúng nửa sai: hoặc toàn bộ lần nạp có hiệu lực, hoặc kho giữ nguyên như trước. Cơ chế giao dịch được trình bày trong bài Giao dịch và bốn tính chất ACID.
2. Làm sạch: ba quyết định và một cuốn sổ
Làm sạch là phát hiện và xử lý dữ liệu sai, thiếu, không nhất quán trong lúc biến đổi. Mục này cho thấy làm sạch là chuỗi quyết định có thể giải trình chứ không phải thao tác kỹ thuật.
Với mỗi loại lỗi, quy trình cần một quyết định được viết thành văn bản và chỉ có ba quyết định hợp lý. Sửa khi giá trị đúng suy ra được chắc chắn từ chính dữ liệu, chẳng hạn "+84 912..." là "0912...", "gold" là hạng "Vàng". Cảnh báo khi lỗi không làm sai phân tích hoặc dữ liệu vẫn có giá trị dù không hoàn hảo: giữ dòng, ghi lại vấn đề. Từ chối khi không thể suy ra giá trị đúng mà không đoán: không nạp, ghi lại để bộ phận sở hữu dữ liệu xử lý. Bảng 2 đưa ví dụ cho mỗi quyết định từ các nguồn của một chuỗi bán lẻ.
Bảng 2. Ba quyết định làm sạch và ví dụ
| Quyết định | Khi nào | Ví dụ |
|---|---|---|
| Sửa | Giá trị đúng suy ra được chắc chắn | Số điện thoại có dấu cách hoặc +84; ngày sinh dạng dd/mm/yyyy; nước suối ghi theo thùng 24 chai, đổi sang chai theo cột đơn vị tính của chính tệp |
| Cảnh báo | Lỗi không làm sai phân tích, hoặc là sự thật kinh doanh | Email sai định dạng khi kho không dùng email; cửa hàng bán thấp hơn giá niêm yết vì chưa cập nhật bảng giá |
| Từ chối | Không suy ra được mà không đoán | Hạng thành viên "Thường" không có trong danh mục; tên sản phẩm khớp với hai mã khác nhau; ngày 31/06 |
Nguồn: dựa trên Jukić (2025).
Dòng giữa của Bảng 2 chứa một phân biệt tinh tế. Một cửa hàng bán nước suối 5.000 đồng suốt một tháng sau khi công ty đã tăng giá lên 6.000 đồng: đó không phải lỗi dữ liệu mà là sự thật kinh doanh, vì cửa hàng thật sự đã thu 5.000 đồng mỗi chai. "Sửa" nó thành 6.000 sẽ làm doanh thu trong kho cao hơn số tiền thật đã vào két. Quy trình đúng là giữ nguyên giá đã thu và cảnh báo, để người quản lý giá biết có một cửa hàng chưa cập nhật bảng giá.
Cả ba quyết định đều phải ghi một dòng vào bảng nhật ký lỗi của quy trình, kèm giá trị gốc. Cuốn sổ này trả lời câu hỏi mà mọi kho dữ liệu đều sẽ nhận: "vì sao con số trong kho khác con số trong tệp của tôi?" Cách làm sạch tệ nhất là thêm một điều kiện WHERE âm thầm loại các dòng trông có vấn đề. Báo cáo sau đó khớp với kho, kho trông gọn gàng, nhưng kho không còn khớp với thực tế và không ai biết đã mất bao nhiêu tiền. Quy tắc nên giữ: không dòng nào được rời khỏi quy trình mà không có một dòng nhật ký giải thích và tổng của kho cộng tổng phần bị từ chối phải bằng tổng của nguồn. Các chiều đo chất lượng dữ liệu dùng để phát hiện lỗi được trình bày trong bài Đo chất lượng dữ liệu theo sáu chiều.
3. Tích hợp: khi các nguồn nói ngôn ngữ khác nhau
Tích hợp khó hơn làm sạch vì các nguồn không chỉ bẩn mà còn dùng mã, tên và đơn vị khác nhau cho cùng một thứ. Mục này rút ra bốn nguyên tắc.
Tri thức tích hợp được ghi thành dữ liệu. "Cửa hàng Quận 1" trong tệp Excel cũ là cửa hàng CH12 sau khi phường được đổi tên; "MI-01" là mã tự đặt của cửa hàng đó cho một loại mì. Những ánh xạ này nên nằm trong một bảng ánh xạ, không chôn trong câu lệnh. Khi phát hiện thêm một mã lạ, người ta thêm một dòng dữ liệu chứ không sửa mã nguồn của quy trình.
Tên không phải là khóa. Khi mã sản phẩm trong tệp nguồn không khớp với tên, quy trình có thể tra theo tên, nhưng chỉ khi tên khớp đúng một sản phẩm. Nếu danh mục có hai sản phẩm cùng tên, tra theo tên là đoán và dòng đó phải bị từ chối để cửa hàng xác nhận. Đây là lý do lược đồ quan hệ đòi khóa chính là một mã, như bài Chuyển sơ đồ ER sang bảng giải thích.
Phân biệt lỗi với sự thật khó chịu. Như ví dụ giá nước suối ở mục 2, một giá trị bất thường chưa chắc là lỗi. Quy trình tích hợp nên giữ những gì đã thật sự xảy ra và đánh dấu những gì cần người xem lại.
Tôn trọng độ mịn. Tệp Excel của cửa hàng thường là tổng theo ngày và sản phẩm, không có từng hóa đơn. Đổ nó vào bảng sự kiện ở độ mịn dòng hàng là trộn hai độ mịn trong một bảng, một lỗi khiến mọi phép đếm số hóa đơn trở nên vô nghĩa. Dữ liệu ở độ mịn thô hơn cần một bảng sự kiện tổng hợp riêng; khái niệm độ mịn được trình bày trong bài Lược đồ hình sao, bảng sự kiện và bảng chiều.
Đối chiếu khớp cũng chưa có nghĩa là dữ liệu dùng được. Sau khi tích hợp, số liệu phải được so với hiểu biết về nghiệp vụ, một phép kiểm tra tính hợp lý (sanity check). Nếu mười mặt hàng chủ lực của một chuỗi đang tăng trưởng bỗng giảm 80% so với hai năm trước, nhiều khả năng hai nguồn đang định nghĩa "số lượng" theo hai cách khác nhau, chẳng hạn số bán lẻ và số xuất từ kho ra quầy. Không quy trình ETL nào tự trả lời được câu hỏi đó; nó chỉ có thể làm cho chênh lệch hiện ra.
4. Nạp gia tăng và tính lũy đẳng
Kho không thể được dựng lại từ đầu mỗi đêm khi nguồn có hàng chục triệu dòng; quy trình phải chỉ lấy phần thay đổi. Đây là nơi phát sinh phần lớn sự cố số liệu của một kho đang vận hành. Mục này so sánh các cách nạp gia tăng bằng một mô phỏng chạy thật.
4.1. Bốn cách xác định phần thay đổi
Có bốn cách xác định dữ liệu nào cần nạp. Toàn bộ là đọc lại cả nguồn và so với kho: đơn giản, chắc chắn đúng, nhưng tốn kém khi nguồn lớn. Theo mốc (watermark) là ghi lại thời điểm của bản ghi mới nhất đã nạp, lần sau chỉ lấy bản ghi muộn hơn mốc: rẻ, nhưng chỉ đúng nếu nguồn chỉ thêm, không sửa, không xóa. Cửa sổ trượt là xóa rồi nạp lại toàn bộ một khoảng thời gian gần nhất, chẳng hạn 35 ngày. Bắt thay đổi (change data capture, CDC) là đọc nhật ký giao dịch của hệ quản trị nguồn để biết chính xác dòng nào được thêm, sửa, xóa: chính xác nhất, nhưng cần quyền và công cụ ở phía nguồn (Kleppmann, 2017).
4.2. Một tuần dữ liệu và ba cách nạp
Để so sánh, có thể dựng một bản chép của cơ sở dữ liệu bán hàng Sen Vàng Mart, nạp toàn bộ 939.668 dòng hàng của năm 2024 và 2025 vào một bảng sự kiện, rồi mô phỏng đúng những gì một hệ thống bán hàng thật gặp trong tuần đầu năm mới: 3.890 hóa đơn mới với 9.137 dòng hàng trị giá 543,9 triệu đồng; ba hóa đơn cũ của tháng 12 bị sửa vì khách trả lại một món (tổng 66.000 đồng); hai hóa đơn cũ bị hủy (112.500 đồng). Ba cách nạp được thử, mỗi cách chạy hai lần liên tiếp để mô phỏng việc chạy lại sau sự cố. Bảng 3 tóm tắt kết quả.
Bảng 3. Ba cách nạp gia tăng một tuần dữ liệu, mỗi cách chạy hai lần (mô phỏng trên SQLite)
| Cách nạp | Dòng nguồn đọc mỗi lần | Doanh thu ngày 1/1 trong kho sau lần hai | Số dòng kho so với nguồn | Tháng bị lệch so với nguồn |
|---|---|---|---|---|
| Chèn dòng mới, không xóa trước | 9.137 | 149.382.000 đồng (gấp đôi) | Thừa 9.139 dòng | Tháng 12/2025 lệch 178.500 đồng; tháng 1/2026 lệch 543.942.500 đồng |
| Theo mốc, xóa phần sau mốc rồi nạp lại | 9.137 | 74.691.000 đồng (đúng) | Thừa 2 dòng | Tháng 12/2025 lệch 178.500 đồng |
| Cửa sổ trượt 35 ngày, xóa rồi nạp lại | 45.470 | 74.691.000 đồng (đúng) | Khớp | Không tháng nào lệch |
Nguồn: mô phỏng trên bản chép dữ liệu Sen Vàng Mart, SQLite. Các cách nạp chạy trong giao dịch, mỗi lần dưới một giây.
Hình 2 đặt cạnh nhau phần lệch của ba cách sau lần chạy thứ hai.
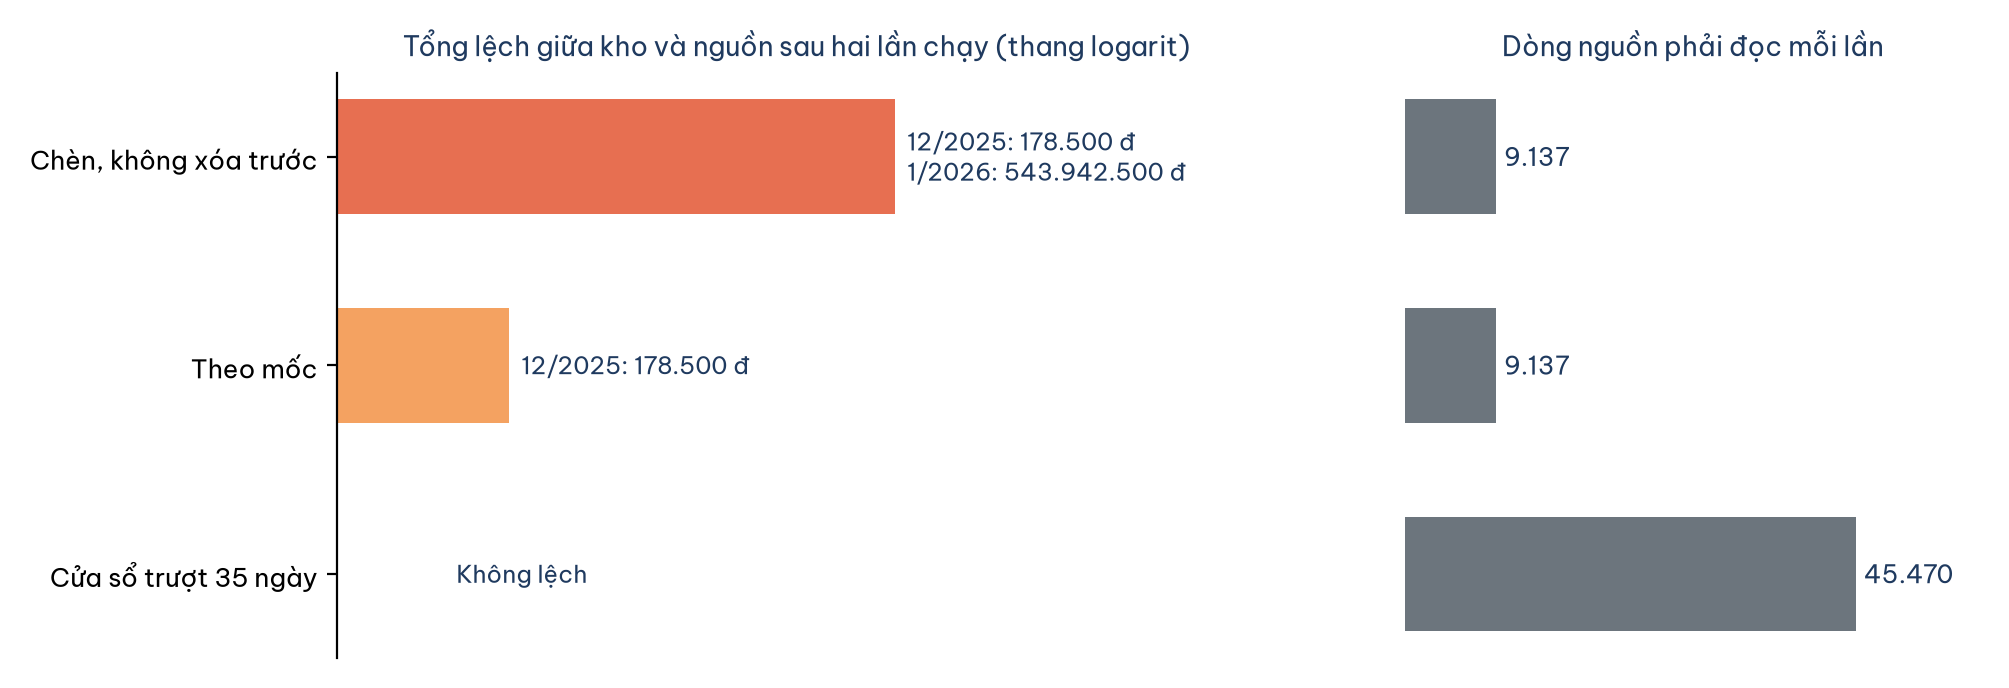
Hình 2. Phần lệch giữa kho và nguồn sau hai lần chạy, theo ba cách nạp gia tăng.
Cách thứ nhất trong Hình 2 lặp lại đúng câu chuyện ở đầu bài: lần chạy thứ hai chèn thêm 9.137 dòng một lần nữa và doanh thu ngày 1/1 nhân đôi. Thuộc tính mà cách này thiếu gọi là lũy đẳng (idempotent): chạy một lần hay nhiều lần cho cùng một kết quả. Một quy trình nạp phải lũy đẳng, vì trong vận hành thật nó sẽ bị chạy lại, do mất mạng, do lỗi giữa chừng, do người vận hành không chắc lần trước đã xong chưa. Cách làm cho một bước nạp lũy đẳng rất đơn giản: xác định khoảng dữ liệu sẽ nạp, xóa mọi dòng của khoảng đó trong kho, rồi nạp lại từ nguồn, tất cả trong một giao dịch.
Cách thứ hai đã lũy đẳng: chạy lại không làm sai thêm. Nhưng nó vẫn để lại một chênh lệch 178.500 đồng ở tháng 12, đúng bằng 66.000 đồng của ba hóa đơn bị sửa cộng 112.500 đồng của hai hóa đơn bị hủy và kho có thừa đúng hai dòng hàng của hai hóa đơn đã hủy. Các hóa đơn đó có thời điểm bán trước mốc, nên mốc không bao giờ nhìn thấy chúng. Đây là cạm bẫy cốt lõi của cách nạp theo mốc: mốc đo thời điểm sự kiện xảy ra, không đo thời điểm dữ liệu thay đổi. Nếu nguồn có cột "lần sửa cuối" được cập nhật mỗi khi dòng bị sửa, mốc theo cột đó sẽ bắt được hóa đơn bị sửa, nhưng vẫn không bắt được hóa đơn bị xóa, vì dòng đã xóa không còn cột nào để so.
Cách thứ ba đọc nhiều gấp khoảng năm lần (45.470 dòng thay vì 9.137) nhưng bắt được mọi thay đổi trong cửa sổ, kể cả dòng bị xóa và chạy lại lần hai vẫn cho đúng kết quả. Đánh đổi của nó cũng rõ: một hóa đơn bị sửa sau khi đã ra khỏi cửa sổ, chẳng hạn hóa đơn tháng trước bị điều chỉnh khi đối soát cuối quý, vẫn bị bỏ sót. Độ rộng cửa sổ vì thế là một quyết định nghiệp vụ: chính sách đổi trả cho phép sửa hóa đơn trong bao lâu, kế toán khóa sổ sau bao nhiêu ngày. Khi nguồn sửa dữ liệu cũ thường xuyên và không có giới hạn rõ, CDC là lựa chọn đáng đầu tư.
5. Kiểm thử sau mỗi lần nạp
Trong mô phỏng ở mục 4, cả ba sai sót đều bị phát hiện bởi ba phép kiểm tra đơn giản chạy ngay sau khi nạp. Mục này hệ thống hóa bộ kiểm thử đó.
Bảng 4 liệt kê sáu kiểm thử nên chạy sau mỗi lần nạp vào một bảng sự kiện bán hàng, cùng loại lỗi mà mỗi kiểm thử bắt được.
Bảng 4. Sáu kiểm thử sau mỗi lần nạp và loại lỗi mỗi kiểm thử bắt được
| Kiểm thử | Kiểm tra | Bắt được |
|---|---|---|
| KT1 | Số dòng trong bảng sự kiện bằng số dòng hàng ở nguồn | Nạp trùng; dòng đã xóa ở nguồn vẫn còn trong kho; dòng bị rơi khi tra khóa |
| KT2 | Doanh thu từng tháng khớp nguồn đến từng đồng | Dòng bị sửa ở nguồn; các lỗi bù trừ nhau trên tổng cả kỳ |
| KT3 | Không có dòng sự kiện trỏ tới dòng chiều không tồn tại | Lỗi tra khóa thay thế |
| KT4 | Không trùng theo khóa logic của độ mịn (hóa đơn, sản phẩm) | Nạp hai lần một khoảng |
| KT5 | Mỗi khách hàng chỉ có một phiên bản hiện hành, các phiên bản không chồng lấn | Lỗi đóng, mở phiên bản của chiều thay đổi chậm |
| KT6 | Giá trị nằm trong miền cho phép | Lỗi biến đổi: số lượng âm, giờ bán ngoài giờ mở cửa |
Nguồn: dựa trên Jukić (2025), Kimball và Caserta (2004).
Ba nguyên tắc rút ra từ Bảng 4. Thứ nhất, kiểm thử phải so kho với nguồn. So hai bảng trong cùng kho với nhau, chẳng hạn bảng sự kiện chi tiết với bảng tổng hợp sinh ra từ chính nó, thì luôn khớp, vì cả hai cùng sai theo một cách. Thứ hai, so theo từng tháng chứ không chỉ cả kỳ. Chẳng hạn, nếu có một hóa đơn bị nạp trùng và một hóa đơn khác bị sửa giảm cùng số tiền, tổng cả năm vẫn khớp trong khi hai tháng đều sai. Thứ ba, kiểm thử là một phần của quy trình nạp, chạy bên trong giao dịch: không đạt thì hoàn tác. Nếu kiểm thử được đặt trong giao dịch như vậy, lần nạp theo mốc ở Bảng 3 sẽ bị KT2 chặn lại vì tháng 12 lệch 178.500 đồng và được hoàn tác toàn bộ; kho giữ nguyên như trước thay vì lặng lẽ sai. Một kiểm thử chạy riêng sau khi đã xác nhận chỉ có thể báo rằng kho đã sai, khi báo cáo có thể đã đến tay giám đốc.
6. Công cụ và cách tổ chức
Mọi nguyên tắc trong bài đều có thể làm bằng SQL và một tệp lệnh chạy theo lịch. Mục này điểm qua các nhóm công cụ thường gặp và tiêu chí chọn.
Với doanh nghiệp nhỏ, Power Query trong Excel và Power BI đã là một công cụ ETL đủ dùng: nó trích xuất từ nhiều nguồn, ghi lại từng bước biến đổi và chạy lại được khi có dữ liệu mới. Khi số nguồn và số bảng tăng, các đội dữ liệu thường tách quy trình thành hai lớp: một lớp điều phối lo lịch chạy, thứ tự các bước, chạy lại khi lỗi và gửi cảnh báo và một lớp biến đổi viết bằng SQL, được quản lý phiên bản như mã nguồn và có kiểm thử đi kèm. Các dịch vụ đám mây của những nhà cung cấp lớn gộp cả hai lớp vào một giao diện, đổi lại là phụ thuộc vào nền tảng. Bảng 5 gợi ý cách chọn theo quy mô.
Bảng 5. Chọn cách tổ chức ETL theo quy mô
| Quy mô | Cách tổ chức phù hợp | Rủi ro cần để ý |
|---|---|---|
| Vài nguồn, vài nghìn đến vài trăm nghìn dòng | Power Query; tệp SQL chạy theo lịch | Quy trình nằm trong tệp của một người; không có kiểm thử |
| Hàng chục nguồn, hàng triệu dòng mỗi ngày | Công cụ điều phối kết hợp lớp biến đổi bằng SQL có quản lý phiên bản | Chi phí học và vận hành; cần người phụ trách rõ ràng |
| Dữ liệu thời gian thực, nguồn sửa dữ liệu cũ thường xuyên | Bắt thay đổi từ nhật ký nguồn đổ vào kho đám mây | Phụ thuộc quyền truy cập nguồn và nhà cung cấp |
Công cụ chỉ là cái vỏ. Một quy trình ETL viết bằng công cụ đắt tiền nhưng không lũy đẳng, không có nhật ký lỗi và không kiểm thử vẫn sẽ có ngày làm doanh thu nhân đôi. Ngược lại, vài tệp SQL được viết theo đúng các nguyên tắc trong bài có thể phục vụ một chuỗi bán lẻ cỡ vừa trong nhiều năm.
Kết luận
ETL thường bị xem là phần "ống nước" của kho dữ liệu: cần có, nhưng không ai muốn bàn. Thực tế ngược lại: độ tin cậy của mọi con số trên bảng điều khiển phụ thuộc vào việc quy trình nạp có chạy lại được không, có bắt được dòng bị sửa và bị xóa không và có tự chặn mình khi số liệu không khớp không. Mô phỏng một tuần dữ liệu ở Sen Vàng Mart cho thấy ba cách nạp đều "chạy được" nhưng chỉ một cách cho kết quả đúng và khác biệt không nằm ở công cụ mà ở vài quyết định thiết kế: xóa trước khi nạp, chọn khoảng nạp theo cách dữ liệu thay đổi chứ không theo cách dữ liệu được tạo ra và đặt kiểm thử bên trong giao dịch.
Phần biến đổi cũng vậy. Làm sạch tốt không phải là làm cho dữ liệu trông gọn, mà là làm cho mọi chênh lệch giữa kho và nguồn giải thích được bằng một dòng trong nhật ký. Một kho dữ liệu đáng tin không phải là kho không bao giờ có lỗi, mà là kho mà khi có người hỏi "vì sao con số này khác", luôn có câu trả lời.
Đọc thêm
- Kho dữ liệu là gì và khi nào doanh nghiệp cần nó
- Lược đồ hình sao, bảng sự kiện và bảng chiều
- Đo chất lượng dữ liệu theo sáu chiều
- Giao dịch và bốn tính chất ACID
- Ba cách hiểu đúng về trí tuệ kinh doanh
Tài liệu tham khảo
Jukić, N. (2025). Database systems: Introduction to databases and data warehouses (3rd ed.). Prospect Press. https://www.prospectpressvt.com/textbooks/jukic-database-systems-introduction-to-databases-and-data-warehouses-3-0
Kimball, R., & Caserta, J. (2004). The data warehouse ETL toolkit: Practical techniques for extracting, cleaning, conforming, and delivering data. Wiley. https://www.wiley.com/en-us/The+Data+Warehouse+ETL+Toolkit%3A+Practical+Techniques+for+Extracting%2C+Cleaning%2C+Conforming%2C+and+Delivering+Data-p-9780764567575
Kimball, R., & Ross, M. (2013). The data warehouse toolkit: The definitive guide to dimensional modeling (3rd ed.). Wiley. https://www.wiley.com/en-us/The+Data+Warehouse+Toolkit:+The+Definitive+Guide+to+Dimensional+Modeling,+3rd+Edition-p-9781118530801
Kleppmann, M. (2017). Designing data-intensive applications. O'Reilly Media. https://www.oreilly.com/library/view/designing-data-intensive-applications/9781491903063/