
PLSPREDICT VÀ NĂNG LỰC DỰ ĐOÁN TRONG SMARTPLS
Vì sao bỏ Q² của blindfolding, cách chạy PLSpredict, đọc Q²predict, RMSE so với LM và kiểm định CVPAT trong SmartPLS
Bài nên đọc trước
Bài đánh giá mô hình cấu trúc trong SmartPLS cho thấy mô hình sàn X giải thích 31,8% phương sai của ý định mua lại (R² = 0,318). R² là năng lực giải thích trong mẫu: mô hình được ước lượng và đánh giá trên cùng một bộ dữ liệu. Câu hỏi của bài này khác: nếu đưa mô hình vào những người chưa tham gia ước lượng, nó dự đoán câu trả lời của họ tốt đến đâu? Đây là bước 5 trong quy trình đánh giá mô hình cấu trúc của Hair và cộng sự (2019): năng lực dự đoán ngoài mẫu.
Bài này dùng hai công cụ có sẵn trong SmartPLS 4:
- PLSpredict (Shmueli và cộng sự, 2016, 2019): tính Q²predict và sai số dự đoán RMSE, MAE cho từng câu hỏi.
- CVPAT (Liengaard và cộng sự, 2021; Sharma và cộng sự, 2023): kiểm định xem sai số dự đoán của PLS-SEM có thấp hơn có ý nghĩa thống kê so với mô hình chuẩn hay không.
Về hình minh họa và con số. Ảnh chụp thật SmartPLS 4.1.2.1 (Ringle và cộng sự, 2026; bản dùng thử 30 ngày) cho mô hình
mo-hinh-san-xcủa bài nhập dữ liệu và vẽ mô hình trong SmartPLS, Casewise deletion, 254 người. Giấy phép Student không có PLSpredict và CVPAT. Con số trong bài lấy từ báo cáo của SmartPLS. Bài có đối chiếu bằng R (fileplspredict.R, gói cSEM) ở mục 6.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
38-plspredict-cvpat-nang-luc-du-doancủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Vì sao không dùng Q² của blindfolding?
Trước đây, năng lực dự đoán thường được đánh giá bằng Q² của Stone–Geisser (Geisser, 1974; Stone, 1974), tính bằng thủ tục blindfolding: lần lượt che một phần điểm dữ liệu, ước lượng lại rồi dự đoán phần bị che. Shmueli và cộng sự (2016) chỉ ra rằng Q² này vẫn dùng thông tin của chính các quan sát được dự đoán khi ước lượng mô hình, nên nó gần với năng lực giải thích trong mẫu hơn là dự đoán ngoài mẫu. Vì vậy, Hair và cộng sự (2019, 2022) khuyến nghị dùng PLSpredict cho bước 5.
Nếu nghiên cứu trước hoặc giảng viên yêu cầu Q² của blindfolding, có thể báo cáo thêm, nhưng nên ghi rõ đó là Q² của blindfolding và không thay thế được PLSpredict.
2. PLSpredict hoạt động thế nào?
PLSpredict dùng kiểm định chéo k nhóm (k-fold cross-validation):
- Chia ngẫu nhiên 254 người thành 10 nhóm, mỗi nhóm khoảng 25 người.
- Ước lượng mô hình trên 9 nhóm (mẫu huấn luyện, khoảng 229 người).
- Dự đoán câu trả lời của nhóm còn lại (mẫu kiểm tra) từ các biến ngoại sinh của mô hình.
- Lặp lại bước 2 và 3 cho đến khi mỗi nhóm đều được làm mẫu kiểm tra một lần.
- Lặp lại toàn bộ quá trình 10 lần với cách chia nhóm khác nhau, rồi lấy trung bình.
Kết quả là sai số dự đoán ngoài mẫu cho từng câu hỏi của các biến nội sinh (biến được dự đoán: Giá trị, Hài lòng, Ý định). Câu hỏi của Xác nhận và Niềm tin không xuất hiện trong kết quả, vì đây là biến ngoại sinh dùng để dự đoán.
Sai số của PLS-SEM được so với hai mô hình chuẩn:
- IA (indicator average): dự đoán mọi người bằng trung bình của câu hỏi trong mẫu huấn luyện. Đây là cách dự đoán đơn giản nhất. Q²predict = 1 − (tổng bình phương sai số của PLS-SEM) / (tổng bình phương sai số của IA). Q²predict lớn hơn 0 nghĩa là PLS-SEM dự đoán tốt hơn trung bình.
- LM (linear model): hồi quy tuyến tính mỗi câu hỏi của biến nội sinh trên tất cả câu hỏi của các biến ngoại sinh, không qua cấu trúc mô hình. Đây là chuẩn khó hơn: PLS-SEM cần dự đoán ít nhất ngang LM thì cấu trúc lý thuyết mới có giá trị dự đoán.
Hai thước đo sai số:
- RMSE (căn bậc hai của trung bình bình phương sai số): phạt nặng các sai số lớn. Dùng mặc định.
- MAE (trung bình giá trị tuyệt đối của sai số): dùng khi phân phối sai số dự đoán lệch mạnh (Shmueli và cộng sự, 2019). Xem phân phối này ở mục Histograms > PLS-SEM MV error histogram của báo cáo.
3. Chạy PLSpredict trong SmartPLS 4
Bước 1. Mở mô hình mo-hinh-san-x trong project San X. Chọn menu Calculate > PLSpredict / CVPAT.
Bước 2. Trong thẻ PLSpredict / CVPAT của hộp thoại, kiểm tra bốn thiết lập (Hình 1):
- Number of folds: 10 (số nhóm).
- No. of repetitions: 10 (số lần lặp).
- Prediction type: Early antecedents, tức dự đoán từ các biến ngoại sinh đầu tiên của chuỗi đường dẫn.
- Random number generator: Fixed seed, để chạy lại cho cùng kết quả. Chọn Random seed thì mỗi lần chạy, các con số dao động nhẹ.
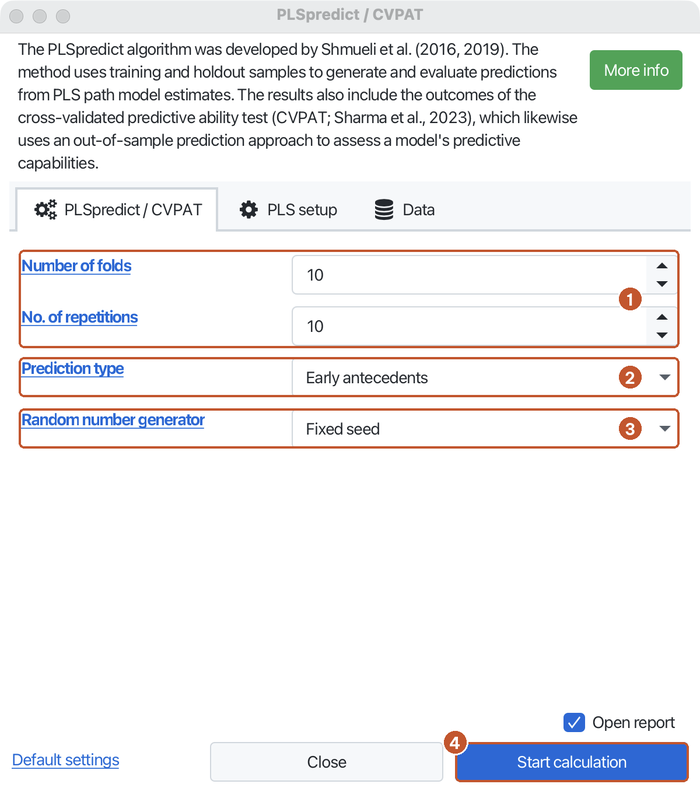
Hình 1. Thẻ PLSpredict / CVPAT: (1) số nhóm và số lần lặp, (2) kiểu dự đoán, (3) cách tạo số ngẫu nhiên, (4) nút Start calculation.
Bước 3. Mở thẻ Data, chọn Missing value algorithm là Casewise deletion như các bài trước (Hình 2).
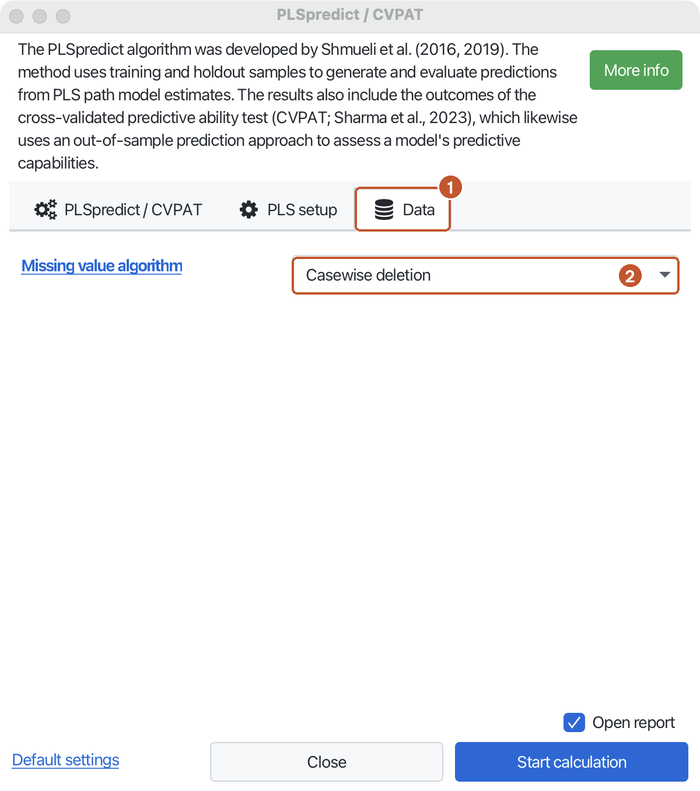
Hình 2. Thẻ Data: (1) thẻ Data, (2) cách xử lý ô thiếu Casewise deletion.
Bước 4. Bấm Start calculation. Với 10 nhóm và 10 lần lặp, SmartPLS ước lượng mô hình 100 lần nên cần vài giây.
Cỡ mẫu khi chia nhóm. Mỗi mẫu huấn luyện chỉ có khoảng 90% số người. Với mẫu nhỏ, nên giảm số nhóm (ví dụ 5) để mẫu huấn luyện không quá nhỏ (Shmueli và cộng sự, 2019). Với 254 người, 10 nhóm là phù hợp.
4. Đọc kết quả PLSpredict
Báo cáo PLSpredict có hai nhóm bảng: kết quả theo từng câu hỏi (MV) và theo từng biến tiềm ẩn (LV).
Q²predict và RMSE của từng câu hỏi
Bước 5. Trong báo cáo, mở Final results > PLSpredict MV summary > Overview (Hình 3).
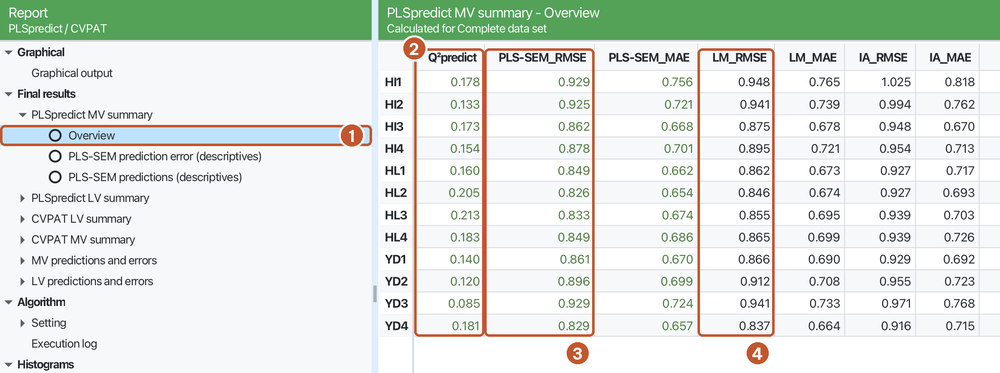
Hình 3. Kết quả PLSpredict cho 12 câu hỏi: (1) mục Overview, (2) Q²predict, (3) RMSE của PLS-SEM, (4) RMSE của LM.
Shmueli và cộng sự (2019) đề xuất đọc theo hai bước:
- Kiểm tra Q²predict. Nếu Q²predict của câu hỏi lớn hơn 0, PLS-SEM dự đoán tốt hơn IA. Nếu Q²predict nhỏ hơn hoặc bằng 0, mô hình không có năng lực dự đoán với câu hỏi đó và dừng ở đây.
- So sánh RMSE của PLS-SEM với LM cho các câu hỏi của biến nội sinh chính (ở đây xét cả 12 câu):
- Tất cả câu có RMSE của PLS-SEM thấp hơn LM: năng lực dự đoán cao.
- Đa số câu thấp hơn: năng lực dự đoán vừa.
- Thiểu số câu thấp hơn: năng lực dự đoán thấp.
- Không câu nào thấp hơn: mô hình không có năng lực dự đoán.
Bước 1 cho mô hình sàn X: Q²predict của 12 câu hỏi nằm trong khoảng 0,085 (YD3) đến 0,213 (HL3), đều lớn hơn 0 (Hình 4).
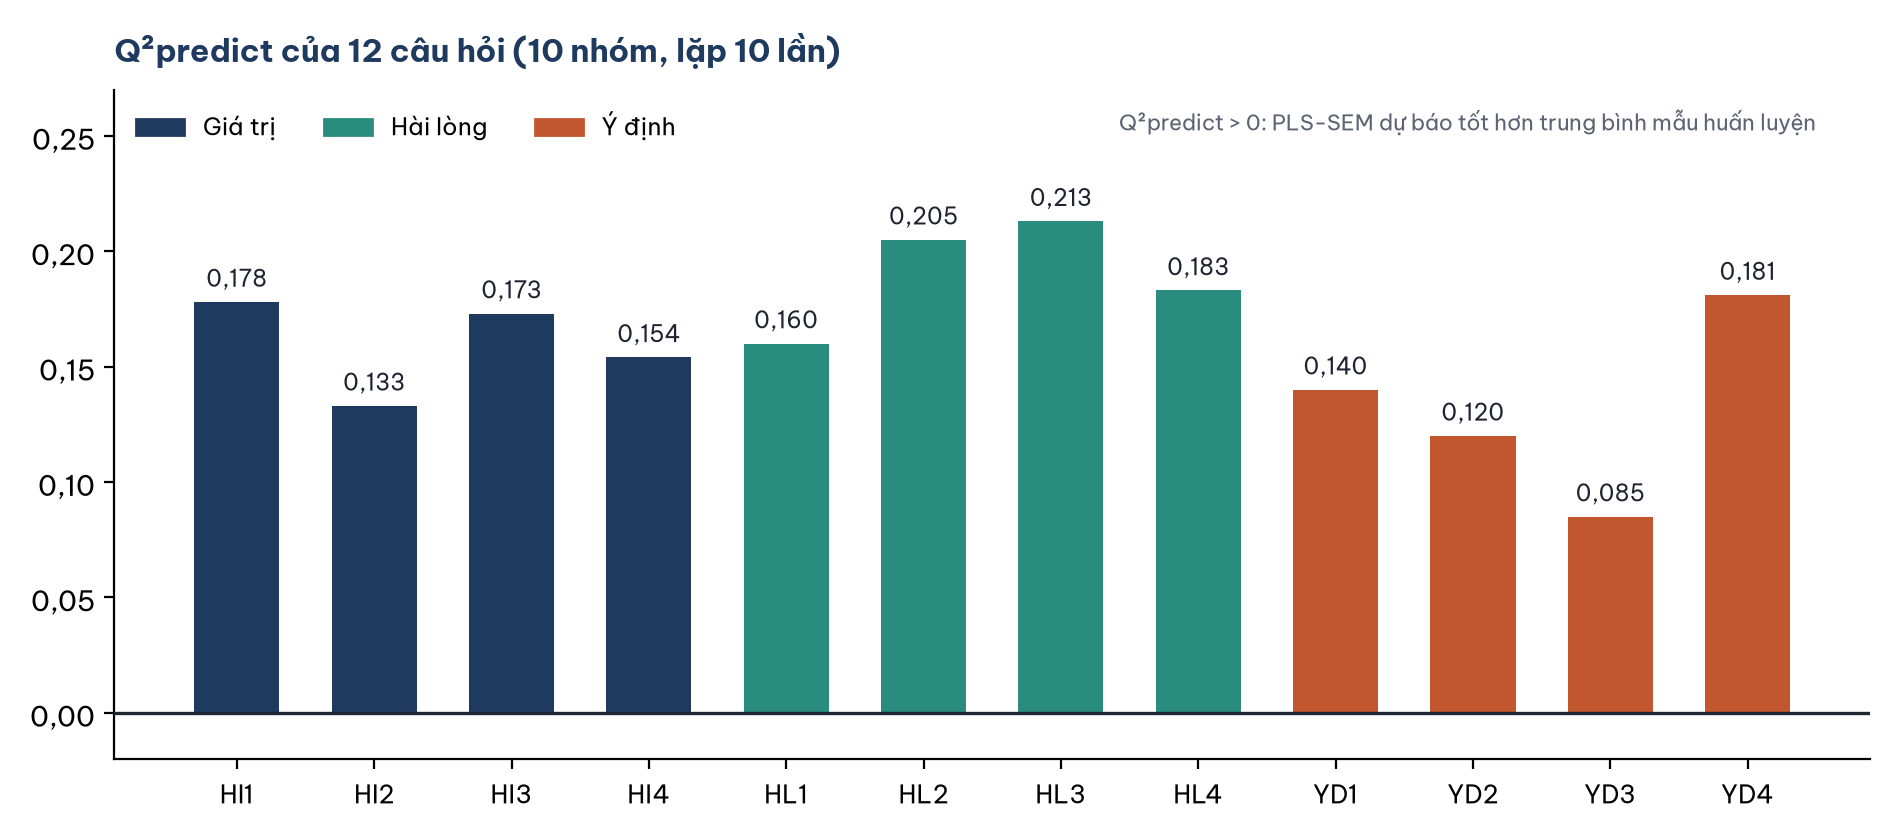
Hình 4. Q²predict của 12 câu hỏi thuộc ba biến nội sinh, số liệu của SmartPLS (Hình 3).
Bước 2: RMSE của PLS-SEM thấp hơn LM ở cả 12 câu hỏi (Hình 5). MAE cũng thấp hơn LM ở cả 12 câu (cột PLS-SEM_MAE và LM_MAE trong Hình 3), nên dùng RMSE hay MAE đều cho cùng kết luận (Bảng 1).
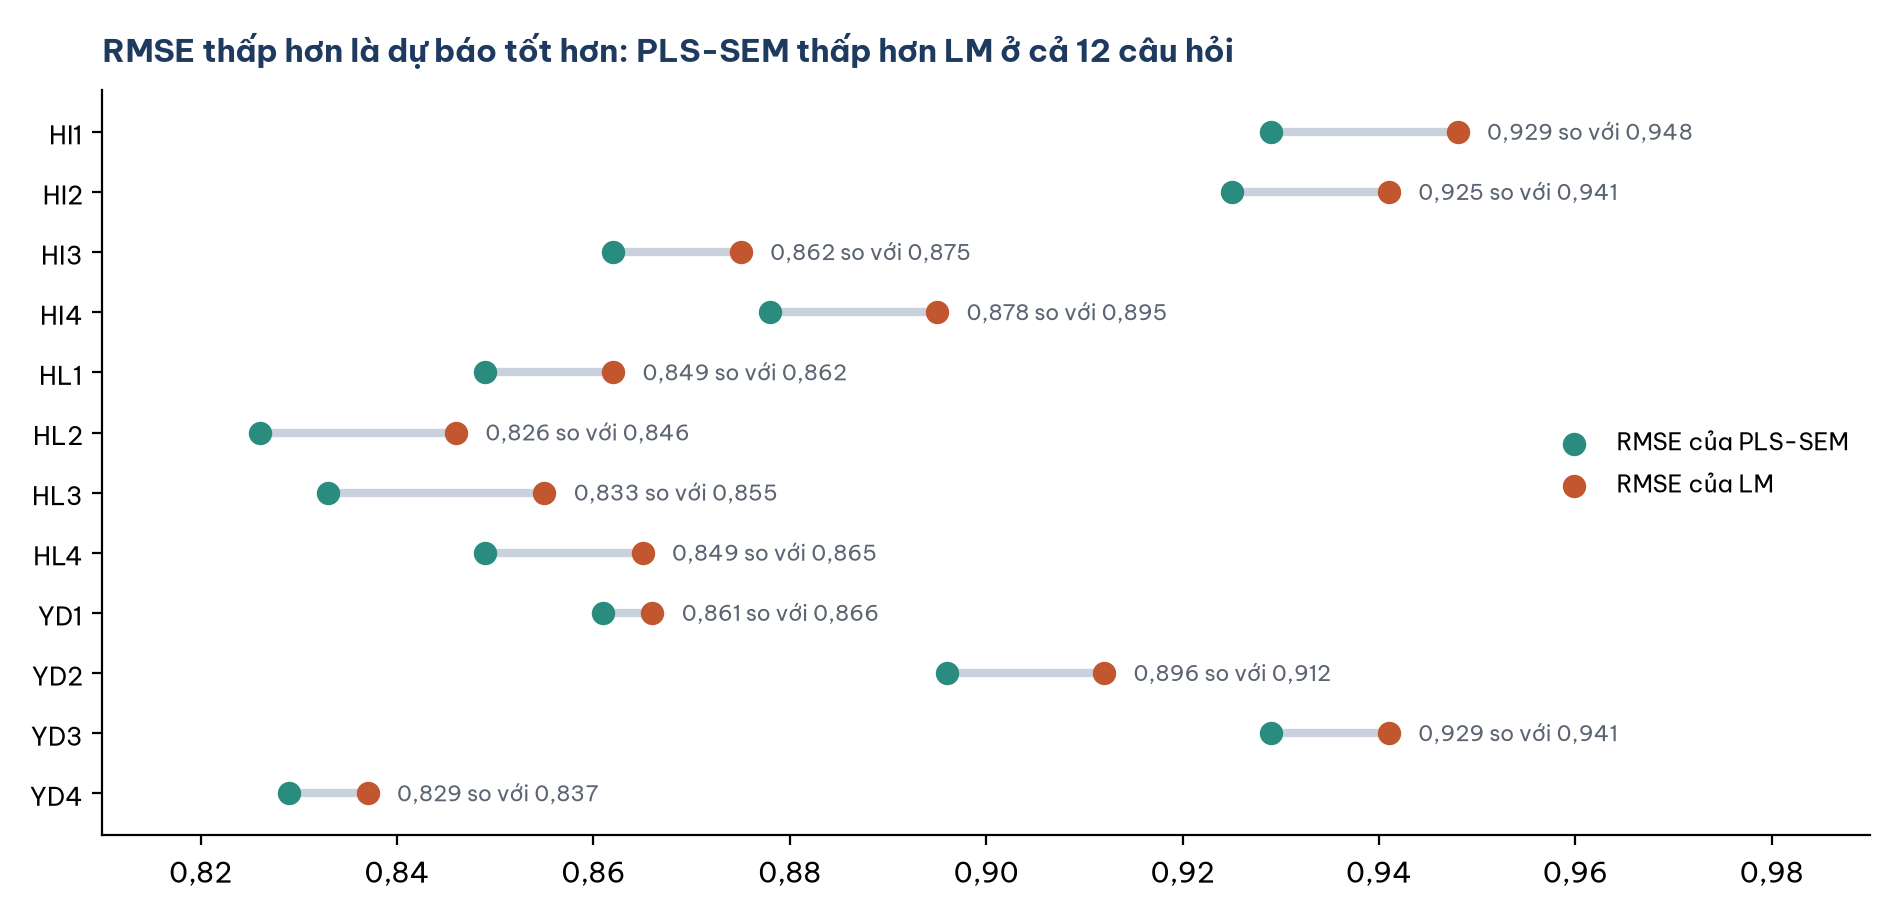
Hình 5. RMSE của PLS-SEM (xanh lục) và LM (cam) cho từng câu hỏi. Đoạn nối càng dài thì PLS-SEM càng hơn LM.
Bảng 1. Q²predict và RMSE của 12 câu hỏi.
| Câu hỏi | Q²predict | RMSE PLS-SEM | RMSE LM | Chênh lệch |
|---|---|---|---|---|
| HI1 | 0,178 | 0,929 | 0,948 | −0,019 |
| HI2 | 0,133 | 0,925 | 0,941 | −0,016 |
| HI3 | 0,173 | 0,862 | 0,875 | −0,013 |
| HI4 | 0,154 | 0,878 | 0,895 | −0,017 |
| HL1 | 0,160 | 0,849 | 0,862 | −0,013 |
| HL2 | 0,205 | 0,826 | 0,846 | −0,020 |
| HL3 | 0,213 | 0,833 | 0,855 | −0,022 |
| HL4 | 0,183 | 0,849 | 0,865 | −0,016 |
| YD1 | 0,140 | 0,861 | 0,866 | −0,005 |
| YD2 | 0,120 | 0,896 | 0,912 | −0,016 |
| YD3 | 0,085 | 0,929 | 0,941 | −0,012 |
| YD4 | 0,181 | 0,829 | 0,837 | −0,008 |
Kết luận theo Shmueli và cộng sự (2019): mô hình sàn X có năng lực dự đoán ngoài mẫu cao. Tuy vậy, cần đọc thêm hai điểm:
- Chênh lệch RMSE rất nhỏ, từ 0,005 (YD1) đến 0,022 (HL3). PLS-SEM hơn LM ở mọi câu, nhưng không hơn nhiều.
- Q²predict ở mức thấp đến vừa. Q²predict 0,085 của YD3 nghĩa là so với dự đoán bằng trung bình, sai số bình phương chỉ giảm khoảng 8,5%. Ý định mua lại vẫn khó dự đoán từ Xác nhận và Niềm tin, đúng với R² ở mức yếu đến vừa của bài đánh giá mô hình cấu trúc trong SmartPLS.
Q²predict của biến tiềm ẩn
Bước 6. Mở PLSpredict LV summary > PLS-SEM (Hình 6, Bảng 2).
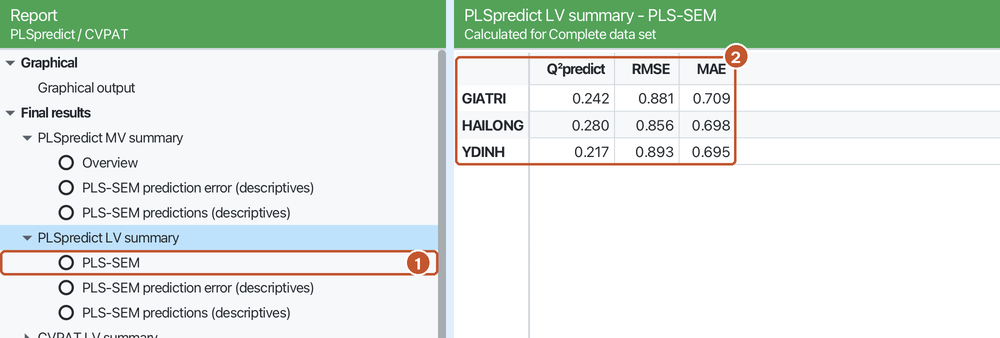
Hình 6. Q²predict, RMSE và MAE của ba biến tiềm ẩn nội sinh: (1) mục PLS-SEM, (2) bảng kết quả.
Bảng 2. Q²predict của ba biến tiềm ẩn nội sinh.
| Biến tiềm ẩn | Q²predict | RMSE | MAE | R² |
|---|---|---|---|---|
| Giá trị | 0,242 | 0,881 | 0,709 | 0,251 |
| Hài lòng | 0,280 | 0,856 | 0,698 | 0,399 |
| Ý định | 0,217 | 0,893 | 0,695 | 0,318 |
Q²predict của biến tiềm ẩn thấp hơn R², rõ nhất ở Hài lòng (0,280 so với 0,399) và Ý định (0,217 so với 0,318). Có hai lý do: Q²predict tính trên người ngoài mẫu ước lượng và với Early antecedents, mỗi biến chỉ được dự đoán từ biến ngoại sinh (Xác nhận; thêm Niềm tin với Ý định), không dùng điểm thật của Giá trị và Hài lòng làm biến dự đoán. Mức giảm này là bình thường, không phải lỗi.
Shmueli và cộng sự (2019) khuyến nghị đánh giá năng lực dự đoán dựa trên câu hỏi (bảng MV), vì người dùng mô hình dự đoán câu trả lời thật, không phải điểm biến tiềm ẩn. Bảng LV dùng để tham khảo.
5. Kiểm định CVPAT
PLSpredict cho biết PLS-SEM có sai số thấp hơn hay không, nhưng không cho biết chênh lệch đó có ý nghĩa thống kê hay chỉ do ngẫu nhiên. CVPAT (cross-validated predictive ability test) trả lời câu hỏi này (Liengaard và cộng sự, 2021). Với mỗi biến nội sinh, CVPAT tính mức mất mát trung bình (average loss, là bình phương sai số dự đoán trung bình) của PLS-SEM và của mô hình chuẩn, rồi kiểm định t cho chênh lệch. Chênh lệch âm và có ý nghĩa nghĩa là PLS-SEM dự đoán tốt hơn mô hình chuẩn (Sharma và cộng sự, 2023).
So với trung bình (IA)
Bước 7. Mở CVPAT LV summary > PLS-SEM vs. Indicator average (IA) (Hình 7).
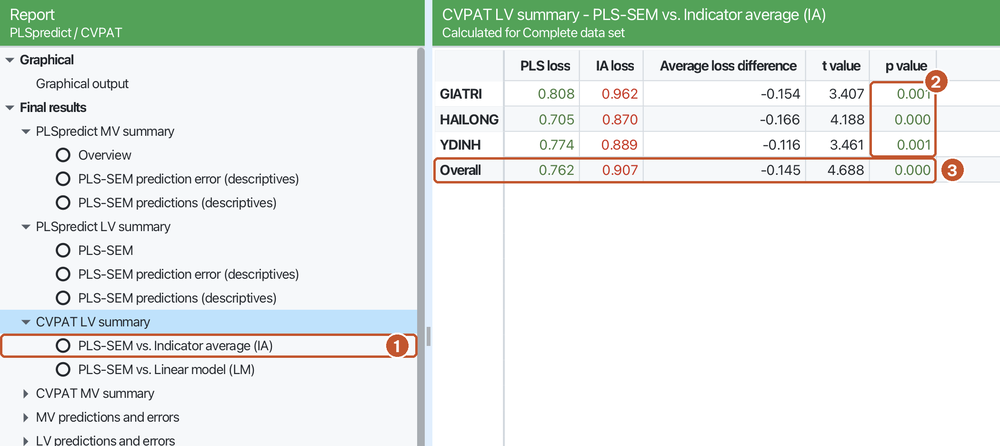
Hình 7. CVPAT so với IA: (1) mục PLS-SEM vs. Indicator average (IA), (2) giá trị p của ba biến, (3) dòng Overall của toàn mô hình.
Chênh lệch mất mát âm ở cả ba biến (−0,116 đến −0,166), với p từ 0,000 đến 0,001. Toàn mô hình: mất mát của PLS-SEM 0,762, của IA 0,907, chênh lệch −0,145, t = 4,688, p < 0,001. PLS-SEM dự đoán tốt hơn trung bình có ý nghĩa thống kê, khớp với Q²predict lớn hơn 0 ở mục 4.
So với mô hình tuyến tính (LM)
Bước 8. Mở CVPAT LV summary > PLS-SEM vs. Linear model (LM) (Hình 8, Bảng 3).
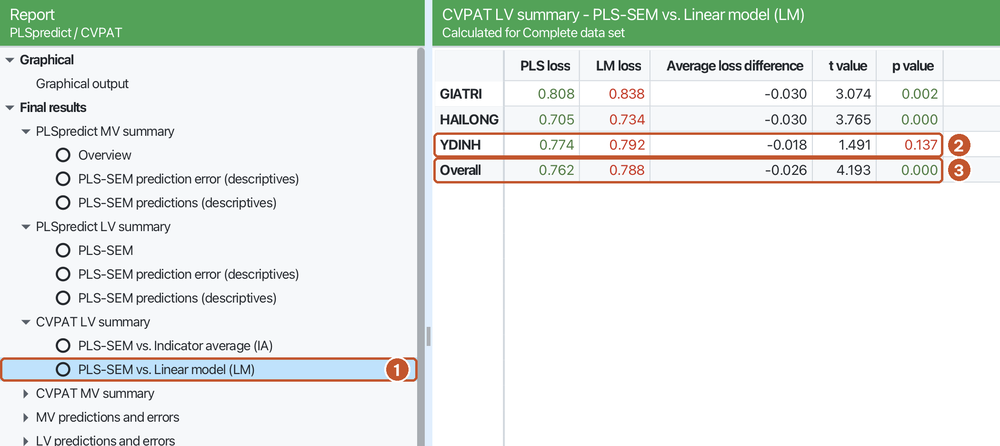
Hình 8. CVPAT so với LM: (1) mục PLS-SEM vs. Linear model (LM), (2) dòng YDINH, giá trị p 0,137 nên SmartPLS tô đỏ, (3) dòng Overall.
Bảng 3. CVPAT so với mô hình tuyến tính.
| Biến | Mất mát PLS-SEM | Mất mát LM | Chênh lệch | t | p |
|---|---|---|---|---|---|
| Giá trị | 0,808 | 0,838 | −0,030 | 3,074 | 0,002 |
| Hài lòng | 0,705 | 0,734 | −0,030 | 3,765 | < 0,001 |
| Ý định | 0,774 | 0,792 | −0,018 | 1,491 | 0,137 |
| Toàn mô hình | 0,762 | 0,788 | −0,026 | 4,193 | < 0,001 |
Đọc kết quả:
- Toàn mô hình: PLS-SEM dự đoán tốt hơn LM có ý nghĩa thống kê (t = 4,193, p < 0,001).
- Giá trị và Hài lòng: PLS-SEM tốt hơn LM có ý nghĩa (p = 0,002 và p < 0,001).
- Ý định mua lại: mất mát của PLS-SEM thấp hơn LM (0,774 so với 0,792), nhưng chênh lệch không có ý nghĩa thống kê (t = 1,491, p = 0,137). Giá trị p này là của kiểm định hai phía; nếu tính một phía thì p khoảng 0,069, vẫn lớn hơn 0,05.
Kết quả này bổ sung, không mâu thuẫn với PLSpredict. PLSpredict cho thấy RMSE của PLS-SEM thấp hơn LM ở cả bốn câu YD1 đến YD4; CVPAT cho thấy với biến Ý định, mức hơn này nhỏ đến mức chưa loại trừ được khả năng do ngẫu nhiên. Cần báo cáo đúng như vậy: với biến quan trọng nhất của mô hình, cấu trúc lý thuyết chưa dự đoán tốt hơn rõ rệt so với hồi quy tuyến tính trực tiếp trên các câu hỏi.
6. Đối chiếu bằng R
File plspredict.R chạy cùng mô hình bằng hàm predict() của gói cSEM: 10 nhóm, 10 lần lặp, LM làm chuẩn, PLS-SEM thông thường (không hiệu chỉnh PLSc), 254 người. Vì cách chia nhóm ngẫu nhiên khác SmartPLS, kết quả chỉ trùng gần đúng:
- Q²predict khớp đến chữ số thứ hai, ví dụ HI1 0,177 (R) so với 0,178 (SmartPLS), YD3 0,085 so với 0,085, HL3 0,211 so với 0,213.
- RMSE của PLS-SEM gần như trùng, ví dụ HI1 0,929 so với 0,929.
- RMSE của LM trong cSEM lớn hơn SmartPLS (ví dụ HI1 0,986 so với 0,948), nên chênh lệch giữa PLS-SEM và LM trong cSEM lớn hơn. Chúng tôi chưa xác định được khác biệt này nằm ở cách thiết lập nào của hai phần mềm. Dù vậy, kết luận không đổi: RMSE của PLS-SEM thấp hơn LM ở cả 12 câu.
Bài viết dùng số liệu của SmartPLS. Nếu dùng phần mềm khác, cần ghi rõ phần mềm, số nhóm, số lần lặp và cách tạo số ngẫu nhiên.
7. Trình bày kết quả
Năng lực dự đoán ngoài mẫu được đánh giá bằng PLSpredict (Shmueli và cộng sự, 2019) với 10 nhóm và 10 lần lặp. Q²predict của 12 câu hỏi thuộc ba biến nội sinh đều lớn hơn 0 (0,085 đến 0,213) và RMSE của PLS-SEM thấp hơn mô hình tuyến tính ở cả 12 câu hỏi, cho thấy mô hình có năng lực dự đoán cao theo tiêu chí của Shmueli và cộng sự (2019). Tuy vậy, chênh lệch RMSE nhỏ (0,005 đến 0,022). Kiểm định CVPAT (Sharma và cộng sự, 2023) cho thấy PLS-SEM dự đoán tốt hơn trung bình (chênh lệch mất mát −0,145, t = 4,688, p < 0,001) và tốt hơn mô hình tuyến tính (−0,026, t = 4,193, p < 0,001) ở cấp toàn mô hình. Riêng với ý định mua lại, PLS-SEM không dự đoán tốt hơn mô hình tuyến tính có ý nghĩa thống kê (t = 1,491, p = 0,137).
Trong bảng của luận văn, nên trình bày Q²predict, RMSE (hoặc MAE) của PLS-SEM và của LM cho từng câu hỏi như bảng ở mục 4, kèm bảng CVPAT và ghi chú số nhóm, số lần lặp, kiểu dự đoán.
Năm lỗi thường gặp
Các lỗi dưới đây thường gặp trong luận văn khi làm bước này.
- Báo cáo Q² của blindfolding như bằng chứng dự đoán ngoài mẫu. Q² này gần với năng lực giải thích trong mẫu (Shmueli và cộng sự, 2016).
- Chỉ báo cáo Q²predict lớn hơn 0 rồi kết luận "dự đoán tốt". Q²predict lớn hơn 0 chỉ là điều kiện tối thiểu; cần so với LM.
- So sánh RMSE của PLS-SEM với RMSE của IA. Chuẩn so sánh ở bước 2 là LM. IA đã được dùng trong Q²predict.
- Bỏ qua kết quả không có ý nghĩa của CVPAT. Kết quả của Ý định trong bài này cần được báo cáo và bàn luận, không chỉ nêu dòng Overall.
- Không ghi thiết lập. Kết quả dao động theo cách chia nhóm; thiếu số nhóm, số lần lặp và seed thì người đọc không kiểm tra lại được.
Tài liệu tham khảo
Geisser, S. (1974). A predictive approach to the random effect model. Biometrika, 61(1), 101–107. https://doi.org/10.1093/biomet/61.1.101
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/EBR-11-2018-0203
Liengaard, B. D., Sharma, P. N., Hult, G. T. M., Jensen, M. B., Sarstedt, M., Hair, J. F., & Ringle, C. M. (2021). Prediction: Coveted, yet forsaken? Introducing a cross-validated predictive ability test in partial least squares path modeling. Decision Sciences, 52(2), 362–392. https://doi.org/10.1111/deci.12445
Ringle, C. M., Wende, S., & Becker, J.-M. (2026). SmartPLS 4 (Version 4.1.2.1) [Computer software]. SmartPLS GmbH. https://www.smartpls.com
Sharma, P. N., Liengaard, B. D., Hair, J. F., Sarstedt, M., & Ringle, C. M. (2023). Predictive model assessment and selection in composite-based modeling using PLS-SEM: Extensions and guidelines for using CVPAT. European Journal of Marketing, 57(6), 1662–1677. https://doi.org/10.1108/EJM-08-2020-0636
Shmueli, G., Ray, S., Velasquez Estrada, J. M., & Chatla, S. B. (2016). The elephant in the room: Predictive performance of PLS models. Journal of Business Research, 69(10), 4552–4564. https://doi.org/10.1016/j.jbusres.2016.03.049
Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/EJM-02-2019-0189
Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–147. https://doi.org/10.1111/j.2517-6161.1974.tb00994.x