
ANOVA MỘT CHIỀU VÀ KIỂM ĐỊNH SAU TRONG SPSS/PSPP
So sánh trung bình nhiều nhóm, kiểm tra phương sai bằng nhau, chọn kiểm định post-hoc và báo cáo cỡ hiệu ứng
Bài nên đọc trước
Bài T-test so sánh trung bình giữa hai nhóm bằng kiểm định T. Khi biến nhóm có ba nhóm trở lên (bốn mức thu nhập, bốn nhóm nghề nghiệp, năm vùng miền), công cụ phù hợp là phân tích phương sai một chiều (one-way ANOVA). ANOVA trả lời câu hỏi: có ít nhất một nhóm có trung bình khác các nhóm còn lại không? Nếu có, kiểm định sâu (post-hoc) cho biết cụ thể nhóm nào khác nhóm nào.
Bài viết dùng bộ dữ liệu mẫu (du_lieu_phan_tich.sav) để trả lời câu hỏi: ý định mua lại trên sàn X có khác nhau theo thu nhập hằng tháng không? Mọi kết quả lấy từ file cú pháp anova.sps đi kèm, chạy bằng PSPP (Free Software Foundation, 2023) và được đối chiếu bằng Python (kiem_tra_python.py). Kết quả lần này nằm sát ngưỡng ý nghĩa: một số kiểm định cho p nhỏ hơn 0,05, một kiểm định cho p đúng bằng 0,050. Bài giữ nguyên các con số và dùng chúng để hướng dẫn cách diễn giải thận trọng.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
18-anova-mot-chieu-post-hoccủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Vì sao không chạy nhiều kiểm định T?
Bốn nhóm thu nhập tạo ra 6 cặp so sánh. Nếu chạy 6 kiểm định T riêng lẻ, mỗi kiểm định có 5% khả năng kết luận sai rằng có khác biệt (sai lầm loại I). Xác suất có ít nhất một kết luận sai trong 6 kiểm định là 1 − 0,95 lũy thừa 6 = 26,5% (Field, 2024) (Hình 1).
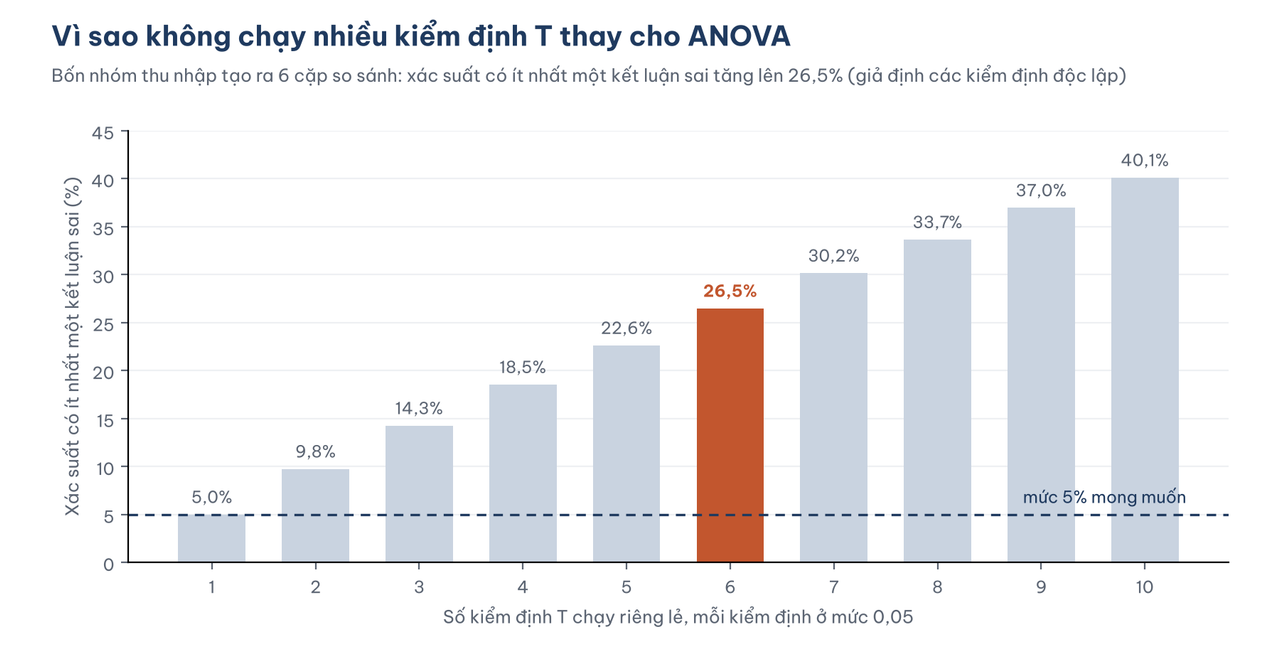
Hình 1. Xác suất có ít nhất một kết luận sai tăng nhanh theo số kiểm định chạy riêng lẻ.
ANOVA giải quyết vấn đề này bằng một kiểm định F duy nhất cho toàn bộ các nhóm. Sau đó, các kiểm định post-hoc so sánh từng cặp nhưng có điều chỉnh để giữ tổng sai lầm loại I ở mức 5%.
2. Giả định và kiểm tra trước khi chạy
ANOVA một chiều có cùng các giả định với kiểm định T hai mẫu độc lập (bài T-test):
- Kiểm tra biến phụ thuộc là định lượng. YD là điểm trung bình của bốn câu Likert, được xem là biến định lượng.
- Kiểm tra các nhóm độc lập. Mỗi người chỉ thuộc một nhóm thu nhập.
- Kiểm tra phân phối không quá lệch trong từng nhóm. ANOVA khá vững với vi phạm phân phối chuẩn khi mỗi nhóm có từ khoảng 20 đến 30 người trở lên. Nhóm "Từ 30 triệu" chỉ có 26 người nên cần xem kỹ biểu đồ hộp.
- Kiểm tra phương sai các nhóm. Đọc kiểm định Levene và chạy thêm Welch ANOVA để đối chiếu (mục 6).
Biểu đồ hộp theo nhóm (menu Analyze > Descriptive Statistics > Explore, đưa YD vào Dependent List, THUNHAP vào Factor List, chọn Plots > Boxplots):
EXAMINE VARIABLES=YD BY THUNHAP /PLOT=BOXPLOT /STATISTICS=NONE.
Hình 2 là biểu đồ hộp của YD theo bốn nhóm thu nhập.
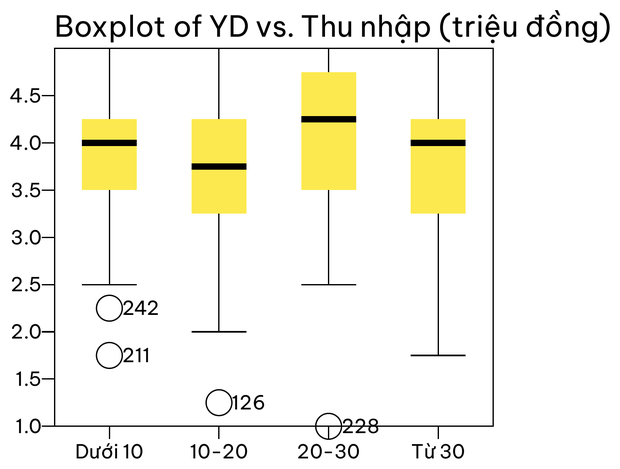
Hình 2. Biểu đồ hộp YD theo bốn nhóm thu nhập (triệu đồng/tháng). Nhóm 20–30 triệu có trung vị cao nhất; độ rộng các hộp tương đương nhau.
Bốn hộp có độ rộng gần nhau, gợi ý phương sai tương đương. Có vài điểm ngoại lai phía dưới ở ba nhóm đầu (các ID 242, 211, 126, 228), nhưng chỉ là vài người trong mỗi nhóm. Nhóm 20–30 triệu có trung vị cao hơn hẳn (4,25 so với 3,75–4,00 ở các nhóm khác).
3. Chạy ANOVA một chiều trong PSPP
ANOVA một chiều chạy được bằng menu One-Way ANOVA hoặc bằng cú pháp.
- Mở menu Analyze > Compare Means > One Way ANOVA (Hình 3).
- Đưa biến YD vào ô Dependent Variable(s) và THUNHAP vào ô Factor (Hình 4).
- Đánh dấu Descriptives và Homogeneity trong khung Statistics để có bảng mô tả và kiểm định Levene.
- Bấm Post-Hoc và chọn các kiểm định sâu: Bonferroni, Games Howell, Tukey HSD, rồi bấm Continue (Hình 5).
- Bấm Contrasts nếu muốn kiểm định một giả thuyết cụ thể. Ở đây nhập lần lượt các hệ số −3, −1, 1, 3, mỗi lần bấm Add, rồi bấm Continue (Hình 6). Mục 7 giải thích ý nghĩa của bộ hệ số này.
- Bấm Paste để lấy cú pháp (Hình 7), hoặc OK để chạy ngay.
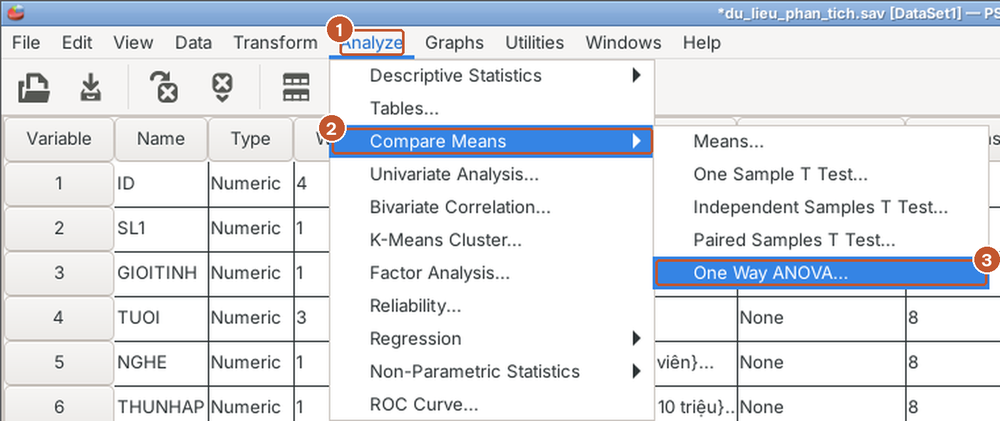
Hình 3. (1) Analyze, (2) Compare Means, (3) One Way ANOVA.
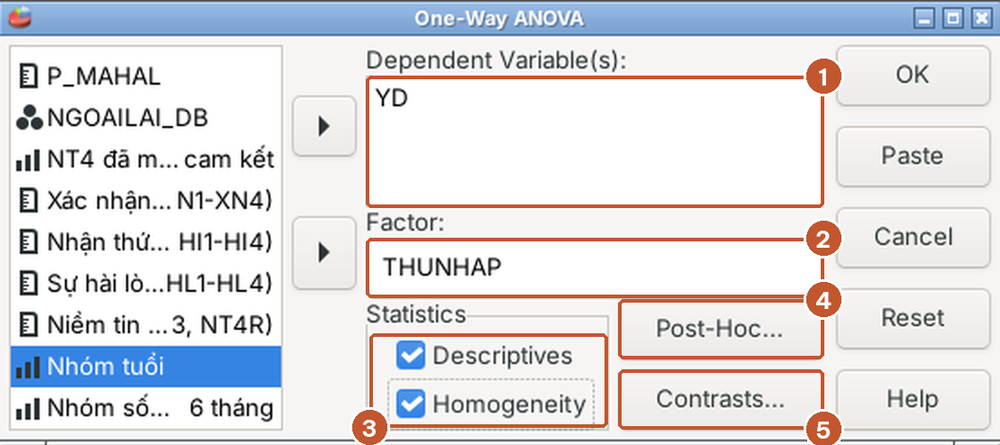
Hình 4. (1) Biến phụ thuộc, (2) biến nhóm, (3) thống kê mô tả và kiểm định Levene, (4) nút Post-Hoc, (5) nút Contrasts.
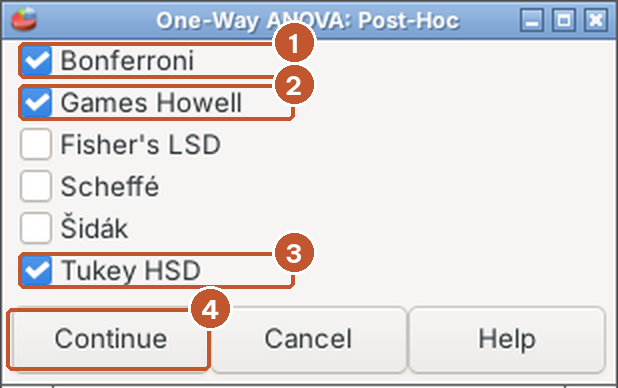
Hình 5. (1) Bonferroni, (2) Games-Howell, (3) Tukey HSD, (4) Continue. PSPP 2.0.0 có sáu kiểm định sâu và không có ô chọn mức ý nghĩa; mức mặc định là 0,05.
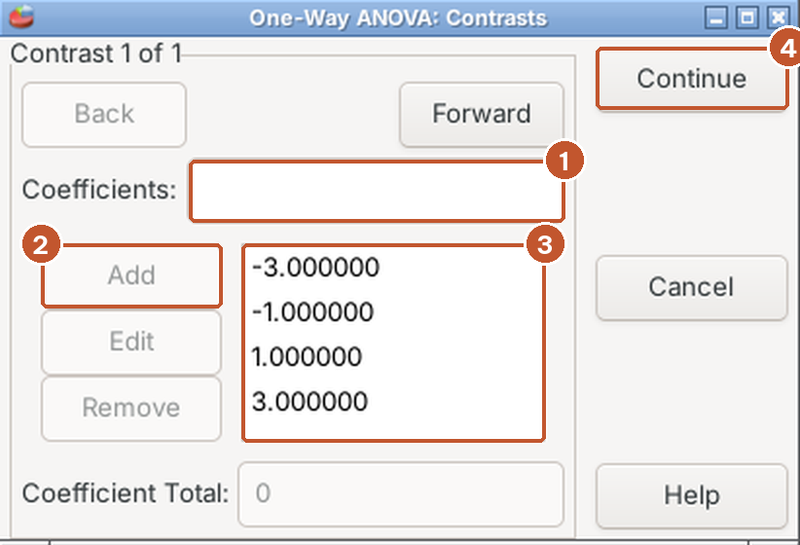
Hình 6. (1) Ô nhập hệ số, (2) nút Add, (3) danh sách hệ số đã nhập theo thứ tự nhóm 1 đến 4, (4) Continue.
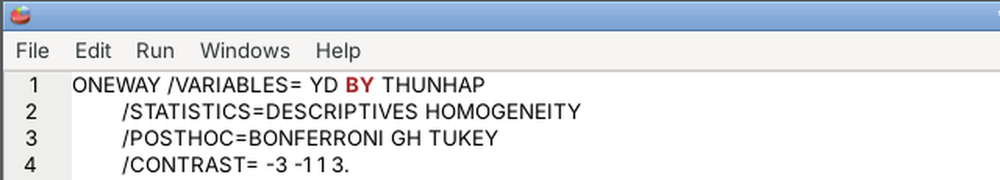
Hình 7. Cú pháp PSPP sinh ra khi bấm Paste.
Cú pháp tương ứng:
ONEWAY /VARIABLES=YD BY THUNHAP
  /STATISTICS=DESCRIPTIVES HOMOGENEITY
  /POSTHOC=TUKEY BONFERRONI GH
  /CONTRAST=-3 -1 1 3.
4. Đọc kết quả ANOVA
Kết quả ANOVA gồm bảng mô tả, kiểm định Levene và bảng ANOVA (Hình 8).
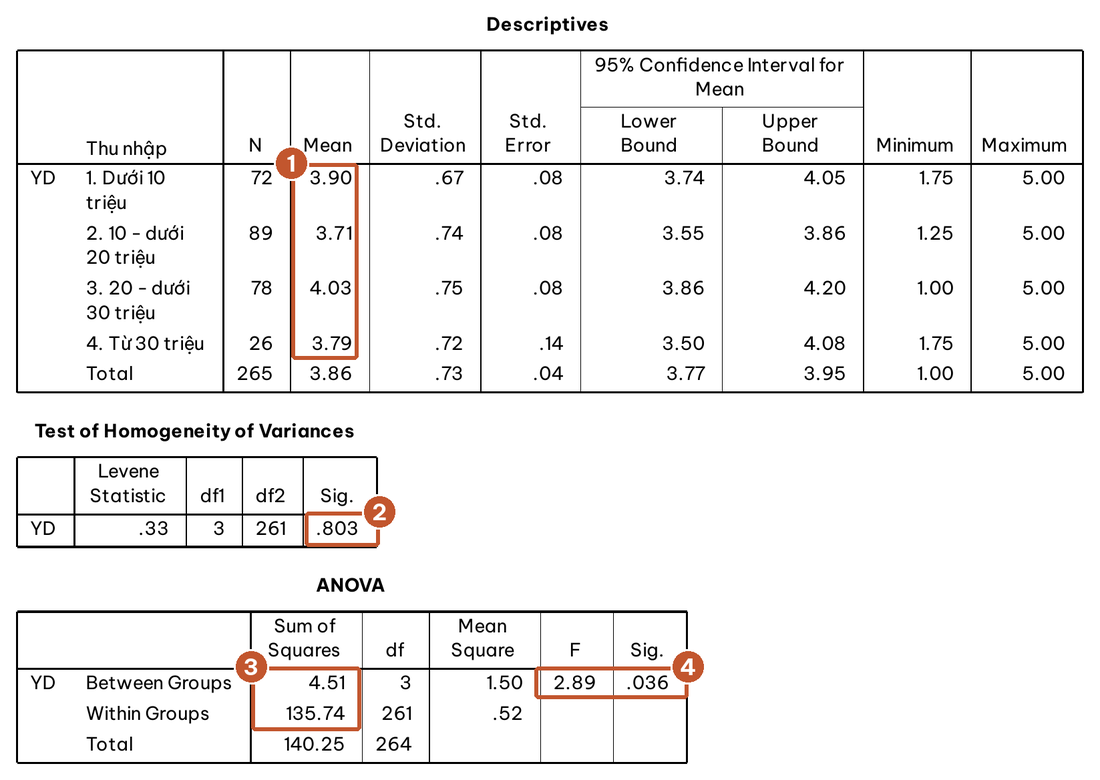
Hình 8. (1) Trung bình YD của từng nhóm, (2) kiểm định Levene, (3) tổng bình phương giữa nhóm và trong nhóm, (4) F và Sig.
Đọc theo bốn bước:
- Đọc bảng Descriptives (ô 1). YD trung bình: dưới 10 triệu 3,90 (n = 72); 10–20 triệu 3,71 (n = 89); 20–30 triệu 4,03 (n = 78); từ 30 triệu 3,79 (n = 26). Hai người không trả lời YD bị loại, còn 265 người.
- Đọc kiểm định Levene (ô 2). F(3, 261) = 0,33; p = 0,803: không có bằng chứng phương sai các nhóm khác nhau.
- Đọc bảng ANOVA (ô 3 và 4). Tổng bình phương giữa các nhóm (Between Groups) là 4,51; trong nhóm (Within Groups) là 135,74. F(3, 261) = 2,89; p = 0,036.
- Kết luận sơ bộ. Có ít nhất một nhóm thu nhập có ý định mua lại trung bình khác các nhóm còn lại.
Tính hệ số ảnh hưởng eta bình phương và omega bình phương
Giá trị p = 0,036 không cho biết khác biệt lớn đến đâu. Hai chỉ số hệ số ảnh hưởng thường dùng cho ANOVA (Lakens, 2013):
- Eta bình phương (eta²) = SS giữa nhóm / SS tổng = 4,51 / 140,25 = 0,032. Thu nhập giải thích 3,2% phương sai của ý định mua lại.
- Omega bình phương (omega²) = (SS giữa nhóm − (k − 1) × MS trong nhóm) / (SS tổng + MS trong nhóm) = (4,51 − 3 × 0,52) / (140,25 + 0,52) = 0,021. Chỉ số này hiệu chỉnh độ chệch dương của eta², nên đáng tin hơn với mẫu nhỏ.
Theo quy ước của Cohen (1988), eta² khoảng 0,01 là nhỏ, 0,06 là trung bình, 0,14 là lớn. Tác động của thu nhập ở đây là nhỏ.
PSPP 2.0.0 không in eta² và omega² cho ANOVA. Có thể tính tay từ bảng ANOVA như trên, hoặc dùng phần 3 của file anova.sps (kết quả ở Hình 12). Trong SPSS từ phiên bản 27, hộp thoại One-Way ANOVA có ô Estimate effect size for overall tests.
5. Kiểm định sâu (post-hoc)
Kiểm định F chỉ cho biết có ít nhất một cặp nhóm khác nhau. Kiểm định sâu cho biết đó là những cặp nào.
Chọn kiểm định sâu
Mỗi kiểm định sâu phù hợp với một tình huống dữ liệu khác nhau (Hình 9).
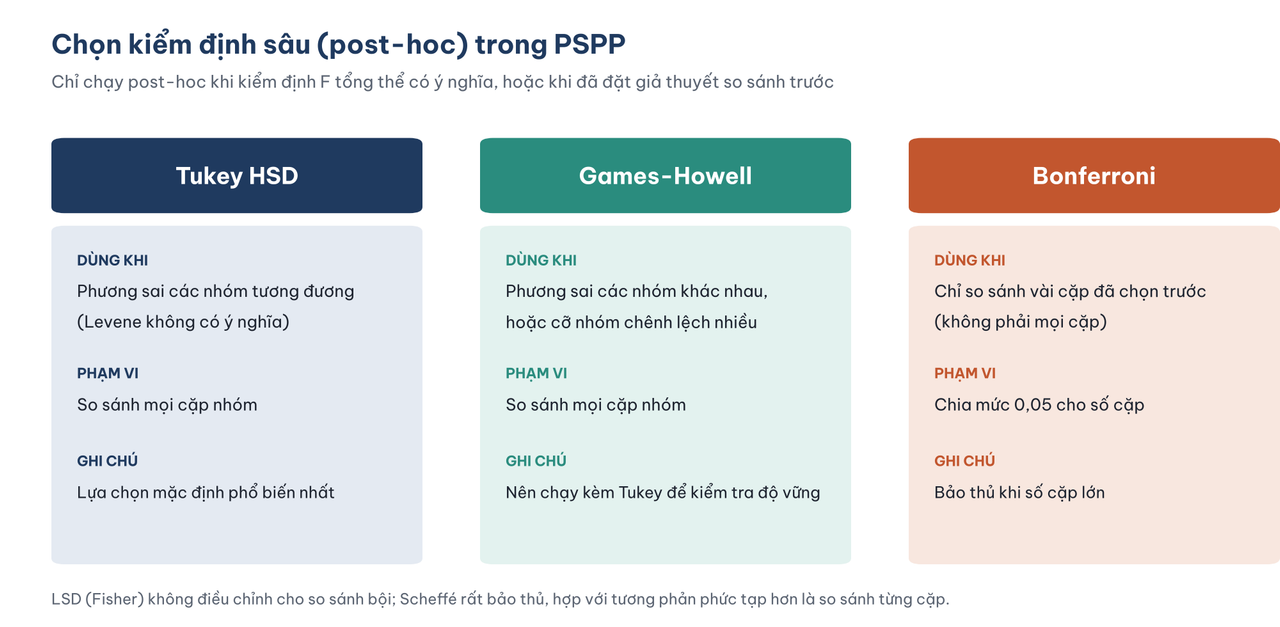
Hình 9. Ba kiểm định sâu thường dùng và khi nào chọn từng loại.
- Tukey HSD so sánh mọi cặp nhóm, kiểm soát tổng sai lầm loại I và là lựa chọn mặc định khi phương sai tương đương (Maxwell và cộng sự, 2018).
- Games-Howell không cần giả định phương sai bằng nhau, phù hợp khi Levene có ý nghĩa hoặc cỡ nhóm chênh lệch nhiều (Games & Howell, 1976). Ở dữ liệu này nhóm nhỏ nhất (26 người) chỉ bằng khoảng 30% nhóm lớn nhất (89 người), nên chạy Games-Howell để kiểm tra độ vững là hợp lý.
- Bonferroni chia mức 0,05 cho số cặp. Kiểm định này thích hợp nhất khi chỉ so sánh vài cặp đã chọn trước khi xem dữ liệu; khi so sánh mọi cặp, nó bảo thủ hơn Tukey.
- LSD của Fisher không điều chỉnh cho so sánh bội, nên không dùng làm kiểm định sâu chính.
Chỉ chạy post-hoc khi kiểm định F tổng thể có ý nghĩa, trừ khi đã đặt giả thuyết so sánh cụ thể từ trước. Nếu F không có ý nghĩa mà vẫn dò từng cặp để tìm p < 0,05, đó là "câu cá" kết quả.
Đọc bảng Multiple Comparisons
Bảng Multiple Comparisons so sánh lần lượt từng cặp nhóm (Hình 10).
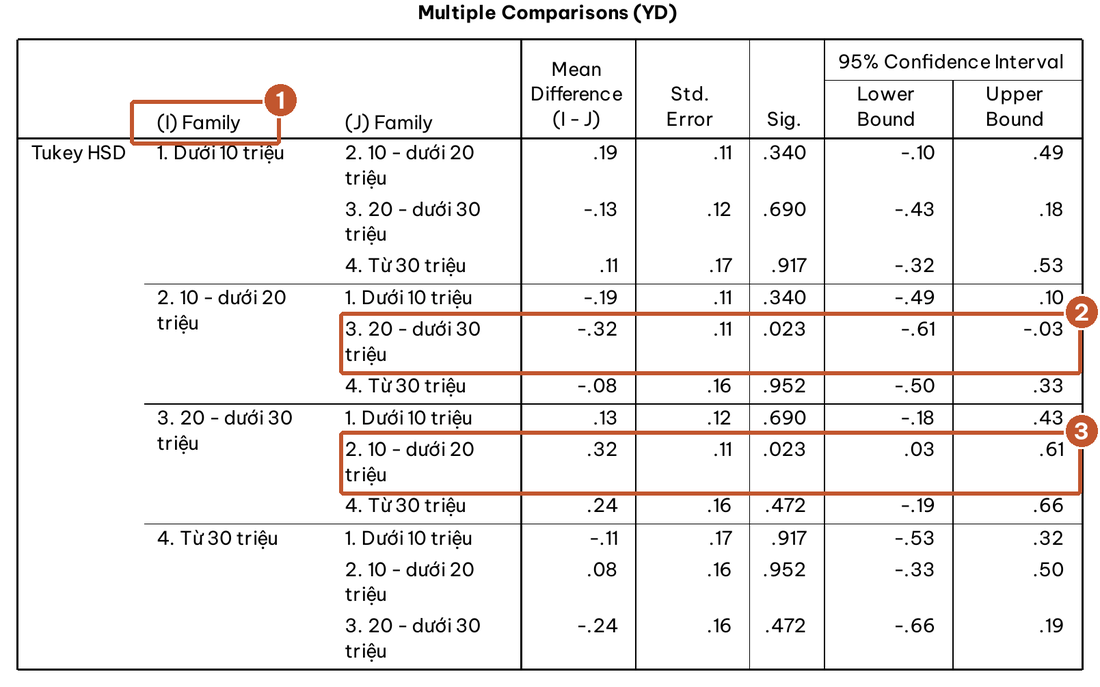
Hình 10. Kết quả Tukey HSD. (1) Cột nhóm I (PSPP ghi nhãn "Family"), (2) so sánh 10–20 triệu với 20–30 triệu, (3) cùng cặp đó theo chiều ngược lại.
- Đọc cột (I) và (J). Mỗi dòng là một cặp nhóm; chênh lệch trung bình bằng nhóm I trừ nhóm J. PSPP 2.0.0 ghi tiêu đề cột là "(I) Family" và "(J) Family" thay vì tên biến nhóm (ô 1); đây là cách hiển thị của PSPP, không ảnh hưởng kết quả.
- Bỏ qua dòng lặp. Mỗi cặp xuất hiện hai lần với dấu ngược nhau (ô 2 và ô 3). Chỉ cần đọc một lần cho mỗi cặp, tức 6 cặp.
- Tìm cặp có Sig. < 0,05. Chỉ có một cặp: nhóm 10–20 triệu thấp hơn nhóm 20–30 triệu 0,32 điểm (p = 0,023; KTC 95% [0,03; 0,61] theo chiều 20–30 trừ 10–20).
- Đối chiếu với Games-Howell và Bonferroni. Cùng cặp này có p = 0,031 theo Games-Howell và 0,027 theo Bonferroni. Năm cặp còn lại đều có p > 0,3 theo cả ba kiểm định.
Hình 11 vẽ trung bình và khoảng tin cậy của từng nhóm thu nhập.
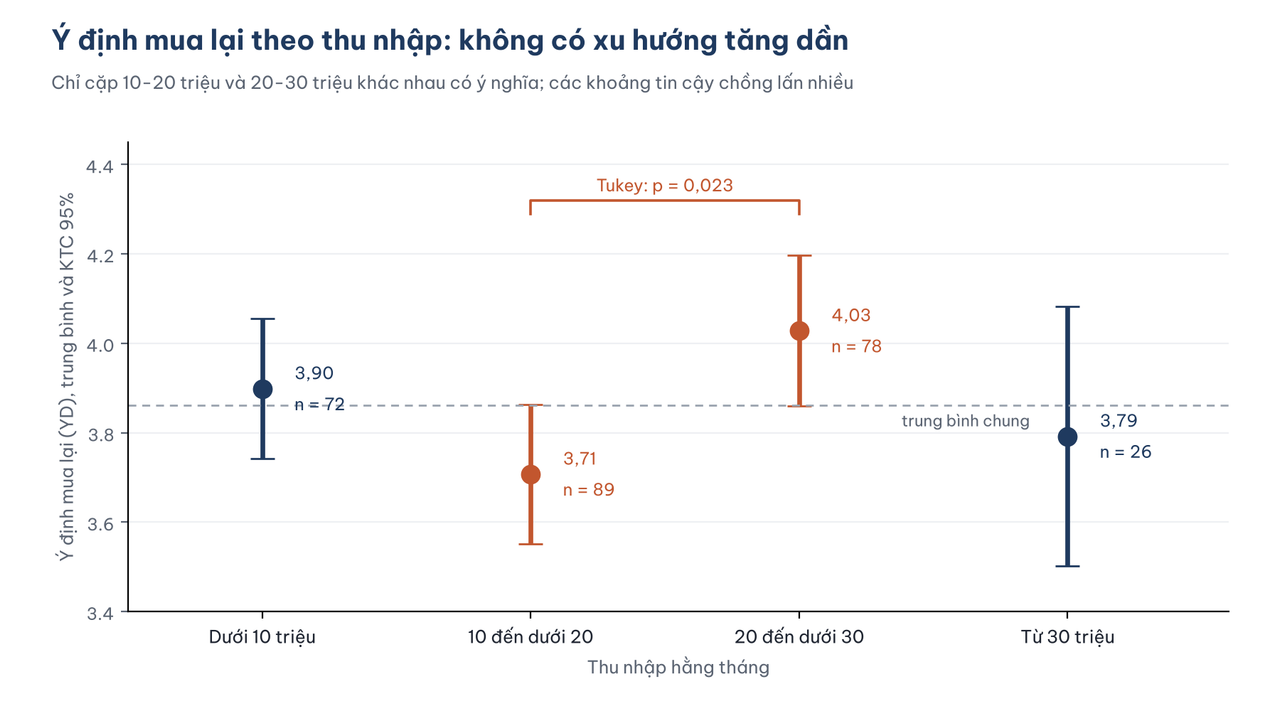
Hình 11. Trung bình YD và khoảng tin cậy 95% theo nhóm thu nhập, tính lại từ dữ liệu mẫu. Hai nhóm màu cam là cặp khác nhau có ý nghĩa.
Hình 11 cho thấy điểm quan trọng: khác biệt nằm giữa hai nhóm thu nhập liền kề ở khoảng giữa, trong khi nhóm thấp nhất và cao nhất không khác các nhóm còn lại.
6. Khi phương sai các nhóm khác nhau: Welch ANOVA
Cũng như kiểm định T, ANOVA cổ điển có thể sai khi phương sai và cỡ nhóm cùng chênh lệch. Welch ANOVA không cần giả định phương sai bằng nhau và nhiều tác giả khuyên dùng theo mặc định (Delacre và cộng sự, 2019). Thay thế phi tham số là kiểm định Kruskal-Wallis, so sánh hạng thay vì trung bình (Kruskal & Wallis, 1952).
PSPP 2.0.0 không có Welch ANOVA. Phần 3 của anova.sps tính trực tiếp theo công thức của Welch (1951): gộp dữ liệu thành một dòng cho mỗi nhóm bằng AGGREGATE, tính trọng số w = n / s², rồi tính F và bậc tự do điều chỉnh. Đoạn cú pháp chính:
SORT CASES BY THUNHAP.
AGGREGATE /OUTFILE=* /BREAK=THUNHAP /N_J=N(YD) /TB_J=MEAN(YD) /SD_J=SD(YD).
COMPUTE W_J = N_J / SD_J ** 2.
...
COMPUTE F_WELCH = (SUM_A / (K - 1)) / (1 + 2 * (K - 2) / (K ** 2 - 1) * SUM_H).
COMPUTE DF2 = (K ** 2 - 1) / (3 * SUM_H).
COMPUTE P_WELCH = 1 - CDF.F(F_WELCH, DF1, DF2).
Kiểm định Kruskal-Wallis có sẵn trong menu Analyze > Non-Parametric Statistics > K Independent Samples:
NPAR TESTS /K-W=YD BY THUNHAP(1, 4).
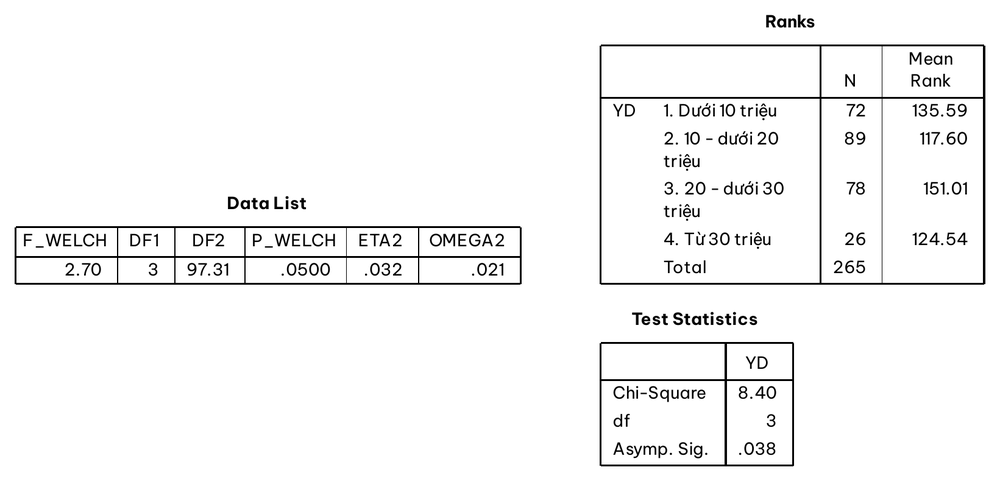
Hình 12. Bên trái: Welch F, bậc tự do, Sig., eta bình phương và omega bình phương tính bằng cú pháp. Bên phải: kiểm định Kruskal-Wallis.
Bảng 1 tổng hợp các kiểm định thay thế khi giả định của ANOVA bị vi phạm.
Bảng 1. Kết quả các kiểm định thay thế cho ANOVA.
| Kiểm định | Thống kê | Bậc tự do | p |
|---|---|---|---|
| ANOVA cổ điển | F = 2,89 | 3; 261 | 0,036 |
| Welch ANOVA | F = 2,70 | 3; 97,31 | 0,050 |
| Kruskal-Wallis | H = 8,40 | 3 | 0,038 |
Welch ANOVA cho p = 0,0500 khi làm tròn đến bốn chữ số. Giá trị chính xác nhỏ hơn 0,05 một chút (0,04999), nhưng tranh luận kết quả nằm bên nào của ngưỡng là vô nghĩa. Điều cần rút ra là: bằng chứng về khác biệt theo thu nhập chỉ ở mức yếu và kết luận phụ thuộc vào kiểm định được chọn. Vì Levene không có ý nghĩa (p = 0,803) và Kruskal-Wallis cho kết quả tương tự ANOVA cổ điển, báo cáo ANOVA cổ điển kèm hai kiểm định đối chiếu là hợp lý, miễn là nói rõ cả ba con số.
7. Kiểm định xu hướng bằng tương phản (contrast)
Thu nhập là biến thứ bậc. Một câu hỏi tự nhiên là: thu nhập càng cao thì ý định mua lại càng cao (hoặc càng thấp)? Post-hoc không trả lời được câu hỏi này, vì nó chỉ so sánh từng cặp. Tương phản xu hướng tuyến tính với hệ số −3, −1, 1, 3 kiểm định đúng giả thuyết đó: các hệ số tăng đều theo thứ tự nhóm và có tổng bằng 0 (Hình 13).
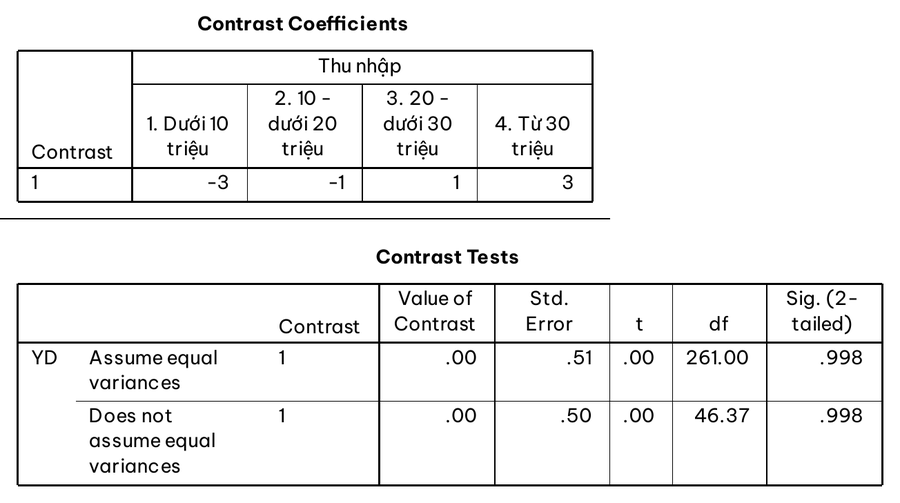
Hình 13. Hệ số tương phản và kết quả kiểm định xu hướng tuyến tính.
Giá trị tương phản là 0,00; t(261) = 0,00; p = 0,998 (dòng Does not assume equal variances cho cùng kết luận). Không có xu hướng tuyến tính nào: ý định mua lại không tăng hay giảm theo thu nhập. Kết hợp với kết quả post-hoc, mẫu hình là zíc zắc (lần lượt 3,90; 3,71; 4,03 và 3,79), không phải một quan hệ có hệ thống.
Lưu ý: tương phản là giả thuyết nên được đặt trước khi xem dữ liệu. Nếu xem Hình 11 rồi mới chọn hệ số "so sánh nhóm 20–30 triệu với các nhóm còn lại", p của tương phản đó không còn đáng tin.
8. Một ví dụ không có ý nghĩa: ý định mua lại theo nghề nghiệp
ONEWAY /VARIABLES=YD BY NGHE /STATISTICS=DESCRIPTIVES HOMOGENEITY.
Hình 14 là kết quả cho biến nghề nghiệp.
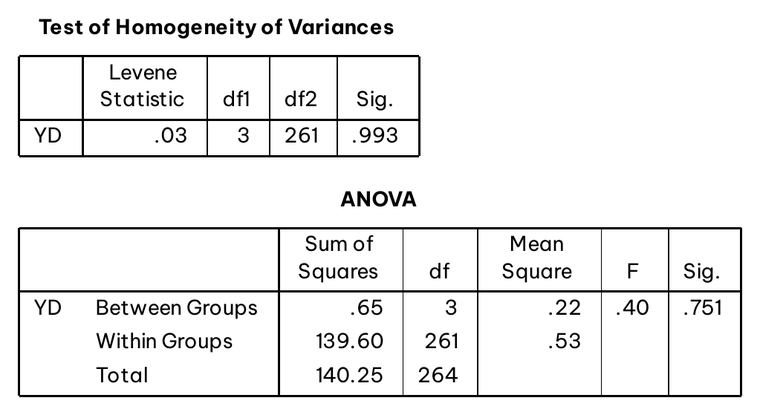
Hình 14. Kiểm định Levene và bảng ANOVA của YD theo bốn nhóm nghề nghiệp.
F(3, 261) = 0,40; p = 0,751; eta² = 0,005. Không có bằng chứng ý định mua lại khác nhau theo nghề nghiệp. Kết quả trùng khớp hoàn toàn với mô hình hồi quy chỉ gồm ba biến giả nghề nghiệp ở bài biến giả và biến điều tiết (F(3, 261) = 0,40; p = 0,751). ANOVA một chiều và hồi quy với biến giả là cùng một mô hình tuyến tính, chỉ khác cách trình bày.
Khi F tổng thể không có ý nghĩa như ở đây, không chạy post-hoc để tìm cặp có khác biệt.
9. Diễn giải thận trọng kết quả theo thu nhập
Kết quả theo thu nhập có ý nghĩa thống kê, nhưng có bốn lý do để diễn giải thận trọng:
- Bằng chứng nằm sát ngưỡng. p = 0,036 với ANOVA cổ điển và 0,050 với Welch.
- Tác động nhỏ. omega² = 0,021: thu nhập giải thích khoảng 2% phương sai của ý định mua lại.
- Không có mẫu hình có ý nghĩa lý thuyết. Chỉ hai nhóm liền kề ở giữa khác nhau và không có xu hướng tuyến tính. Rất khó đưa ra lời giải thích vì sao người có thu nhập 20–30 triệu muốn mua lại nhiều hơn người có thu nhập 10–20 triệu, nhưng không nhiều hơn người dưới 10 triệu.
- Đây là một trong nhiều kiểm định. Bộ dữ liệu có bốn biến nhân khẩu học (giới tính, tuổi, nghề nghiệp, thu nhập). Khi kiểm định cả bốn biến cho YD ở mức 0,05, việc có một kết quả p < 0,05 do ngẫu nhiên không phải là hiếm. Trong bộ dữ liệu mẫu, chỉ thu nhập có ý nghĩa; giới tính (bài T-test, p = 0,977), nhóm tuổi (p = 0,544) và nghề nghiệp (mục 8, p = 0,751) đều không.
Cách viết phù hợp trong luận văn: báo cáo tất cả các kiểm định nhân khẩu học đã chạy, nêu kết quả theo thu nhập kèm hệ số ảnh hưởng và ghi nhận đây là phát hiện khám phá cần được kiểm chứng trên một mẫu khác. Không nên xây dựng hàm ý quản trị lớn ("sàn X nên tập trung vào nhóm thu nhập 20–30 triệu") từ một khác biệt 0,32 điểm sát ngưỡng ý nghĩa.
10. Trình bày kết quả theo APA 7
Phân tích phương sai một chiều cho thấy ý định mua lại khác nhau có ý nghĩa giữa các nhóm thu nhập, F(3, 261) = 2,89; p = 0,036; eta² = 0,03; omega² = 0,02. Kiểm định Levene không cho thấy phương sai các nhóm khác nhau, F(3, 261) = 0,33; p = 0,803. Kết quả Welch ANOVA nằm sát ngưỡng ý nghĩa, F(3; 97,31) = 2,70; p = 0,050 và kiểm định Kruskal-Wallis cho kết quả tương tự, H(3) = 8,40; p = 0,038. Kiểm định Tukey HSD cho thấy chỉ nhóm thu nhập 20 đến dưới 30 triệu (M = 4,03; SD = 0,75) có ý định mua lại cao hơn nhóm 10 đến dưới 20 triệu (M = 3,71; SD = 0,74), chênh lệch = 0,32; KTC 95% [0,03; 0,61]; p = 0,023. Tương phản xu hướng tuyến tính không có ý nghĩa, t(261) = 0,00; p = 0,998.
Ý định mua lại không khác nhau theo nghề nghiệp, F(3, 261) = 0,40; p = 0,751; eta² = 0,005.
Bảng mô tả nên kèm theo cỡ mẫu, trung bình và độ lệch chuẩn của từng nhóm (lấy từ bảng Descriptives ở Hình 8).
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chạy ANOVA trong luận văn.
- Chạy nhiều kiểm định T thay cho ANOVA. Sai lầm loại I cộng dồn lên 26,5% với 6 cặp so sánh.
- Chạy post-hoc khi F tổng thể không có ý nghĩa để tìm một cặp có p < 0,05.
- Dùng LSD làm kiểm định sâu chính. LSD không điều chỉnh cho so sánh bội.
- Diễn giải post-hoc như một xu hướng. "Nhóm 20–30 triệu cao hơn nhóm 10–20 triệu" không có nghĩa là "thu nhập càng cao càng muốn mua lại". Dùng tương phản xu hướng để kiểm định điều này.
- Chỉ báo cáo p mà không báo cáo hệ số ảnh hưởng. eta² hoặc omega² cho biết khác biệt có đáng kể về mặt thực tiễn hay không.
Tài liệu tham khảo
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysisfor-the-Behavioral-Sciences/Cohen/p/book/9780805802832
Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n's and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579