
KIỂM ĐỊNH T-TEST TRONG SPSS/PSPP
Chọn kiểm định cho hai mẫu độc lập, mẫu cặp hay một mẫu, đọc Levene, mức ý nghĩa và cỡ hiệu ứng
Bài nên đọc trước
Sau khi chạy hồi quy ở các bài trước, nhiều câu hỏi nghiên cứu thật ra đơn giản hơn: nam và nữ có ý định mua lại khác nhau không? Khách hàng đánh giá hai câu hỏi về giá trị cảm nhận có như nhau không? Mức hài lòng trung bình có đạt mục tiêu 4 điểm mà bộ phận chăm sóc khách hàng của sàn X đặt ra không? Cả ba câu hỏi đều so sánh trung bình và công cụ chuẩn để trả lời là kiểm định T (t-test).
Bài viết hướng dẫn cả ba loại kiểm định T trên bộ dữ liệu mẫu (du_lieu_phan_tich.sav, 267 người trả lời). Mọi kết quả trong bài lấy từ file cú pháp t_test.sps đi kèm, chạy bằng PSPP (Free Software Foundation, 2023) và được đối chiếu lại bằng Python (kiem_tra_python.py). Kết quả có hai kiểm định không có ý nghĩa. Bài giữ nguyên các kết quả đó và dùng chúng để hướng dẫn cách đọc đúng một kết quả "không khác biệt".
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
17-kiem-dinh-t-test-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Chọn đúng loại kiểm định T
Câu hỏi quyết định chỉ có một: hai trung bình cần so sánh đến từ đâu (Hình 1)?
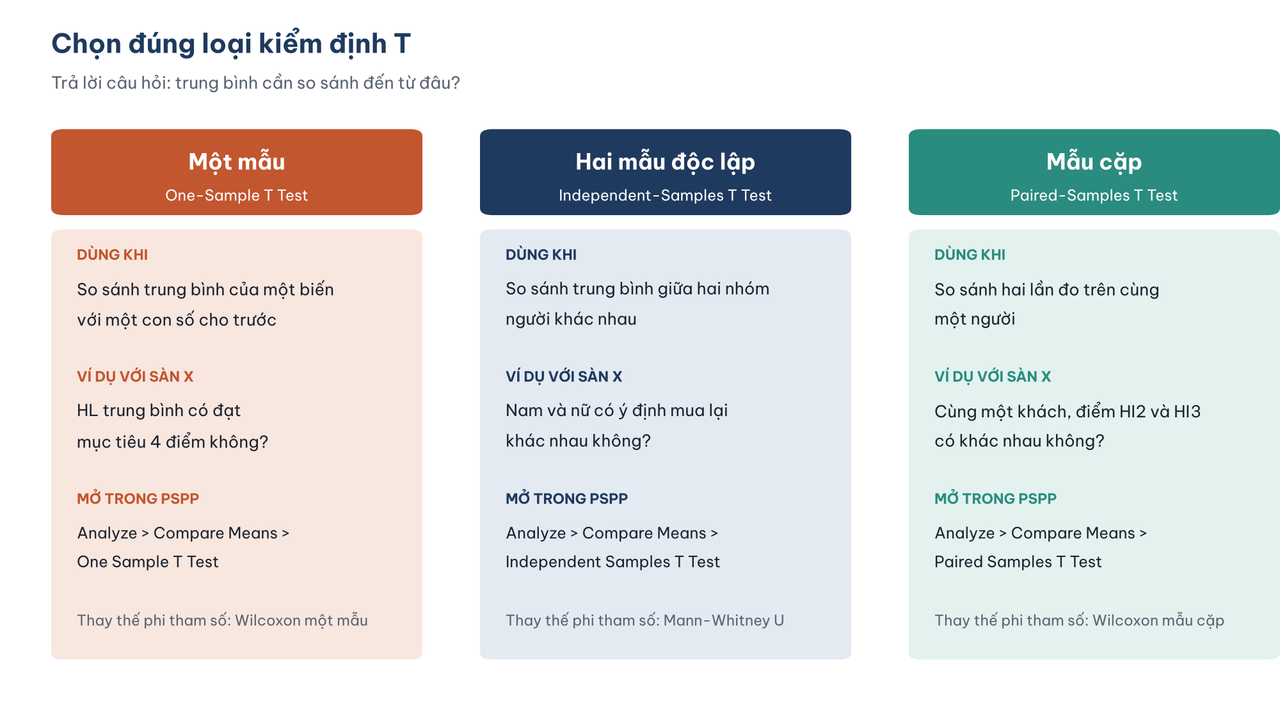
Hình 1. Ba loại kiểm định T, khi nào dùng, ví dụ với sàn X và đường dẫn menu trong PSPP.
Bảng 1 tóm tắt ba loại kiểm định T.
Bảng 1. Ba loại kiểm định T.
| Loại | Dữ liệu | Giả thuyết H0 | Ví dụ trong bài |
|---|---|---|---|
| Một mẫu (One-Sample) | Một biến định lượng và một con số cho trước | Trung bình tổng thể bằng con số đó | HL, YD so với mục tiêu 4 |
| Hai mẫu độc lập (Independent-Samples) | Một biến định lượng và một biến nhóm có hai giá trị | Trung bình hai nhóm bằng nhau | YD của nam so với nữ |
| Mẫu cặp (Paired-Samples) | Hai biến đo trên cùng một người | Trung bình của chênh lệch bằng 0 | HI2 so với HI3 |
Một lỗi rất hay gặp là dùng kiểm định hai mẫu độc lập cho dữ liệu cặp, ví dụ so sánh điểm trước và sau khóa đào tạo của cùng một nhóm nhân viên. Dữ liệu cặp có tương quan giữa hai lần đo. Kiểm định độc lập bỏ qua tương quan đó nên sai số chuẩn bị ước lượng sai. Nếu cùng một người trả lời cả hai biến, hãy dùng kiểm định mẫu cặp.
Nếu biến nhóm có ba nhóm trở lên (ví dụ bốn nhóm nghề nghiệp), không chạy nhiều kiểm định T cho từng cặp vì sai lầm loại I sẽ cộng dồn. Trường hợp này dùng ANOVA một chiều ở bài ANOVA một chiều.
2. Các giả định của kiểm định T
Kiểm định T cho kết quả đáng tin khi dữ liệu thỏa một số giả định.
- Kiểm tra biến phụ thuộc là biến định lượng. Điểm trung bình thang đo Likert (như YD, HL) được xem là định lượng. Một câu hỏi Likert đơn lẻ (như HI2) chỉ có năm mức, nên với kiểm định mẫu cặp nên chạy thêm kiểm định phi tham số để đối chiếu (mục 5).
- Kiểm tra các quan sát độc lập. Mỗi người trả lời chỉ xuất hiện một lần trong mỗi nhóm. Với kiểm định độc lập, một người không thể thuộc cả hai nhóm.
- Kiểm tra phân phối không quá lệch. Kiểm định T khá vững khi mẫu mỗi nhóm từ khoảng 30 trở lên, nhờ định lý giới hạn trung tâm (Lumley và cộng sự, 2002). Điều cần quan tâm là ngoại lai mạnh, không phải kết quả Shapiro-Wilk (xem FAQ ở bài thống kê mô tả).
- Kiểm tra phương sai hai nhóm (chỉ với kiểm định độc lập). Mục 3 giải thích vì sao bài này khuyên đọc kết quả Welch theo mặc định.
Biểu đồ hộp là cách nhanh nhất để kiểm tra giả định 3 và 4 cùng lúc. Menu: Analyze > Descriptive Statistics > Explore, đưa YD vào Dependent List, GIOITINH vào Factor List, chọn Plots > Boxplots.
EXAMINE VARIABLES=YD BY GIOITINH /PLOT=BOXPLOT /STATISTICS=NONE.
Hình 2 là biểu đồ hộp của YD theo giới tính.
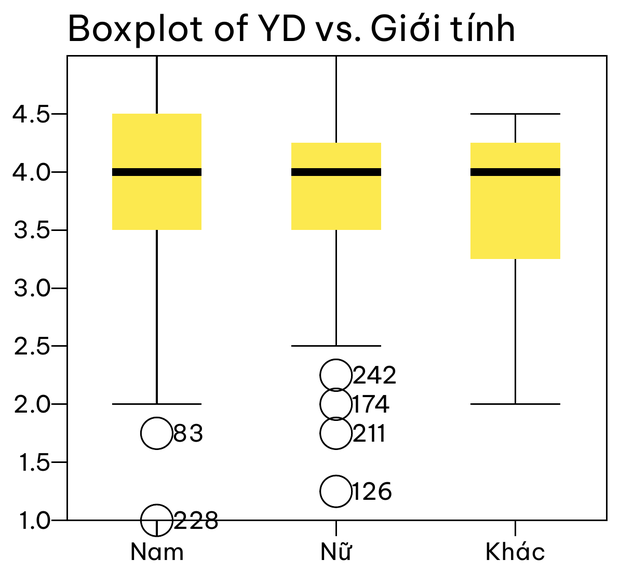
Hình 2. Biểu đồ hộp YD theo giới tính. Hai hộp Nam và Nữ có trung vị và độ rộng gần như nhau; nhóm Khác chỉ có 5 người và sẽ bị loại khỏi kiểm định.
Hai hộp Nam và Nữ có cùng trung vị (4,0) và độ rộng tương đương. Có vài điểm ngoại lai phía dưới (các ID 83, 228, 242, 174, 211, 126) nhưng không quá xa và cả hai nhóm đều có trên 120 người, nên kiểm định T vẫn phù hợp.
3. Kiểm định hai mẫu độc lập (Independent-Samples T Test)
Kiểm định hai mẫu độc lập so sánh trung bình của hai nhóm người khác nhau, ví dụ nam và nữ.
Chạy kiểm định trong PSPP
Kiểm định chạy được bằng menu Compare Means hoặc bằng cú pháp.
- Mở menu Analyze > Compare Means > Independent Samples T Test (Hình 3).
- Đưa biến YD vào ô Test Variable(s) và GIOITINH vào ô Grouping Variable (Hình 4).
- Bấm Define Groups và nhập mã hai nhóm cần so sánh: Group1 value = 1 (Nam), Group2 value = 2 (Nữ), rồi bấm Continue (Hình 5).
- Bấm Paste để lấy cú pháp (Hình 6), hoặc OK để chạy ngay.
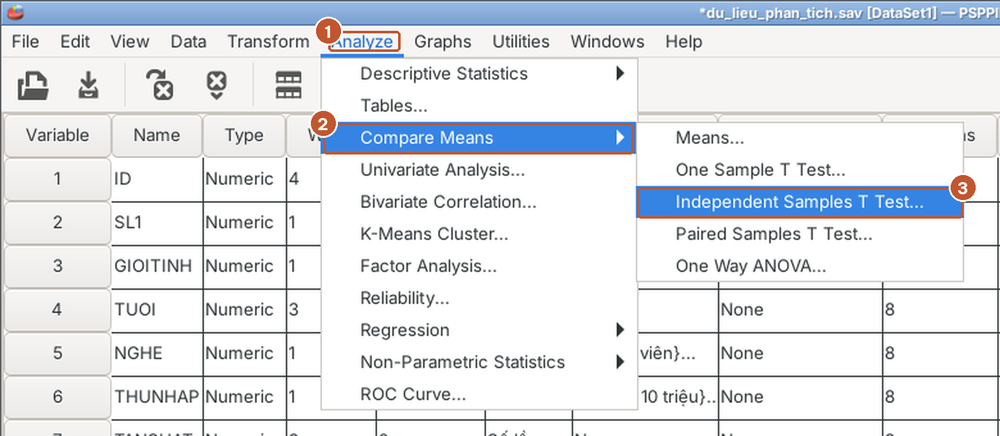
Hình 3. (1) Analyze, (2) Compare Means, (3) Independent Samples T Test.
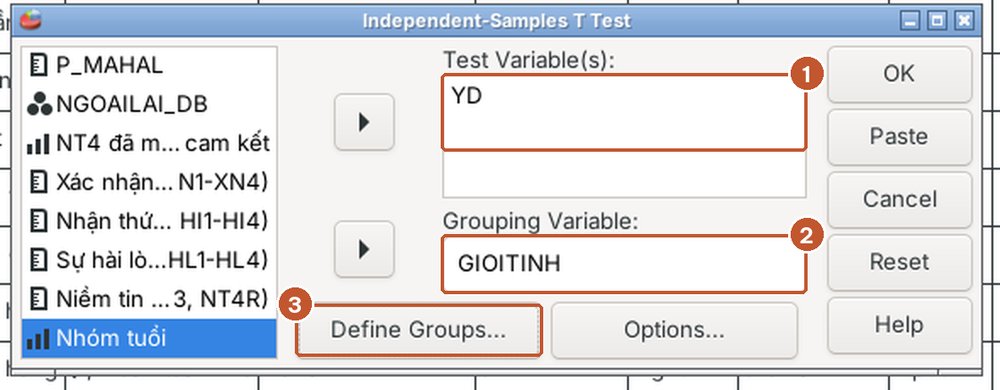
Hình 4. (1) Biến cần so sánh, (2) biến nhóm, (3) nút Define Groups để khai báo mã hai nhóm.
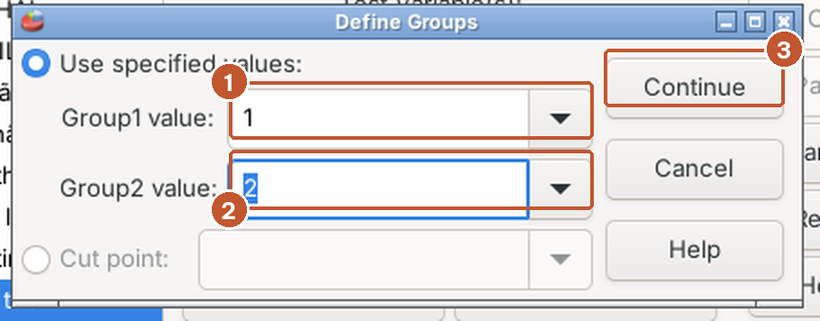
Hình 5. (1) Mã nhóm thứ nhất, (2) mã nhóm thứ hai, (3) Continue. Biến GIOITINH có ba mã (1 Nam, 2 Nữ, 3 Khác); chỉ hai mã được khai báo mới vào kiểm định.
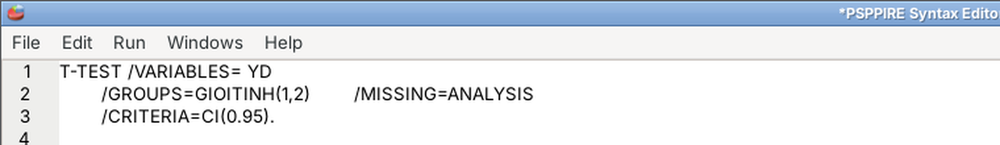
Hình 6. Cú pháp PSPP sinh ra khi bấm Paste.
Cú pháp trong file đi kèm chạy cho ba biến cùng lúc để có thêm ví dụ:
T-TEST /VARIABLES=YD HL TANSUAT
  /GROUPS=GIOITINH(1,2)
  /MISSING=ANALYSIS
  /CRITERIA=CI(0.95).
/MISSING=ANALYSIS loại giá trị thiếu theo từng biến, nên mỗi biến dùng tối đa số người có dữ liệu. Năm người chọn "Khác" bị loại vì không thuộc mã 1 hoặc 2. Nhóm này quá nhỏ để so sánh riêng; nếu cần, hãy báo cáo mô tả riêng cho nhóm này thay vì gộp tùy tiện vào nhóm khác.
Đọc kết quả
PSPP in kết quả thành hai bảng: thống kê nhóm và kết quả kiểm định (Hình 7).
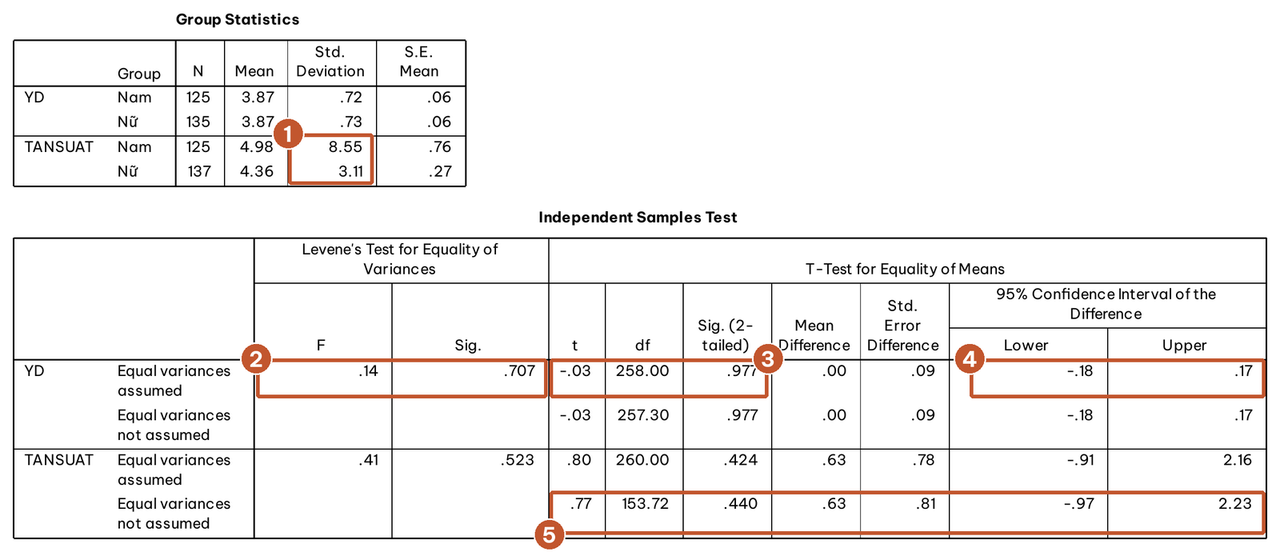
Hình 7. Kết quả cho YD và TANSUAT. (1) Độ lệch chuẩn TANSUAT của hai nhóm, (2) kiểm định Levene của YD, (3) t và Sig. của YD, (4) khoảng tin cậy 95% của chênh lệch YD, (5) dòng Welch của TANSUAT.
Đọc bảng theo năm bước:
- Đọc bảng Group Statistics. YD của nam là 3,87 (SD = 0,72; n = 125), của nữ là 3,87 (SD = 0,73; n = 135). Hai trung bình gần như trùng nhau.
- Đọc kiểm định Levene (ô 2). F = 0,14; p = 0,707: không có bằng chứng phương sai hai nhóm khác nhau.
- Đọc dòng kết quả t (ô 3). t = −0,03; p = 0,977. Hai dòng Equal variances assumed và not assumed cho kết quả gần như nhau vì phương sai và cỡ nhóm tương đương (bậc tự do 258 so với 257,30).
- Đọc khoảng tin cậy (ô 4). Chênh lệch nam trừ nữ nằm trong khoảng từ −0,18 đến 0,17 điểm. Khoảng này chứa 0.
- Kết luận. Không có bằng chứng ý định mua lại khác nhau giữa nam và nữ.
Levene hay Welch: nên đọc dòng nào?
Cách dạy truyền thống là: nếu Levene có p > 0,05 thì đọc dòng Equal variances assumed (kiểm định Student), ngược lại đọc dòng not assumed (kiểm định Welch) (Field, 2024). Cách làm hai bước này có hai vấn đề (Delacre và cộng sự, 2017):
- Levene có độ nhạy thấp khi mẫu nhỏ, nên thường "không phát hiện" được phương sai khác nhau dù chúng khác thật.
- Kiểm định Welch gần như không mất độ chính xác khi phương sai bằng nhau, nhưng tránh được sai lầm lớn khi phương sai khác nhau và cỡ nhóm lệch nhau.
Biến TANSUAT (số lần mua trong 6 tháng) cho thấy rõ vấn đề thứ nhất. Độ lệch chuẩn của nam là 8,55, gấp gần ba lần của nữ (3,11) (ô 1). Thế nhưng Levene lại cho p = 0,523. Nguyên nhân là một người duy nhất (ID 99, nam, khai 95 lần mua, được giữ lại sau khi kiểm tra ở bài làm sạch dữ liệu). Levene so sánh độ lệch tuyệt đối so với trung bình giữa hai nhóm. Điểm cực đoan này làm độ lệch trung bình của nhóm nam tăng, nhưng đồng thời làm độ biến thiên của chính các độ lệch đó trong nhóm nam tăng mạnh, nên F của Levene vẫn nhỏ. Khi bỏ riêng ID 99, độ lệch chuẩn nhóm nam chỉ còn 2,69.
Với TANSUAT, dòng Welch (ô 5) cho t(153,72) = 0,77; p = 0,440, còn dòng Student cho p = 0,424. Kết luận không đổi trong ví dụ này, nhưng bậc tự do của Welch giảm mạnh (153,72 so với 260) vì nó nhận ra nhóm nam kém chính xác hơn.
Khuyến nghị của bài: đọc dòng Equal variances not assumed (Welch) theo mặc định và báo cáo bậc tự do lẻ của nó. Chỉ cần nói rõ trong phần phương pháp là đã dùng kiểm định Welch.
Tính hệ số ảnh hưởng Cohen's d
Giá trị p chỉ cho biết có đủ bằng chứng về khác biệt hay không, không cho biết khác biệt lớn bao nhiêu. Cohen's d đo chênh lệch trung bình theo đơn vị độ lệch chuẩn gộp (Cohen, 1988; Lakens, 2013):
d = (TB nhóm 1 − TB nhóm 2) / SD gộp
SD gộp = căn bậc hai của [(n1 − 1) × SD1² + (n2 − 1) × SD2²] / (n1 + n2 − 2)
trong đó n1, n2 là cỡ mẫu và SD1, SD2 là độ lệch chuẩn của nhóm 1 và nhóm 2.
Quy ước tham khảo của Cohen (1988): 0,2 là nhỏ, 0,5 là trung bình, 0,8 là lớn. Nên ưu tiên so sánh với các nghiên cứu cùng lĩnh vực hơn là áp dụng máy móc quy ước này.
PSPP 2.0 không in Cohen's d. File t_test.sps tính d bằng AGGREGATE:
DATASET COPY TINH_D.
DATASET ACTIVATE TINH_D.
SELECT IF ANY(GIOITINH, 1, 2) AND NOT MISSING(YD).
* AGGREGATE theo nhóm cần dữ liệu được sắp xếp theo biến nhóm trước.
SORT CASES BY GIOITINH.
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /BREAK=GIOITINH /TB_NHOM=MEAN(YD).
IF (GIOITINH = 1) YD_NAM = YD.
IF (GIOITINH = 2) YD_NU = YD.
COMPUTE BP_LECH = (YD - TB_NHOM) ** 2.
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /TB_NAM=MEAN(YD_NAM) /TB_NU=MEAN(YD_NU)
  /SS_TRONG=SUM(BP_LECH) /N_TONG=N(YD).
COMPUTE SD_GOP = SQRT(SS_TRONG / (N_TONG - 2)).
COMPUTE COHEN_D = (TB_NAM - TB_NU) / SD_GOP.
Kết quả: SD gộp = 0,726; d = −0,004. Chênh lệch giữa nam và nữ gần như bằng 0.
Lưu ý dòng SORT CASES. Khi chạy thử mà không sắp xếp trước, AGGREGATE với /BREAK cho SD gộp sai (0,551 thay vì 0,726) mà không báo lỗi. Luôn đối chiếu với một cách tính khác; ở đây giá trị được kiểm tra lại bằng Python.
Trong SPSS từ phiên bản 27, hộp thoại T-test có sẵn ô Estimate effect sizes in ra Cohen's d và Hedges' g.
4. Kiểm định mẫu cặp (Paired-Samples T Test)
Kiểm định mẫu cặp so sánh hai phép đo trên cùng một người, ví dụ hai câu hỏi cùng thang đo.
Tình huống
Thang đo Giá trị cảm nhận (HI) có hai câu: HI2 "Mua hàng trên sàn X giúp tôi tìm được giá tốt" và HI3 "Sàn X giúp tôi dễ so sánh và lựa chọn sản phẩm". Bộ phận marketing muốn biết khách hàng đánh giá hai lợi ích này có như nhau không. Cùng một người trả lời cả hai câu, nên dữ liệu là dữ liệu cặp.
Chạy kiểm định
Kiểm định mẫu cặp cũng nằm trong menu Compare Means.
- Mở menu Analyze > Compare Means > Paired Samples T Test.
- Chọn HI2 làm Variable 1 và HI3 làm Variable 2 của cặp thứ nhất.
- Bấm OK hoặc Paste.
T-TEST /PAIRS=HI2 WITH HI3 (PAIRED) /CRITERIA=CI(0.95).
Đọc kết quả
Kết quả kiểm định mẫu cặp được trình bày ở Hình 8.
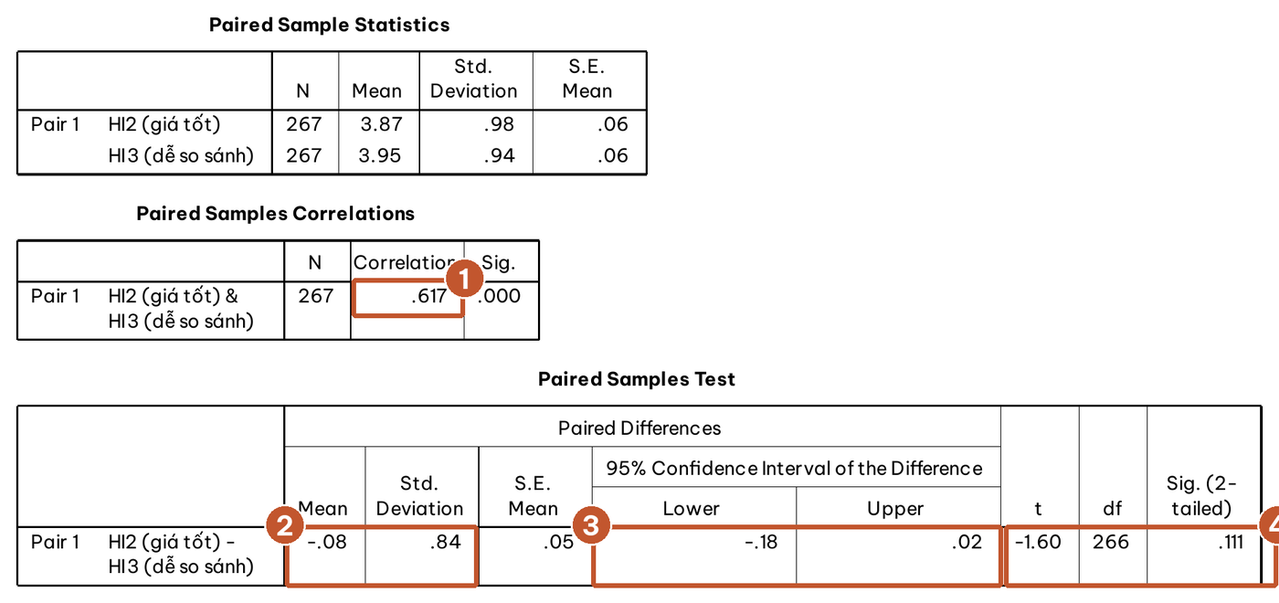
Hình 8. (1) Tương quan giữa hai lần đo, (2) trung bình và độ lệch chuẩn của chênh lệch, (3) khoảng tin cậy 95%, (4) t, df và Sig.
- Đọc bảng Paired Sample Statistics. HI2 = 3,87; HI3 = 3,95; N = 267.
- Đọc bảng tương quan (ô 1). r = 0,617: người đánh giá cao câu này thường cũng đánh giá cao câu kia. Tương quan dương này là lý do kiểm định cặp có sai số chuẩn nhỏ hơn kiểm định độc lập.
- Đọc chênh lệch (ô 2). HI2 trừ HI3 trung bình là −0,08 điểm (SD = 0,84).
- Đọc khoảng tin cậy (ô 3): từ −0,18 đến 0,02, chứa 0.
- Đọc t và Sig. (ô 4): t(266) = −1,60; p = 0,111.
- Kết luận. Chưa đủ bằng chứng để nói khách hàng đánh giá hai lợi ích này khác nhau.
Hệ số ảnh hưởng cho dữ liệu cặp là dz = trung bình chênh lệch / SD của chênh lệch = −0,08 / 0,84 = −0,10 (Lakens, 2013). PSPP không in giá trị này nhưng có thể tính tay từ bảng, hoặc dùng COMPUTE CHENH_HI = HI2 - HI3. rồi DESCRIPTIVES như trong file cú pháp.
5. Kiểm định phi tham số thay thế
Khi mẫu nhỏ và phân phối rất lệch, hoặc khi biến chỉ có vài mức như một câu hỏi Likert đơn, nên chạy kiểm định phi tham số để đối chiếu (Bảng 2):
Bảng 2. Kiểm định phi tham số thay thế cho kiểm định T.
| Kiểm định T | Thay thế phi tham số | Menu PSPP | Kết quả với dữ liệu mẫu |
|---|---|---|---|
| Hai mẫu độc lập | Mann-Whitney U | Analyze > Non-Parametric Statistics > 2 Independent Samples | YD: U = 8401,5; Z = −0,06; p = 0,952 |
| Mẫu cặp | Wilcoxon | Analyze > Non-Parametric Statistics > 2 Related Samples | HI2 với HI3: 77 hạng âm, 56 hạng dương, 134 cặp bằng nhau; p = 0,119 |
NPAR TESTS /M-W=YD BY GIOITINH(1 2).
NPAR TESTS /WILCOXON=HI2 WITH HI3 (PAIRED).
Cả hai kiểm định phi tham số cho cùng kết luận với kiểm định T. Khi hai cách cho kết quả giống nhau, báo cáo kiểm định T là chính và nhắc kiểm định phi tham số như một kiểm tra độ vững. Khi chúng khác nhau, hãy tìm nguyên nhân (thường là ngoại lai) trước khi chọn kết quả nào để báo cáo. Không chọn kiểm định chỉ vì nó cho p < 0,05.
Kiểm định Wilcoxon bỏ qua các cặp bằng nhau. Ở đây 134 trong 267 người (50%) chấm HI2 và HI3 bằng nhau, nên kiểm định chỉ dựa trên 133 người còn lại. Đây là đặc điểm thường gặp với câu hỏi Likert năm mức.
6. Kiểm định một mẫu (One-Sample T Test)
Kiểm định một mẫu so sánh trung bình của một biến với một giá trị cho trước.
Chọn giá trị kiểm định có ý nghĩa
Kiểm định một mẫu so sánh trung bình với một con số cho trước (Test Value). Con số này phải xuất phát từ câu hỏi nghiên cứu, không phải chọn tùy ý. Hai lựa chọn phổ biến:
- Điểm giữa thang đo (3). Trả lời câu hỏi "khách hàng nghiêng về đồng ý hay không đồng ý?". Với dữ liệu mẫu, HL và YD đều cao hơn 3 rất rõ (t(265) = 19,21 và t(264) = 19,24; cả hai p < 0,001; d = 1,18). Kết quả này gần như hiển nhiên khi trung bình đã là 3,9, nên ít giá trị thông tin.
- Mục tiêu quản trị (4). Giả sử bộ phận chăm sóc khách hàng của sàn X đặt mục tiêu điểm hài lòng trung bình đạt 4 ("Đồng ý"). Đây là câu hỏi có ý nghĩa ra quyết định hơn.
Chạy kiểm định
Giá trị so sánh được nhập ở ô Test Value hoặc trong cú pháp.
- Mở menu Analyze > Compare Means > One Sample T Test.
- Đưa biến HL và YD vào ô Test Variable(s).
- Nhập 4 vào ô Test Value.
- Bấm OK hoặc Paste.
T-TEST /TESTVAL=4 /VARIABLES=HL YD /CRITERIA=CI(0.95).
Đọc kết quả
Hình 9 cho biết chênh lệch giữa trung bình mẫu và giá trị so sánh có ý nghĩa hay không.
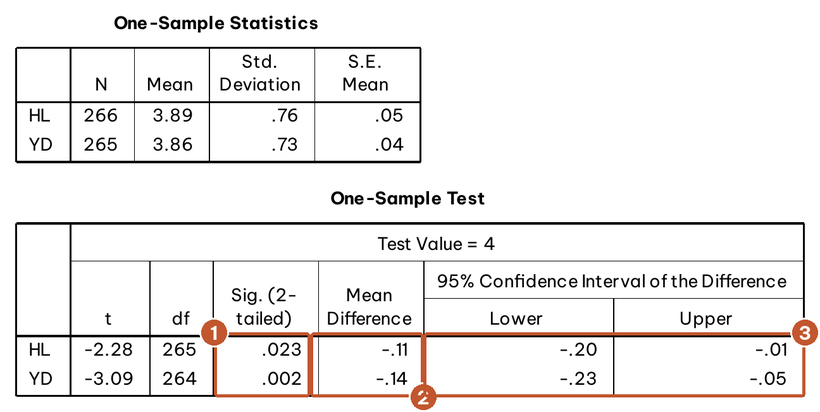
Hình 9. (1) Sig., (2) chênh lệch so với 4, (3) khoảng tin cậy 95% của chênh lệch.
- Đọc bảng One-Sample Statistics. HL = 3,89 (SD = 0,76; N = 266); YD = 3,86 (SD = 0,73; N = 265).
- Đọc Sig. (ô 1). HL: t(265) = −2,28; p = 0,023. YD: t(264) = −3,09; p = 0,002.
- Đọc chênh lệch (ô 2). HL thấp hơn mục tiêu 0,11 điểm; YD thấp hơn 0,14 điểm.
- Đọc khoảng tin cậy (ô 3). HL: từ −0,20 đến −0,01; YD: từ −0,23 đến −0,05. Cả hai khoảng nằm hoàn toàn dưới 0.
- Kết luận. Sự hài lòng và ý định mua lại trung bình chưa đạt mục tiêu 4 điểm.
Diễn giải cho nhà quản trị
Kết quả có ý nghĩa thống kê, nhưng khoảng cách nhỏ: d = −0,14 với HL và −0,19 với YD, dưới ngưỡng "nhỏ" của Cohen. Khoảng tin cậy của HL cho thấy mức thiếu hụt thật có thể chỉ là 0,01 điểm, hoặc lớn đến 0,20 điểm. Cách diễn đạt phù hợp với nhà quản trị là: "Điểm hài lòng trung bình đang ở mức 3,89, thấp hơn mục tiêu khoảng 0,1 điểm. Khoảng cách không lớn, nhưng đủ rõ để khẳng định mục tiêu chưa đạt." Không nên viết "khách hàng không hài lòng", vì trung bình vẫn cao hơn hẳn điểm giữa thang đo.
7. Đọc đúng kết quả không có ý nghĩa
Hai trong bốn kiểm định chính của bài không có ý nghĩa. Hình 10 đặt cả bốn kết quả lên cùng một trục để so sánh.
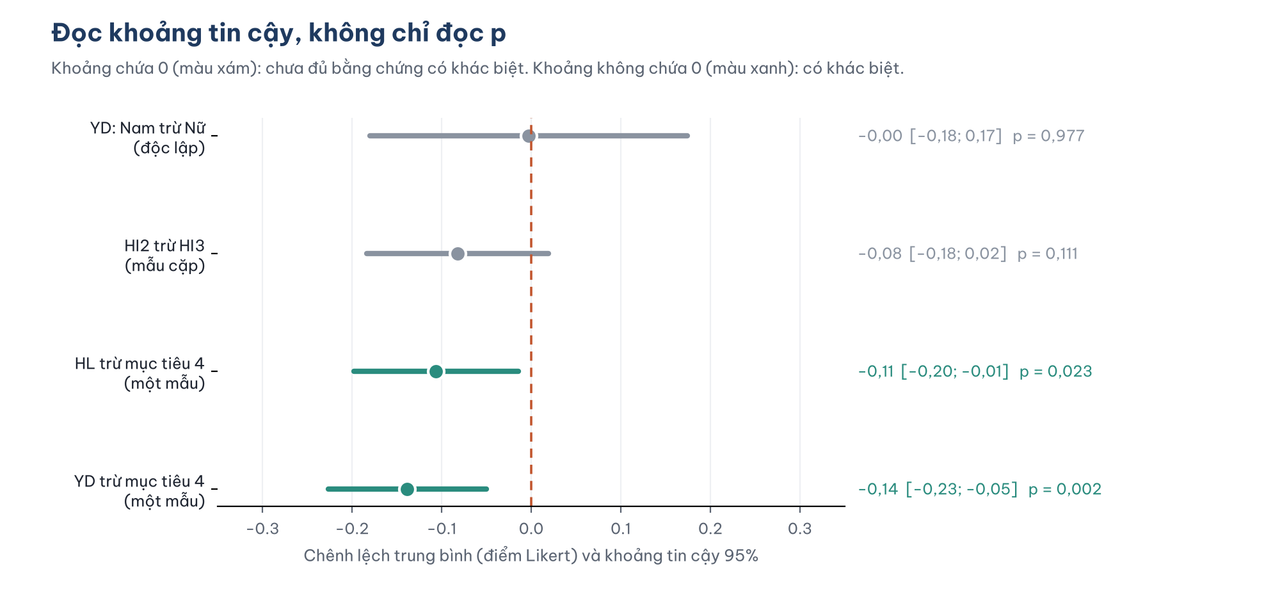
Hình 10. Chênh lệch trung bình và khoảng tin cậy 95% của bốn kiểm định, tính lại bằng Python từ dữ liệu mẫu. Đường đứt đoạn là mức không chênh lệch.
Không viết "nam và nữ có ý định mua lại như nhau". p = 0,977 chỉ cho biết dữ liệu không đủ bằng chứng về khác biệt. Không có ý nghĩa thống kê không có nghĩa là đã chứng minh được không có khác biệt.
Đọc khoảng tin cậy để biết kết quả "không khác biệt" chặt đến đâu. Khoảng tin cậy của YD theo giới tính là [−0,18; 0,17]: khác biệt thật, nếu có, gần như chắc chắn nhỏ hơn 0,2 điểm trên thang 5 điểm. Khoảng tin cậy của HI2 trừ HI3 là [−0,18; 0,02]: vẫn còn khả năng HI3 được đánh giá cao hơn HI2 khoảng 0,1 đến 0,2 điểm mà mẫu này chưa đủ lớn để phát hiện. Hai kết quả cùng "không có ý nghĩa" nhưng mức độ chắc chắn khác nhau.
Dùng kiểm định tương đương nếu muốn khẳng định "không khác biệt". Nếu nhà nghiên cứu xác định trước rằng chênh lệch dưới 0,2 điểm là không đáng kể về mặt thực tiễn, có thể chạy kiểm định tương đương hai phía (TOST, two one-sided tests) (Lakens, 2017). Cách làm tương đương là kiểm tra khoảng tin cậy 90% có nằm trọn trong [−0,2; 0,2] không. Với YD theo giới tính, khoảng tin cậy 90% là [−0,15; 0,15], nằm trọn trong vùng này (hai kiểm định một phía cho p = 0,015 và 0,013). Khi đó mới có thể viết: "Ý định mua lại của nam và nữ tương đương nhau trong phạm vi ±0,2 điểm." Ngưỡng ±0,2 phải được chọn và nêu lý do trước khi xem dữ liệu.
Không thử thêm biến khác cho đến khi tìm được kết quả có ý nghĩa. Chạy T-test cho hàng chục biến theo giới tính rồi chỉ báo cáo biến có p < 0,05 là "câu cá" kết quả. Nếu thực sự cần kiểm định nhiều biến, hãy báo cáo tất cả và điều chỉnh mức ý nghĩa (ví dụ Bonferroni: chia 0,05 cho số kiểm định).
8. Trình bày kết quả theo APA 7
Hai mẫu độc lập:
Kiểm định T hai mẫu độc lập (hiệu chỉnh Welch) không cho thấy khác biệt về ý định mua lại giữa nam (M = 3,87; SD = 0,72; n = 125) và nữ (M = 3,87; SD = 0,73; n = 135), t(257,30) = −0,03; p = 0,977; chênh lệch trung bình = −0,003; KTC 95% [−0,18; 0,17]; d = −0,004. Kiểm định Mann-Whitney cho cùng kết luận (U = 8401,5; p = 0,952).
Mẫu cặp:
Đánh giá về lợi ích giá tốt (HI2: M = 3,87; SD = 0,98) và lợi ích dễ so sánh và lựa chọn (HI3: M = 3,95; SD = 0,94) không khác nhau có ý nghĩa, t(266) = −1,60; p = 0,111; chênh lệch trung bình = −0,08; KTC 95% [−0,18; 0,02]; dz = −0,10.
Một mẫu:
Điểm hài lòng trung bình (M = 3,89; SD = 0,76) thấp hơn có ý nghĩa so với mục tiêu 4 điểm, t(265) = −2,28; p = 0,023; chênh lệch trung bình = −0,11; KTC 95% [−0,20; −0,01]; d = −0,14. Ý định mua lại (M = 3,86; SD = 0,73) cũng thấp hơn mục tiêu, t(264) = −3,09; p = 0,002; chênh lệch = −0,14; KTC 95% [−0,23; −0,05]; d = −0,19.
Theo APA 7, p được báo cáo với hai hoặc ba chữ số thập phân, không có số 0 đứng trước (p = .023 trong bài viết tiếng Anh). Khi viết bằng tiếng Việt, nhiều tạp chí trong nước dùng dấu phẩy thập phân như trên; hãy theo quy định của nơi nộp bài.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chạy và báo cáo kiểm định T.
- Dùng kiểm định độc lập cho dữ liệu cặp. Dữ liệu trước và sau, hoặc hai câu hỏi do cùng một người trả lời, phải dùng kiểm định mẫu cặp.
- Chạy nhiều T-test thay cho ANOVA. Với ba nhóm trở lên, dùng ANOVA một chiều (bài ANOVA một chiều).
- Chỉ đọc dòng Student vì Levene có p > 0,05. Levene có thể bỏ sót phương sai khác nhau, như ví dụ TANSUAT. Đọc dòng Welch theo mặc định.
- Kết luận "không có khác biệt" từ p > 0,05. Hãy đọc khoảng tin cậy và dùng kiểm định tương đương nếu muốn khẳng định hai nhóm như nhau.
- Chỉ báo cáo p mà bỏ hệ số ảnh hưởng. Với mẫu lớn, một chênh lệch rất nhỏ cũng có ý nghĩa thống kê. Luôn báo cáo chênh lệch, khoảng tin cậy và Cohen's d.
Tài liệu tham khảo
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysisfor-the-Behavioral-Sciences/Cohen/p/book/9780805802832
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546