
BIẾN GIẢ VÀ BIẾN ĐIỀU TIẾT TRONG HỒI QUY SPSS/PSPP
Mã hóa biến định danh thành biến giả, tạo số hạng tương tác, chạy và diễn giải tác động điều tiết
Bài nên đọc trước
Hai câu hỏi thường gặp sau khi chạy xong mô hình hồi quy ở bài hồi quy tuyến tính bội. Thứ nhất: làm sao đưa nghề nghiệp hay giới tính vào hồi quy, khi các mã 1, 2, 3, 4 chỉ là nhãn chứ không phải con số? Thứ hai: tác động của Sự hài lòng đến Ý định mua lại có giống nhau với mọi khách hàng không, hay mạnh hơn ở những người tin tưởng sàn X?
Câu hỏi thứ nhất được giải quyết bằng biến giả (dummy variable). Câu hỏi thứ hai được kiểm định bằng biến điều tiết (moderator). Bài viết này hướng dẫn cả hai trên bộ dữ liệu mẫu (du_lieu_phan_tich.sav), với kết quả thật từ file cú pháp bien_gia_dieu_tiet.sps đi kèm (Free Software Foundation, 2023). Kết quả có một điểm đáng chú ý: cả biến giả lẫn biến điều tiết đều không có ý nghĩa. Bài dùng chính kết quả này để hướng dẫn cách đọc và báo cáo đúng khi không tìm thấy tác động, một tình huống rất hay gặp nhưng ít được hướng dẫn.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
16-bien-gia-bien-dieu-tiet-hoi-quycủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Biến giả: đưa biến định danh vào hồi quy
Hồi quy chỉ nhận biến định lượng, nên biến định danh như giới tính hay nghề nghiệp phải được chuyển thành biến giả trước.
Vì sao không đưa thẳng NGHE vào hồi quy?
Biến NGHE được mã 1 = Sinh viên, 2 = Nhân viên văn phòng, 3 = Kinh doanh tự do, 4 = Khác. Nếu đưa thẳng NGHE vào hồi quy, phần mềm sẽ coi nó là biến định lượng và ước lượng một hệ số. Hệ số đó mặc định rằng "Kinh doanh tự do" lớn hơn "Nhân viên văn phòng" đúng bằng khoảng cách giữa "Nhân viên văn phòng" và "Sinh viên". Điều này vô nghĩa với biến định danh: đổi thứ tự mã hóa sẽ cho một kết quả hoàn toàn khác.
Mã hóa biến giả
Cách đúng là tạo các biến giả nhận giá trị 0 hoặc 1. Một biến có k nhóm cần k − 1 biến giả (Cohen và cộng sự, 2003; Hardy, 1993). Nhóm không có biến giả riêng (toàn số 0) là nhóm tham chiếu (Hình 1).
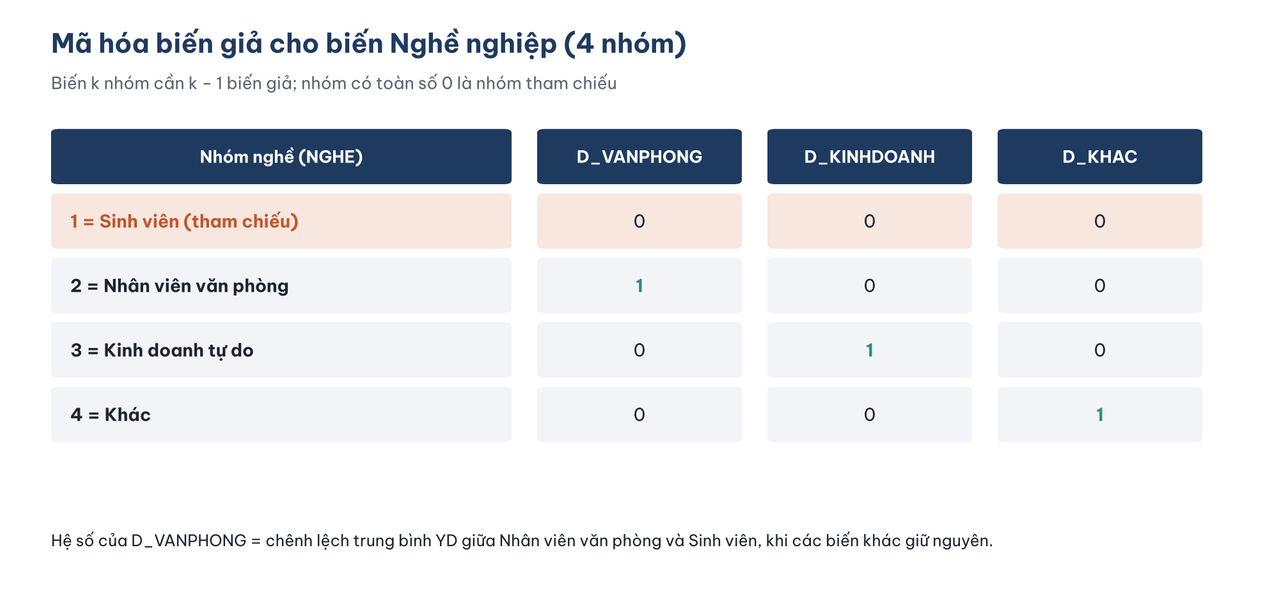
Hình 1. Bốn nhóm nghề nghiệp được thể hiện bằng ba biến giả; Sinh viên là nhóm tham chiếu.
Trong PSPP, dùng lệnh RECODE ... INTO như ở bài tính biến đại diện (menu Transform > Recode into Different Variables):
RECODE NGHE (2=1) (1,3,4=0) (MISSING=SYSMIS) INTO D_VANPHONG.
RECODE NGHE (3=1) (1,2,4=0) (MISSING=SYSMIS) INTO D_KINHDOANH.
RECODE NGHE (4=1) (1,2,3=0) (MISSING=SYSMIS) INTO D_KHAC.
(MISSING=SYSMIS) giữ người không trả lời câu nghề nghiệp là giá trị thiếu ở cả ba biến giả, thay vì xếp họ vào nhóm tham chiếu. Sau khi tạo, kiểm tra bằng bảng trung bình của từng biến giả theo nhóm gốc:
MEANS TABLES=D_VANPHONG D_KINHDOANH D_KHAC BY NGHE /CELLS=MEAN COUNT.
Hình 2 kiểm tra lại cách mã hóa: mỗi nhóm nghề ứng với đúng một tổ hợp 0/1.
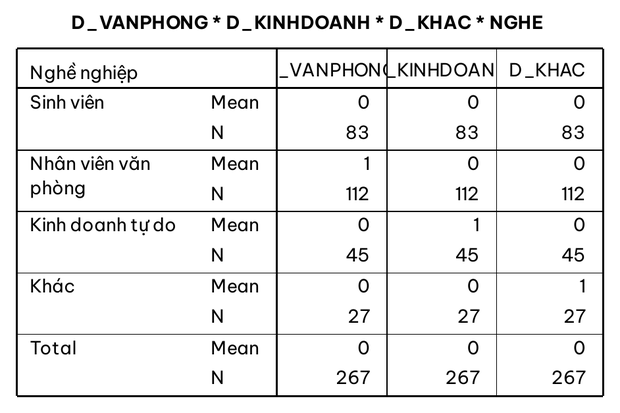
Hình 2. Mỗi nhóm nghề ứng đúng một tổ hợp 0/1, giống bảng ở Hình 1.
Chọn nhóm tham chiếu
Nhóm tham chiếu không làm thay đổi R² hay kết quả dự đoán, nhưng quyết định các hệ số so sánh với ai. Ba nguyên tắc chọn:
- Nhóm có ý nghĩa để so sánh với câu hỏi nghiên cứu. Ví dụ, nếu muốn biết người đi làm khác sinh viên thế nào, chọn Sinh viên.
- Nhóm đủ lớn. Nhóm tham chiếu nhỏ làm mọi hệ số có sai số chuẩn lớn. Tránh chọn nhóm "Khác".
- Không chọn nhóm có định nghĩa mơ hồ. "Khác" gồm nhiều nghề khác nhau, nên so sánh với nhóm này khó diễn giải.
Với giới tính, file cú pháp tạo biến giả D_NU (Nữ = 1, Nam = 0) và để nhóm giới tính "Khác" là giá trị thiếu, vì nhóm này chỉ có 5 người (bài thống kê mô tả), quá ít để ước lượng một hệ số đáng tin cậy. Đây là một quyết định cần được ghi rõ trong báo cáo.
2. Hồi quy với biến giả
Khi đã có biến giả, chúng được đưa vào phương trình như mọi biến độc lập khác.
Hệ số biến giả là chênh lệch trung bình
Chạy hồi quy YD chỉ với ba biến giả nghề nghiệp:
REGRESSION /VARIABLES=D_VANPHONG D_KINHDOANH D_KHAC /DEPENDENT=YD /METHOD=ENTER
  /STATISTICS=COEFF R ANOVA.
Hình 3 đặt trung bình của từng nhóm nghề cạnh hệ số hồi quy của các biến giả.
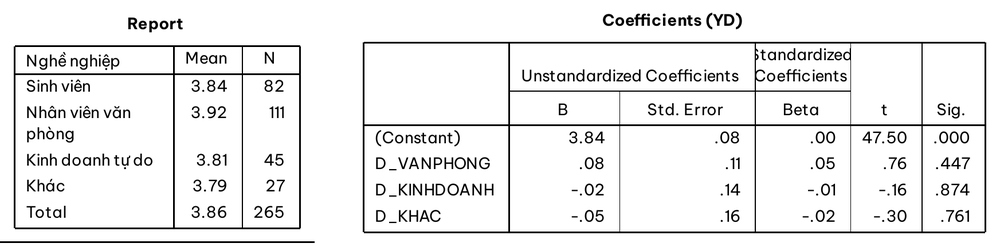
Hình 3. Trái: trung bình YD của từng nhóm nghề. Phải: hệ số hồi quy của ba biến giả.
Đặt hai bảng cạnh nhau để thấy ý nghĩa của từng hệ số:
- Hằng số = 3,84 là trung bình YD của nhóm tham chiếu (Sinh viên).
- B của D_VANPHONG = 0,08 là chênh lệch giữa Nhân viên văn phòng (3,92) và Sinh viên (3,84).
- B của D_KINHDOANH = −0,02 và B của D_KHAC = −0,05 là chênh lệch của hai nhóm còn lại so với Sinh viên.
Không chênh lệch nào có ý nghĩa (p từ 0,447 đến 0,874) và cả mô hình chỉ giải thích 0,5% phương sai của YD (F(3, 261) = 0,40; p = 0,751). Hồi quy chỉ với biến giả chính là ANOVA một chiều: bài ANOVA một chiều sẽ cho cùng kết quả này.
Bẫy biến giả
Điều gì xảy ra nếu tạo cả bốn biến giả, kể cả D_SINHVIEN và đưa hết vào mô hình có hằng số? Bốn biến giả luôn cộng lại bằng 1, đúng bằng hằng số. Đây là đa cộng tuyến hoàn hảo, gọi là bẫy biến giả (dummy variable trap) và mô hình không thể ước lượng được.
SPSS phát hiện điều này và tự động loại một biến. PSPP 2.0 thì không: lệnh vẫn chạy và in ra các con số vô nghĩa (Hình 4).
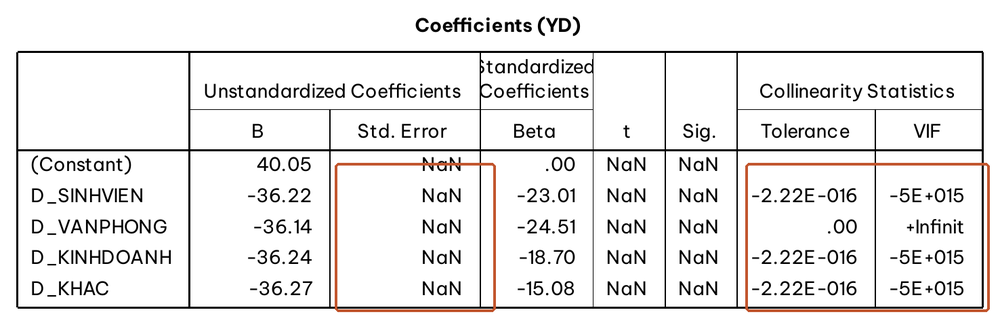
Hình 4. Sai số chuẩn, t và Sig. đều là NaN (không xác định); Tolerance gần 0 và VIF lên tới hàng triệu tỷ. Các hệ số B quanh −36 là hoàn toàn vô nghĩa.
Nếu thấy NaN, Tolerance bằng 0 hoặc VIF cực lớn trong bảng kết quả của PSPP, hãy kiểm tra xem có biến nào là tổ hợp tuyến tính hoàn hảo của các biến khác không.
Biến giả làm biến kiểm soát
Cách dùng phổ biến nhất của biến giả trong luận văn là làm biến kiểm soát: thêm các đặc điểm nhân khẩu học vào Mô hình 2 của bài hồi quy tuyến tính bội để xem kết quả chính có thay đổi không. File cú pháp chạy hai mô hình trên cùng 259 phiếu có đủ thông tin (Bảng 1):
Bảng 1. Hệ số hồi quy khi có và không có biến kiểm soát.
| Biến | Không kiểm soát: β | Có kiểm soát: β | p (có kiểm soát) |
|---|---|---|---|
| XN | 0,09 | 0,08 | ,208 |
| HI | 0,20 | 0,20 | ,003 |
| HL | 0,21 | 0,22 | ,001 |
| NT | 0,30 | 0,29 | < ,001 |
| Nhân viên văn phòng | 0,04 | ,553 | |
| Kinh doanh tự do | 0,01 | ,914 | |
| Nghề khác | −0,05 | ,399 | |
| Nữ | 0,01 | ,859 | |
| R² | 0,323 | 0,327 |
Thêm bốn biến kiểm soát chỉ làm R² tăng 0,005 (F(4, 250) = 0,42; p = 0,793) và các hệ số chính gần như không đổi. Kết luận: các tác động của HI, HL và NT không phải do khác biệt về nghề nghiệp hay giới tính của đáp viên. Đây là một bằng chứng về độ vững của kết quả, nên được báo cáo cùng mô hình chính.
3. Biến điều tiết
Biến điều tiết làm thay đổi độ mạnh hoặc chiều của quan hệ giữa hai biến khác.
Khái niệm
Biến điều tiết W làm thay đổi độ mạnh hoặc chiều của tác động của X lên Y (Baron & Kenny, 1986). Khác với biến trung gian (nằm giữa X và Y trên đường tác động), biến điều tiết tác động lên chính mối quan hệ giữa X và Y. Trên sơ đồ, đó là một mũi tên chỉ vào một mũi tên (Hình 5).
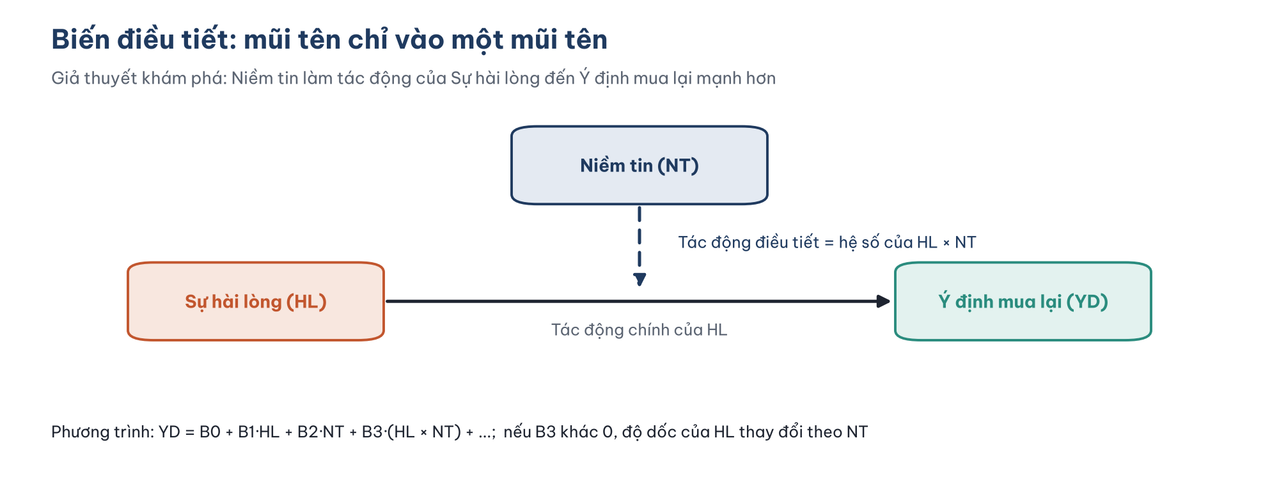
Hình 5. Giả thuyết khám phá: Niềm tin điều tiết tác động của Sự hài lòng đến Ý định mua lại.
Bài này kiểm định một giả thuyết khám phá: khách hàng tin tưởng sàn X hơn thì sự hài lòng chuyển thành ý định mua lại mạnh hơn, vì họ ít lo rủi ro trong các lần mua tiếp theo. Giả thuyết này không có trong mô hình gốc của nghiên cứu; nó được đặt ra để minh họa phương pháp.
Kiểm định bằng biến tích
Tác động điều tiết được kiểm định bằng cách thêm biến tích X × W vào phương trình (Aiken & West, 1991):
YD = B₀ + B₁HL + B₂NT + B₃(HL × NT) + các biến khác
Biến đổi phương trình: YD = B₀ + (B₁ + B₃NT) × HL + ... Độ dốc của HL bây giờ là B₁ + B₃NT, thay đổi theo NT. Nếu B₃ khác 0 có ý nghĩa thống kê, có tác động điều tiết.
Chuẩn hóa tâm trước khi nhân
Trước khi tạo biến tích, nên chuẩn hóa tâm (mean centering) các biến: trừ đi trung bình của chúng.
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /TB_HL = MEAN(HL) /TB_NT = MEAN(NT)
  /TB_XN = MEAN(XN) /TB_HI = MEAN(HI) /SD_NT = SD(NT).
COMPUTE HL_C = HL - TB_HL.
COMPUTE NT_C = NT - TB_NT.
COMPUTE XN_C = XN - TB_XN.
COMPUTE HI_C = HI - TB_HI.
COMPUTE HLxNT = HL_C * NT_C.
Để thấy vì sao, file cú pháp chạy cả hai cách (Hình 6):
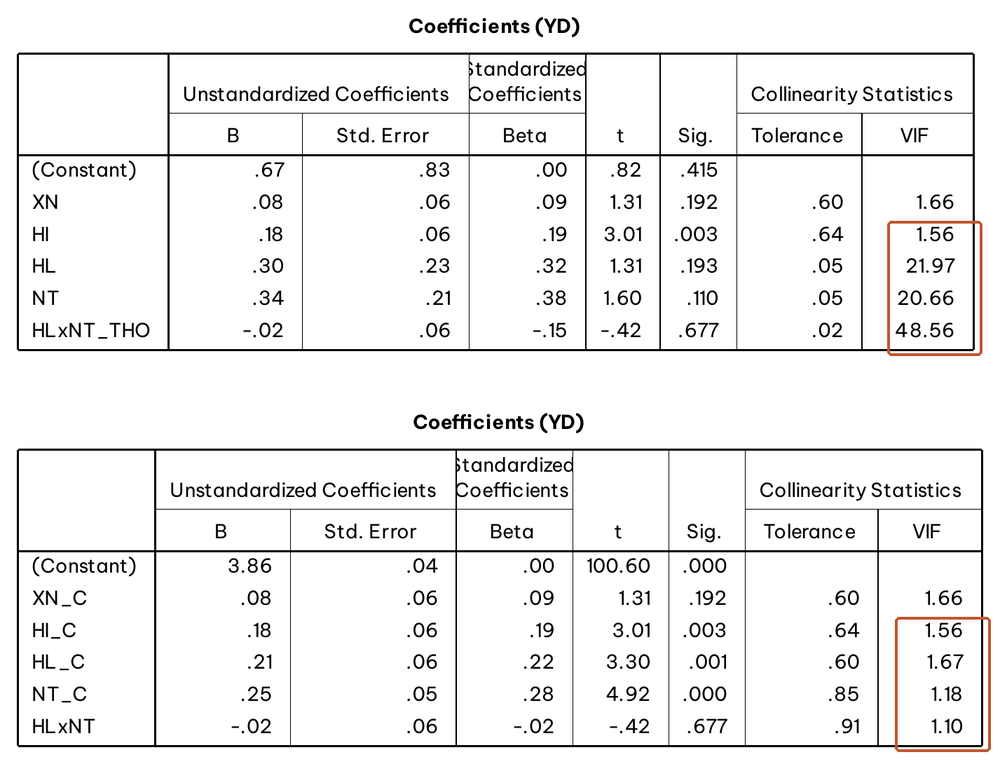
Hình 6. Trên: VIF của HL, NT và biến tích lên tới 22, 21 và 49. Dưới: sau khi chuẩn hóa tâm, VIF chỉ còn 1,1 đến 1,7. Hệ số và t của biến tích (−0,02; t = −0,42) giống hệt nhau ở hai cách.
So sánh hai bảng cho ba bài học:
- VIF giảm mạnh. HL × NT tương quan rất cao với HL và NT khi chưa chuẩn hóa tâm, vì mọi giá trị đều dương (1 đến 5). Đây là đa cộng tuyến "không thiết yếu", sinh ra từ cách đặt gốc tọa độ.
- Kiểm định của biến tích không đổi. Hệ số −0,02, t = −0,42 và p = 0,677 giống hệt nhau. Echambadi và Hess (2007) chỉ ra rằng chuẩn hóa tâm không thay đổi kết luận về tác động điều tiết. Lợi ích chính của nó là giúp diễn giải.
- Hệ số của HL và NT thay đổi ý nghĩa. Khi có biến tích, B₁ là tác động của HL khi NT = 0. Với biến chưa chuẩn hóa tâm, NT = 0 nằm ngoài thang đo 1–5, nên B₁ = 0,30 (p = 0,193) mô tả một tình huống không tồn tại. Sau khi chuẩn hóa tâm, NT_C = 0 nghĩa là Niềm tin ở mức trung bình và B₁ = 0,21 (p = 0,001) là tác động của HL với một khách hàng có niềm tin trung bình.
Kết quả kiểm định
Chạy hai khối trên cùng 263 phiếu (PSPP 2.0 chưa hỗ trợ nhiều khối trong một lệnh, xem bài hồi quy tuyến tính bội) (Bảng 2):
Bảng 2. Hồi quy thứ bậc kiểm định tác động điều tiết.
| Khối | Biến | R² | ΔR² |
|---|---|---|---|
| 1 | XN_C, HI_C, HL_C, NT_C | 0,3150 | |
| 2 | + HLxNT | 0,3154 | 0,0005 |
Biến tích có B = −0,02, 95% KTC [−0,13; 0,09], t = −0,42, p = 0,677. Không có tác động điều tiết: Niềm tin không làm thay đổi tác động của Sự hài lòng đến Ý định mua lại.
4. Độ dốc đơn giản
Khi có tác động điều tiết, bước tiếp theo là tính độ dốc đơn giản (simple slopes): tác động của HL ở các mức NT khác nhau, thường là thấp (−1 SD), trung bình và cao (+1 SD). Dù kết quả ở đây không có ý nghĩa, bài vẫn trình bày kỹ thuật này vì nó cần thiết khi bạn tìm thấy tác động điều tiết.
SPSS thường dùng macro PROCESS của Hayes (2022) để làm việc này tự động. PSPP không chạy được PROCESS, nhưng có thể làm bằng tay theo cách của Aiken và West (1991): dời gốc của NT đến mức cần xét rồi chạy lại hồi quy. Khi đó, hệ số của HL_C chính là độ dốc của HL tại mức NT đó.
COMPUTE NT_THAP = NT_C + SD_NT.
COMPUTE HLxNT_THAP = HL_C * NT_THAP.
REGRESSION /VARIABLES=XN_C HI_C HL_C NT_THAP HLxNT_THAP /DEPENDENT=YD /METHOD=ENTER
  /STATISTICS=COEFF CI(95).
Cộng thêm SD vào NT_C có vẻ ngược, nhưng đúng: biến mới NT_THAP bằng 0 khi NT_C = −SD, tức khi niềm tin thấp hơn trung bình một độ lệch chuẩn. Tương tự, NT_CAO = NT_C − SD_NT (Bảng 3).
Bảng 3. Độ dốc đơn của HL theo ba mức Niềm tin.
| Mức Niềm tin | Độ dốc của HL | 95% KTC | p |
|---|---|---|---|
| Thấp (−1 SD) | 0,23 | 0,07 đến 0,39 | ,004 |
| Trung bình | 0,21 | 0,09 đến 0,34 | ,001 |
| Cao (+1 SD) | 0,19 | 0,04 đến 0,34 | ,013 |
Hình 7 vẽ quan hệ giữa HL và YD ở ba mức Niềm tin.
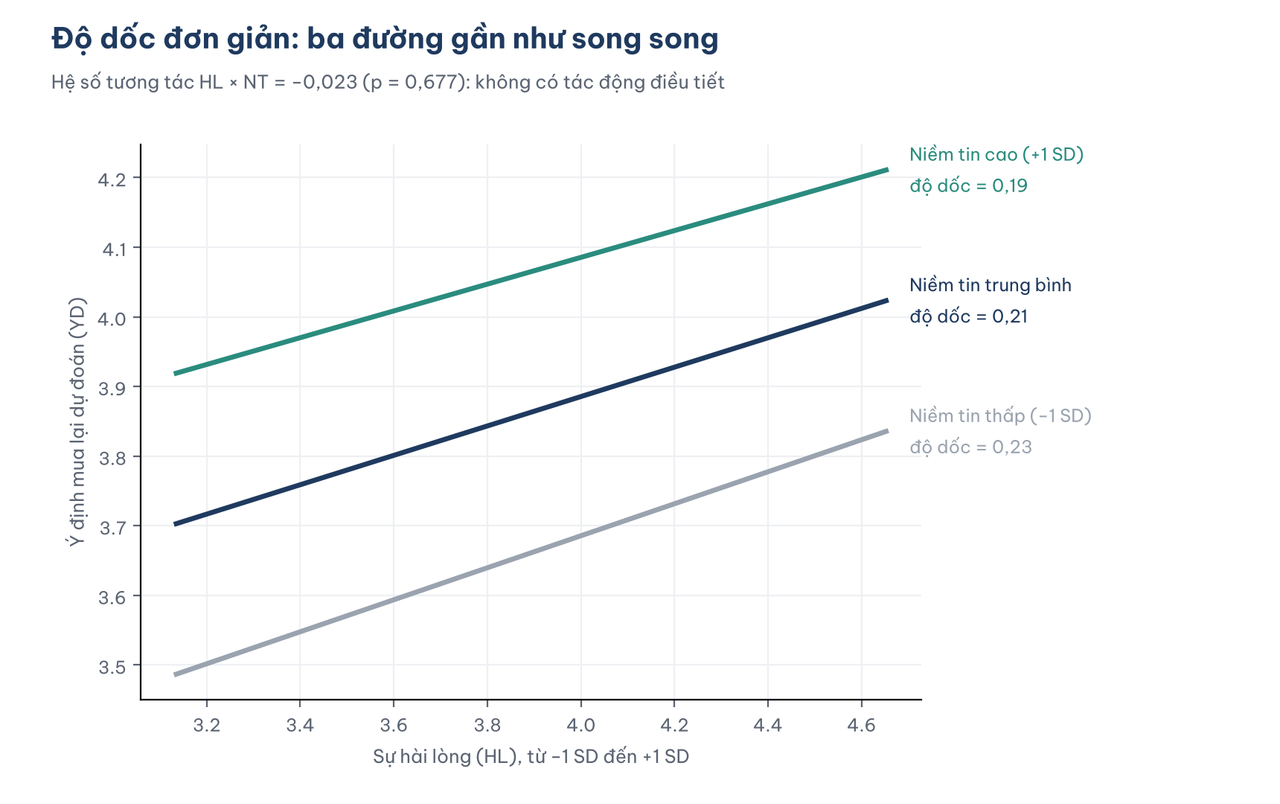
Hình 7. Ba đường gần như song song: tác động của HL như nhau ở mọi mức Niềm tin. Đường cao hơn chỉ phản ánh tác động chính của NT.
Ba độ dốc gần bằng nhau và khoảng tin cậy chồng lên nhau phần lớn, trực quan hóa cho kết luận "không có tác động điều tiết". Khi có tác động điều tiết thật, các đường sẽ có độ dốc khác nhau rõ rệt, có thể cắt nhau. Đồ thị này nên luôn đi kèm khi báo cáo một tác động điều tiết có ý nghĩa (Dawson, 2014).
5. Đọc đúng kết quả không có ý nghĩa
Kết quả "không có tác động điều tiết" cần được diễn giải cẩn thận:
- Không có ý nghĩa không có nghĩa là bằng 0. Khoảng tin cậy [−0,13; 0,09] cho thấy tác động điều tiết, nếu có, là nhỏ. Dữ liệu không đủ để khẳng định không có tác động nào.
- Kiểm định tương tác có lực thống kê thấp. McClelland và Judd (1993) chỉ ra rằng các nghiên cứu khảo sát thường cần cỡ mẫu lớn hơn nhiều để phát hiện tác động tương tác so với tác động chính. Aguinis và cộng sự (2005) tổng kết 30 năm nghiên cứu và thấy hệ số ảnh hưởng điển hình của tác động điều tiết rất nhỏ. Với 263 phiếu, nghiên cứu này chỉ đủ lực để phát hiện tác động điều tiết khá lớn.
- Không "đi tìm" biến điều tiết. Trong quá trình chuẩn bị bài viết, tôi đã thử thêm một số biến điều tiết khác. Một trong số đó (tuổi) cho p = 0,073. Nếu thử 20 biến điều tiết, trung bình sẽ có 1 kết quả "có ý nghĩa" ở mức 0,05 hoàn toàn do ngẫu nhiên. Biến điều tiết phải được đề xuất trước từ lý thuyết. Nếu kiểm định nhiều biến, hãy báo cáo tất cả và điều chỉnh mức ý nghĩa (ví dụ Bonferroni: 0,05 chia cho số kiểm định).
6. Trình bày kết quả trong báo cáo
Đoạn văn mẫu cho biến kiểm soát: "Để kiểm tra độ vững của kết quả, nghề nghiệp (ba biến giả, nhóm tham chiếu là sinh viên) và giới tính (nữ = 1, nam = 0; 4 đáp viên chọn giới tính khác được loại khỏi phân tích này) được thêm vào Mô hình 2 làm biến kiểm soát. Các biến kiểm soát không có tác động có ý nghĩa (ΔR² = 0,005; F(4, 250) = 0,42; p = ,793) và hệ số của các biến chính gần như không thay đổi."
Đoạn văn mẫu cho biến điều tiết: "Tác động điều tiết của Niềm tin lên quan hệ giữa Sự hài lòng và Ý định mua lại được kiểm định bằng hồi quy với biến tích, sau khi chuẩn hóa tâm các biến. Hệ số của biến tích không có ý nghĩa (B = −0,02; KTC 95% [−0,13; 0,09]; p = ,677; ΔR² < 0,001). Tác động của Sự hài lòng có độ lớn tương tự ở các mức Niềm tin thấp (B = 0,23), trung bình (B = 0,21) và cao (B = 0,19). Vì vậy, dữ liệu không ủng hộ vai trò điều tiết của Niềm tin."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi dùng biến giả và kiểm định điều tiết trong luận văn.
- Đưa biến định danh vào hồi quy như biến định lượng, ví dụ đưa thẳng NGHE với các mã 1–4.
- Rơi vào bẫy biến giả khi tạo k biến giả cho k nhóm. Với PSPP, lỗi này không bị chặn mà cho ra các con số vô nghĩa.
- Diễn giải hệ số chính như "tác động chung" khi mô hình có biến tích, trong khi đó là tác động tại mức 0 của biến điều tiết.
- Chỉ báo cáo hệ số biến tích mà không vẽ đồ thị độ dốc đơn giản khi tìm thấy tác động điều tiết.
- Thử nhiều biến điều tiết rồi chỉ báo cáo biến có ý nghĩa.
Tài liệu tham khảo
Aguinis, H., Beaty, J. C., Boik, R. J., & Pierce, C. A. (2005). Effect size and power in assessing moderating effects of categorical variables using multiple regression: A 30-year review. Journal of Applied Psychology, 90(1), 94–107. https://doi.org/10.1037/0021-9010.90.1.94
Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications. https://www.sagepub.com/shop/buy-a-book/multiple-regression-1-3045
Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Applied-Multiple-RegressionCorrelation-Analysis-for-the-Behavioral-Sciences/Cohen-Cohen-West-Aiken/p/book/9780805822236
Dawson, J. F. (2014). Moderation in management research: What, why, when, and how. Journal of Business and Psychology, 29(1), 1–19. https://doi.org/10.1007/s10869-013-9308-7
Echambadi, R., & Hess, J. D. (2007). Mean-centering does not alleviate collinearity problems in moderated multiple regression models. Marketing Science, 26(3), 438–445. https://doi.org/10.1287/mksc.1060.0263
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Hardy, M. A. (1993). Regression with dummy variables. SAGE Publications. https://www.sagepub.com/shop/buy-a-book/regression-with-dummy-variables-1-3924
Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press. https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030
McClelland, G. H., & Judd, C. M. (1993). Statistical difficulties of detecting interactions and moderator effects. Psychological Bulletin, 114(2), 376–390. https://doi.org/10.1037/0033-2909.114.2.376