
BOOTSTRAPPING KIỂM ĐỊNH GIẢ THUYẾT TRONG SMARTPLS 4
Thiết lập bootstrapping trong SmartPLS 4, đọc giá trị p, khoảng tin cậy và chọn kiểm định một phía hay hai phía
Bài nên đọc trước
Bài đánh giá mô hình cấu trúc trong SmartPLS và bài năng lực dự đoán với PLSpredict đã đánh giá đa cộng tuyến, R², f² và năng lực dự đoán của mô hình sàn X. Câu hỏi còn lại là câu hỏi quan trọng nhất của luận văn: bảy giả thuyết H1 đến H7 có được ủng hộ không? Muốn trả lời, cần biết mỗi hệ số đường dẫn có khác 0 có ý nghĩa thống kê hay không. Trong PLS-SEM, việc này làm bằng bootstrapping, bước 2 trong quy trình đánh giá mô hình cấu trúc của Hair và cộng sự (2019).
Bài này giải thích cách bootstrapping hoạt động, cách thiết lập trong SmartPLS 4, cách đọc kết quả và chọn kiểm định một phía hay hai phía, rồi đối chiếu bằng R.
Về hình minh họa và con số. Ảnh chụp thật SmartPLS 4.1.2.1 (Ringle và cộng sự, 2026; bản dùng thử) cho mô hình
mo-hinh-san-xcủa bài nhập dữ liệu và vẽ mô hình trong SmartPLS, Casewise deletion, 254 người. Con số trong bài lấy từ báo cáo của SmartPLS. Mục 5 đối chiếu bằng R (filebootstrap.R, gói cSEM). Bootstrapping có trong giấy phép Student, nhưng giấy phép này chỉ nhận tối đa 100 dòng dữ liệu.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
39-bootstrapping-smartplscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Bootstrapping là gì?
CB-SEM (AMOS, lavaan) tính sai số chuẩn bằng công thức, dựa trên giả định dữ liệu phân phối chuẩn. PLS-SEM không có giả định này nên không có công thức sai số chuẩn. Thay vào đó, sai số chuẩn được ước lượng bằng thực nghiệm:
- Rút ngẫu nhiên có hoàn lại 254 người từ 254 người của mẫu gốc. Một người có thể được rút nhiều lần, người khác không được rút lần nào. Đây là một mẫu bootstrap.
- Ước lượng lại mô hình trên mẫu bootstrap đó, ghi lại bảy hệ số đường dẫn.
- Lặp lại bước 1 và 2 nhiều lần, ví dụ 5000 lần.
- Tính độ lệch chuẩn của 5000 hệ số. Đây là sai số chuẩn của hệ số.
- Lấy điểm cắt 2,5% và 97,5% của 5000 hệ số làm khoảng tin cậy 95% (khoảng tin cậy percentile).
Hệ số có ý nghĩa ở mức 5% khi khoảng tin cậy 95% không chứa 0. Cách đọc tương đương là giá trị t = hệ số / sai số chuẩn lớn hơn 1,96 (kiểm định hai phía), hay p nhỏ hơn 0,05 (Hình 1).
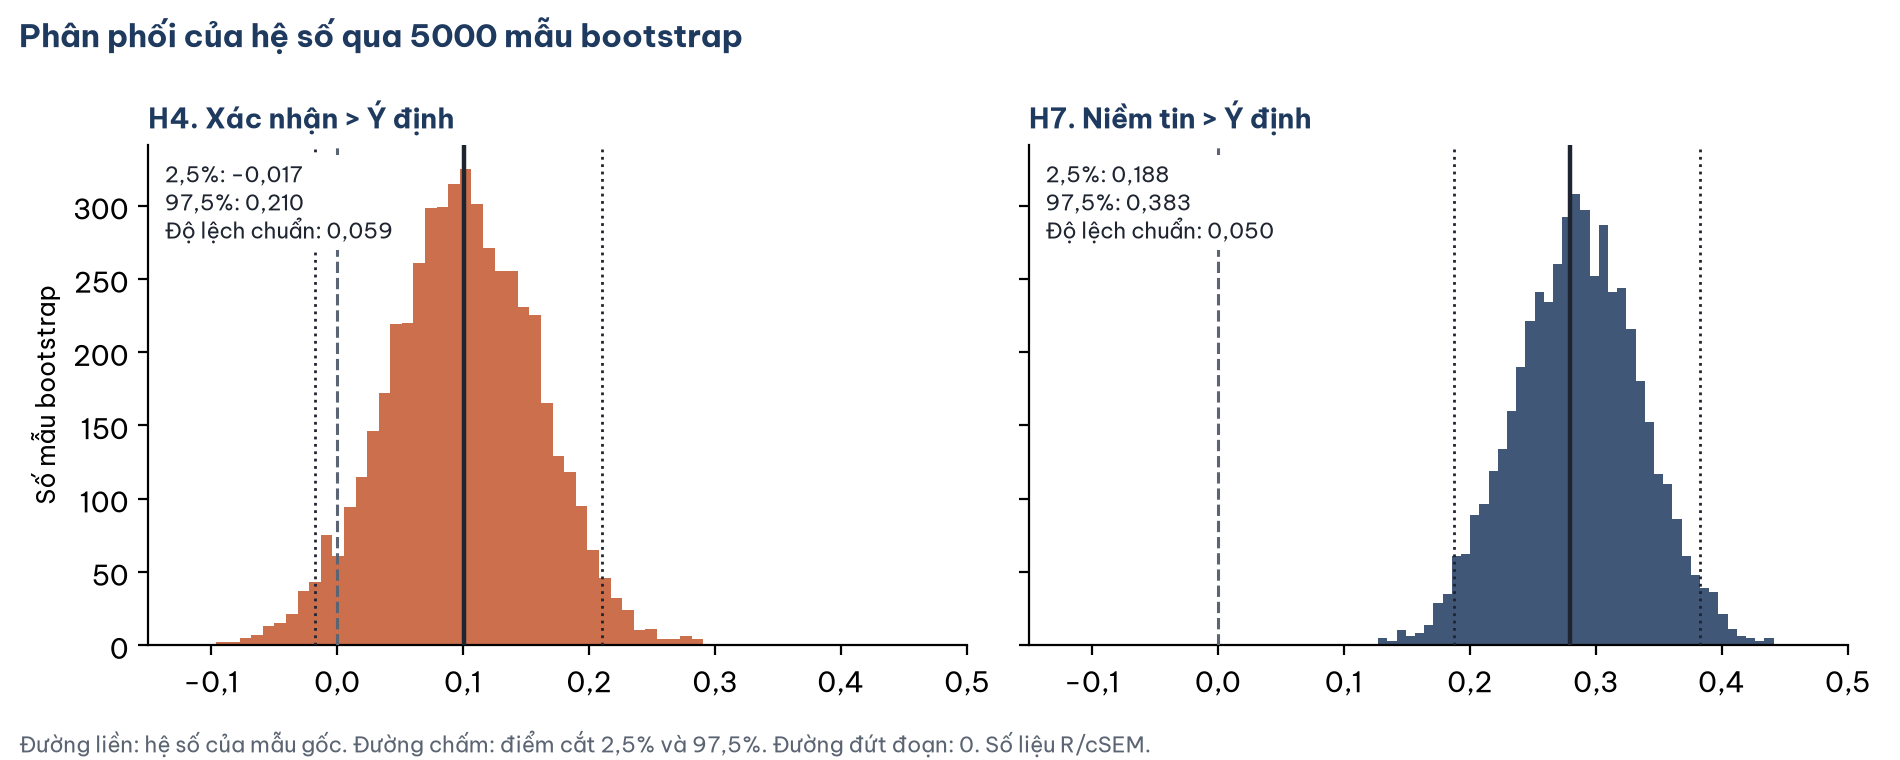
Hình 1. Phân phối của hệ số H4 và H7 qua 5000 mẫu bootstrap (số liệu R, file bootstrap.R). Khoảng giữa hai đường chấm của H4 chứa 0; của H7 thì nằm hẳn bên phải 0.
Hình 1 cho thấy sự khác nhau giữa một đường dẫn không có ý nghĩa và một đường dẫn có ý nghĩa. Với H4, 4,8% mẫu bootstrap (240 trong 5000 mẫu) cho hệ số âm, nên chưa thể loại trừ khả năng hệ số thật bằng 0. Với H7, hệ số nhỏ nhất trong 5000 mẫu vẫn là 0,105, cách xa 0.
2. Chạy bootstrapping trong SmartPLS 4
Bước 1. Mở mô hình mo-hinh-san-x trong project San X. Chọn menu Calculate > Bootstrapping.
Bước 2. Trong thẻ BT setup, kiểm tra năm thiết lập (Hình 2):
- Subsamples: 5000, là số mẫu bootstrap. Đây là mức thường dùng trong nghiên cứu PLS-SEM. Có thể tăng lên 10000 cho kết quả cuối cùng để giá trị p và khoảng tin cậy ổn định hơn (Streukens & Leroi-Werelds, 2016), nhưng thời gian chạy sẽ lâu hơn.
- Confidence interval method: Percentile bootstrap. Khoảng tin cậy percentile được khuyến nghị cho PLS-SEM (Aguirre-Urreta & Rönkkö, 2018; Hair và cộng sự, 2022).
- Test type: Two-tailed, tức kiểm định hai phía (xem mục 4).
- Significance level: 0,05.
- Random number generator: Fixed seed, để chạy lại cho cùng kết quả.
Giữ Amount of results là Most important (faster): báo cáo vẫn có đủ các bảng dùng trong bài này và bài biến trung gian trong SmartPLS.
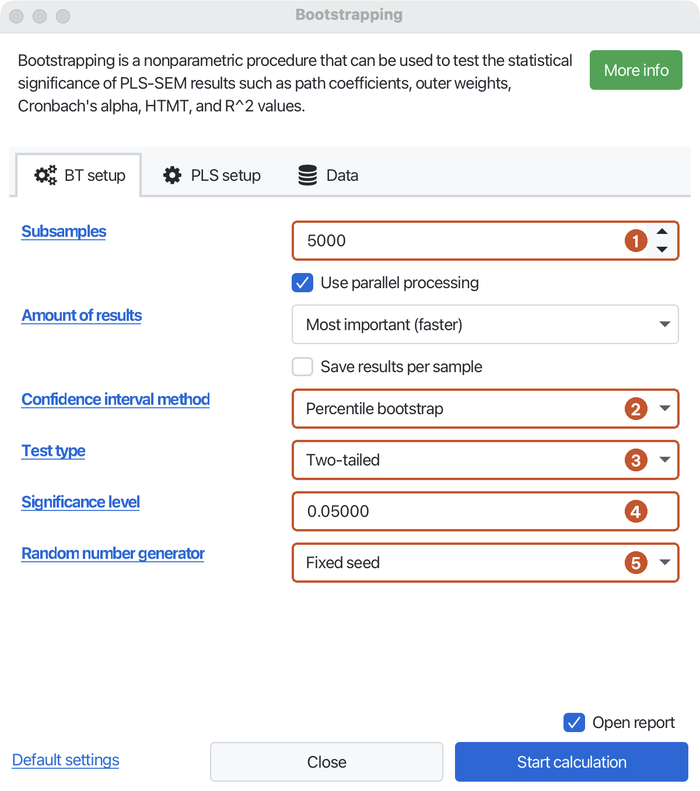
Hình 2. Thẻ BT setup: (1) số mẫu bootstrap, (2) cách tính khoảng tin cậy, (3) kiểm định hai phía, (4) mức ý nghĩa, (5) cách tạo số ngẫu nhiên.
Bước 3. Mở thẻ Data, chọn Missing value algorithm là Casewise deletion, rồi bấm Start calculation (Hình 3). Thẻ PLS setup giữ thiết lập như thuật toán PLS-SEM ở bài nhập dữ liệu và vẽ mô hình trong SmartPLS (Path weighting scheme).
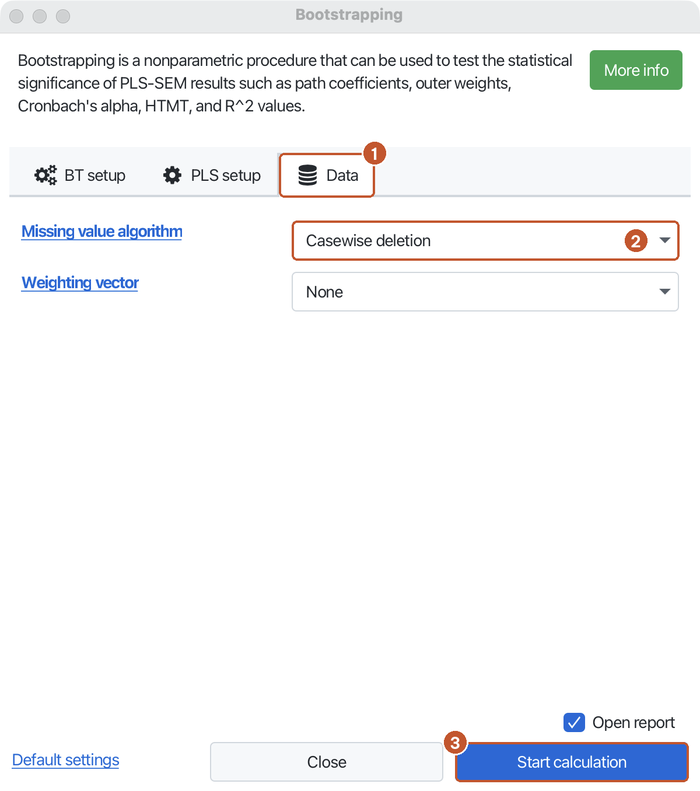
Hình 3. Thẻ Data: (1) thẻ Data, (2) Casewise deletion, (3) nút Start calculation.
Với 5000 mẫu, SmartPLS ước lượng mô hình 5000 lần. Trên máy Mac chip Apple, quá trình này mất vài giây đến vài chục giây.
3. Đọc kết quả
Báo cáo bootstrapping có ba chỗ cần đọc: sơ đồ, bảng hệ số đường dẫn và bảng khoảng tin cậy.
Giá trị p trên sơ đồ
Bước 4. Báo cáo mở ở mục Graphical output (Hình 4). Trong khung Graphical output phía dưới bên trái, chọn Structural model là P values để mỗi đường dẫn hiện giá trị p.
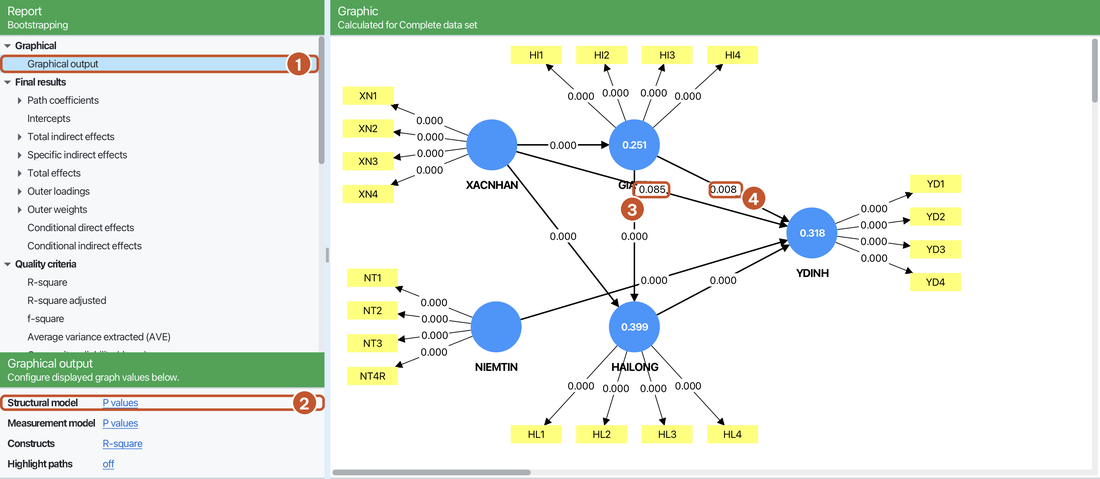
Hình 4. Sơ đồ kết quả bootstrapping: (1) mục Graphical output, (2) hiện giá trị p trên đường dẫn của mô hình cấu trúc, (3) H4 Xác nhận đến Ý định, p = 0,085, (4) H5 Giá trị đến Ý định, p = 0,008. Số trong hình tròn là R².
Sơ đồ giúp nhìn nhanh, nhưng một số nhãn nằm chồng lên nhau (nhãn 0,085 đè lên tên GIATRI). Khi viết bài, nên đọc số từ bảng.
Bảng hệ số đường dẫn
Bước 5. Mở Final results > Path coefficients > Mean, STDEV, T values, p values (Hình 5).
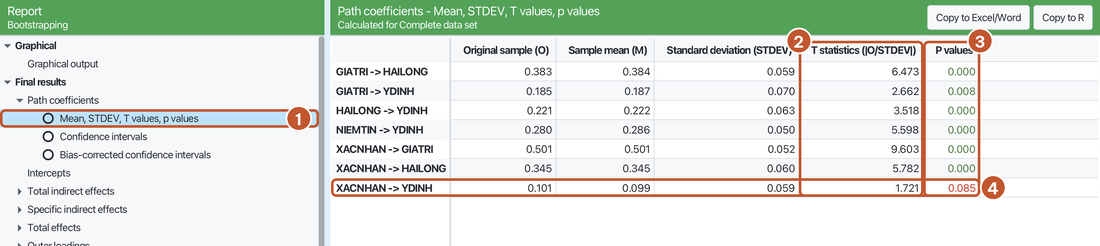
Hình 5. Bảng kiểm định hệ số đường dẫn: (1) mục Mean, STDEV, T values, p values, (2) giá trị t, (3) giá trị p, (4) đường Xác nhận đến Ý định, p = 0,085 nên SmartPLS tô đỏ.
Ý nghĩa các cột:
- Original sample (O): hệ số ước lượng trên mẫu gốc, là hệ số cần báo cáo.
- Sample mean (M): trung bình của 5000 hệ số bootstrap. M gần O cho thấy phân phối bootstrap không lệch nhiều so với hệ số gốc.
- Standard deviation (STDEV): độ lệch chuẩn của 5000 hệ số, tức sai số chuẩn.
- T statistics (|O/STDEV|): giá trị tuyệt đối của O chia cho STDEV.
- P values: giá trị p tương ứng với t.
Tính tay giá trị t của H7 (Niềm tin đến Ý định): t = 0,2805 / 0,0501 = 5,60. SmartPLS báo 5,598 vì dùng hệ số và độ lệch chuẩn chưa làm tròn.
Khoảng tin cậy
Bước 6. Mở Path coefficients > Confidence intervals (Hình 6). Cột 2.5% và 97.5% là giới hạn dưới và trên của khoảng tin cậy percentile 95%.
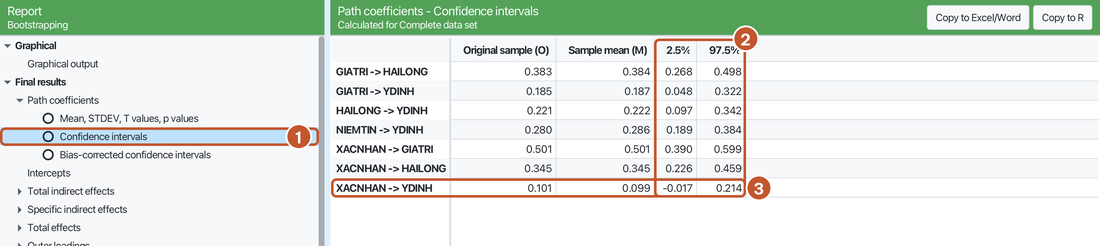
Hình 6. Khoảng tin cậy percentile: (1) mục Confidence intervals, (2) giới hạn 2,5% và 97,5%, (3) khoảng của Xác nhận đến Ý định chứa 0.
Mục Bias-corrected confidence intervals ngay bên dưới là khoảng tin cậy đã hiệu chỉnh độ lệch. Bài này dùng khoảng percentile như đã chọn ở Bước 2.
Kết luận cho bảy giả thuyết
Bảng 1 gom hệ số, giá trị p và khoảng tin cậy của bảy giả thuyết, còn Hình 7 vẽ các khoảng tin cậy này trên cùng một trục.
Bảng 1. Kết quả bootstrapping của bảy giả thuyết.
| Giả thuyết | Hệ số (O) | STDEV | t | p | Khoảng tin cậy 95% | Kết luận |
|---|---|---|---|---|---|---|
| H1. Xác nhận đến Giá trị | 0,501 | 0,052 | 9,603 | < 0,001 | [0,390; 0,599] | Ủng hộ |
| H2. Xác nhận đến Hài lòng | 0,345 | 0,060 | 5,782 | < 0,001 | [0,226; 0,459] | Ủng hộ |
| H3. Giá trị đến Hài lòng | 0,383 | 0,059 | 6,473 | < 0,001 | [0,268; 0,498] | Ủng hộ |
| H4. Xác nhận đến Ý định | 0,101 | 0,059 | 1,721 | 0,085 | [−0,017; 0,214] | Không ủng hộ |
| H5. Giá trị đến Ý định | 0,185 | 0,070 | 2,662 | 0,008 | [0,048; 0,322] | Ủng hộ |
| H6. Hài lòng đến Ý định | 0,221 | 0,063 | 3,518 | < 0,001 | [0,097; 0,342] | Ủng hộ |
| H7. Niềm tin đến Ý định | 0,280 | 0,050 | 5,598 | < 0,001 | [0,189; 0,384] | Ủng hộ |
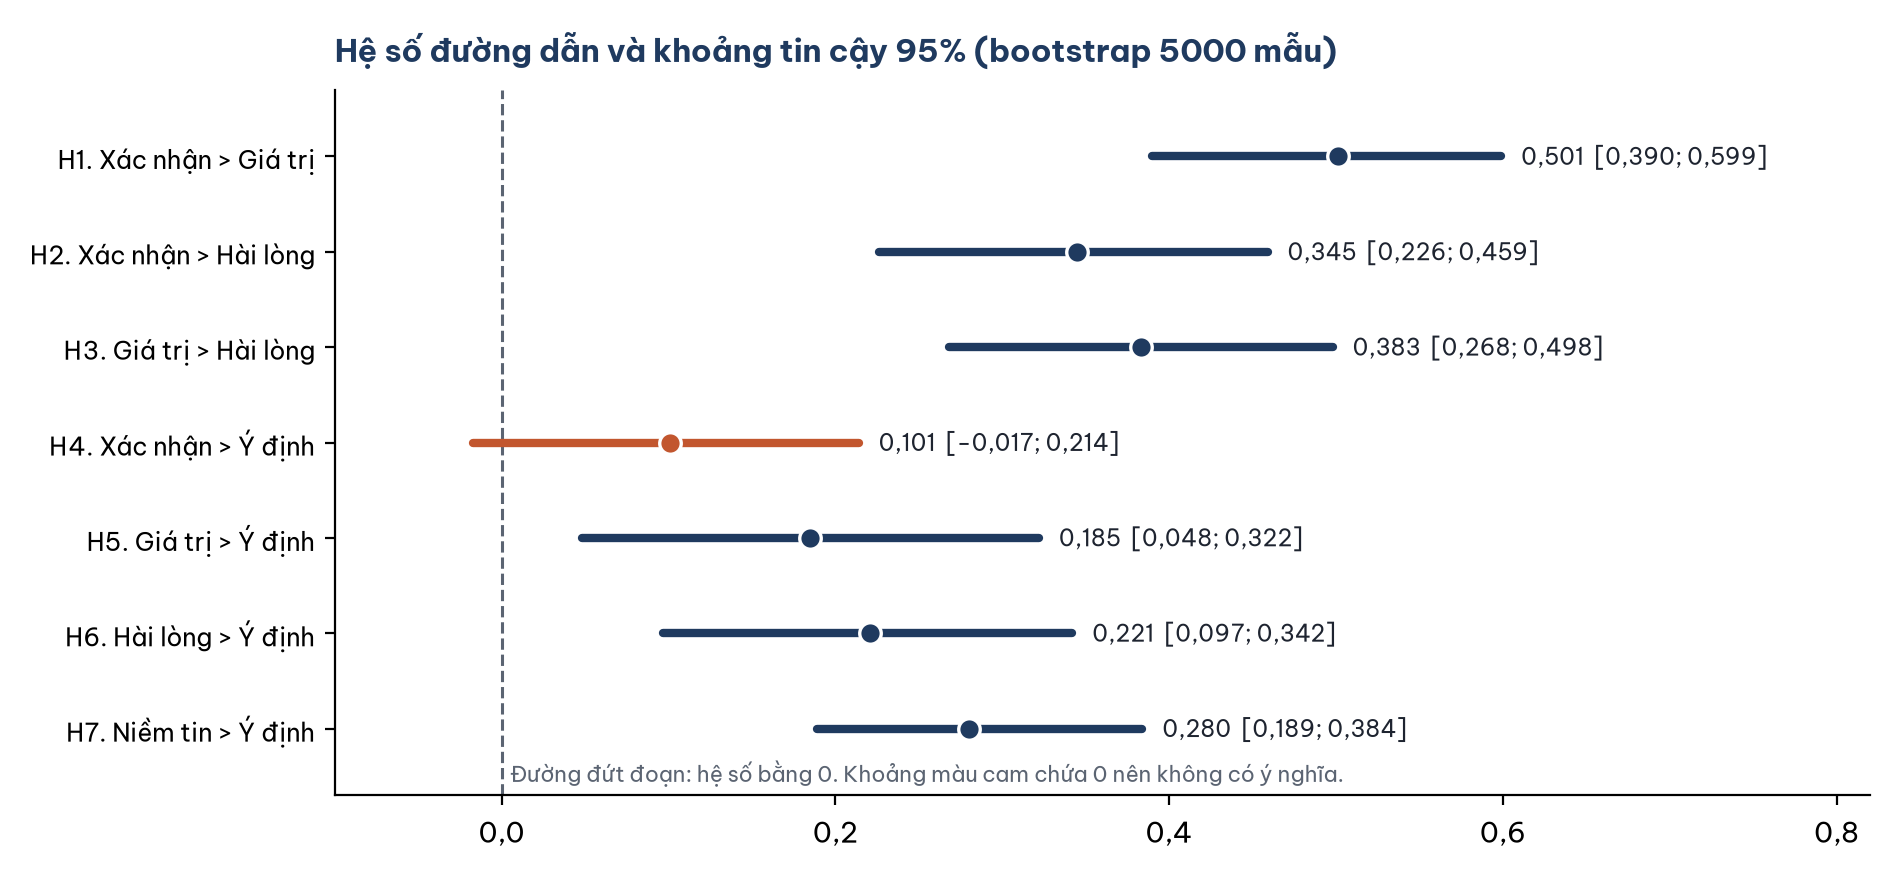
Hình 7. Hệ số đường dẫn (chấm tròn) và khoảng tin cậy percentile 95% (đoạn thẳng) của bảy giả thuyết, số liệu của SmartPLS (Hình 5 và Hình 6).
Đọc kết quả:
- Sáu giả thuyết được ủng hộ. Khoảng tin cậy của H1, H2, H3, H5, H6, H7 nằm hẳn bên phải 0 và p nhỏ hơn 0,01.
- H4 không được ủng hộ (t = 1,721, p = 0,085). Khoảng tin cậy [−0,017; 0,214] chứa 0. Kết quả này khớp với f² = 0,009 ở bài đánh giá mô hình cấu trúc trong SmartPLS và với CB-SEM ở bài SmartPLS và PLS-SEM (p = 0,443).
- H5 có ý nghĩa nhưng khoảng tin cậy rộng [0,048; 0,322]: tác động của Giá trị lên Ý định chắc chắn dương, nhưng có thể chỉ rất nhỏ.
- Ý nghĩa thống kê không phải là độ lớn. H5 có p = 0,008 nhưng f² = 0,032 (nhỏ; bài đánh giá mô hình cấu trúc trong SmartPLS). Báo cáo cả hai.
4. Một phía hay hai phía?
Các giả thuyết H1 đến H7 đều có hướng (tác động dương), nên về lý thuyết có thể dùng kiểm định một phía. Với H4, giá trị p một phía bằng một nửa giá trị hai phía, khoảng 0,043, tức dưới 0,05.
Bài này vẫn kết luận H4 không được ủng hộ, vì hai lý do:
- Kiểm định phải được chọn trước khi xem kết quả. Chuyển sang một phía sau khi thấy p = 0,085 để "cứu" giả thuyết là sai về phương pháp.
- Kiểm định hai phía là mặc định phổ biến trong các nghiên cứu PLS-SEM và thận trọng hơn. Nếu luận văn muốn dùng một phía, cần nêu rõ trong phần phương pháp, trước phần kết quả và áp dụng cho mọi giả thuyết.
Ghi chú thêm trong bài: với kiểm định một phía, H4 sát ngưỡng 0,05. Đây là kết quả sát ngưỡng cần báo cáo trung thực, không bỏ qua và cũng không thổi phồng.
5. Đối chiếu bằng R
File bootstrap.R chạy cùng mô hình bằng gói cSEM: PLS-SEM thông thường, 5000 mẫu, khoảng tin cậy percentile, 254 người. Vì mẫu bootstrap ngẫu nhiên khác SmartPLS, sai số chuẩn và giá trị p chỉ trùng gần đúng (Bảng 2):
Bảng 2. Bootstrapping trong SmartPLS và cSEM.
| Giả thuyết | STDEV SmartPLS | STDEV R | p SmartPLS | p R | Khoảng tin cậy R |
|---|---|---|---|---|---|
| H4 | 0,059 | 0,059 | 0,085 | 0,086 | [−0,017; 0,210] |
| H5 | 0,070 | 0,069 | 0,008 | 0,007 | [0,052; 0,323] |
| H7 | 0,050 | 0,050 | < 0,001 | < 0,001 | [0,188; 0,383] |
Hệ số gốc (O) trùng tuyệt đối vì không phụ thuộc vào mẫu bootstrap. Kết luận cho bảy giả thuyết giống nhau ở hai phần mềm. Hai lần chạy với seed khác nhau trong cùng một phần mềm cũng cho kết quả lệch ở chữ số thứ ba như vậy.
6. Trình bày kết quả
Ý nghĩa của các hệ số đường dẫn được kiểm định bằng bootstrapping với 5000 mẫu, khoảng tin cậy percentile 95%, kiểm định hai phía. Kết quả ủng hộ sáu trong bảy giả thuyết. Xác nhận kỳ vọng tác động dương lên giá trị cảm nhận (hệ số = 0,501; t = 9,603; p < 0,001; 95% CI [0,390; 0,599]) và lên sự hài lòng (hệ số = 0,345; t = 5,782; p < 0,001). Giá trị cảm nhận tác động dương lên sự hài lòng (hệ số = 0,383; p < 0,001) và lên ý định mua lại (hệ số = 0,185; t = 2,662; p = 0,008). Sự hài lòng (hệ số = 0,221; p < 0,001) và niềm tin (hệ số = 0,280; t = 5,598; p < 0,001) tác động dương lên ý định mua lại. Tác động trực tiếp của xác nhận kỳ vọng lên ý định mua lại không có ý nghĩa thống kê (hệ số = 0,101; t = 1,721; p = 0,085; 95% CI [−0,017; 0,214]), nên H4 không được ủng hộ.
Bảng giả thuyết trong luận văn nên có: hệ số (O), t, p, khoảng tin cậy 95%, f² (bài đánh giá mô hình cấu trúc trong SmartPLS) và kết luận. Ghi chú dưới bảng: số mẫu bootstrap, loại khoảng tin cậy, một phía hay hai phía.
Năm lỗi thường gặp
Các lỗi dưới đây thường gặp trong luận văn khi làm bước này.
- Báo cáo Sample mean (M) thay cho Original sample (O). Hệ số cần báo cáo là O.
- Ghi p = 0,000. Giá trị p không bằng 0; ghi p < 0,001.
- Đổi sang kiểm định một phía sau khi xem kết quả để giả thuyết có ý nghĩa (mục 4).
- Dùng quá ít mẫu bootstrap, ví dụ 500. Giá trị p và khoảng tin cậy sẽ dao động nhiều giữa các lần chạy.
- Không ghi thiết lập. Thiếu số mẫu, loại khoảng tin cậy và số phía thì người đọc không kiểm tra lại được.
Tài liệu tham khảo
Aguirre-Urreta, M. I., & Rönkkö, M. (2018). Statistical inference with PLSc using bootstrap confidence intervals. MIS Quarterly, 42(3), 1001–1020. https://doi.org/10.25300/MISQ/2018/13587
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/EBR-11-2018-0203
Ringle, C. M., Wende, S., & Becker, J.-M. (2026). SmartPLS 4 (Version 4.1.2.1) [Computer software]. SmartPLS GmbH. https://www.smartpls.com
Streukens, S., & Leroi-Werelds, S. (2016). Bootstrapping and PLS-SEM: A step-by-step guide to get more out of your bootstrap results. European Management Journal, 34(6), 618–632. https://doi.org/10.1016/j.emj.2016.06.003