
CƠ SỞ DỮ LIỆU VECTOR CHO AI
Tìm theo nghĩa thay vì theo từ, chỉ mục vector hoạt động ra sao và vì sao quản trị dữ liệu vẫn cần
Một chuỗi siêu thị muốn biết khách đang phàn nàn gì về hàng sắp hết hạn. Người phân tích mở bảng đánh giá sản phẩm và viết một câu truy vấn tìm những đánh giá có từ "hạn". Kết quả ra 187 đánh giá, trông khá đầy đủ. Nhưng trong cùng bảng đó còn 107 đánh giá nói đúng chuyện ấy mà không có từ "hạn" nào: "date gần quá", "sắp quá date, không thấy giảm giá". Khách viết theo cách của khách và tìm kiếm theo từ chỉ thấy những gì người tìm đã đoán trước.
Tìm theo nghĩa thay vì theo từ là bài toán mà cơ sở dữ liệu vector (vector database) được sinh ra để giải. Từ năm 2023, cùng với làn sóng ứng dụng mô hình ngôn ngữ lớn, loại cơ sở dữ liệu này trở thành một thành phần quen thuộc trong kiến trúc dữ liệu: nó là nơi lưu tri thức của doanh nghiệp để trợ lý AI tra cứu trước khi trả lời. Nhưng đằng sau tên gọi mới là những ý tưởng khá cũ của ngành truy hồi thông tin, cộng với một kỹ thuật chỉ mục mới và gần như mọi câu hỏi quản trị dữ liệu quen thuộc vẫn còn nguyên giá trị.
Bài viết đi theo trình tự sau. Mục 1 giải thích cách biến văn bản thành vector và đo độ gần bằng cosine, minh họa bằng 2.064 đánh giá sản phẩm của Sen Vàng Mart, một chuỗi siêu thị giả định. Mục 2 giới thiệu vector nhúng, thứ giúp máy nhận ra hai câu gần nghĩa dù không chung từ nào. Mục 3 đo vì sao cần một chỉ mục riêng cho vector khi dữ liệu lớn. Mục 4 so sánh các cách lưu vector trong thực tế. Mục 5 đặt cơ sở dữ liệu vector vào ứng dụng nổi bật nhất của nó là sinh văn bản tăng cường truy xuất (RAG) và những câu hỏi quản trị đi kèm.
1. Từ tìm theo từ đến tìm theo nghĩa
Mục này dựng ý tưởng vector từ con số không, bằng cách đơn giản nhất có thể, để thấy rõ cả sức mạnh lẫn giới hạn của nó.
Ý tưởng nền tảng là biểu diễn mỗi văn bản thành một vector, tức một dãy số, sao cho văn bản giống nhau có vector gần nhau. Mô hình không gian vector này đã được ngành truy hồi thông tin dùng từ nhiều thập kỷ trước khi có AI tạo sinh (Manning và cộng sự, 2008). Cách tạo vector đơn giản nhất là vector đếm từ: lập một từ vựng, rồi với mỗi văn bản, ghi lại mỗi tiếng trong từ vựng xuất hiện bao nhiêu lần. Với 2.064 đánh giá của Sen Vàng Mart, từ vựng gồm 318 tiếng xuất hiện trong ít nhất năm đánh giá, nên mỗi đánh giá trở thành một vector 318 chiều.
Độ gần giữa hai vector thường được đo bằng độ tương tự cosine: lấy tích vô hướng của hai vector (tổng các tích từng cặp thành phần) chia cho tích độ dài của chúng. Kết quả bằng 1 khi hai vector cùng hướng, bằng 0 khi chúng không có thành phần chung nào. Cosine chỉ quan tâm đến hướng chứ không đến độ dài, nên một đánh giá dài và một đánh giá ngắn cùng nói một chuyện vẫn được coi là gần nhau. Hình 1 minh họa ý tưởng này trong không gian hai chiều.
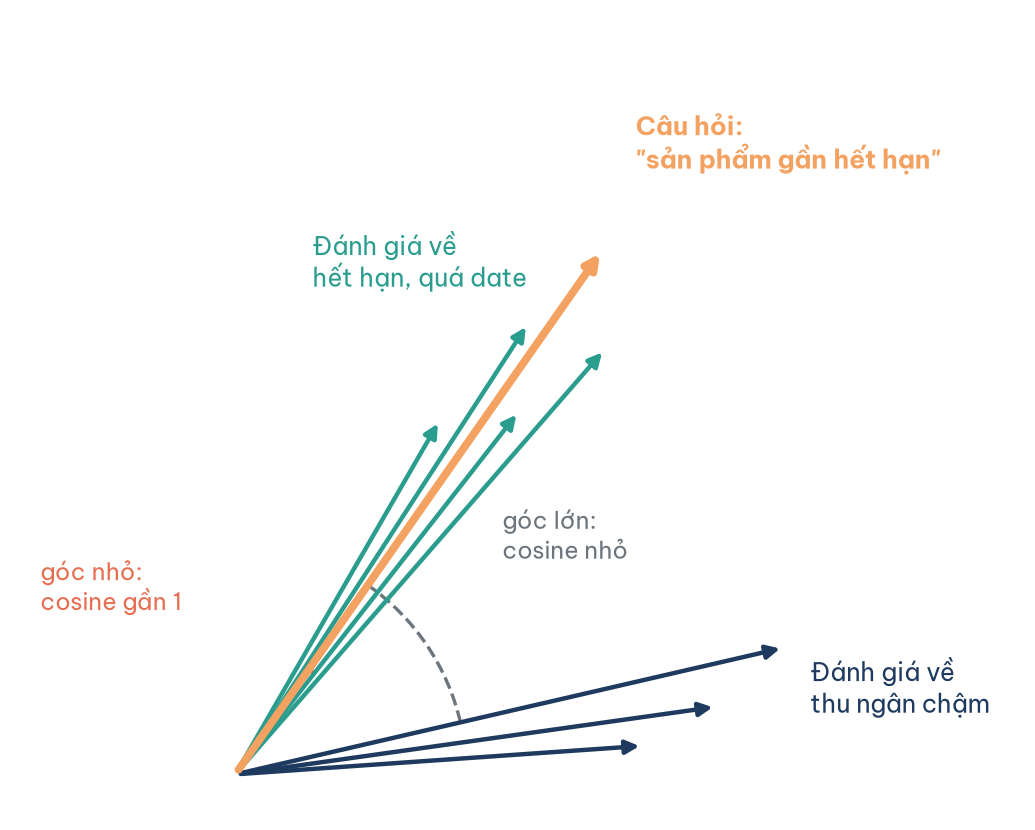
Hình 1. Mỗi văn bản là một mũi tên; văn bản càng gần nghĩa thì góc giữa hai mũi tên càng nhỏ và cosine càng gần 1.
Bảng 1 là kết quả khi đặt câu hỏi "sản phẩm gần hết hạn sử dụng", biến nó thành vector đếm từ và xếp hạng 2.064 đánh giá theo cosine.
Bảng 1. Tìm đánh giá gần câu hỏi "sản phẩm gần hết hạn sử dụng" bằng vector đếm từ
| Hạng | Số sao | Cosine | Đánh giá |
|---|---|---|---|
| 1 | 2 | 0,63 | Hạn sử dụng chỉ còn vài ngày. Hàng gần hết hạn sử dụng mà vẫn bày bán. |
| 4 | 1 | 0,61 | Sản phẩm sắp quá date, không thấy giảm giá. Hàng gần hết hạn sử dụng mà vẫn bày bán. |
| 5 | 2 | 0,60 | Hàng gần hết hạn sử dụng mà vẫn bày bán. |
| 177 | 5 | 0,31 | Sản phẩm đúng như mô tả. |
| 208 | 2 | 0,28 | Mì ly hải sản 65g: sản phẩm sắp quá date, không thấy giảm giá. |
Nguồn: kết quả chạy trên bộ đánh giá mô phỏng của Sen Vàng Mart.
Năm kết quả đầu đúng là phàn nàn về hạn dùng; cả 50 kết quả đầu đều có từ "hạn". Nhưng hai dòng cuối của Bảng 1 lộ ra giới hạn. Không đánh giá nào trong 107 đánh giá chỉ nói "date" lọt vào 50 kết quả đầu; đánh giá cao nhất của nhóm này đứng hạng 208 và nó lên được đó chỉ nhờ chung hai tiếng "sản phẩm" với câu hỏi. Trong khi đó, một lời khen năm sao "Sản phẩm đúng như mô tả" lại đứng hạng 177, cao hơn, cũng vì chung hai tiếng ấy. Đảo câu hỏi thành "hàng sắp quá date" thì kết quả lật ngược: 40 trong 50 kết quả đầu là đánh giá chỉ nói "date". Vector đếm từ chỉ thấy từ, không thấy nghĩa; hai cách nói cùng một ý cho ra hai tập kết quả khác nhau.
2. Vector nhúng: khi máy học được nghĩa
Giới hạn ở Bảng 1 được giải quyết bằng một cách tạo vector khác. Mục này giải thích vector nhúng và những hệ quả thực tế của việc dùng nó.
Vector nhúng (embedding) là vector do một mô hình học máy sinh ra, được huấn luyện trên lượng văn bản rất lớn để những câu gần nghĩa nằm gần nhau, kể cả khi chúng không chung từ nào. Ý tưởng này có từ các mô hình nhúng từ như word2vec, nơi những từ xuất hiện trong ngữ cảnh giống nhau được đặt gần nhau trong không gian vector (Mikolov và cộng sự, 2013). Các mô hình nhúng câu ngày nay biến mỗi đoạn văn thành vài trăm đến vài nghìn số. Với một mô hình như vậy, "date gần quá" và "sắp hết hạn sử dụng" thành hai vector gần nhau và câu hỏi ở mục 1 sẽ tìm ra cả hai nhóm đánh giá.
Dùng vector nhúng kéo theo ba hệ quả mà người làm dữ liệu cần biết. Thứ nhất, vector chỉ so sánh được với vector sinh ra từ cùng một mô hình; đổi mô hình nhúng nghĩa là phải tính lại vector cho toàn bộ kho văn bản. Thứ hai, mỗi con số trong vector không còn mang nghĩa diễn giải được như "số lần xuất hiện của tiếng hạn"; ta biết hai câu gần nhau nhưng không biết chính xác vì sao. Thứ ba, tìm theo nghĩa không thay thế hoàn toàn tìm theo từ. Khi người dùng tìm một mã sản phẩm, một số hợp đồng hay một tên riêng, khớp chính xác vẫn tốt hơn. Vì vậy nhiều hệ thống dùng tìm kiếm lai (hybrid search): chạy song song tìm theo từ khóa và tìm theo vector, rồi trộn hai danh sách kết quả.
3. Vì sao cần một chỉ mục riêng cho vector
Với 2.064 đánh giá, so câu hỏi với từng vector một là đủ nhanh. Mục này đo điều gì xảy ra khi số vector lên tới hàng triệu và cơ sở dữ liệu vector giải quyết bằng cách nào.
Cách tìm chính xác là vét cạn: tính cosine giữa câu hỏi và mọi vector, rồi lấy những vector gần nhất. Thời gian của cách này tăng tỷ lệ thuận với số vector. Cơ sở dữ liệu vector thay vét cạn bằng chỉ mục tìm láng giềng gần đúng (approximate nearest neighbor, ANN). Chỉ mục phổ biến nhất hiện nay là HNSW, một đồ thị nhiều tầng trong đó mỗi vector được nối với vài vector gần nó; khi tìm, thuật toán đi từ tầng trên thưa sang tầng dưới dày, mỗi bước nhảy tới láng giềng gần câu hỏi hơn (Malkov & Yashunin, 2020). Cái giá là "gần đúng": đôi khi chỉ mục bỏ sót một kết quả mà vét cạn tìm được.
Để thấy đánh đổi này bằng số, có thể sinh 10 nghìn, 100 nghìn và 1 triệu vector 384 chiều có cấu trúc cụm giống dữ liệu nhúng thật, rồi so hai cách tìm 10 vector gần nhất. Hình 2 vẽ thời gian mỗi truy vấn.
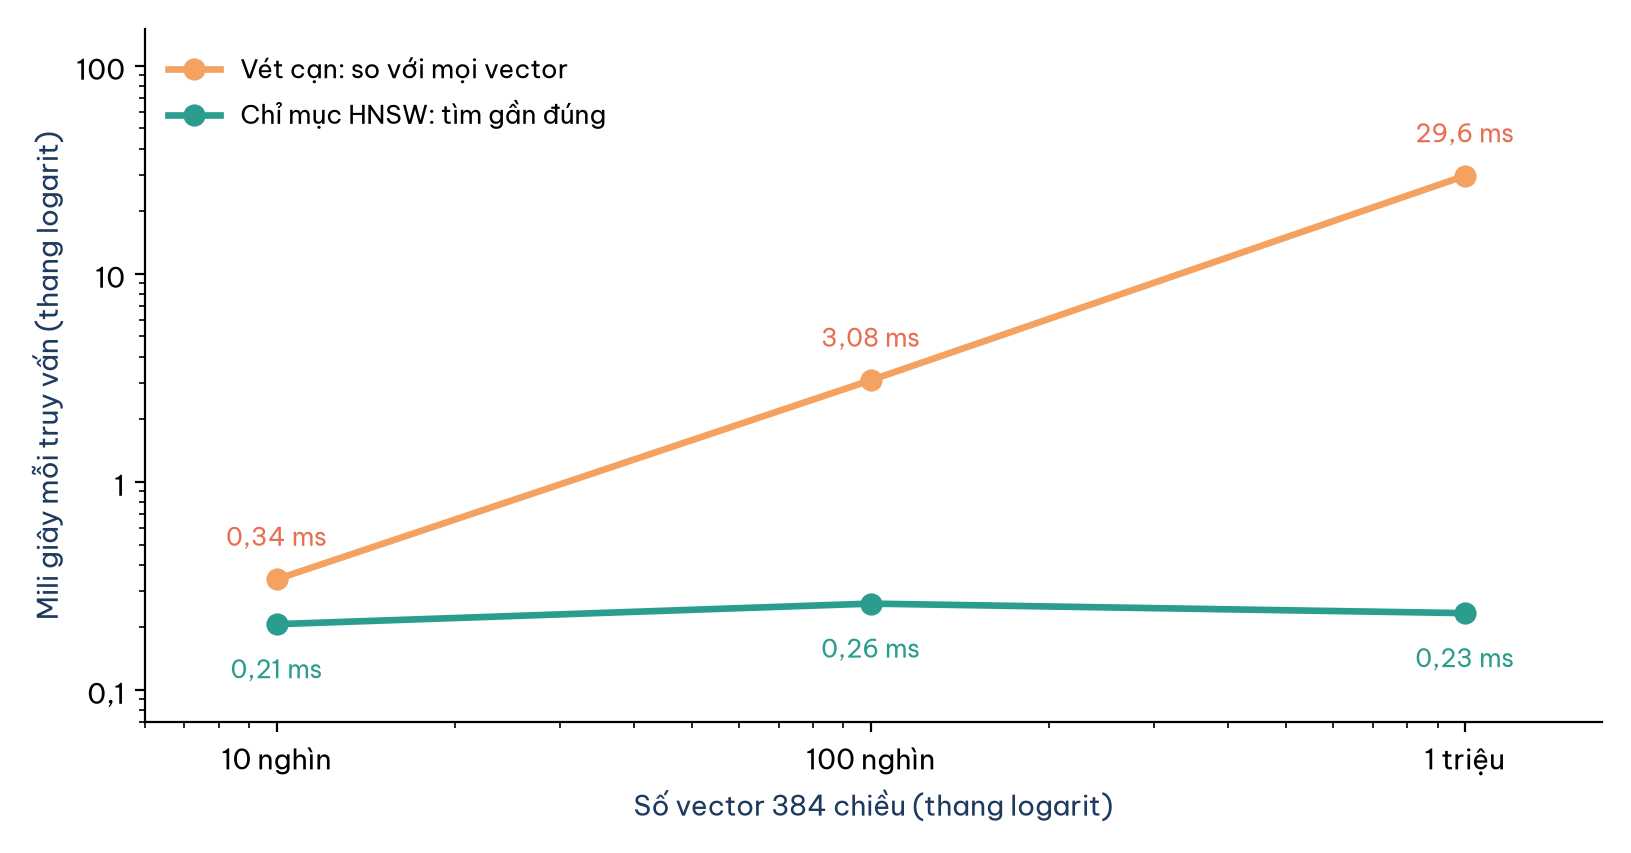
Hình 2. Thời gian tìm 10 vector gần nhất: vét cạn so với chỉ mục HNSW (vector 384 chiều, máy tính xách tay Apple M1 Pro).
Bảng 2 đặt lợi ích và chi phí của chỉ mục cạnh nhau.
Bảng 2. Vét cạn và chỉ mục HNSW trên vector 384 chiều
| Số vector | Dung lượng vector | Vét cạn, mỗi truy vấn | HNSW, mỗi truy vấn | Độ phủ 10 kết quả đầu của HNSW | Thời gian dựng chỉ mục |
|---|---|---|---|---|---|
| 10 nghìn | 15 MB | 0,34 ms | 0,21 ms | 93% | 0,4 giây |
| 100 nghìn | 154 MB | 3,1 ms | 0,26 ms | 100% | 7,6 giây |
| 1 triệu | 1.536 MB | 29,6 ms | 0,23 ms | 91% | 56 giây |
Nguồn: đo bằng NumPy và thư viện hnswlib (tham số M = 16, ef = 64), dữ liệu sinh ngẫu nhiên có cấu trúc cụm. Độ phủ là tỷ lệ trong 10 kết quả thật sự gần nhất mà chỉ mục tìm được.
Bảng 2 cho ba bài học. Thứ nhất, với vài chục nghìn vector, vét cạn hoàn toàn đủ dùng; nhiều dự án thử nghiệm không cần cơ sở dữ liệu vector nào, chỉ cần một cột lưu vector và một phép nhân ma trận. Thứ hai, từ vài trăm nghìn vector trở lên, khi hệ thống phải phục vụ nhiều người dùng cùng lúc, chỉ mục bắt đầu đáng giá: ở 1 triệu vector, HNSW nhanh hơn khoảng 130 lần. Thứ ba, chỉ mục có giá: mất gần một phút để dựng, chiếm thêm bộ nhớ và trong thí nghiệm này bỏ sót trung bình khoảng một trong mười kết quả gần nhất ở quy mô 1 triệu vector. Mức bỏ sót đó điều chỉnh được bằng tham số, đổi lại chậm hơn; với tìm đánh giá khách hàng thì chấp nhận được, với tìm tiền lệ pháp lý thì có thể không.
Bảng 2 cũng cho thấy vector chiếm dung lượng đáng kể: 1 triệu đoạn văn với vector 384 chiều đã cần khoảng 1,5 GB chỉ để lưu vector, chưa kể chỉ mục và văn bản gốc. Với mô hình nhúng 1.536 chiều, con số gấp bốn. Dung lượng này cần được tính vào chi phí khi chọn mô hình nhúng.
4. Lưu vector ở đâu
Thị trường cơ sở dữ liệu vector phát triển rất nhanh và tên sản phẩm thay đổi liên tục. Mục này không xếp hạng sản phẩm mà chia các lựa chọn thành ba nhóm, kèm tiêu chí chọn.
Nhóm thứ nhất là phần mở rộng của cơ sở dữ liệu đang dùng. PostgreSQL có phần mở rộng pgvector thêm kiểu dữ liệu vector, các phép đo khoảng cách và chỉ mục HNSW ngay trong cơ sở dữ liệu quan hệ (pgvector, n.d.); DuckDB và SQLite cũng có phần mở rộng tương tự. Nhóm thứ hai là cơ sở dữ liệu vector chuyên dụng, được thiết kế riêng cho việc lưu và tìm hàng trăm triệu đến hàng tỷ vector, thường có cả dịch vụ đám mây được quản lý. Nhóm thứ ba là công cụ tìm kiếm vốn mạnh về tìm theo từ khóa, nay bổ sung tìm theo vector, thuận lợi cho tìm kiếm lai. Bảng 3 so sánh ba nhóm.
Bảng 3. Ba nhóm lựa chọn lưu và tìm vector
| Nhóm | Thế mạnh | Hạn chế | Phù hợp khi |
|---|---|---|---|
| Phần mở rộng của cơ sở dữ liệu quan hệ | Vector nằm cạnh dữ liệu nghiệp vụ; dùng chung giao dịch, phân quyền, sao lưu; lọc bằng SQL | Quy mô và tốc độ thấp hơn hệ chuyên dụng ở mức rất lớn | Đến vài chục triệu vector; đội ngũ đã quen cơ sở dữ liệu đó |
| Cơ sở dữ liệu vector chuyên dụng | Quy mô rất lớn; nhiều loại chỉ mục; dịch vụ được quản lý | Thêm một hệ thống phải đồng bộ, phân quyền, giám sát | Hàng trăm triệu vector trở lên; tìm kiếm là sản phẩm lõi |
| Công cụ tìm kiếm có tìm vector | Tìm kiếm lai từ khóa và vector trong một nơi | Vận hành phức tạp; ít hợp với dữ liệu giao dịch | Đã có hạ tầng tìm kiếm; cần khớp chính xác lẫn theo nghĩa |
Tiêu chí quan trọng nhất thường không phải tốc độ mà là lọc theo thuộc tính. Câu hỏi thật hiếm khi là "tìm đoạn văn gần nhất" mà là "tìm đoạn văn gần nhất trong các chính sách còn hiệu lực, thuộc phòng ban mà người hỏi được xem". Nếu vector nằm ở một hệ thống, còn ngày hiệu lực và quyền xem nằm ở hệ thống khác, việc lọc trở nên khó và dễ sai. Đó là lý do nhiều doanh nghiệp vừa và nhỏ bắt đầu bằng phần mở rộng của cơ sở dữ liệu đang dùng và chỉ tách ra hệ chuyên dụng khi quy mô thật sự đòi hỏi.
5. RAG và những câu hỏi dữ liệu cũ
Ứng dụng nổi bật nhất của cơ sở dữ liệu vector hiện nay là làm "trí nhớ" cho trợ lý AI. Mục này mô tả cơ chế đó và chỉ ra rằng phần lớn rủi ro của nó là rủi ro dữ liệu, không phải rủi ro AI.
Sinh văn bản tăng cường truy xuất (retrieval-augmented generation, RAG) hoạt động như sau: trước khi mô hình ngôn ngữ lớn trả lời, hệ thống biến câu hỏi thành vector, tìm trong cơ sở dữ liệu vector những đoạn tài liệu gần nhất, rồi đưa các đoạn đó cho mô hình làm căn cứ (Lewis và cộng sự, 2020). Một trợ lý trên ứng dụng của Sen Vàng Mart trả lời "sữa chua loại nào ít bị chê về hạn dùng?" bằng cách truy xuất các đánh giá liên quan rồi tóm tắt chúng. Cơ chế này giúp mô hình trả lời dựa trên tài liệu của doanh nghiệp thay vì dựa trên trí nhớ chung của nó, nhưng không loại bỏ hoàn toàn việc mô hình nói sai; bài Vì sao AI tạo sinh bị ảo giác và cách phòng phân tích giới hạn này từ phía mô hình.
Nhìn từ phía dữ liệu, cơ sở dữ liệu vector chỉ là một loại cơ sở dữ liệu nữa và mọi câu hỏi quản trị quen thuộc vẫn còn nguyên. Bảng 4 gom các câu hỏi đó lại.
Bảng 4. Câu hỏi quản trị dữ liệu cho một hệ thống RAG
| Câu hỏi | Vì sao quan trọng | Cách làm thường gặp |
|---|---|---|
| Tài liệu nào được đưa vào và ai sở hữu nó? | Trợ lý trả lời từ mọi thứ nó tìm thấy, kể cả bản nháp | Danh mục nguồn có người chịu trách nhiệm cho từng nguồn |
| Tài liệu có còn đúng không? | Chính sách đổi trả đã hết hiệu lực vẫn nằm trong kho vector | Lưu ngày hiệu lực kèm vector; quy trình cập nhật và xóa khi nguồn đổi |
| Ai được thấy đoạn nào? | Trợ lý có thể trích lương của người khác cho người hỏi | Lọc theo quyền của người hỏi ngay trong câu truy vấn vector |
| Tài liệu được cắt thành đoạn thế nào? | Đoạn quá ngắn mất ngữ cảnh, đoạn quá dài làm loãng kết quả | Cắt theo cấu trúc tài liệu; thử nghiệm và đo trên câu hỏi thật |
| Đổi mô hình nhúng thì sao? | Vector của hai mô hình không so sánh được | Ghi phiên bản mô hình kèm vector; kế hoạch tính lại toàn bộ |
| Có dữ liệu cá nhân trong tài liệu không? | Vector và văn bản gốc đều chứa thông tin có thể nhận diện người | Áp dụng cùng quy định bảo vệ dữ liệu như với cơ sở dữ liệu khác |
Dòng thứ hai của Bảng 4 là nơi nhiều dự án vấp nhất. Một cơ sở dữ liệu quan hệ được thiết kế tốt có khóa, ràng buộc và quy trình cập nhật; một kho vector được dựng vội cho bản trình diễn thường chỉ là một lần nạp toàn bộ thư mục tài liệu, không ai nhớ cập nhật. Khi trợ lý AI trả lời khách bằng một chính sách đổi trả đã hết hiệu lực, đó là lỗi dữ liệu chứ không phải lỗi AI và nó được phòng bằng đúng những công cụ đã quen: quy trình nạp lũy đẳng, kiểm thử sau nạp, phân quyền. Bài ETL là gì và cách nạp dữ liệu vào kho trình bày các công cụ đó cho kho dữ liệu; chúng áp dụng gần như nguyên vẹn cho kho vector.
Kết luận
Cơ sở dữ liệu vector giải một bài toán thật: tìm theo nghĩa thay vì theo từ. Thí nghiệm với 2.064 đánh giá cho thấy vì sao bài toán đó quan trọng: 107 lời phàn nàn về hạn dùng bị bỏ sót chỉ vì khách viết "date" thay cho "hạn". Vector nhúng lấp khoảng trống này và chỉ mục gần đúng như HNSW giữ cho việc tìm kiếm nhanh ở quy mô hàng triệu vector, đổi lại một chút độ chính xác và chi phí dựng chỉ mục.
Nhưng bên dưới công nghệ mới là những nguyên tắc cũ. Với dữ liệu nhỏ, một cột vector và phép tính vét cạn là đủ; với dữ liệu lớn, chọn nơi lưu nên dựa vào khả năng lọc theo quyền và theo thời hiệu hơn là vào tốc độ trên bảng xếp hạng. Và chất lượng câu trả lời của một trợ lý AI không thể tốt hơn chất lượng của kho tài liệu mà nó tra cứu. Một doanh nghiệp đã quản trị tốt cơ sở dữ liệu quan hệ và kho dữ liệu của mình đang có sẵn phần lớn năng lực cần để quản trị một cơ sở dữ liệu vector.
Đọc thêm
- Vì sao AI tạo sinh bị ảo giác và cách phòng
- ETL là gì và cách nạp dữ liệu vào kho
- Đo chất lượng dữ liệu theo sáu chiều
- Trí tuệ nhân tạo cho dữ liệu văn phòng
- Kho dữ liệu là gì và khi nào doanh nghiệp cần nó
Tài liệu tham khảo
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. In Advances in Neural Information Processing Systems 33 (pp. 9459–9474). https://proceedings.neurips.cc/paper/2020/hash/6b493230205f780e1bc26945df7481e5-Abstract.html
Malkov, Y. A., & Yashunin, D. A. (2020). Efficient and robust approximate nearest neighbor search using hierarchical navigable small world graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4), 824–836. https://doi.org/10.1109/TPAMI.2018.2889473
Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to information retrieval. Cambridge University Press. https://nlp.stanford.edu/IR-book/
Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient estimation of word representations in vector space (arXiv:1301.3781). arXiv. https://doi.org/10.48550/arXiv.1301.3781
pgvector. (n.d.). pgvector: Open-source vector similarity search for Postgres. GitHub. https://github.com/pgvector/pgvector