
DỰ BÁO CHUỖI THỜI GIAN CHO DOANH NGHIỆP
Chọn đúng thứ để dự báo, chọn phương pháp theo mẫu hình chuỗi và kiểm tra dự báo như khi dùng thật
Sáu Phố, một chuỗi cà phê giả định, cần xếp ca cho cửa hàng CH03 trong tuần tới. Việc xếp ca nào cũng bắt đầu bằng một con số: tuần tới, mỗi ca sẽ có bao nhiêu ly khách muốn mua. Người quản lý mở báo cáo doanh số, lấy số ly bán được của các tuần trước và tính trung bình. Phép tính đơn giản, nhanh và sai theo một cách không ai nhận ra.
Từ tháng Bảy, ca Trưa của CH03 thiếu một nhân viên. Khách đặt qua ứng dụng bị hủy đơn vì làm không kịp, khách tại quầy thấy xếp hàng dài thì bỏ về. Số ly bán được vì thế thấp hơn số ly khách muốn mua. Dự báo trên số ly bán được nghĩa là dự báo chính sự thiếu hụt năng lực phục vụ; lịch ca xếp theo dự báo ấy lại thiếu người, lại mất khách và dự báo tuần sau còn thấp hơn.
Dự báo chuỗi thời gian (time series forecasting) là việc dự đoán giá trị tương lai của một biến dựa trên chính lịch sử của nó (Hyndman & Athanasopoulos, 2021). Bài viết gồm năm mục. Mục 1 nêu các thành phần của chuỗi thời gian và năm mẫu hình thường gặp. Mục 2 so sánh các phương pháp đơn giản. Mục 3 bàn quyết định quan trọng nhất trước mọi mô hình: dự báo cái gì. Mục 4 trình bày cách kiểm tra dự báo như khi dùng thật. Mục 5 bàn cách trình bày dự báo để người ra quyết định dùng nó.
1. Thành phần và mẫu hình của chuỗi thời gian
Khác với hồi quy dùng nhiều biến giải thích, phân tích chuỗi thời gian thường chỉ dùng một biến, chính lịch sử của nó. Khái niệm cốt lõi là tính bền vững (persistence): khả năng các xu hướng trong quá khứ tiếp tục trong tương lai. Đây là giả định ngầm của mọi dự báo chuỗi thời gian; doanh số thường có tính bền vững cao hơn lợi nhuận ròng, nên dự báo doanh số thường chính xác hơn dự báo lợi nhuận.
Một chuỗi thời gian thường gồm các thành phần: xu hướng (hướng đi dài hạn), mùa vụ (biến động lặp lại theo chu kỳ cố định như tuần, tháng, quý), chu kỳ dài hơn và nhiễu ngẫu nhiên. Bước đầu tiên của mọi bài dự báo là vẽ chuỗi lên và gọi tên mẫu hình của nó, vì mỗi mẫu hình gọi một họ phương pháp khác nhau (Camm et al., 2024). Hình 1 minh họa năm mẫu hình thường gặp.
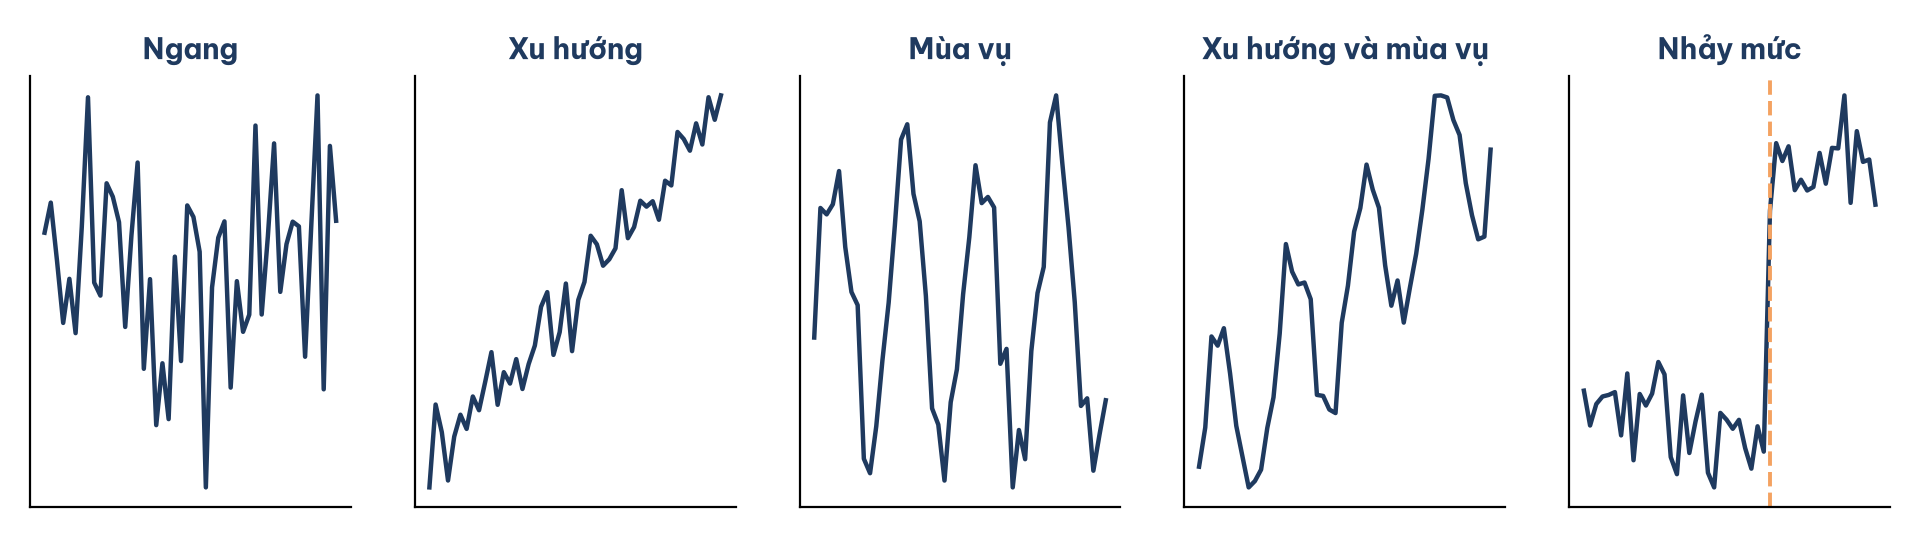
Hình 1. Năm mẫu hình chuỗi thời gian thường gặp (dữ liệu minh họa). Nguồn: dựa trên Camm et al. (2024).
Mẫu hình cuối trong Hình 1 đáng chú ý nhất với doanh nghiệp. Chuỗi nhảy mức đổi hẳn mức trung bình sau một sự kiện như hợp đồng mới, cửa hàng đối thủ mở bên cạnh hay đổi giá, khiến phần lịch sử trước sự kiện gần như vô dụng cho dự báo. Một dự báo dựa trên trung bình dài hạn của chuỗi nhảy mức sẽ sai lệch kéo dài cho tới khi lịch sử mới đủ dài để lấn át lịch sử cũ.
2. Các phương pháp đơn giản và khi nào chúng thắng
Với chuỗi dao động quanh một mức ổn định, các phương pháp đơn giản cạnh tranh nhau. Camm et al. (2024) so sánh bốn cách trên 12 tuần doanh số xăng của một trạm, dao động quanh khoảng 19.250 gallon mỗi tuần. Dự báo ngây thơ (naive) lấy nguyên tuần trước làm dự báo tuần này. Trung bình mọi quan sát quá khứ lấy trung bình toàn bộ lịch sử. Trung bình trượt lấy trung bình vài tuần gần nhất, ở đây là ba tuần. Làm mượt hàm mũ lấy trung bình có trọng số giảm dần về quá khứ, điều khiển bằng hệ số α. Bảng 1 so sánh sai số.
Bảng 1. Bốn phương pháp trên cùng chuỗi doanh số xăng 12 tuần
| Phương pháp | MAE (nghìn gallon) | MAPE |
|---|---|---|
| Ngây thơ, lấy tuần trước | 3,73 | 19,2% |
| Trung bình mọi quan sát quá khứ | 2,44 | 12,9% |
| Trung bình trượt 3 tuần | 2,67 | 14,4% |
Nguồn: Camm et al. (2024). MAE là sai số tuyệt đối bình quân; MAPE là sai số phần trăm tuyệt đối bình quân.
Trên chuỗi ngang này, trung bình dài hạn thắng các phương pháp "nhanh nhạy", vì chuỗi chỉ dao động quanh một mức và nhớ càng dài thì càng ít bị nhiễu kéo đi. Nhưng khi trạm ký hợp đồng cung cấp mới và doanh số nhảy lên quanh 31.000 gallon mỗi tuần, trung bình dài hạn thích nghi chậm nhất, còn dự báo ngây thơ thích nghi ngay. Trung bình trượt và làm mượt hàm mũ nằm giữa và tham số của chúng, số tuần trong cửa sổ hay hệ số α, chính là nút vặn giữa "nhớ lâu" và "phản ứng nhanh". Không có phương pháp tốt nhất tuyệt đối; chỉ có phương pháp hợp với mẫu hình của chuỗi và mẫu hình có thể đổi.
Khi chuỗi có mùa vụ, có thể đưa mùa vụ vào hồi quy bằng biến giả theo quý hoặc tháng, cộng một biến thời gian cho xu hướng, như bài Hồi quy trong thống kê và học máy trình bày. Các phương pháp phức tạp hơn như làm mượt Holt–Winters hay họ ARIMA mở rộng cùng ý tưởng (Hyndman & Athanasopoulos, 2021). Nhưng có một phát hiện thực nghiệm đáng nhớ từ các nghiên cứu so sánh trên hàng nghìn chuỗi: mô hình phức tạp không chắc dự báo tốt hơn mô hình đơn giản và dự báo ngây thơ đôi khi thắng cả mô hình tinh vi (Albright & Winston, 2025). Hệ quả thực hành: mọi mô hình dự báo mới phải thắng mốc ngây thơ và mốc mùa vụ đơn giản trên dữ liệu chưa thấy trước khi được tin. Các công cụ như Forecast Sheet của Excel tự động hóa nhiều bước, nhưng không tự làm bước so sánh ấy.
3. Chọn đúng thứ để dự báo
Quyết định quan trọng nhất của một bài dự báo nằm trước mọi mô hình: biến mục tiêu là gì. Ở Sáu Phố, lựa chọn tự nhiên là số ly bán được, vì nó nằm sẵn trong báo cáo doanh thu. Nhưng từ khi ca Trưa thiếu người, số ly bán được thấp hơn nhu cầu chính vì cửa hàng phục vụ không kịp. Đo bằng cùng một mô hình, đổi biến mục tiêu từ ly nhu cầu sang ly bán làm dự báo ca Trưa thấp hơn 11,8%, trong khi các ca khác chỉ lệch khoảng 2%.
Vì vậy dự án dùng ly nhu cầu: ly tại quầy cộng ly đặt qua ứng dụng, kể cả các đơn bị hủy. Cách này sửa được phần ứng dụng, nhưng không sửa được phần tại quầy, vì khách bỏ về không để lại dấu vết. Phần ấy phải ước lượng riêng bằng cách so với một nhóm cửa hàng không bị thiếu người; ở Sáu Phố, nhu cầu tại quầy ca Trưa bị đếm thiếu khoảng 9,3%.
Cạm bẫy của mục này có tên là nhu cầu bị kiểm duyệt (censored demand). Mọi doanh nghiệp có giới hạn năng lực, như số bàn, số nhân viên hay hàng tồn kho, đều gặp nó: dữ liệu bán hàng chỉ ghi phần nhu cầu đã được đáp ứng (Talluri & van Ryzin, 2004). Khi năng lực đủ, hai thứ trùng nhau và không ai để ý; khi năng lực thiếu, doanh số bằng năng lực chứ không bằng nhu cầu và mô hình dự báo học thuộc lòng sự thiếu hụt ấy. Dấu hiệu nhận biết là doanh số đi ngang đáng ngờ đúng lúc lẽ ra phải cao điểm, hoặc đi kèm hết hàng, hủy đơn, thời gian chờ tăng. Cách xử lý là tìm một cột ghi nhu cầu trước khi bị cắt như đơn đặt, lượt truy cập, yêu cầu báo giá. Đây là một dạng thiên kiến sống sót, như bài Năm nguồn thiên kiến trong dữ liệu phân tích.
4. Kiểm tra dự báo như khi dùng thật
Nguyên tắc nền của mọi mô hình dự đoán là không chấm mô hình trên dữ liệu đã dùng để xây nó. Với dự báo theo thời gian, nguyên tắc ấy có một dạng chặt hơn gọi là kiểm tra cuộn (rolling-origin evaluation): đứng ở từng thời điểm trong quá khứ, chỉ dùng dữ liệu có trước thời điểm đó để dự báo, rồi so với điều thực sự xảy ra (Hyndman & Athanasopoulos, 2021). Ở Sáu Phố, mỗi sáng thứ Hai là một gốc dự báo: mô hình chỉ thấy dữ liệu tới hết Chủ nhật hôm trước và phải dự báo bảy ngày tới, đúng như quy trình xếp ca hằng tuần. Lặp lại cho 17 tuần cho 476 cặp dự báo và thực tế.
Thước đo sai số là sai số phần trăm tuyệt đối bình quân (MAPE): trung bình của |thực tế − dự báo| / thực tế, tính bằng phần trăm. MAPE đọc thẳng được bằng lời, "dự báo lệch bình quân bao nhiêu phần trăm" và vì là tỷ lệ nên so được giữa ca đông với ca vắng; đổi lại, nó vô nghĩa khi giá trị thực tế gần bằng 0. Ba mô hình được so sánh, từ thô đến tinh: mô hình A lấy số của cùng thứ, cùng ca tuần trước; mô hình B lấy trung bình bốn tuần gần nhất cùng thứ, cùng ca; mô hình C gộp năm ngày thường thành một nhóm, thứ Bảy một nhóm, Chủ nhật một nhóm, rồi lấy trung bình tám tuần gần nhất của nhóm, cùng ca. Cả ba viết được bằng một hàm AVERAGEIFS trong bảng tính. Hình 2 là kết quả.
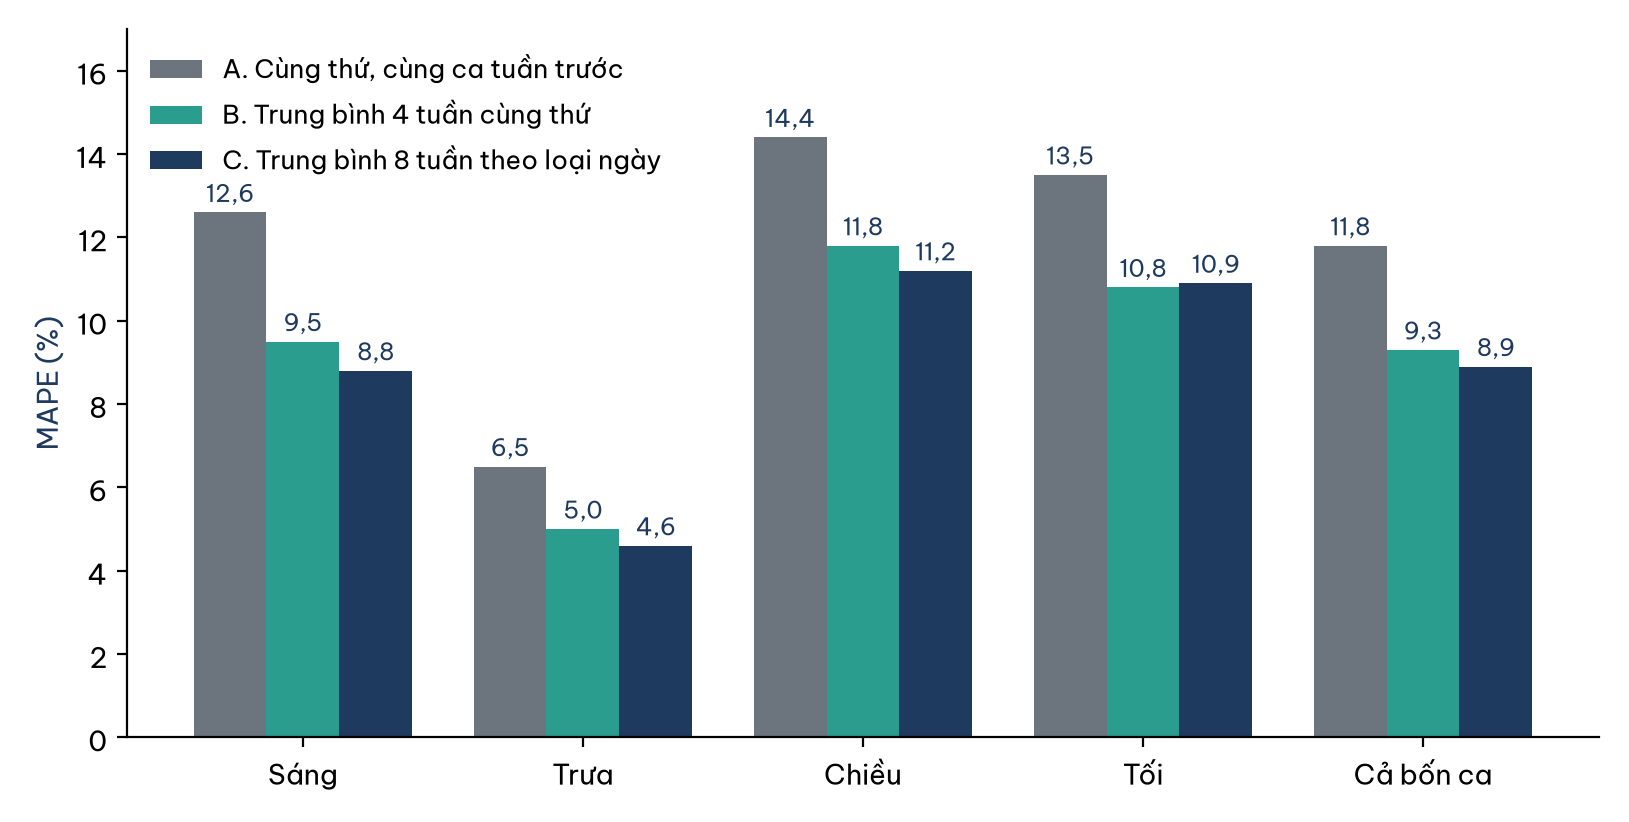
Hình 2. MAPE của ba mô hình dự báo theo ca, kiểm tra cuộn 17 tuần (tình huống giả định).
Hình 2 cho thấy mô hình C thắng khi gộp cả bốn ca (8,9% so với 11,8% của mô hình A) và lý do thắng đáng hiểu hơn chính con số. Mô hình A dựa trên một quan sát, nên mang nguyên nhiễu của tuần trước sang tuần sau: một ngày mưa to tuần trước thành dự báo thấp cho tuần này. Mô hình B dựa trên bốn quan sát, nhiễu giảm bớt. Mô hình C dựa trên khoảng bốn mươi quan sát cho ngày thường, nên nhiễu gần như triệt tiêu. Cái giá của việc gộp là giả định năm ngày thường giống nhau; giả định ấy được kiểm trên dữ liệu chứ không đoán: ngày thường đông nhất của CH03 chỉ hơn ngày vắng nhất 3,9%, nhỏ hơn nhiều so với nhiễu mà việc gộp loại bỏ.
Ca Chiều và Tối có sai số cao hơn hẳn ca Trưa ở cả ba mô hình. Đó là dấu vết của thời tiết: mưa làm nhu cầu chiều tối dao động thêm và không mô hình nào dựa thuần trên lịch sử dự báo được mưa. Muốn thu hẹp sai số ấy phải đưa dự báo thời tiết vào làm biến giải thích, tức chuyển từ chuỗi thời gian thuần sang mô hình có biến ngoài.
5. Trình bày dự báo để được dùng
Một dự báo điểm, dù tốt nhất trong ba mô hình, vẫn sai trung bình khoảng 8,9%. Thay vì giấu sai số ấy đi, hãy ghi nó lại thành phân phối. Trong 476 cặp dự báo và thực tế của mô hình C, tỷ số thực tế chia dự báo có 80% nằm trong khoảng 0,87 đến 1,18. Lấy các phân vị 10, 30, 50, 70 và 90 của phân phối ấy cho năm kịch bản nhu cầu: dự báo nhân 0,866; 0,964; 1,015; 1,065; 1,179. Năm con số khiêm tốn này chính là đầu vào cho bài toán xếp ca, nơi quy luật trung bình sai lầm trong bài Phân tích what-if trong Excel, từ Data Table đến Monte Carlo sẽ phát huy tác dụng: xếp ca theo dự báo điểm và xếp ca theo năm kịch bản cho hai lịch khác nhau.
Độ chính xác thống kê là điều kiện cần, chưa phải điều kiện đủ. Bài học từ NBCUniversal là ví dụ rõ: nhóm phân tích dựng mô hình chuỗi thời gian dự báo cầu quảng cáo với sai số chỉ 5–12%, nhưng lãnh đạo bán hàng không dùng vì mô hình bỏ qua những yếu tố định tính họ cho là quyết định (Bollapragada et al., 2008). Nhóm đổi cách tiếp cận, kết hợp dự báo "từ gốc rễ" do chính nhân viên bán hàng đưa ra với dữ liệu lịch sử; hệ thống mới được hơn 200 nhân viên dùng. Một dự báo chỉ tạo ra giá trị khi người ra quyết định hiểu và tin nó và cách chắc nhất để họ tin là cho họ góp phần vào nó.
AI giúp được nhiều ở bước viết mã dự báo và kiểm tra cuộn. Nhưng cạm bẫy phổ biến nhất khi nhờ AI là rò rỉ dữ liệu tương lai: mã do AI viết hay chuẩn hóa dữ liệu hoặc tính trung bình trên toàn bộ chuỗi trước khi chia, khiến mô hình vô tình "thấy" tương lai và cho sai số đẹp hơn thực tế. Hãy yêu cầu AI chỉ rõ dòng lệnh nào chặn dữ liệu sau gốc dự báo, rồi tự kiểm dòng đó. Cách đánh giá mô hình nói chung được bàn trong bài Đọc ma trận nhầm lẫn cho nhà quản lý.
Kết luận
Dự báo tốt bắt đầu trước mô hình: chọn đúng thứ để dự báo. Ở Sáu Phố, dự báo trên số ly bán được thay vì ly nhu cầu làm ca Trưa thấp hơn 11,8% và lịch ca xếp theo đó tự củng cố sự thiếu hụt. Bước tiếp theo là vẽ chuỗi và gọi tên mẫu hình, vì mỗi mẫu hình hợp với một họ phương pháp và một chuỗi nhảy mức có thể làm phương pháp tốt nhất hôm qua thành tệ nhất hôm nay.
Kiểm tra cuộn đánh giá dự báo đúng như khi dùng thật và trên dữ liệu Sáu Phố nó cho thấy một mô hình gộp các ngày giống nhau thắng việc bám sát tuần gần nhất. Mô hình phức tạp phải thắng mốc đơn giản mới đáng dùng. Cuối cùng, dự báo nên được trình bày kèm khoảng sai số và kịch bản và nên có sự tham gia của người sẽ dùng nó.
Đọc thêm
- Phân tích what-if trong Excel, từ Data Table đến Monte Carlo
- Hồi quy trong thống kê và học máy
- Năm nguồn thiên kiến trong dữ liệu
- Nhân quả Granger trong chuỗi thời gian
- Năm loại hình phân tích kinh doanh
Tài liệu tham khảo
Albright, S. C., & Winston, W. L. (2025). Business analytics: Data analysis and decision making (8th ed.). Cengage Learning. https://www.cengage.ca/c/new-edition/9780357984581/
Bollapragada, S., Gupta, S., Hurwitz, B., Miles, P., Tyagi, R., & Fierro, L. (2008). NBC-Universal uses a novel qualitative forecasting technique to predict advertising demand. Interfaces, 38(2), 103–111. https://doi.org/10.1287/inte.1070.0339
Camm, J. D., Cochran, J. J., Fry, M. J., & Ohlmann, J. W. (2024). Business analytics (5th ed.). Cengage Learning. https://www.cengage.com/c/business-analytics-5e-camm-cochran-fry-ohlmann/9780357902202/
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
Talluri, K. T., & van Ryzin, G. J. (2004). The theory and practice of revenue management. Springer. https://doi.org/10.1007/b139000