
HỒI QUY TUYẾN TÍNH BỘI TRONG SPSS/PSPP
Đọc R bình phương, ANOVA, hệ số B và Beta, khoảng tin cậy, kiểm định giả thuyết và hồi quy thứ bậc
Bài nên đọc trước
Bài tương quan Pearson cho thấy Ý định mua lại tương quan với cả bốn biến còn lại, nhưng bốn biến đó cũng tương quan với nhau. Câu hỏi của nghiên cứu cần câu trả lời rõ hơn: khi xét đồng thời các yếu tố, yếu tố nào thực sự tác động đến ý định mua lại và mạnh đến mức nào? Đó là việc của hồi quy tuyến tính bội.
Bài viết này dùng hồi quy để kiểm định 6 giả thuyết của mô hình nghiên cứu trên bộ dữ liệu mẫu (du_lieu_phan_tich.sav). Bài hướng dẫn cách chạy trong PSPP, cách đọc từng bảng kết quả, cách viết phương trình hồi quy và cách trình bày theo chuẩn luận văn. Mọi ảnh là ảnh chụp giao diện PSPP 2.0 thật và kết quả thật từ file cú pháp hoi_quy.sps đi kèm (Free Software Foundation, 2023). Các giả định của hồi quy (phân phối phần dư, đa cộng tuyến) sẽ được kiểm tra chi tiết ở bài kiểm định giả định hồi quy.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
14-hoi-quy-tuyen-tinh-boi-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Kết quả trước: mô hình nghiên cứu sau hồi quy
Trước khi đi vào cách chạy, hãy xem kết quả cuối cùng mà bài này hướng tới (Hình 1).
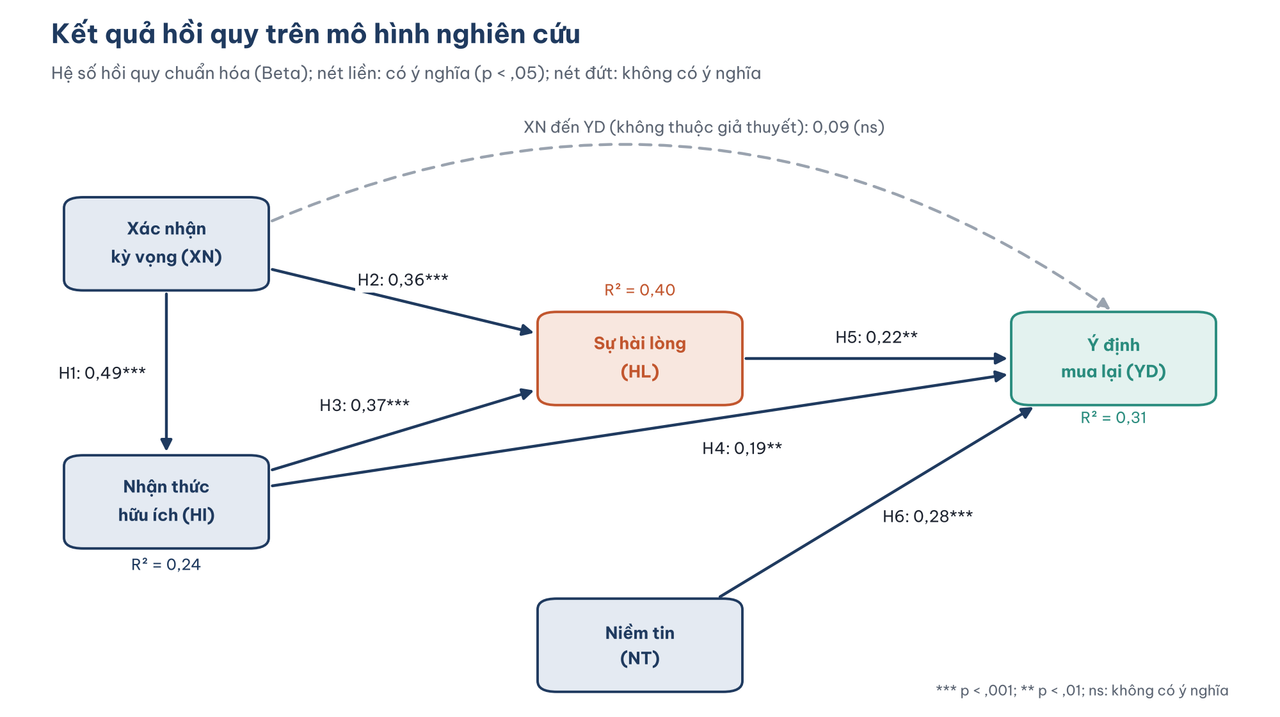
Hình 1. Hệ số hồi quy chuẩn hóa của từng đường tác động. Cả sáu giả thuyết H1–H6 đều được dữ liệu ủng hộ; đường XN đến YD (không thuộc giả thuyết) không có ý nghĩa.
Hình 1 tóm tắt toàn bộ kết quả của bài. Các mục sau giải thích từng con số đến từ đâu và đọc như thế nào.
2. Hồi quy tuyến tính bội là gì?
Hồi quy tuyến tính bội ước lượng một biến phụ thuộc Y từ nhiều biến độc lập X₁, X₂, ..., Xₖ theo phương trình:
Y = B₀ + B₁X₁ + B₂X₂ + ... + BₖXₖ + e
Mỗi hệ số B cho biết Y thay đổi bao nhiêu khi X tương ứng tăng một đơn vị, trong khi các biến độc lập khác được giữ nguyên. Cụm từ in đậm là điểm khác biệt quan trọng nhất giữa hồi quy bội và tương quan. Tương quan giữa XN và YD là 0,39, nhưng khi đã tính đến HI, HL và NT, phần tác động riêng của XN lên YD có thể nhỏ hơn nhiều (Cohen và cộng sự, 2003).
Ba phương trình cho mô hình nghiên cứu
Mô hình có biến trung gian HL, nên một phương trình hồi quy duy nhất không kiểm định được hết các giả thuyết. Mỗi biến có mũi tên đi vào cần một phương trình riêng (Bảng 1):
Bảng 1. Ba phương trình hồi quy cho mô hình nghiên cứu.
| Phương trình | Biến phụ thuộc | Biến độc lập | Giả thuyết kiểm định |
|---|---|---|---|
| Mô hình 0 | HI | XN | H1: XN → HI |
| Mô hình 1 | HL | XN, HI | H2: XN → HL; H3: HI → HL |
| Mô hình 2 | YD | XN, HI, HL, NT | H4: HI → YD; H5: HL → YD; H6: NT → YD |
Ở Mô hình 2, XN không có giả thuyết tác động trực tiếp đến YD. Theo mô hình kỳ vọng – xác nhận (ECM) của Bhattacherjee (2001), xác nhận kỳ vọng tác động đến ý định tiếp tục thông qua sự hài lòng và nhận thức hữu ích. XN vẫn được đưa vào Mô hình 2 để kiểm tra điều này: nếu lý thuyết đúng, XN sẽ không có tác động trực tiếp đáng kể khi đã có HI và HL.
Chạy các phương trình hồi quy riêng lẻ là cách tiếp cận truyền thống của phân tích đường dẫn (path analysis). Cách tiếp cận này không cho chỉ số độ phù hợp của toàn mô hình và không tính đến sai số đo lường. Cụm bài AMOS và SmartPLS sẽ ước lượng toàn bộ mô hình cùng lúc.
3. Chạy hồi quy trong PSPP
Hồi quy trong PSPP chạy bằng lệnh REGRESSION, qua giao diện hoặc cú pháp.
Bằng giao diện
Chọn Analyze > Regression > Linear (Hình 2).
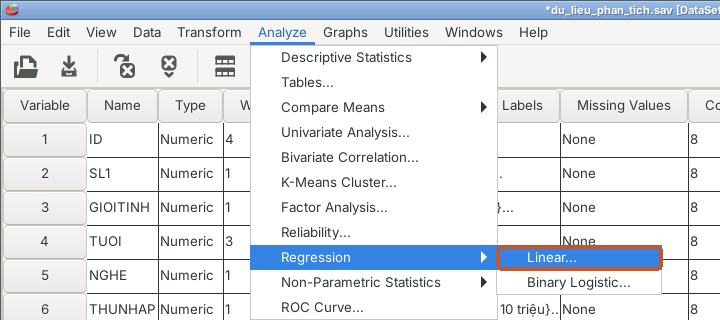
Hình 2. Lệnh Linear trong menu Regression của PSPP.
Trong hộp thoại Regression (Hình 3):
- Đưa biến phụ thuộc YD vào ô Dependent (1).
- Đưa bốn biến độc lập XN, HI, HL, NT vào ô Independent (2).
- Bấm Statistics (3) để chọn các bảng kết quả.
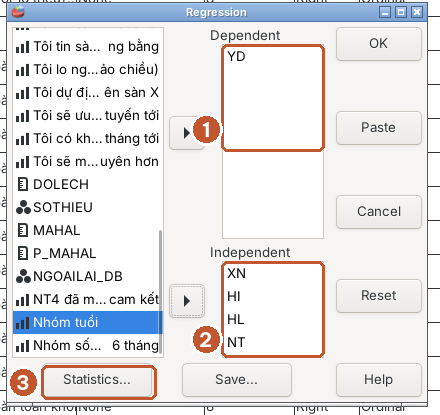
Hình 3. Biến phụ thuộc YD và bốn biến độc lập của Mô hình 2.
Trong hộp thoại Statistics (Hình 4), ngoài Coeff, R và Anova đã được chọn sẵn, đánh dấu thêm Conf. Interval (1) để có khoảng tin cậy 95% của hệ số B và Tol (2) để có hệ số Tolerance và VIF dùng kiểm tra đa cộng tuyến.
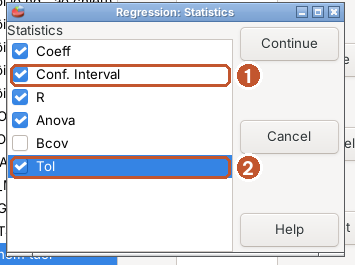
Hình 4. Chọn thêm khoảng tin cậy và thống kê đa cộng tuyến.
Bấm Paste để lấy cú pháp (Hình 5).
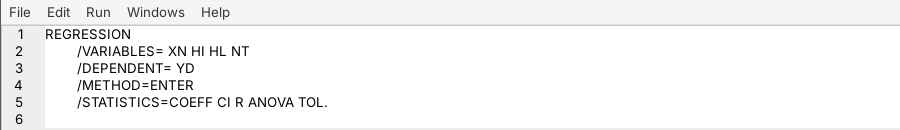
Hình 5. Cú pháp REGRESSION khi bấm Paste.
Bằng cú pháp
File hoi_quy.sps chạy cả ba phương trình:
REGRESSION /VARIABLES=XN /DEPENDENT=HI /METHOD=ENTER
  /STATISTICS=COEFF CI(95) R ANOVA.
REGRESSION /VARIABLES=XN HI /DEPENDENT=HL /METHOD=ENTER
  /STATISTICS=COEFF CI(95) R ANOVA TOL.
REGRESSION /VARIABLES=XN HI HL NT /DEPENDENT=YD /METHOD=ENTER
  /STATISTICS=COEFF CI(95) R ANOVA TOL.
Những điểm PSPP khác SPSS
Khi chạy thử, PSPP 2.0 có ba giới hạn cần biết:
- Chỉ có phương pháp Enter (đưa tất cả biến vào cùng lúc). PSPP báo lỗi với
/METHOD=STEPWISE. Đây không phải là thiếu sót đáng tiếc: các phương pháp từng bước (stepwise, forward, backward) chọn biến dựa hoàn toàn vào dữ liệu, cho mô hình không ổn định và giá trị p bị sai lệch (Smith, 2018; Whittingham và cộng sự, 2006). Với nghiên cứu kiểm định giả thuyết, Enter là phương pháp đúng. - Không hỗ trợ nhiều khối biến trong một lệnh và không có
/STATISTICS=CHANGEđể tính mức thay đổi của R². Mục 6 hướng dẫn cách làm tương đương. - Hệ số Beta của hằng số in là ,00. SPSS để trống ô này. Hằng số không có hệ số chuẩn hóa, nên hãy bỏ qua con số này.
4. Đọc kết quả hồi quy
PSPP in ba bảng cho mỗi phương trình. Hình 6 là kết quả của Mô hình 2.
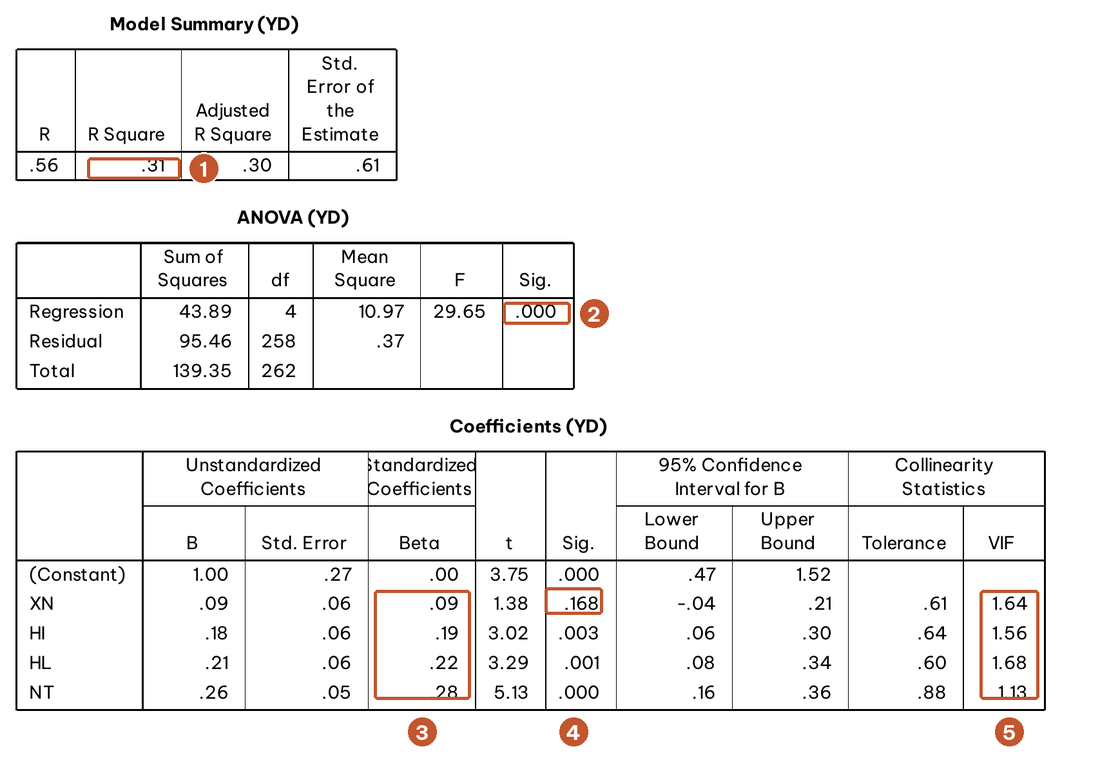
Hình 6. Ba bảng kết quả: R bình phương (1), kiểm định F của mô hình (2), hệ số Beta (3), mức ý nghĩa của XN (4) và hệ số VIF (5).
Bảng Model Summary: mô hình giải thích được bao nhiêu?
Bảng đầu tiên cho biết các biến độc lập giải thích được bao nhiêu phần trăm biến thiên của biến phụ thuộc.
- R = 0,56 là tương quan giữa giá trị YD thực tế và giá trị YD mà mô hình dự đoán.
- R Square (R²) = 0,31 (1): bốn biến độc lập giải thích 31,5% sự khác biệt về ý định mua lại giữa các đáp viên. 68,5% còn lại do các yếu tố khác ngoài mô hình và sai số.
- Adjusted R Square = 0,30 là R² đã điều chỉnh theo số biến độc lập và cỡ mẫu. R² luôn tăng khi thêm biến, kể cả biến vô nghĩa; R² hiệu chỉnh thì không. Khi so sánh các mô hình có số biến khác nhau, hãy dùng R² hiệu chỉnh (Hair và cộng sự, 2019; Field, 2024).
- Std. Error of the Estimate = 0,61 là sai số chuẩn của ước lượng: trung bình, giá trị dự đoán lệch khoảng 0,61 điểm so với giá trị thực tế trên thang 1–5.
R² = 0,31 là thấp hay cao? Không có ngưỡng chung, vì hành vi con người chịu ảnh hưởng của rất nhiều yếu tố ngoài mô hình. Một cách đánh giá khách quan hơn là quy đổi sang hệ số ảnh hưởng f² = R² / (1 − R²) = 0,46. Cohen (1988) coi f² = 0,02 là nhỏ, 0,15 là trung bình và 0,35 là lớn, nên Mô hình 2 có mức ảnh hưởng lớn.
Bảng ANOVA: mô hình có ý nghĩa không?
Kiểm định F kiểm tra giả thuyết mọi hệ số hồi quy đều bằng 0, tức mô hình không giải thích được gì. Kết quả F(4, 258) = 29,65, p < ,001 (2) bác bỏ giả thuyết này. Hai con số trong ngoặc là bậc tự do: 4 biến độc lập và 258 = 263 − 4 − 1, với 263 là số phiếu đầy đủ cả năm biến.
Kiểm định F có ý nghĩa là điều kiện cần. Nếu F không có ý nghĩa, không nên diễn giải các hệ số riêng lẻ.
Bảng Coefficients: từng biến tác động thế nào?
Đây là bảng quan trọng nhất. Với mỗi biến độc lập:
- B (hệ số chưa chuẩn hóa): YD tăng bao nhiêu điểm khi biến đó tăng 1 điểm, các biến khác giữ nguyên. B của NT là 0,26: hai khách hàng giống hệt nhau về XN, HI, HL, nhưng một người có Niềm tin cao hơn 1 điểm, thì ý định mua lại dự kiến cao hơn 0,26 điểm.
- Std. Error: sai số chuẩn của B, cho biết độ chính xác của ước lượng.
- Beta (hệ số chuẩn hóa) (3): hệ số khi mọi biến được chuẩn hóa về trung bình 0, độ lệch chuẩn 1. Beta cho phép so sánh mức tác động giữa các biến. NT có Beta lớn nhất (0,28), tiếp theo là HL (0,22) và HI (0,19).
- t và Sig.: kiểm định giả thuyết hệ số bằng 0. XN có t = 1,38, p = 0,168 (4), không có ý nghĩa ở mức 0,05.
- 95% Confidence Interval for B: khoảng tin cậy của B. Khoảng của XN đi từ −0,04 đến 0,21, chứa giá trị 0, nhất quán với p > 0,05.
- Tolerance và VIF (5): thống kê đa cộng tuyến. VIF từ 1,13 đến 1,68, thấp xa ngưỡng cảnh báo, sẽ được bàn kỹ ở bài kiểm định giả định hồi quy.
Mô hình 1 và Mô hình 0
Hai phương trình còn lại được đọc theo cùng cách (Hình 7).
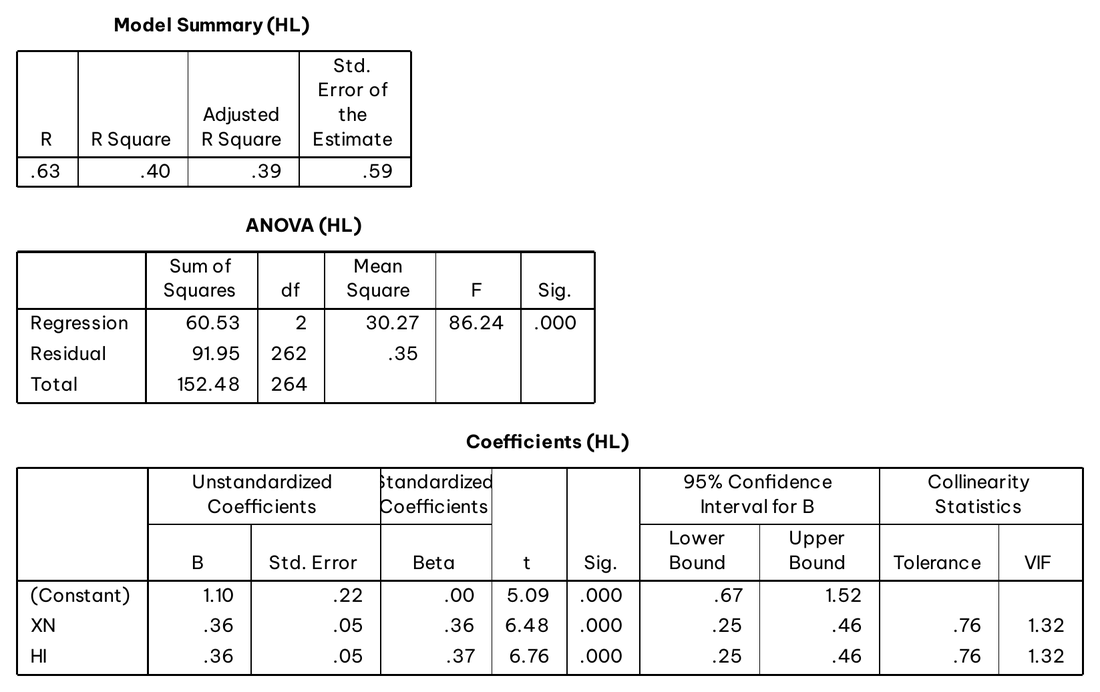
Hình 7. XN và HI cùng tác động đến HL với mức gần bằng nhau (Beta 0,36 và 0,37).
Mô hình 1 giải thích 39,7% phương sai của Sự hài lòng (R² hiệu chỉnh = 0,39; F(2, 262) = 86,24; p < ,001; f² = 0,66). Xác nhận kỳ vọng (B = 0,36; β = 0,36; p < ,001) và Nhận thức hữu ích (B = 0,36; β = 0,37; p < ,001) có tác động dương và gần như ngang nhau.
Mô hình 0 là hồi quy đơn với một biến độc lập: XN giải thích 24,2% phương sai của HI (B = 0,51; β = 0,49; p < ,001). Với hồi quy đơn, Beta chính bằng hệ số tương quan Pearson giữa hai biến (0,492 ở bài tương quan Pearson).
5. Kết luận về các giả thuyết
Bảng 2 tổng hợp kết luận về sáu giả thuyết từ các phương trình hồi quy.
Bảng 2. Kết luận về sáu giả thuyết.
| Giả thuyết | Đường tác động | B | β | t | p | Kết luận |
|---|---|---|---|---|---|---|
| H1 | XN → HI | 0,51 | 0,49 | 9,17 | < ,001 | Ủng hộ |
| H2 | XN → HL | 0,36 | 0,36 | 6,48 | < ,001 | Ủng hộ |
| H3 | HI → HL | 0,36 | 0,37 | 6,76 | < ,001 | Ủng hộ |
| H4 | HI → YD | 0,18 | 0,19 | 3,02 | ,003 | Ủng hộ |
| H5 | HL → YD | 0,21 | 0,22 | 3,29 | ,001 | Ủng hộ |
| H6 | NT → YD | 0,26 | 0,28 | 5,13 | < ,001 | Ủng hộ |
| (kiểm tra thêm) | XN → YD | 0,09 | 0,09 | 1,38 | ,168 | Không có ý nghĩa |
Hãy dùng cụm từ "dữ liệu ủng hộ giả thuyết" thay vì "giả thuyết được chứng minh". Một nghiên cứu cắt ngang chỉ cho thấy dữ liệu phù hợp với giả thuyết, không chứng minh quan hệ nhân quả (Hình 8).
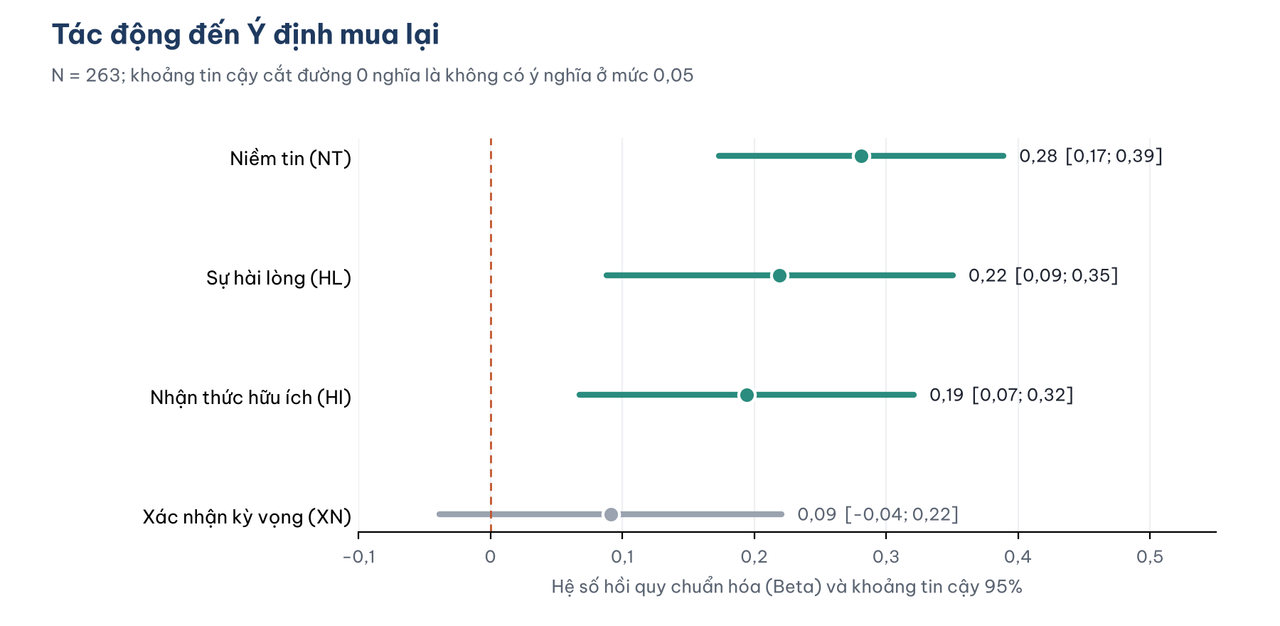
Hình 8. Khoảng tin cậy của XN cắt đường 0, ba biến còn lại nằm hoàn toàn bên phải đường 0.
XN không có ý nghĩa trong Mô hình 2: hiểu thế nào?
Bài tương quan Pearson cho thấy XN tương quan 0,39 với YD. Vậy tại sao trong Mô hình 2, XN gần như không có tác động? Vì phần lớn ảnh hưởng của XN đến YD đi qua HL và HI: XN làm tăng HI (H1) và HL (H2), rồi HI và HL làm tăng YD. Khi HI và HL đã có trong phương trình, XN không còn nhiều thông tin riêng để giải thích thêm YD.
Đây chính là điều mô hình ECM dự đoán. Kết quả này không có nghĩa là XN không quan trọng: XN quan trọng vì nó là điểm khởi đầu của chuỗi tác động. Việc kiểm định chính thức tác động gián tiếp này (phân tích trung gian bằng bootstrap) sẽ được trình bày ở các bài sau.
6. Hồi quy thứ bậc: HL giải thích thêm bao nhiêu?
Một câu hỏi khác có thể đặt ra: khi đã biết XN, HI và NT, việc biết thêm Sự hài lòng giúp dự đoán ý định mua lại tốt hơn bao nhiêu? Hồi quy thứ bậc (hierarchical regression) trả lời bằng cách đưa biến vào theo từng khối và so sánh R².
SPSS làm việc này trong một lệnh với nút Next để tạo khối và tùy chọn R squared change. PSPP 2.0 chưa hỗ trợ, nên file cú pháp chạy hai mô hình trên cùng một tập phiếu đầy đủ (một bản sao dữ liệu đã lọc 263 phiếu) rồi so sánh:
DATASET NAME CHINH.
DATASET COPY DAYDU.
DATASET ACTIVATE DAYDU.
SELECT IF NMISS(XN, HI, HL, NT, YD) = 0.
REGRESSION /VARIABLES=XN HI NT /DEPENDENT=YD /METHOD=ENTER /STATISTICS=R ANOVA.
REGRESSION /VARIABLES=XN HI NT HL /DEPENDENT=YD /METHOD=ENTER /STATISTICS=R ANOVA.
Phải dùng cùng tập phiếu, vì nếu chạy trên toàn bộ dữ liệu, mô hình không có HL dùng 264 phiếu, còn mô hình có HL dùng 263 phiếu và hai R² không so sánh được (Bảng 3).
Bảng 3. Hồi quy thứ bậc khi thêm HL.
| Khối | Biến | R² | ΔR² |
|---|---|---|---|
| Khối 1 | XN, HI, NT | 0,286 | |
| Khối 2 | + HL | 0,315 | 0,029 |
Kiểm định ý nghĩa của ΔR² được tính từ hai R²:
F = (ΔR² / số biến thêm vào) / ((1 − R²₂) / (N − k₂ − 1)) = (0,029 / 1) / (0,685 / 258) = 10,83
với k₂ = 4 biến ở khối 2. Với bậc tự do (1, 258), p = 0,001. Sự hài lòng giải thích thêm 2,9% phương sai của ý định mua lại, một mức nhỏ nhưng có ý nghĩa thống kê.
ΔR² khi thêm một biến cuối cùng còn gọi là bình phương tương quan bán riêng phần (sr²) của biến đó: phần phương sai chỉ riêng biến đó giải thích. Tính cho cả bốn biến (Bảng 4):
Bảng 4. Phương sai giải thích riêng của từng biến.
| Biến | sr² (phương sai giải thích riêng) |
|---|---|
| NT | 7,0% |
| HL | 2,9% |
| HI | 2,4% |
| XN | 0,5% |
| Tổng phần riêng | 12,8% |
| R² của mô hình | 31,5% |
Phần riêng của bốn biến cộng lại chỉ 12,8%, trong khi mô hình giải thích 31,5%. 18,7% còn lại là phần chung, do các biến độc lập tương quan với nhau cùng giải thích. Đây là lý do không nên diễn giải Beta như "tỷ lệ đóng góp" của từng biến vào R². Niềm tin có phần riêng lớn nhất vì NT ít tương quan với các biến độc lập khác (bài tương quan Pearson).
7. Phương trình hồi quy và dự đoán
Từ cột B của Mô hình 2, phương trình hồi quy chưa chuẩn hóa là:
YD = 1,00 + 0,09 × XN + 0,18 × HI + 0,21 × HL + 0,26 × NT
Phương trình chuẩn hóa (dùng Beta, không có hằng số):
YD = 0,09 × XN + 0,19 × HI + 0,22 × HL + 0,28 × NT
Phương trình chưa chuẩn hóa dùng để dự đoán trên thang đo gốc. Một khách hàng có cả bốn biến ở mức 4 điểm có ý định mua lại dự kiến là 1,00 + 0,09 × 4 + 0,18 × 4 + 0,21 × 4 + 0,26 × 4 ≈ 3,93. Nếu Sự hài lòng tăng lên 5 điểm, các biến khác giữ nguyên, ý định mua lại dự kiến tăng lên khoảng 4,14. Phương trình chuẩn hóa dùng để so sánh mức tác động giữa các biến có đơn vị đo khác nhau.
Cách diễn giải này cho thấy ý nghĩa thực tiễn của kết quả: với sàn X, cải thiện niềm tin của khách hàng (bảo vệ thông tin cá nhân, giải quyết khiếu nại công bằng) có tác động riêng lớn nhất đến ý định mua lại, bên cạnh việc nâng cao sự hài lòng.
8. Trình bày kết quả hồi quy trong báo cáo
Bảng kết quả theo chuẩn APA (American Psychological Association, 2020) thường gộp các mô hình vào một bảng (Bảng 5):
Bảng 5. Kết quả hồi quy theo chuẩn APA.
| Biến độc lập | Mô hình 1: HL | Mô hình 2: YD | ||
|---|---|---|---|---|
| B [KTC 95%] | β | B [KTC 95%] | β | |
| Hằng số | 1,10 [0,67; 1,52] | 1,00 [0,47; 1,52] | ||
| Xác nhận kỳ vọng (XN) | 0,36*** [0,25; 0,46] | 0,36 | 0,09 [−0,04; 0,21] | 0,09 |
| Nhận thức hữu ích (HI) | 0,36*** [0,25; 0,46] | 0,37 | 0,18** [0,06; 0,30] | 0,19 |
| Sự hài lòng (HL) | 0,21** [0,08; 0,34] | 0,22 | ||
| Niềm tin (NT) | 0,26*** [0,16; 0,36] | 0,28 | ||
| R² (R² hiệu chỉnh) | 0,40 (0,39) | 0,31 (0,30) | ||
| F (bậc tự do) | 86,24 (2; 262)*** | 29,65 (4; 258)*** | ||
| N | 265 | 263 |
Ghi chú: B là hệ số chưa chuẩn hóa, β là hệ số chuẩn hóa, KTC là khoảng tin cậy. ** p < ,01; *** p < ,001.
Đoạn văn mẫu: "Kết quả hồi quy cho thấy Xác nhận kỳ vọng (β = 0,36; p < ,001) và Nhận thức hữu ích (β = 0,37; p < ,001) có tác động dương đến Sự hài lòng, giải thích 39,7% phương sai của biến này (F(2, 262) = 86,24; p < ,001). Ý định mua lại chịu tác động dương của Niềm tin (β = 0,28; p < ,001), Sự hài lòng (β = 0,22; p = ,001) và Nhận thức hữu ích (β = 0,19; p = ,003); mô hình giải thích 31,5% phương sai (F(4, 258) = 29,65; p < ,001). Xác nhận kỳ vọng không có tác động trực tiếp đáng kể đến Ý định mua lại (β = 0,09; p = ,168), phù hợp với lập luận của mô hình ECM rằng tác động của xác nhận kỳ vọng đến ý định tiếp tục đi qua sự hài lòng và nhận thức hữu ích. Do đó, các giả thuyết H1 đến H6 đều được dữ liệu ủng hộ."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chạy và diễn giải hồi quy trong luận văn.
- Diễn giải hệ số B mà quên điều kiện "các biến khác giữ nguyên".
- So sánh mức tác động bằng B thay vì Beta khi các biến có đơn vị đo khác nhau.
- Kết luận "XN không ảnh hưởng đến YD" chỉ vì hệ số của XN không có ý nghĩa trong mô hình có biến trung gian.
- Dùng phương pháp stepwise trong nghiên cứu kiểm định giả thuyết, để dữ liệu quyết định biến nào vào mô hình.
- So sánh R² của hai mô hình chạy trên hai tập phiếu khác nhau khi làm hồi quy thứ bậc.
Tài liệu tham khảo
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Bhattacherjee, A. (2001). Understanding information systems continuance: An expectation-confirmation model. MIS Quarterly, 25(3), 351–370. https://doi.org/10.2307/3250921
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysisfor-the-Behavioral-Sciences/Cohen/p/book/9780805802832
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Applied-Multiple-RegressionCorrelation-Analysis-for-the-Behavioral-Sciences/Cohen-Cohen-West-Aiken/p/book/9780805822236
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Smith, G. (2018). Step away from stepwise. Journal of Big Data, 5, Article 32. https://doi.org/10.1186/s40537-018-0143-6
Whittingham, M. J., Stephens, P. A., Bradbury, R. B., & Freckleton, R. P. (2006). Why do we still use stepwise modelling in ecology and behaviour? Journal of Animal Ecology, 75(5), 1182–1189. https://doi.org/10.1111/j.1365-2656.2006.01141.x