
PHÂN TÍCH TƯƠNG QUAN PEARSON TRONG SPSS/PSPP
Điều kiện dùng, cách đọc hệ số r và mức ý nghĩa, ảnh hưởng của ngoại lai, Spearman và bảng tương quan APA
Bài nên đọc trước
Sau khi đã có năm biến đại diện XN, HI, HL, NT, YD (bài tính biến đại diện) và đã kiểm tra độ tin cậy (bài Cronbach's Alpha) cùng cấu trúc nhân tố (bài phân tích nhân tố khám phá), bước tiếp theo trong hầu hết các luận văn là phân tích tương quan. Ma trận tương quan cho cái nhìn đầu tiên về quan hệ giữa các khái niệm. Các biến có liên quan với nhau theo hướng lý thuyết dự đoán không? Có cặp biến nào tương quan quá cao đến mức khó phân biệt? Có biến nào hầu như không liên quan đến biến kết quả?
Bài viết này hướng dẫn chạy tương quan Pearson trong PSPP trên bộ dữ liệu mẫu (du_lieu_phan_tich.sav, 267 phiếu), cách đọc từng con số trong ma trận và những lỗi diễn giải hay gặp. Bài cũng chỉ ra hai lệnh mà PSPP 2.0 chưa có (tương quan Spearman và tương quan riêng phần), kèm cách làm tương đương. Mọi kết quả trong bài là kết quả thật từ file cú pháp tuong_quan.sps đi kèm (Free Software Foundation, 2023).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
13-tuong-quan-pearson-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Hệ số tương quan Pearson đo cái gì?
Hệ số tương quan Pearson, ký hiệu r, đo mức độ và chiều của quan hệ tuyến tính giữa hai biến định lượng. Giá trị của r nằm trong khoảng từ −1 đến +1:
- r dương: hai biến cùng tăng. Người hài lòng hơn có ý định mua lại cao hơn.
- r âm: biến này tăng thì biến kia giảm. Ví dụ, mức lo ngại sàn X không giữ cam kết (NT4 gốc) càng cao thì niềm tin càng thấp.
- r càng gần ±1, các điểm càng nằm sát một đường thẳng. r = 0 nghĩa là không có quan hệ tuyến tính, nhưng không có nghĩa là không có quan hệ nào.
Hình 1 minh họa các mức tương quan khác nhau trên dữ liệu mô phỏng.
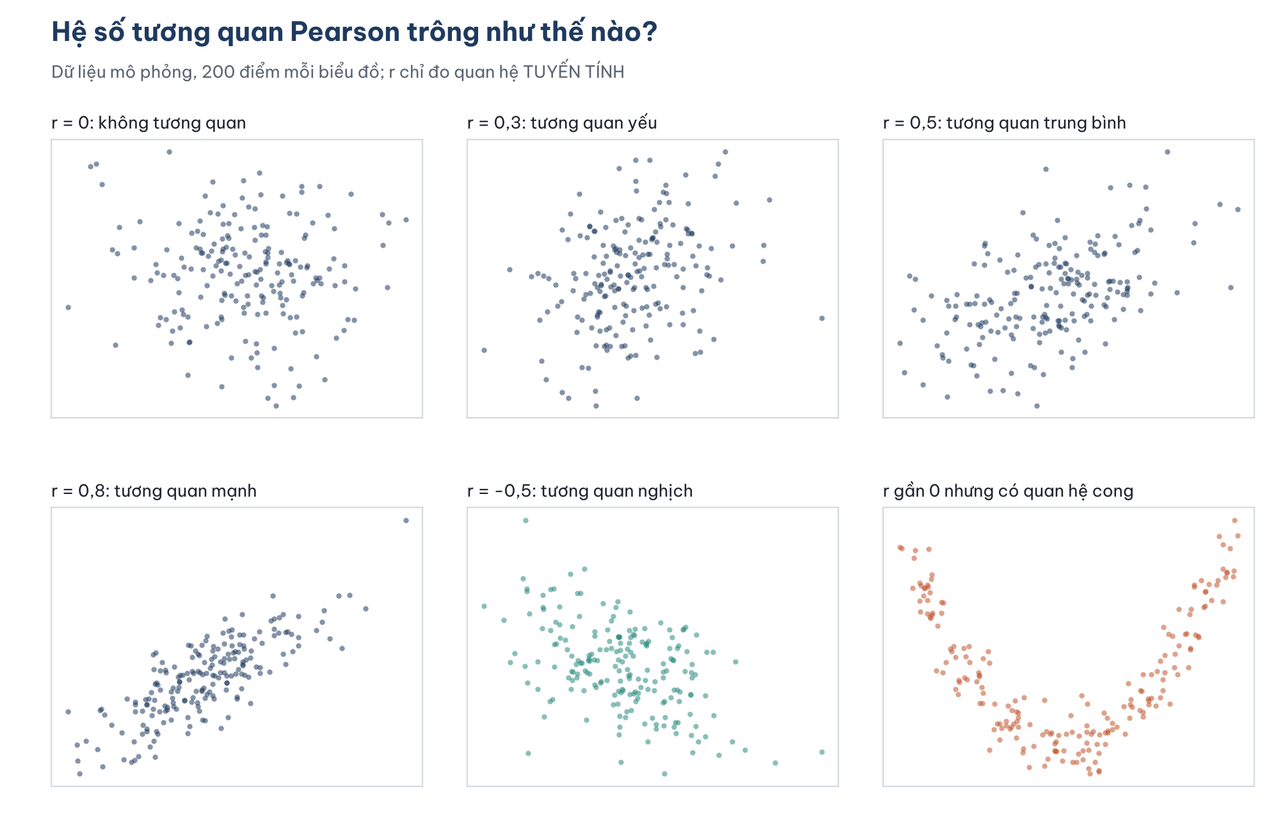
Hình 1. Dữ liệu mô phỏng với các mức tương quan khác nhau. Biểu đồ cuối có quan hệ rất rõ nhưng r gần 0, vì quan hệ có dạng cong.
Biểu đồ cuối của Hình 1 là lý do phải luôn nhìn biểu đồ phân tán trước khi tin vào r. Anscombe (1973) đã minh họa điều này bằng bốn bộ dữ liệu có cùng hệ số tương quan nhưng hình dạng hoàn toàn khác nhau.
Bình phương hệ số tương quan, r², là tỷ lệ phương sai chung giữa hai biến. Với r = 0,50, r² = 0,25, nghĩa là 25% sự khác biệt của biến này giữa các đáp viên được "chia sẻ" với biến kia. Cách đọc này giúp tránh phóng đại: một tương quan "trung bình" 0,30 chỉ ứng với 9% phương sai chung.
Điều kiện sử dụng
Theo Field (2024) và Tabachnick và Fidell (2019), tương quan Pearson phù hợp khi:
- Hai biến là định lượng. Biến đại diện (trung bình của 4 câu Likert) đáp ứng điều kiện này tốt hơn từng câu Likert riêng lẻ.
- Quan hệ có dạng tuyến tính. Kiểm tra bằng biểu đồ phân tán.
- Không có ngoại lai ảnh hưởng mạnh. Một điểm cực đoan có thể làm r thay đổi đáng kể (mục 5).
- Phân phối gần chuẩn, để kiểm định ý nghĩa của r chính xác. Với cỡ mẫu vài trăm, kiểm định khá vững khi phân phối lệch vừa phải; khi phân phối lệch nặng, nên dùng tương quan Spearman hoặc bootstrap (Bishara & Hittner, 2012).
2. Chạy tương quan Pearson trong PSPP
Lệnh CORRELATIONS chạy được bằng giao diện hoặc cú pháp.
Bằng giao diện
Chọn Analyze > Bivariate Correlation (trong SPSS: Analyze > Correlate > Bivariate). Trong hộp thoại (Hình 2):
- Đưa năm biến đại diện XN, HI, HL, NT, YD vào ô bên phải (1).
- Giữ Two-tailed (2) ở mục Test of Significance. Chỉ chọn One-tailed khi giả thuyết đã nêu rõ chiều của quan hệ trước khi thu dữ liệu và bạn chấp nhận bỏ qua khả năng quan hệ ngược chiều.
- Đánh dấu Flag significant correlations (3) để PSPP đánh dấu các hệ số có ý nghĩa.
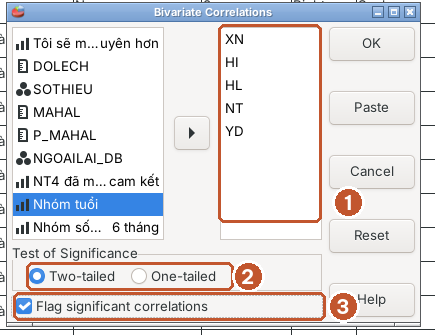
Hình 2. Năm biến đại diện, kiểm định hai phía và tùy chọn đánh dấu hệ số có ý nghĩa.
Bấm Paste để xem cú pháp (Hình 3). Lưu ý rằng trong cú pháp, NOSIG có nghĩa là đánh dấu hệ số có ý nghĩa, không phải "không có ý nghĩa". Tên này kế thừa từ SPSS và dễ gây nhầm lẫn.
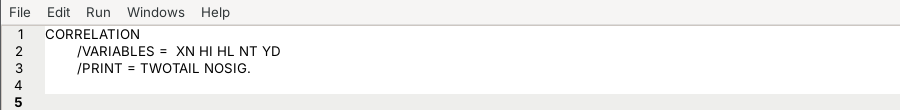
Hình 3. Cú pháp sinh ra khi bấm Paste.
Bằng cú pháp
Giao diện PSPP không có nút Options để in thống kê mô tả như SPSS, nhưng cú pháp có thể thêm /STATISTICS=DESCRIPTIVES:
CORRELATIONS /VARIABLES=XN HI HL NT YD /PRINT=TWOTAIL NOSIG /STATISTICS=DESCRIPTIVES.
3. Đọc ma trận tương quan
Ma trận tương quan đối xứng qua đường chéo, nên chỉ cần đọc một nửa (Hình 4).
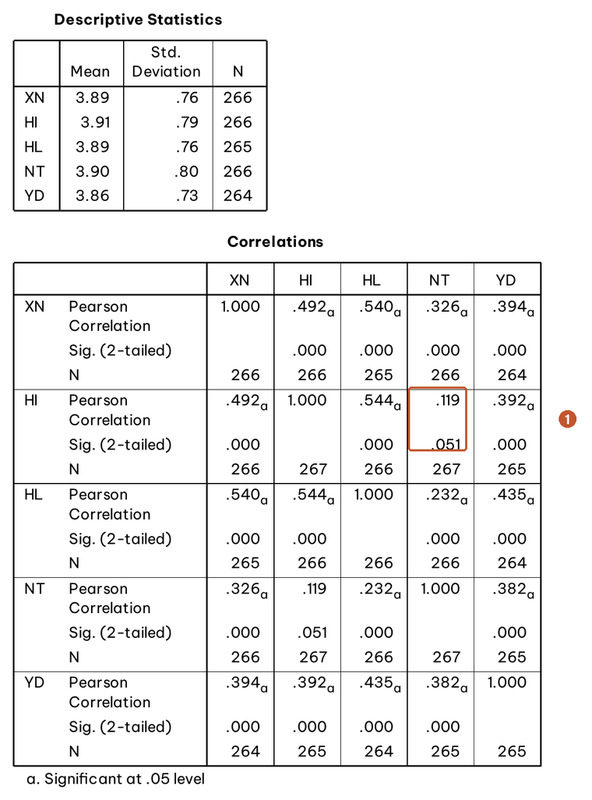
Hình 4. Ma trận tương quan giữa năm biến đại diện. Chữ "a" đánh dấu hệ số có ý nghĩa ở mức 0,05. Cặp HI và NT (1) là cặp duy nhất không có ý nghĩa.
Ba dòng trong mỗi ô
Mỗi ô của ma trận có ba con số:
- Pearson Correlation: hệ số r.
- Sig. (2-tailed): giá trị p của kiểm định giả thuyết r = 0 trong tổng thể.
- N: số phiếu dùng để tính hệ số.
Ma trận đối xứng qua đường chéo, nên chỉ cần đọc nửa dưới hoặc nửa trên. Đường chéo luôn bằng 1, vì mỗi biến tương quan hoàn toàn với chính nó.
Độ lớn của tương quan
Cohen (1988) đề xuất ba mốc: r = 0,10 là nhỏ, 0,30 là trung bình, 0,50 là lớn. Gignac và Szodorai (2016) tổng hợp hơn 700 hệ số tương quan trong nghiên cứu về khác biệt cá nhân và thấy các mốc 0,10, 0,20 và 0,30 phản ánh thực tế tốt hơn. Nói cách khác, r = 0,30 trong khoa học xã hội đã là một tương quan khá lớn.
Kết quả của dữ liệu mẫu, kèm khoảng tin cậy 95% tính bằng biến đổi Fisher z (Bảng 1):
Bảng 1. Tương quan giữa các cặp biến trong mô hình mẫu.
| Cặp biến | r | p | Khoảng tin cậy 95% | r² | Độ lớn theo Cohen |
|---|---|---|---|---|---|
| HI – HL | 0,544 | < ,001 | 0,45 đến 0,62 | 29,6% | Lớn |
| XN – HL | 0,540 | < ,001 | 0,45 đến 0,62 | 29,2% | Lớn |
| XN – HI | 0,492 | < ,001 | 0,39 đến 0,58 | 24,2% | Trung bình đến lớn |
| HL – YD | 0,435 | < ,001 | 0,33 đến 0,53 | 18,9% | Trung bình |
| XN – YD | 0,394 | < ,001 | 0,29 đến 0,49 | 15,5% | Trung bình |
| HI – YD | 0,392 | < ,001 | 0,28 đến 0,49 | 15,4% | Trung bình |
| NT – YD | 0,382 | < ,001 | 0,27 đến 0,48 | 14,6% | Trung bình |
| XN – NT | 0,326 | < ,001 | 0,21 đến 0,43 | 10,7% | Trung bình |
| HL – NT | 0,232 | < ,001 | 0,12 đến 0,34 | 5,4% | Nhỏ |
| HI – NT | 0,119 | 0,051 | 0,00 đến 0,24 | 1,4% | Nhỏ, không có ý nghĩa |
Đọc kết quả theo mô hình nghiên cứu
Ma trận tương quan không kiểm định giả thuyết nhân quả, nhưng cho thấy dữ liệu có phù hợp với mô hình hay không:
- Biến kết quả YD tương quan dương, ở mức trung bình, với cả bốn biến còn lại (0,38 đến 0,44). Tương quan mạnh nhất là với HL (0,435), phù hợp với vai trò trung tâm của Sự hài lòng trong lý thuyết ECM.
- XN và HI tương quan mạnh với HL (0,54), phù hợp với giả thuyết H2 và H3 rằng Xác nhận kỳ vọng và Nhận thức hữu ích tác động đến Sự hài lòng.
- NT tương quan yếu với HI và HL. Trong mô hình, Niềm tin tác động trực tiếp đến YD (H6) chứ không qua HL. Tương quan thấp giữa NT và HI cho thấy hai khái niệm này khá độc lập.
Mức ý nghĩa phụ thuộc vào cỡ mẫu
Cặp HI – NT có p = 0,051, chỉ vượt ngưỡng 0,05 một chút. Khi chuyển sang loại theo danh sách (/MISSING=LISTWISE, mọi hệ số dùng cùng 263 phiếu đầy đủ), hệ số giảm còn 0,110 và p = 0,076. Hai điều rút ra từ ví dụ này:
- Có ý nghĩa hay không có ý nghĩa không phải ranh giới tuyệt đối. r = 0,119 với p = 0,051 và r = 0,125 với p = 0,04 gần như là cùng một kết quả. Hãy báo cáo khoảng tin cậy (0,00 đến 0,24) thay vì chỉ nói "không có ý nghĩa".
- Với mẫu lớn, tương quan rất nhỏ cũng có ý nghĩa. Với N = 265, mọi r từ khoảng 0,12 trở lên đều có ý nghĩa ở mức 0,05. Có ý nghĩa thống kê không có nghĩa là quan trọng trong thực tế: r = 0,12 chỉ ứng với 1,4% phương sai chung.
Mặc định, PSPP và SPSS loại theo cặp: mỗi hệ số dùng mọi phiếu có đủ hai biến đó, nên cột N khác nhau giữa các ô (từ 264 đến 267). Khi báo cáo, hãy ghi rõ cách xử lý, hoặc dùng loại theo danh sách để mọi hệ số dựa trên cùng một mẫu.
4. Kiểm tra quan hệ tuyến tính bằng biểu đồ phân tán
Lệnh GRAPH vẽ biểu đồ phân tán (menu Graphs > Scatterplot):
GRAPH /SCATTERPLOT(BIVAR)=HL WITH YD.
Hình 5 là biểu đồ phân tán do PSPP vẽ cho dữ liệu mẫu.
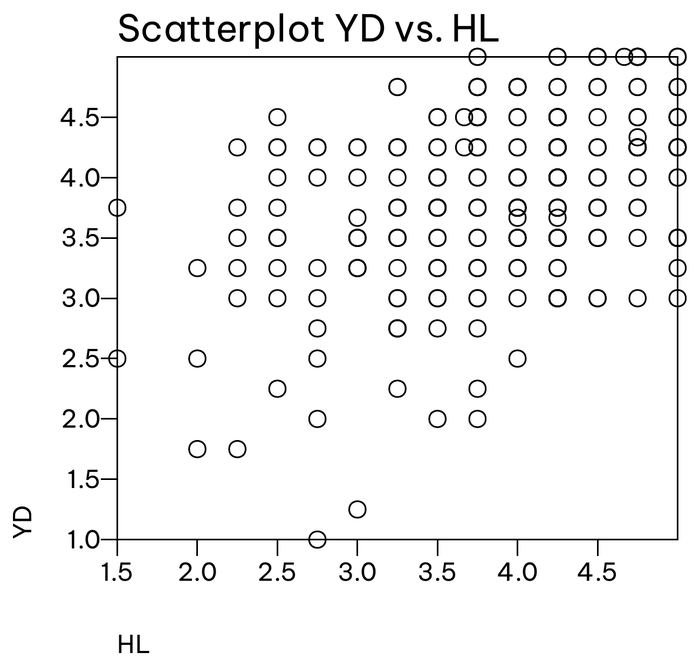
Hình 5. Biểu đồ phân tán do PSPP vẽ. Các điểm xếp thành lưới vì biến đại diện chỉ nhận các giá trị như 3,00; 3,25; 3,50.
Biến đại diện của thang 4 câu chỉ nhận một số giá trị rời rạc, nên nhiều phiếu chồng lên cùng một điểm. Trên biểu đồ của PSPP, 264 phiếu chỉ hiện thành 111 điểm phân biệt. Cách khắc phục là làm nhiễu điểm (jitter): dịch mỗi điểm một khoảng ngẫu nhiên rất nhỏ để thấy được mật độ thật. Script tao_hinh.py đi kèm vẽ lại biểu đồ theo cách này (Hình 6):
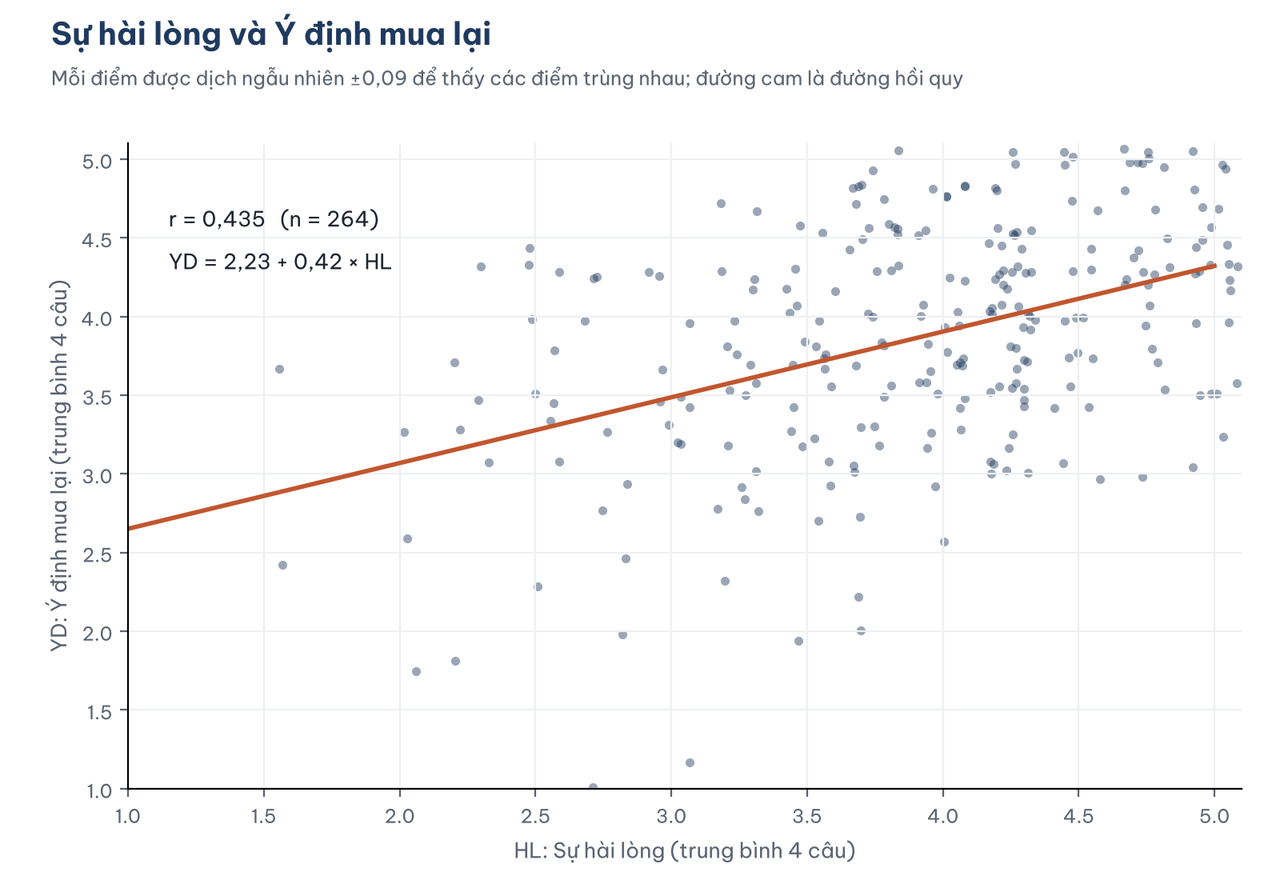
Hình 6. Cùng dữ liệu, sau khi làm nhiễu điểm và thêm đường hồi quy.
Quan hệ có dạng tuyến tính: các điểm phân bố quanh đường thẳng đi lên, không có dạng cong hay nhóm điểm tách biệt. Các điểm dày đặc ở góc trên bên phải, đúng với việc phần lớn đáp viên hài lòng và có ý định mua lại.
5. Ảnh hưởng của ngoại lai và tương quan Spearman
Bài làm sạch dữ liệu đã giữ lại phiếu 99 với 95 lần mua trong 6 tháng. Biểu đồ phân tán giữa số lần mua và ý định mua lại cho thấy phiếu này nằm tách hẳn khỏi phần còn lại (Hình 7):
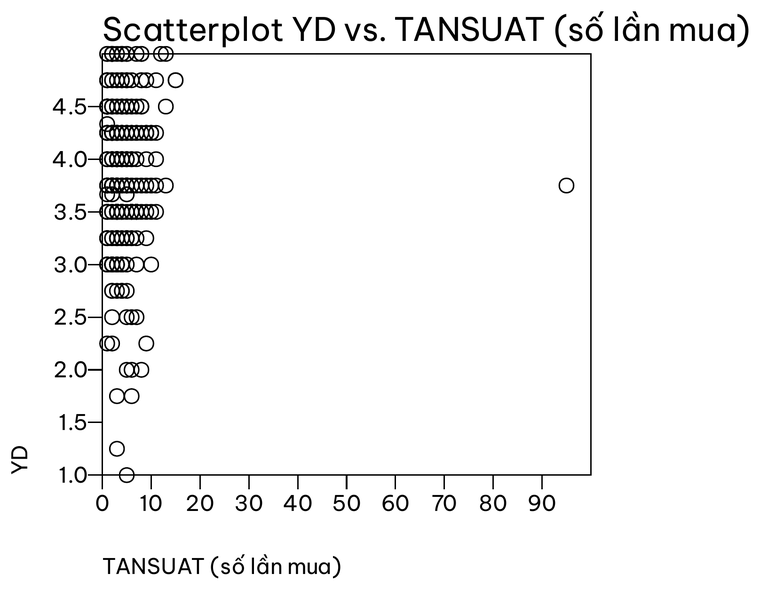
Hình 7. Phiếu 99 (TANSUAT = 95) nằm đơn độc bên phải, cách xa 266 phiếu còn lại.
So sánh ba cách tính tương quan giữa YD và TANSUAT (Bảng 2):
Bảng 2. Ba cách tính tương quan giữa YD và TANSUAT.
| Cách tính | r | p | N |
|---|---|---|---|
| Pearson, đủ 265 phiếu | 0,025 | 0,680 | 265 |
| Pearson, bỏ phiếu 99 | 0,073 | 0,236 | 264 |
| Spearman, đủ 265 phiếu | 0,030 | 0,621 | 265 |
Một phiếu duy nhất làm hệ số Pearson thay đổi gần gấp ba lần. Trong trường hợp này kết luận không đổi (không có tương quan đáng kể), nhưng với mẫu nhỏ hơn, một ngoại lai có thể biến một tương quan không có ý nghĩa thành có ý nghĩa, hoặc ngược lại.
Tương quan hạng Spearman (ký hiệu ρ hoặc rₛ) tính tương quan trên thứ hạng của dữ liệu thay vì giá trị gốc. Phiếu 99 chỉ là "người mua nhiều nhất", dù mua 95 hay 16 lần thì thứ hạng vẫn như nhau. Vì vậy Spearman ít bị ảnh hưởng bởi ngoại lai và phù hợp với biến thứ bậc hoặc biến lệch nặng như TANSUAT.
PSPP 2.0 chưa có lệnh NONPAR CORR để tính Spearman. Vì Spearman chính là Pearson tính trên thứ hạng, cách làm tương đương là xếp hạng bằng lệnh RANK rồi chạy CORRELATIONS:
RANK VARIABLES=YD TUOI TANSUAT (A) /RANK INTO R_YD R_TUOI R_TS /TIES=MEAN.
CORRELATIONS /VARIABLES=R_YD R_TUOI R_TS.
/TIES=MEAN gán cho các giá trị bằng nhau thứ hạng trung bình, đúng cách tính của Spearman. Kết quả 0,030 trùng với giá trị tính bằng thư viện scipy trong Python. Trong SPSS, chọn thêm ô Spearman trong hộp thoại Bivariate Correlations.
6. Tương quan riêng phần
HL và YD tương quan 0,435. Nhưng cả hai đều tương quan với XN và HI. Một phần tương quan giữa HL và YD có thể chỉ vì người có kỳ vọng được xác nhận và thấy sàn X hữu ích thì vừa hài lòng hơn, vừa có ý định mua lại cao hơn. Tương quan riêng phần (partial correlation) trả lời câu hỏi: HL và YD còn tương quan bao nhiêu khi đã loại bỏ ảnh hưởng của XN và HI?
PSPP 2.0 cũng chưa có lệnh PARTIAL CORR. Cách làm tương đương dựa trên định nghĩa của tương quan riêng phần: lấy phần dư của HL sau khi hồi quy theo XN và HI, lấy phần dư của YD sau khi hồi quy theo XN và HI, rồi tính tương quan giữa hai phần dư:
DATASET NAME CHINH.
DATASET COPY RIENGPHAN.
DATASET ACTIVATE RIENGPHAN.
SELECT IF NMISS(HL, YD, XN, HI) = 0.
REGRESSION /VARIABLES=XN HI /DEPENDENT=HL /SAVE=RESID.
RENAME VARIABLES (RES1 = E_HL).
REGRESSION /VARIABLES=XN HI /DEPENDENT=YD /SAVE=RESID.
RENAME VARIABLES (RES1 = E_YD).
CORRELATIONS /VARIABLES=E_HL E_YD.
Lệnh SELECT IF chạy trên một bản sao dữ liệu, để hai phần dư được tính trên cùng 263 phiếu mà không làm mất phiếu ở dữ liệu chính.
Kết quả: tương quan riêng phần giữa HL và YD là 0,221 (p < ,001), giảm một nửa so với tương quan đơn 0,435. Khoảng một nửa quan hệ giữa HL và YD được giải thích bởi XN và HI. Phần còn lại là quan hệ riêng giữa Sự hài lòng và Ý định mua lại. Đây là gợi ý đầu tiên cho vai trò trung gian của HL, sẽ được kiểm định chính thức ở các bài hồi quy và mô hình cấu trúc.
Một lưu ý kỹ thuật: lệnh CORRELATIONS tính giá trị p với bậc tự do n − 2, trong khi tương quan riêng phần kiểm soát hai biến có bậc tự do n − 4. Với 263 phiếu, sai khác này không đáng kể. Trong SPSS, dùng menu Analyze > Correlate > Partial.
7. Tương quan và các bước phân tích tiếp theo
Ma trận tương quan còn được dùng cho hai việc kiểm tra sơ bộ:
Đa cộng tuyến. Hồi quy ở bài hồi quy tuyến tính bội dùng XN, HI, HL, NT làm biến độc lập. Nếu hai biến độc lập tương quan rất cao (từ khoảng 0,80 trở lên), hồi quy khó tách riêng tác động của từng biến. Tương quan lớn nhất giữa các biến độc lập ở đây là 0,544 (HI – HL), không đáng lo. Kiểm tra chính thức bằng hệ số VIF sẽ được làm ở bài kiểm định giả định hồi quy.
Giá trị phân biệt. Hai thang đo đo hai khái niệm khác nhau không nên tương quan quá cao. Kline (2016) cho rằng tương quan từ 0,85 trở lên giữa hai biến tiềm ẩn là dấu hiệu chúng khó phân biệt. Mọi tương quan ở đây đều dưới 0,55. Giá trị phân biệt sẽ được kiểm định chặt chẽ hơn bằng AVE và HTMT ở các cụm bài AMOS và SmartPLS.
Tương quan không phải là nhân quả. HL tương quan với YD không chứng minh rằng tăng sự hài lòng sẽ làm tăng ý định mua lại. Quan hệ có thể theo chiều ngược lại, hoặc cả hai cùng do một biến khác gây ra. Thiết kế khảo sát cắt ngang như nghiên cứu này không thể chứng minh nhân quả; lý thuyết mới là cơ sở cho chiều tác động trong mô hình.
8. Trình bày bảng tương quan theo chuẩn APA
Trong luận văn và bài báo, bảng tương quan thường kết hợp thống kê mô tả, ma trận tương quan và Cronbach's Alpha (American Psychological Association, 2020) (Bảng 3):
Bảng 3. Thống kê mô tả và ma trận tương quan theo chuẩn APA.
| Biến | M | SD | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|---|
| 1. Xác nhận kỳ vọng (XN) | 3,89 | 0,76 | (0,82) | ||||
| 2. Nhận thức hữu ích (HI) | 3,91 | 0,79 | 0,49** | (0,83) | |||
| 3. Sự hài lòng (HL) | 3,89 | 0,76 | 0,54** | 0,54** | (0,84) | ||
| 4. Niềm tin (NT) | 3,90 | 0,80 | 0,33** | 0,12 | 0,23** | (0,83) | |
| 5. Ý định mua lại (YD) | 3,86 | 0,73 | 0,39** | 0,39** | 0,44** | 0,38** | (0,79) |
Ghi chú: N từ 264 đến 267 (loại theo cặp). Giá trị trong ngoặc trên đường chéo là Cronbach's Alpha. ** p < ,01.
Ba quy ước của APA: chỉ trình bày nửa dưới ma trận, đánh số cột thay vì lặp tên biến và ghi chú mức ý nghĩa dưới bảng. PSPP đánh dấu "a" cho mức 0,05, còn bảng báo cáo thường dùng một sao cho p < ,05 và hai sao cho p < ,01.
Đoạn văn mẫu: "Bảng 4.x trình bày thống kê mô tả và tương quan Pearson giữa các biến nghiên cứu. Ý định mua lại tương quan dương, ở mức trung bình, với Sự hài lòng (r = 0,44; KTC 95% [0,33; 0,53]), Xác nhận kỳ vọng (r = 0,39), Nhận thức hữu ích (r = 0,39) và Niềm tin (r = 0,38), đều có ý nghĩa ở mức p < ,001. Sự hài lòng tương quan mạnh với Xác nhận kỳ vọng và Nhận thức hữu ích (r = 0,54). Tương quan giữa Nhận thức hữu ích và Niềm tin nhỏ và không có ý nghĩa thống kê (r = 0,12; p = ,051). Mọi tương quan giữa các biến độc lập đều dưới 0,60, cho thấy khả năng đa cộng tuyến thấp."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi đọc và báo cáo tương quan.
- Chạy tương quan mà không xem biểu đồ phân tán, bỏ sót quan hệ cong hoặc ngoại lai.
- Diễn giải tương quan như quan hệ nhân quả, ví dụ "sự hài lòng làm tăng ý định mua lại 0,435".
- Chỉ báo cáo "có ý nghĩa" hay "không có ý nghĩa" mà không nêu độ lớn và khoảng tin cậy của r.
- Dùng Pearson cho biến lệch nặng hoặc có ngoại lai như số lần mua, thay vì Spearman hoặc kiểm tra lại khi bỏ ngoại lai.
- Chọn kiểm định một phía sau khi đã thấy kết quả, để biến p = 0,051 thành p = 0,026.
Tài liệu tham khảo
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
Bishara, A. J., & Hittner, J. B. (2012). Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches. Psychological Methods, 17(3), 399–417. https://doi.org/10.1037/a0028087
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysisfor-the-Behavioral-Sciences/Cohen/p/book/9780805802832
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74–78. https://doi.org/10.1016/j.paid.2016.06.069
Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462523344
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003097