
KIỂM ĐỊNH GIẢ ĐỊNH HỒI QUY TUYẾN TÍNH TRONG SPSS/PSPP
Kiểm tra tuyến tính, độc lập phần dư, phương sai không đổi, phân phối chuẩn, đa cộng tuyến và điểm có ảnh hưởng
Bài nên đọc trước
Bài hồi quy tuyến tính bội đã ước lượng mô hình hồi quy và kết luận cả sáu giả thuyết đều được dữ liệu ủng hộ. Nhưng các giá trị p và khoảng tin cậy trong bảng Coefficients chỉ đáng tin khi mô hình thỏa một số giả định. Nếu phần dư có phương sai thay đổi mạnh, sai số chuẩn có thể bị đánh giá thấp và một hệ số "có ý nghĩa" thật ra không có ý nghĩa. Nếu một vài phiếu bất thường chi phối kết quả, kết luận có thể không còn đúng khi bỏ chúng đi.
Bài viết này kiểm tra lần lượt năm giả định và các điểm có ảnh hưởng cho Mô hình 2 của bài hồi quy tuyến tính bội (biến phụ thuộc YD, bốn biến độc lập XN, HI, HL, NT, N = 263). PSPP 2.0 chỉ lưu được giá trị dự đoán và phần dư, nên bài hướng dẫn tính các thống kê còn lại bằng cú pháp. Mọi kết quả là kết quả thật từ file gia_dinh_hoi_quy.sps đi kèm (Free Software Foundation, 2023) và đã được đối chiếu với thư viện statsmodels trong Python.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
15-kiem-dinh-gia-dinh-hoi-quycủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Năm giả định và vì sao chúng quan trọng
Hồi quy tuyến tính chỉ cho kết quả đáng tin khi dữ liệu thỏa năm giả định (Hình 1).
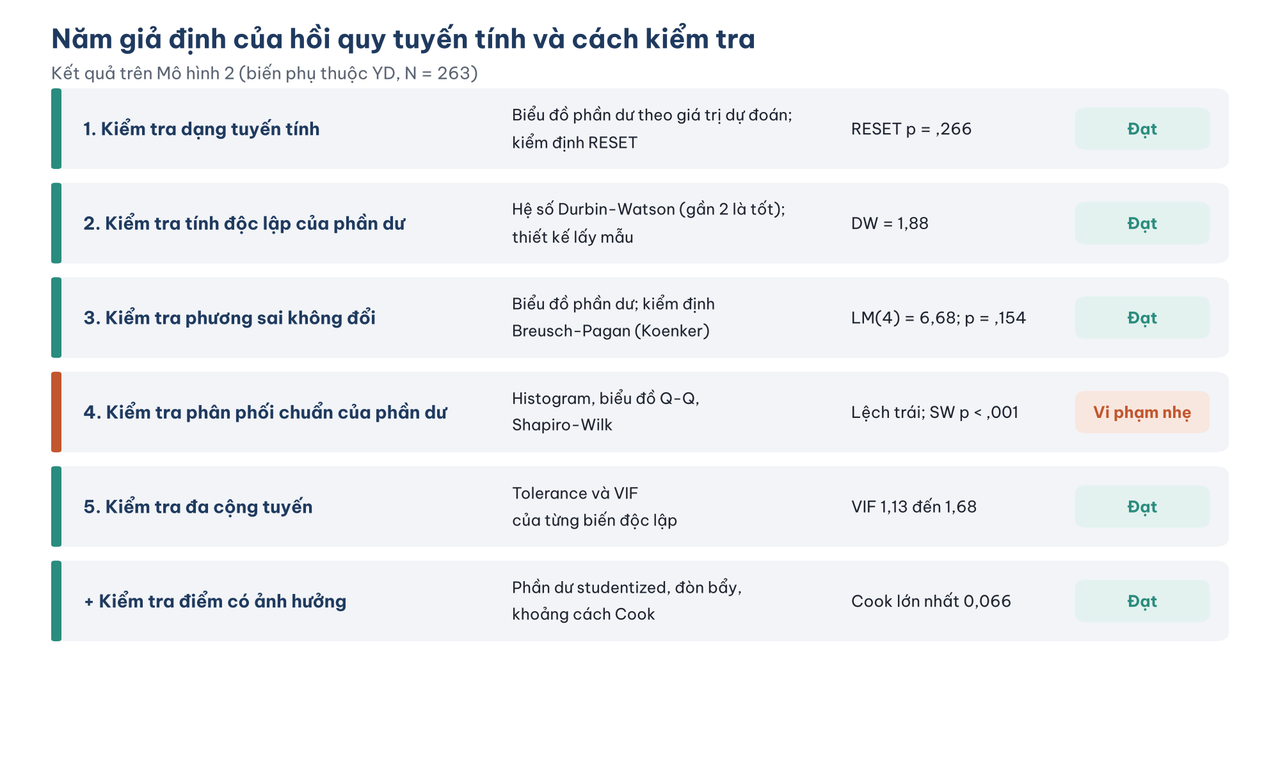
Hình 1. Kết quả kiểm tra trên Mô hình 2: bốn giả định đạt, phân phối chuẩn của phần dư vi phạm nhẹ.
Một điểm quan trọng thường bị hiểu sai: các giả định nói về phần dư (sai số của mô hình), không nói về các biến. Williams và cộng sự (2013) chỉ ra hai hiểu lầm phổ biến: cho rằng biến độc lập và biến phụ thuộc phải có phân phối chuẩn và coi đa cộng tuyến là một giả định. Thực tế, hồi quy không yêu cầu biến có phân phối chuẩn. Đa cộng tuyến không phải là giả định, mà là một vấn đề của dữ liệu làm sai số chuẩn tăng cao.
Mỗi giả định ảnh hưởng đến một phần khác nhau của kết quả (Bảng 1):
Bảng 1. Hệ quả khi vi phạm từng giả định.
| Giả định | Nếu vi phạm thì sao? |
|---|---|
| Tuyến tính | Hệ số hồi quy bị sai lệch, mô hình mô tả sai quan hệ |
| Độc lập của phần dư | Sai số chuẩn bị đánh giá thấp, giá trị p quá nhỏ |
| Phương sai không đổi | Sai số chuẩn và giá trị p không chính xác |
| Phân phối chuẩn của phần dư | Giá trị p và khoảng tin cậy kém chính xác khi mẫu nhỏ |
| Không có đa cộng tuyến cao | Sai số chuẩn tăng, hệ số không ổn định, khó tách tác động riêng |
2. Lưu giá trị dự đoán và phần dư
Trong hộp thoại Regression (bài hồi quy tuyến tính bội), bấm Save và đánh dấu cả hai ô (Hình 2).
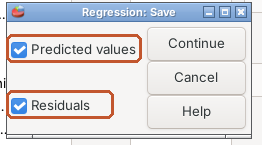
Hình 2. PSPP chỉ có hai lựa chọn: giá trị dự đoán và phần dư.
Đây là giới hạn lớn nhất của PSPP khi kiểm tra giả định. SPSS cho lưu thêm phần dư chuẩn hóa, phần dư studentized, khoảng cách Cook, đòn bẩy, khoảng cách Mahalanobis và có nút Plots vẽ sẵn biểu đồ phần dư. PSPP 2.0 không có các tùy chọn này, cũng không có lựa chọn Durbin-Watson. File cú pháp tính bù tất cả.
File cú pháp làm việc trên bản sao dữ liệu chỉ gồm 263 phiếu đầy đủ năm biến, để mọi thống kê dựa trên cùng một tập phiếu với mô hình:
DATASET NAME CHINH.
DATASET COPY HQ.
DATASET ACTIVATE HQ.
SELECT IF NMISS(XN, HI, HL, NT, YD) = 0.
REGRESSION /VARIABLES=XN HI HL NT /DEPENDENT=YD /METHOD=ENTER
  /STATISTICS=COEFF R ANOVA TOL /SAVE=PRED RESID.
RENAME VARIABLES (PRED1 = DUDOAN) (RES1 = PHANDU).
PSPP đặt tên hai biến mới là PRED1 và RES1. Lệnh RENAME VARIABLES đổi sang tên dễ hiểu. Tiếp theo, phần dư chuẩn hóa (ZRESID) được tính bằng phần dư chia cho sai số chuẩn của ước lượng, đúng như cách SPSS tính:
COMPUTE PD2 = PHANDU ** 2.
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /SSE = SUM(PD2) /N_HQ = N(PHANDU)
  /TB_DD = MEAN(DUDOAN) /SD_DD = SD(DUDOAN).
COMPUTE ZRESID = PHANDU / SQRT(SSE / (N_HQ - 5)).
COMPUTE ZPRED = (DUDOAN - TB_DD) / SD_DD.
AGGREGATE với MODE=ADDVARIABLES tính tổng bình phương phần dư (SSE) trên toàn bộ phiếu và gắn giá trị đó vào từng phiếu. Con số 5 là số tham số của mô hình: 4 hệ số và hằng số.
3. Kiểm tra đa cộng tuyến
Đa cộng tuyến xảy ra khi các biến độc lập tương quan quá cao với nhau. Hai thống kê trong bảng Coefficients (với /STATISTICS=TOL) đo vấn đề này:
- Tolerance = 1 − R²ⱼ, với R²ⱼ là R² khi hồi quy biến độc lập thứ j theo các biến độc lập còn lại. Tolerance nhỏ nghĩa là biến đó gần như được giải thích hoàn toàn bởi các biến khác.
- VIF (Variance Inflation Factor) = 1 / Tolerance, cho biết phương sai của hệ số bị "thổi phồng" bao nhiêu lần do đa cộng tuyến.
Hình 3 là kết quả đa cộng tuyến của Mô hình 2.
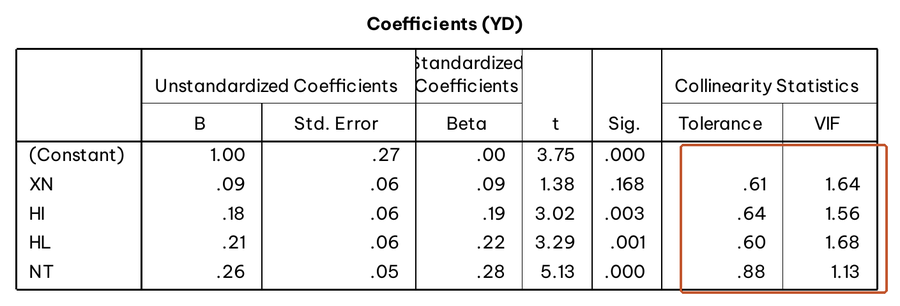
Hình 3. Tolerance từ 0,60 đến 0,88; VIF từ 1,13 đến 1,68.
Hair và cộng sự (2019) dùng ngưỡng phổ biến VIF > 10 (Tolerance < 0,10) để cảnh báo đa cộng tuyến nghiêm trọng và nhiều tác giả dùng ngưỡng chặt hơn là 5. VIF lớn nhất trong Mô hình 2 là 1,68 (HL), thấp xa cả hai ngưỡng. Nói cách khác, sai số chuẩn của hệ số HL lớn hơn khoảng √1,68 ≈ 1,3 lần so với khi HL hoàn toàn không tương quan với các biến độc lập khác. Đa cộng tuyến không phải là vấn đề ở đây, đúng như ma trận tương quan ở bài tương quan Pearson đã gợi ý.
4. Kiểm tra dạng tuyến tính
Mô hình giả định quan hệ giữa các biến độc lập và YD là đường thẳng. Có hai cách kiểm tra.
Bằng biểu đồ. Vẽ phần dư chuẩn hóa theo giá trị dự đoán chuẩn hóa:
GRAPH /SCATTERPLOT(BIVAR)=ZPRED WITH ZRESID.
Hình 4 là biểu đồ phần dư theo giá trị dự đoán.
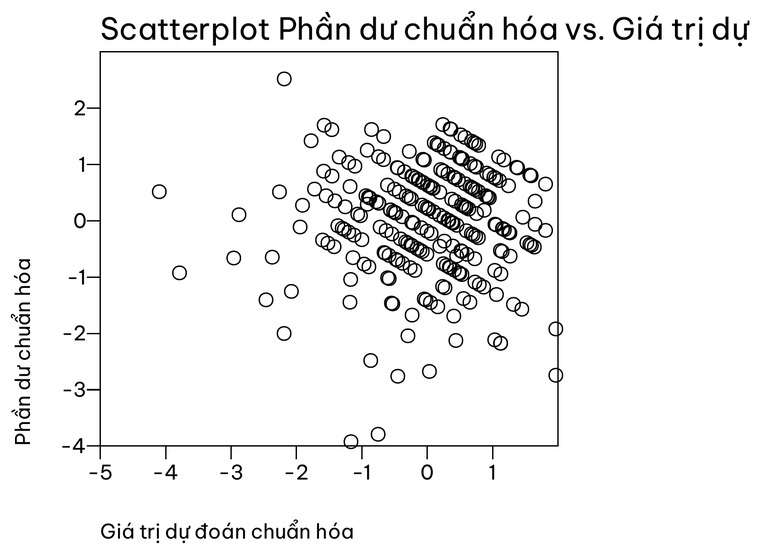
Hình 4. Biểu đồ phần dư của PSPP. Các điểm phân tán quanh 0, không có dạng cong rõ ràng.
Nếu quan hệ tuyến tính, các điểm phân tán ngẫu nhiên quanh đường 0, không tạo thành hình chữ U hay chữ U ngược. Biểu đồ của dữ liệu mẫu đạt yêu cầu này. Bạn sẽ thấy các điểm xếp thành những đường chéo song song. Đây không phải dấu hiệu vi phạm: YD chỉ nhận các giá trị rời rạc như 3,00; 3,25; 3,50, nên các phiếu có cùng giá trị YD nằm trên cùng một đường chéo có độ dốc −1.
Bằng kiểm định RESET (Ramsey, 1969). Thêm bình phương giá trị dự đoán vào mô hình. Nếu quan hệ thật sự là tuyến tính, biến thêm vào này sẽ không giải thích thêm được gì:
COMPUTE DD2 = DUDOAN ** 2.
REGRESSION /VARIABLES=XN HI HL NT DD2 /DEPENDENT=YD /METHOD=ENTER /STATISTICS=COEFF.
Hệ số của DD2 có t = −1,11 và p = 0,266, không có ý nghĩa. Giả định tuyến tính được thỏa.
5. Kiểm tra tính độc lập của phần dư
Phần dư của các phiếu phải độc lập với nhau. Giả định này chủ yếu được bảo đảm bằng thiết kế nghiên cứu: mỗi đáp viên trả lời một lần, độc lập với người khác. Giả định bị vi phạm khi dữ liệu có cấu trúc nhóm (nhiều nhân viên trong cùng một cửa hàng) hoặc theo thời gian (cùng một người được khảo sát nhiều lần).
Hệ số Durbin-Watson (Durbin & Watson, 1951) kiểm tra tự tương quan giữa phần dư của các phiếu liền kề:
DW = Σ(eᵢ − eᵢ₋₁)² / Σeᵢ²
DW nằm trong khoảng 0 đến 4. DW gần 2 nghĩa là không có tự tương quan. Field (2024) cho rằng DW dưới 1 hoặc trên 3 là đáng lo và giá trị càng gần 2 càng tốt. PSPP không có lựa chọn Durbin-Watson, nhưng công thức trên tính được bằng hàm LAG:
SORT CASES BY ID.
COMPUTE CHENH2 = (PHANDU - LAG(PHANDU)) ** 2.
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /TONG_CHENH2 = SUM(CHENH2).
COMPUTE DW = TONG_CHENH2 / SSE.
LAG(PHANDU) lấy phần dư của phiếu ngay trước. Kết quả: DW = 1,877, rất gần 2.
Cần hiểu đúng ý nghĩa của con số này: DW phụ thuộc vào thứ tự các phiếu trong file. Với dữ liệu khảo sát cắt ngang, thứ tự phiếu (theo ID, tức thứ tự thu về) thường không có ý nghĩa đặc biệt, nên DW chỉ kiểm tra được một dạng phụ thuộc rất hẹp: những người trả lời gần nhau về thời gian có phần dư giống nhau không. DW chủ yếu hữu ích với dữ liệu chuỗi thời gian. Với khảo sát, hãy mô tả cách lấy mẫu để chứng minh tính độc lập và báo cáo DW như một kiểm tra bổ sung.
6. Kiểm tra phương sai không đổi
Phương sai của phần dư phải như nhau ở mọi mức giá trị dự đoán (homoscedasticity). Khi phương sai thay đổi (heteroscedasticity), biểu đồ phần dư có hình phễu: các điểm tản rộng ở một đầu và co hẹp ở đầu kia.
Biểu đồ ở Hình 4 không có hình phễu rõ ràng. Để có kết luận khách quan hơn, dùng kiểm định Breusch-Pagan (Breusch & Pagan, 1979), phiên bản của Koenker (1981) vững hơn khi phần dư không chuẩn. Ý tưởng của kiểm định: nếu phương sai không đổi, các biến độc lập không thể dự đoán được độ lớn của bình phương phần dư. Cách làm trong PSPP:
REGRESSION /VARIABLES=XN HI HL NT /DEPENDENT=PD2 /METHOD=ENTER /STATISTICS=R ANOVA.
Thống kê kiểm định là LM = N × R² của hồi quy phụ này, có phân phối khi bình phương với bậc tự do bằng số biến độc lập. Hồi quy phụ có R² = 2,80 / 110,22 = 0,0254, nên LM = 263 × 0,0254 = 6,68, với 4 bậc tự do, p = 0,154. Không bác bỏ giả thuyết phương sai không đổi. Kiểm định F của chính hồi quy phụ cho kết luận tương tự (F(4, 258) = 1,68; p = 0,155).
7. Kiểm tra phân phối chuẩn của phần dư
EXAMINE VARIABLES=ZRESID /PLOT=HISTOGRAM NPPLOT /STATISTICS=DESCRIPTIVES EXTREME(5) /ID=ID.
Hình 5 cho thấy phân phối của phần dư.
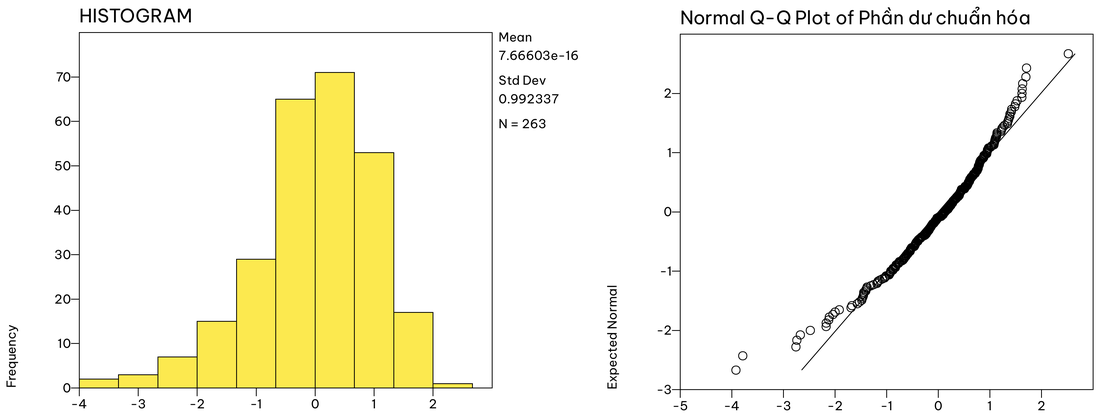
Hình 5. Phần dư lệch trái: đuôi bên trái dài hơn và trên biểu đồ Q-Q các điểm ở đầu dưới nằm lệch khỏi đường thẳng.
Đây là giả định duy nhất bị vi phạm. Phần dư có độ lệch −0,81 và độ nhọn 1,23. Kiểm định Shapiro-Wilk cho W = 0,96, p < ,001. Trên biểu đồ Q-Q, phần lớn các điểm nằm sát đường thẳng, nhưng ở đầu dưới có một số phiếu có phần dư âm lớn: những người có ý định mua lại thấp hơn nhiều so với mô hình dự đoán.
Vì sao phần dư lệch trái?
Nguyên nhân nằm ở dữ liệu. YD bị giới hạn trên ở mức 5 và phần lớn đáp viên đã ở gần mức này (bài thống kê mô tả). Một khách hàng được dự đoán YD = 4,5 chỉ có thể có phần dư dương tối đa 0,5, nhưng có thể có phần dư âm tới −3,5. Đây là hiệu ứng trần thường gặp với thang Likert khi đáp viên nghiêng hẳn về phía đồng ý.
Có cần lo không?
Với cỡ mẫu lớn, vi phạm phân phối chuẩn ít ảnh hưởng đến hồi quy. Theo định lý giới hạn trung tâm, các hệ số hồi quy có phân phối xấp xỉ chuẩn khi cỡ mẫu đủ lớn, dù phần dư không chuẩn. Lumley và cộng sự (2002) cho thấy với vài trăm quan sát, các kiểm định dựa trên phân phối chuẩn vẫn cho kết quả đáng tin cậy. Kiểm định Shapiro-Wilk thì ngược lại: mẫu càng lớn, càng dễ có ý nghĩa với những sai lệch rất nhỏ (bài thống kê mô tả).
Để kiểm chứng, script kiem_tra_python.py đi kèm tính khoảng tin cậy bootstrap (5.000 mẫu lặp), một phương pháp không cần giả định phân phối chuẩn (Bảng 2):
Bảng 2. Khoảng tin cậy 95% theo OLS và theo bootstrap.
| Biến | KTC 95% theo OLS | KTC 95% bootstrap |
|---|---|---|
| XN | −0,04 đến 0,21 | −0,02 đến 0,19 |
| HI | 0,06 đến 0,30 | 0,06 đến 0,30 |
| HL | 0,08 đến 0,34 | 0,09 đến 0,34 |
| NT | 0,16 đến 0,36 | 0,17 đến 0,35 |
Hai cách cho khoảng tin cậy gần như trùng nhau và kết luận về ý nghĩa của từng biến không thay đổi. Vi phạm phân phối chuẩn không ảnh hưởng đến kết luận của nghiên cứu.
8. Điểm có ảnh hưởng
Một vài phiếu bất thường có thể kéo đường hồi quy về phía chúng. Ba thống kê đo điều này:
- Phần dư studentized: phần dư chia cho sai số chuẩn riêng của từng phiếu. Trị tuyệt đối lớn hơn 3 là phiếu mà mô hình dự đoán rất kém.
- Đòn bẩy (leverage, h): mức độ bất thường của phiếu về các biến độc lập. Phiếu có tổ hợp XN, HI, HL, NT khác xa phần còn lại có đòn bẩy cao. Ngưỡng hay dùng là 2(k + 1)/N = 10/263 = 0,038 (Hoaglin & Welsch, 1978).
- Khoảng cách Cook (Cook, 1977): kết hợp cả phần dư và đòn bẩy, đo mức thay đổi của toàn bộ hệ số hồi quy khi bỏ phiếu đó. Cook > 1 là đáng lo; ngưỡng thận trọng hơn là 4/N = 0,015.
PSPP tính được cả ba bằng lệnh MATRIX, theo đúng công thức đại số: đòn bẩy là đường chéo của ma trận H = X(X′X)⁻¹X′ và khoảng cách Cook là e²/(p × MSE) × h/(1 − h)²:
MATRIX.
GET X /VARIABLES=XN HI HL NT.
GET E /VARIABLES=PHANDU.
GET MAID /VARIABLES=ID.
COMPUTE N = NROW(X).
COMPUTE X1 = {MAKE(N, 1, 1), X}.
COMPUTE P = NCOL(X1).
COMPUTE H = DIAG(X1 * INV(T(X1) * X1) * T(X1)).
COMPUTE MSE = CSSQ(E) / (N - P).
COMPUTE COOK = (E &** 2 / (P * MSE)) &* (H &/ (1 - H) &** 2).
COMPUTE SRESID = E &/ SQRT(MSE * (1 - H)).
SAVE {MAID, H, COOK, SRESID} /OUTFILE='../du-lieu/anh_huong.sav' /VARIABLES=ID DONBAY COOK SRESID.
END MATRIX.
Kết quả trùng khớp với thư viện statsmodels trong Python đến ba chữ số thập phân. Sáu phiếu có khoảng cách Cook lớn nhất (Hình 6):
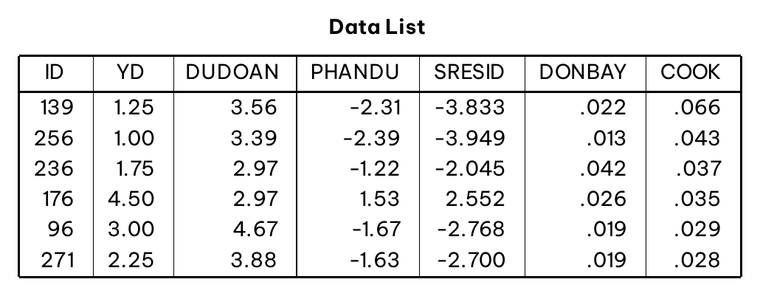
Hình 6. Phiếu 139 và 256 có phần dư studentized gần −4: ý định mua lại chỉ 1,25 và 1,00 trong khi mô hình dự đoán khoảng 3,5.
Tổng hợp (Bảng 3):
Bảng 3. Các tiêu chí phát hiện điểm có ảnh hưởng.
| Tiêu chí | Ngưỡng | Số phiếu vượt ngưỡng | Giá trị lớn nhất |
|---|---|---|---|
| Khoảng cách Cook | > 1 | 0 | 0,066 (phiếu 139) |
| Khoảng cách Cook | > 4/N = 0,015 | 12 | |
| Đòn bẩy | > 0,038 | 19 | 0,069 |
| Phần dư studentized | Trị tuyệt đối > 3 | 2 (phiếu 139, 256) | −3,95 |
Không phiếu nào có khoảng cách Cook gần ngưỡng 1. Hai phiếu 139 và 256 là những khách hàng có đánh giá tương đối tốt về sàn X nhưng gần như không có ý định mua lại. Đây là câu trả lời hợp lệ (có thể họ đã chuyển sang sàn khác vì lý do ngoài mô hình), không phải lỗi dữ liệu, nên không loại (bài làm sạch dữ liệu).
Phân tích độ nhạy
Để chắc chắn kết luận không phụ thuộc vào vài phiếu, file cú pháp chạy lại hồi quy khi bỏ 12 phiếu có Cook > 4/N (Bảng 4):
Bảng 4. Hệ số hồi quy trước và sau khi bỏ 12 phiếu có ảnh hưởng.
| Biến | β (263 phiếu) | p | β (251 phiếu) | p |
|---|---|---|---|---|
| XN | 0,09 | ,168 | 0,11 | ,078 |
| HI | 0,19 | ,003 | 0,24 | < ,001 |
| HL | 0,22 | ,001 | 0,15 | ,019 |
| NT | 0,28 | < ,001 | 0,34 | < ,001 |
| R² | 0,31 | 0,36 |
Độ lớn của các hệ số thay đổi đôi chút, nhưng kết luận về giả thuyết không đổi: HI, HL, NT vẫn có tác động dương có ý nghĩa, XN vẫn không có ý nghĩa ở mức 0,05. Kết quả chính được báo cáo trên đủ 263 phiếu và phân tích độ nhạy được nêu như một bằng chứng về độ vững của kết quả.
9. Bốn biểu đồ chẩn đoán trong một hình
Phần mềm thống kê như R thường gộp bốn biểu đồ chẩn đoán vào một hình. Script tao_hinh.py vẽ hình tương tự từ dữ liệu mẫu, tiện cho việc đưa vào phụ lục luận văn (Hình 7):
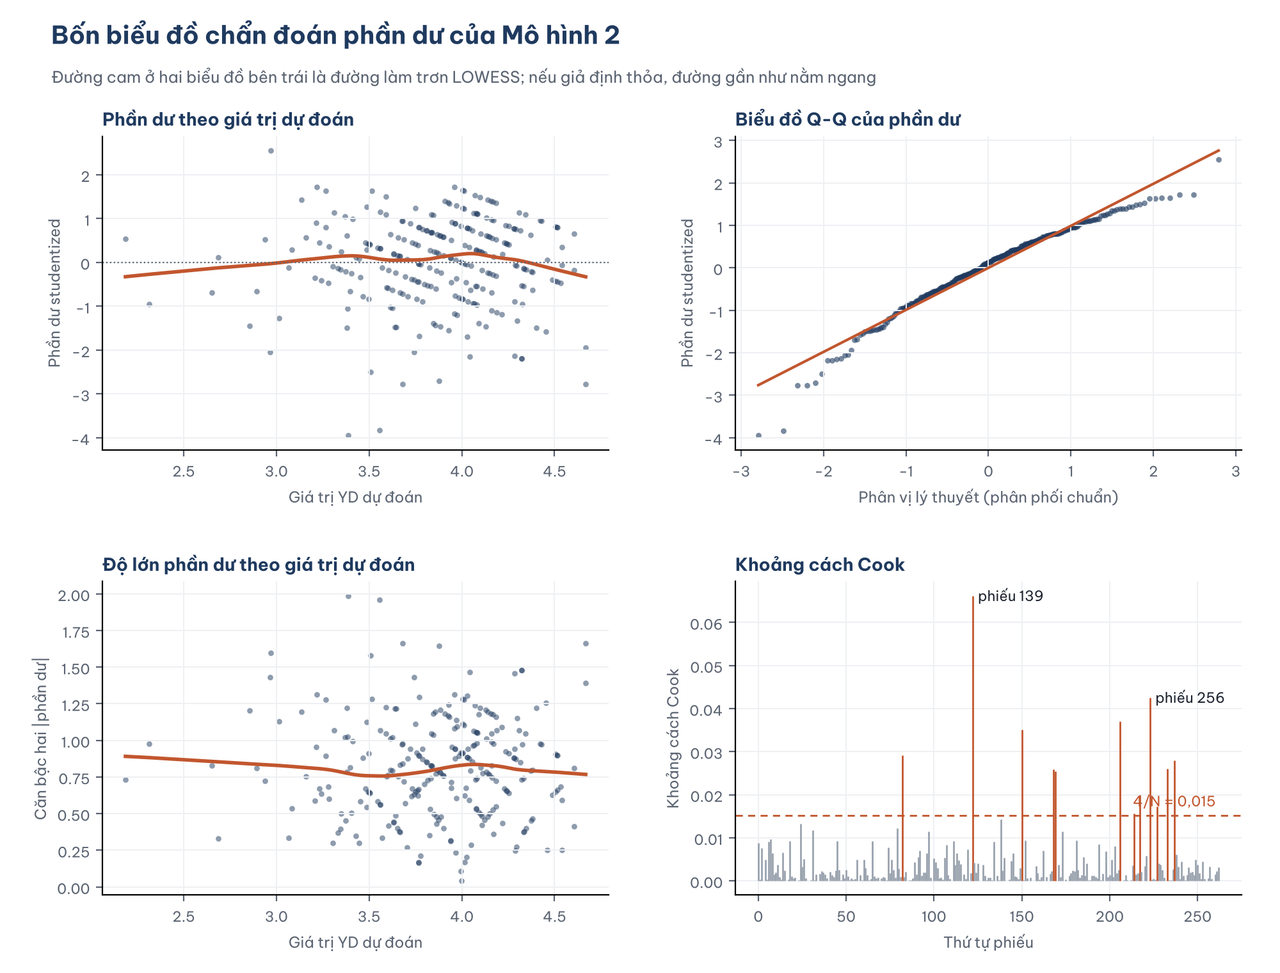
Hình 7. Đường làm trơn ở hai biểu đồ bên trái gần như nằm ngang (tuyến tính và phương sai không đổi được thỏa). Biểu đồ Q-Q lệch ở đầu dưới. Khoảng cách Cook đều rất nhỏ so với ngưỡng 1.
10. Xử lý khi giả định bị vi phạm
Dữ liệu mẫu chỉ vi phạm nhẹ một giả định, nhưng với dữ liệu thật, bạn có thể gặp vi phạm nặng hơn. Các cách xử lý thường dùng (Bảng 5):
Bảng 5. Cách xử lý khi giả định bị vi phạm.
| Vi phạm | Cách xử lý |
|---|---|
| Không tuyến tính | Thêm bình phương của biến độc lập; biến đổi biến (log); xem lại lý thuyết |
| Phương sai thay đổi | Dùng sai số chuẩn vững HC3 (Hayes & Cai, 2007); bootstrap; hồi quy có trọng số |
| Phần dư không chuẩn, mẫu nhỏ | Bootstrap khoảng tin cậy; biến đổi biến phụ thuộc |
| Đa cộng tuyến cao | Gộp các biến tương quan cao nếu chúng đo cùng khái niệm; bỏ bớt biến; thu thêm dữ liệu |
| Điểm có ảnh hưởng lớn | Kiểm tra lỗi nhập liệu; báo cáo kết quả có và không có các điểm đó |
| Phần dư không độc lập | Mô hình đa cấp (multilevel) hoặc sai số chuẩn theo cụm |
PSPP và SPSS bản cơ bản không có sẵn sai số chuẩn HC3. Để đối chiếu, script kiem_tra_python.py tính sai số chuẩn HC3 cho Mô hình 2: các sai số chuẩn gần như không đổi (ví dụ HL: 0,064 so với 0,064) và XN vẫn không có ý nghĩa (p = 0,118). Điều này nhất quán với kết quả kiểm định Breusch-Pagan.
11. Trình bày trong báo cáo
Phần kiểm tra giả định thường được viết ngắn gọn trong chương kết quả, kèm biểu đồ trong phụ lục. Đoạn văn mẫu:
"Các giả định của hồi quy tuyến tính được kiểm tra trên Mô hình 2. Hệ số VIF từ 1,13 đến 1,68 cho thấy không có đa cộng tuyến. Kiểm định RESET (p = ,266) và biểu đồ phần dư không cho thấy dấu hiệu quan hệ phi tuyến. Kiểm định Breusch-Pagan không bác bỏ giả định phương sai không đổi (LM = 6,68; df = 4; p = ,154). Hệ số Durbin-Watson bằng 1,88. Phần dư lệch trái nhẹ (độ lệch −0,81; Shapiro-Wilk p < ,001), phản ánh hiệu ứng trần của thang đo Ý định mua lại; với cỡ mẫu 263, khoảng tin cậy bootstrap (5.000 mẫu lặp) gần như trùng với khoảng tin cậy thông thường. Không có phiếu nào có khoảng cách Cook lớn hơn 0,07 và kết luận về các giả thuyết không thay đổi khi loại 12 phiếu có khoảng cách Cook lớn hơn 4/N."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi kiểm định giả định hồi quy.
- Kiểm tra phân phối chuẩn của biến thay vì phân phối chuẩn của phần dư.
- Kết luận mô hình "không dùng được" chỉ vì Shapiro-Wilk có ý nghĩa ở mẫu lớn, mà không xem mức độ lệch và kiểm tra bằng bootstrap.
- Báo cáo Durbin-Watson như bằng chứng duy nhất của tính độc lập với dữ liệu khảo sát cắt ngang, trong khi giá trị này phụ thuộc vào thứ tự phiếu.
- Xóa các phiếu có khoảng cách Cook lớn mà không kiểm tra lý do và không báo cáo kết quả trước khi xóa.
- Chỉ nhìn VIF < 10 mà bỏ qua khi VIF từ 5 đến 10, mức đã đủ làm hệ số không ổn định ở mẫu nhỏ.
Tài liệu tham khảo
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression. II. Biometrika, 38(1/2), 159–178. https://doi.org/10.2307/2332325
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/BF03192961
Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237
Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90062-2
Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18(11). https://doi.org/10.7275/55hn-wk47