
LÀM SẠCH DỮ LIỆU KHẢO SÁT TRONG SPSS/PSPP
Bảy bước loại phiếu không hợp lệ, sửa lỗi nhập liệu, đánh giá giá trị thiếu và phát hiện ngoại lai
Bài nên đọc trước
Dữ liệu khảo sát vừa nhập xong hầu như không bao giờ sẵn sàng để phân tích. Có người chưa từng mua hàng nhưng vẫn trả lời hết bảng hỏi, có người chọn "Đồng ý" cho mọi câu trong vài giây, có ô bị gõ nhầm 55 thay vì 5. Nếu đưa thẳng những phiếu này vào Cronbach's Alpha hay hồi quy, kết quả có thể sai mà phần mềm không cảnh báo gì.
Bài viết này hướng dẫn quy trình làm sạch dữ liệu gồm 7 bước, thực hành trên bộ dữ liệu mẫu 300 phiếu về ý định mua lại trên sàn X. Bộ dữ liệu này được cài sẵn các lỗi thường gặp. Mọi con số và bảng kết quả trong bài đều là kết quả chạy thật trên PSPP 2.0 (Free Software Foundation, 2023) bằng file cú pháp lam_sach.sps đi kèm. Cú pháp PSPP tương thích với SPSS nên lệnh và thao tác trong SPSS giống hệt (GNU Project, n.d.).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
08-lam-sach-du-lieu-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Tổng quan quy trình làm sạch dữ liệu
Làm sạch dữ liệu đi theo một thứ tự nhất định, vì kết quả của bước trước ảnh hưởng đến bước sau. Hình 1 trình bày bảy bước cùng kết quả của từng bước trên bộ dữ liệu mẫu.
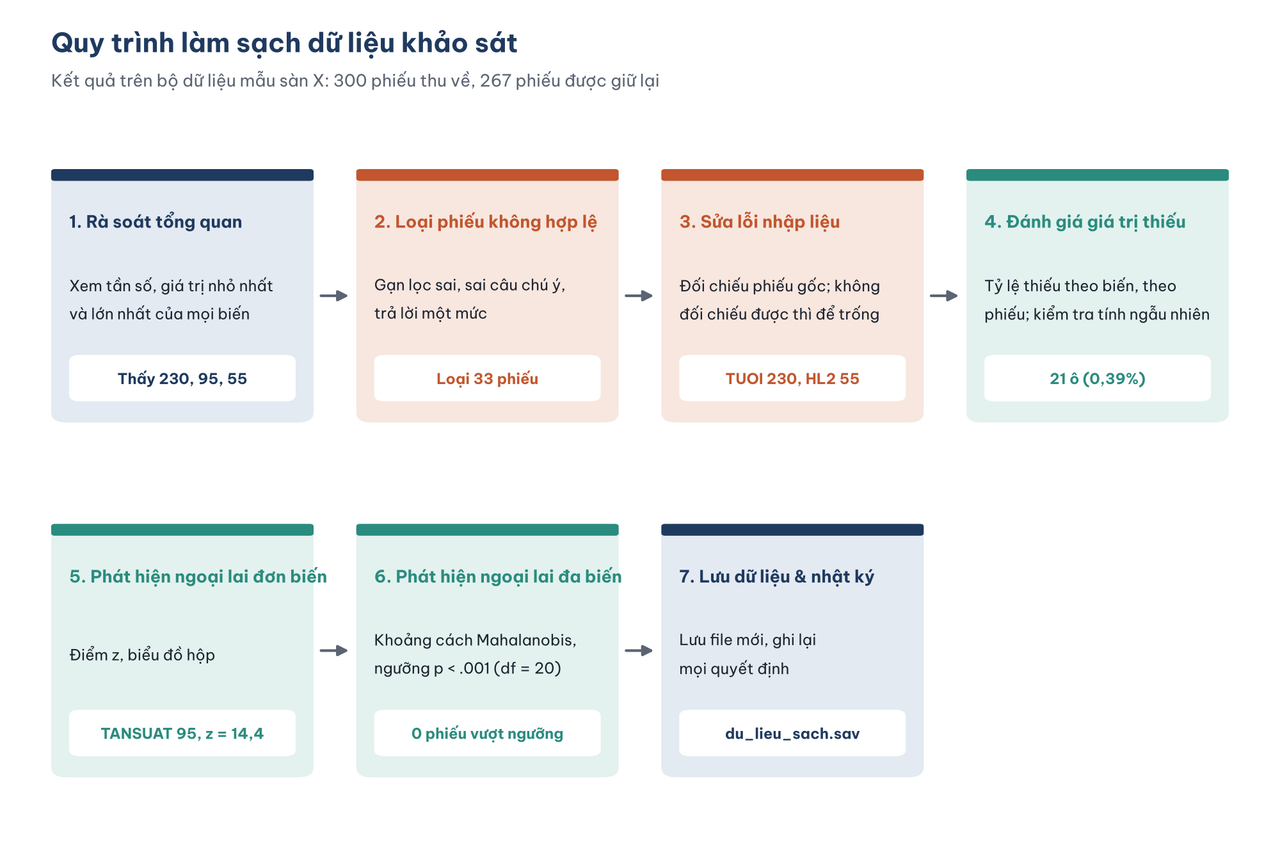
Hình 1. Bảy bước làm sạch dữ liệu và kết quả của từng bước trên bộ dữ liệu mẫu.
Thứ tự các bước có lý do. Phải loại phiếu không hợp lệ trước khi đánh giá giá trị thiếu và ngoại lai, vì những phiếu này làm sai lệch trung bình, độ lệch chuẩn và ma trận hiệp phương sai mà các bước sau dựa vào. Phải sửa lỗi nhập liệu trước khi tìm ngoại lai, vì một giá trị 55 trong thang 1–5 là lỗi cần sửa, không phải một quan sát bất thường cần cân nhắc.
Nguyên tắc chung cho cả quy trình: không bao giờ ghi đè file gốc. File cú pháp đọc du_lieu_mau_san_x.sav và lưu kết quả thành file mới du_lieu_sach.sav. Mọi quyết định đều nằm trong cú pháp, nên người khác (hoặc chính bạn ba tháng sau) có thể kiểm tra và chạy lại.
2. Bước 1: Rà soát tổng quan dữ liệu
Việc đầu tiên là xem khoảng giá trị của mọi biến. Lệnh DESCRIPTIVES (menu Analyze > Descriptive Statistics > Descriptives) cho biết giá trị nhỏ nhất, lớn nhất, trung bình và độ lệch chuẩn:
DESCRIPTIVES TUOI TANSUAT XN1 TO YD4 /STATISTICS=MEAN STDDEV MIN MAX.
Kết quả ở Hình 2 cho thấy ngay ba dấu hiệu bất thường.
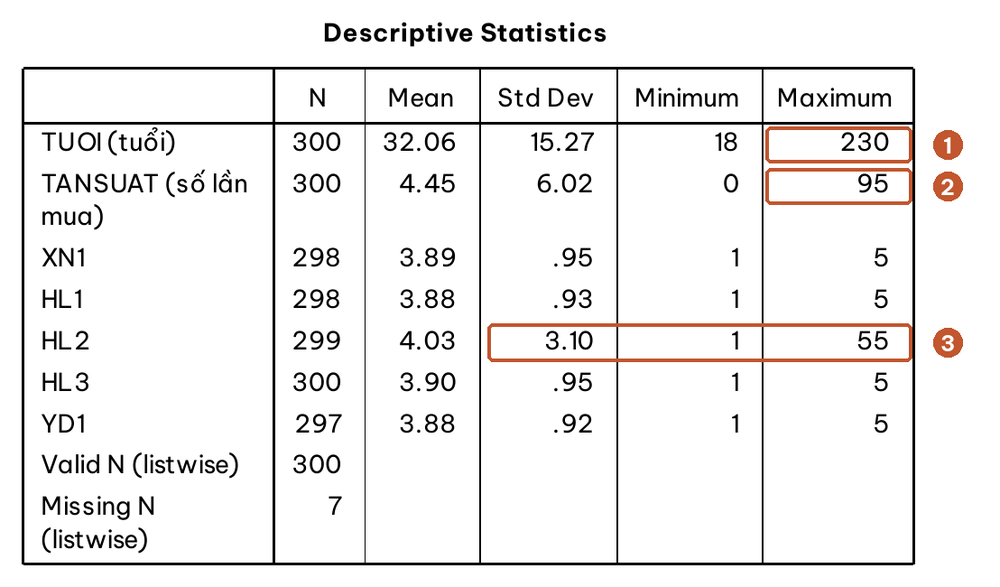
Hình 2. Kết quả DESCRIPTIVES trên dữ liệu thô (trích một số biến): tuổi lớn nhất 230 (1), số lần mua lớn nhất 95 (2), câu HL2 có giá trị 55 và độ lệch chuẩn 3,10, gấp ba lần các câu khác (3).
Ba dấu hiệu bất thường hiện ra ngay:
- Tuổi lớn nhất là 230. Không ai 230 tuổi, nên đây chắc chắn là lỗi nhập liệu (rất có thể là 23 bị gõ thừa số 0).
- Số lần mua lớn nhất là 95 trong 6 tháng, trong khi trung bình chỉ khoảng 4,5. Giá trị này bất thường nhưng có thể xảy ra, tức là khoảng 3–4 lần mỗi tuần. Đây là ngoại lai cần xem xét ở Bước 5, chưa phải lỗi.
- Câu HL2 có giá trị 55 trên thang 1–5. Chỉ một ô sai cũng làm độ lệch chuẩn của HL2 tăng từ khoảng 0,9 lên 3,10.
Cũng nên chạy FREQUENCIES cho các câu kiểm soát (câu gạn lọc SL1 và câu kiểm tra chú ý AC1). Bảng tần số cho thấy 14 người trả lời "Chưa" ở SL1 và 19 người không chọn mức 2 ở câu AC1 "Hãy chọn mức 2 cho câu này".
Mẹo nhỏ: khi biến Likert có nhãn giá trị, PSPP hiển thị Minimum và Maximum bằng nhãn ("Hoàn toàn không đồng ý") thay vì con số. Giá trị nào không có nhãn, như 55, sẽ hiện ra dưới dạng số, nên lại càng dễ thấy.
3. Bước 2: Loại phiếu không hợp lệ
Phiếu không hợp lệ là phiếu không nên có mặt trong mẫu, dù câu trả lời trông có vẻ đầy đủ. Có ba loại thường gặp.
Phiếu không qua câu gạn lọc. Đề tài nghiên cứu khách hàng đã mua trên sàn X trong 6 tháng qua, nên 14 người trả lời "Chưa" ở SL1 không thuộc tổng thể nghiên cứu. Ý kiến của họ về "sự hài lòng với các lần mua hàng" không dựa trên trải nghiệm thật.
Phiếu trả lời sai câu kiểm tra chú ý. Câu kiểm tra chú ý (instructed response item) yêu cầu người trả lời chọn một mức cụ thể. Meade và Craig (2012) khuyến nghị đưa loại câu này vào khảo sát trực tuyến để phát hiện người trả lời qua loa. Ai không làm theo hướng dẫn rõ ràng như vậy thì nhiều khả năng cũng không đọc kỹ các câu khác. Huang và cộng sự (2012) cũng cho thấy câu kiểm tra chú ý và chỉ số trả lời một mức là hai cách hiệu quả để phát hiện kiểu trả lời thiếu nỗ lực.
Phiếu trả lời một mức cho mọi câu (straight-lining). Curran (2016) gọi đây là kiểu trả lời theo chuỗi dài (long-string): người trả lời chọn cùng một mức cho hàng loạt câu liên tiếp. Cách phát hiện đơn giản nhất là tính độ lệch chuẩn của các câu Likert trong cùng một phiếu. Độ lệch chuẩn bằng 0 nghĩa là mọi câu có cùng một đáp án:
COMPUTE DOLECH = SD(XN1 TO HL2, HL3 TO YD4).
Danh sách biến bỏ qua câu AC1, vì câu này nằm giữa HL2 và HL3 trong bảng hỏi. Với bộ dữ liệu mẫu, 8 phiếu có độ lệch chuẩn bằng 0 (Hình 3):
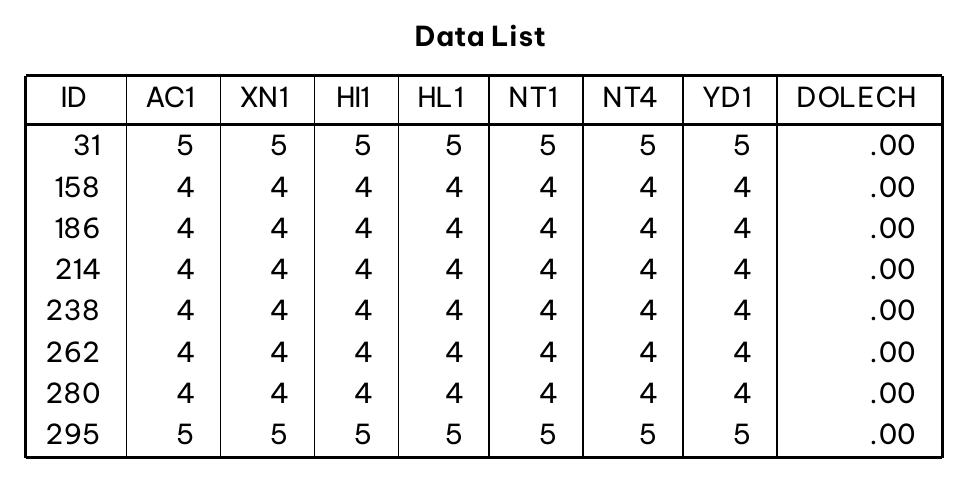
Hình 3. Tám phiếu có DOLECH = 0. Câu NT4 cũng được chọn mức 4 hoặc 5, dù đây là câu hỏi đảo chiều.
Bằng chứng rõ nhất nằm ở câu NT4 "Tôi lo ngại sàn X không giữ đúng cam kết". Đây là câu đảo chiều: người tin tưởng sàn X sẽ chọn mức thấp. Một người "Hoàn toàn đồng ý" rằng họ tin sàn X (NT1 = 5) mà cũng "Hoàn toàn đồng ý" rằng họ lo sàn X không giữ cam kết (NT4 = 5) là đang tự mâu thuẫn. Đây là lý do nên có ít nhất một câu đảo chiều trong bảng hỏi.
Để không xóa nhầm, cú pháp đánh dấu từng loại lỗi bằng biến cờ 0/1 trước, đếm, rồi mới loại:
COMPUTE LOI_GANLOC = (SL1 = 2).
COMPUTE LOI_CHUY = (AC1 <> 2).
COMPUTE LOI_MOTMUC = (DOLECH = 0).
COMPUTE LOAI = MAX(LOI_GANLOC, LOI_CHUY, LOI_MOTMUC).
FREQUENCIES LOI_GANLOC LOI_CHUY LOI_MOTMUC LOAI /STATISTICS=NONE.
CROSSTABS /TABLES=LOI_CHUY BY LOI_MOTMUC.

SELECT IF LOAI = 0.
EXECUTE.
Bảng chéo cho thấy cả 8 phiếu trả lời một mức đều chọn 4 hoặc 5 ở câu AC1, nên cũng sai câu kiểm tra chú ý. Hai cách phát hiện bổ sung cho nhau. Kết quả tổng hợp (Bảng 1):
Bảng 1. Các loại phiếu không hợp lệ trong bộ dữ liệu mẫu.
| Loại lỗi | Số phiếu | Ghi chú |
|---|---|---|
| Không qua câu gạn lọc (SL1 = 2) | 14 | |
| Sai câu kiểm tra chú ý (AC1 ≠ 2) | 19 | Gồm 8 phiếu trả lời một mức |
| Trả lời một mức (DOLECH = 0) | 8 | Đều nằm trong 19 phiếu ở dòng trên |
| Tổng số phiếu bị loại | 33 | 11% số phiếu thu về |
| Số phiếu còn lại | 267 | Vượt cỡ mẫu mục tiêu 250 |
Lệnh SELECT IF xóa vĩnh viễn các phiếu không thỏa điều kiện khỏi dữ liệu đang mở. Trên giao diện, menu Data > Select Cases có hai lựa chọn: lọc tạm thời (Filtered) hoặc xóa (Deleted). Khi chưa chắc chắn, hãy dùng lọc tạm thời và luôn lưu kết quả sang file mới.
4. Bước 3: Sửa lỗi nhập liệu
Lỗi nhập liệu là giá trị không thể xảy ra: nằm ngoài thang đo, ngoài khoảng hợp lệ đã quy định trong bảng mã hóa, hoặc mâu thuẫn logic với câu trả lời khác. Lệnh COUNT giúp tìm mọi ô Likert ngoài khoảng 1–5 trong một lần:
COUNT SAI_THANG = XN1 TO HL2 HL3 TO YD4 (LOWEST THRU 0, 6 THRU HIGHEST).
TEMPORARY.
SELECT IF TUOI > 60 OR TUOI < 18 OR SAI_THANG > 0.
LIST /VARIABLES=ID TUOI SAI_THANG XN1 TO HL2.
TEMPORARY khiến lệnh SELECT IF ngay sau nó chỉ có hiệu lực cho một thủ tục (ở đây là LIST), nên dữ liệu không bị xóa. Kết quả có hai phiếu: phiếu 59 có tuổi 230 và phiếu 257 có HL2 = 55. Khoảng tuổi hợp lệ 18–60 lấy theo đối tượng khảo sát trong bảng mã hóa.
Cách sửa tốt nhất là đối chiếu với phiếu gốc (phiếu giấy hoặc bản ghi Google Forms). Nếu phiếu ghi 23 thì sửa thành 23, ghi 5 thì sửa thành 5. Khi không thể đối chiếu, như với bộ dữ liệu mẫu này, đừng đoán. Hãy chuyển ô đó thành giá trị thiếu:
IF (TUOI > 60 OR TUOI < 18) TUOI = $SYSMIS.
RECODE XN1 TO HL2 HL3 TO YD4 (6 THRU HIGHEST = SYSMIS) (LOWEST THRU 0 = SYSMIS).
Cũng nên kiểm tra tính nhất quán logic giữa các câu. Ví dụ, người trả lời "Có" ở câu gạn lọc mà số lần mua bằng 0 là mâu thuẫn. Trong dữ liệu mẫu, các giá trị TANSUAT = 0 đều thuộc 14 phiếu "Chưa" đã bị loại, nên sau Bước 2 giá trị nhỏ nhất của TANSUAT là 1.
5. Bước 4: Đánh giá giá trị thiếu
Sau khi loại phiếu không hợp lệ và sửa lỗi nhập liệu, các ô trống còn lại cần được đánh giá trước khi chọn cách xử lý.
Ba cơ chế thiếu dữ liệu
Cách xử lý giá trị thiếu phụ thuộc vào lý do dữ liệu bị thiếu. Rubin (1976) phân biệt ba cơ chế và Schafer và Graham (2002) giải thích hệ quả của từng cơ chế (Bảng 2):
Bảng 2. Ba cơ chế thiếu dữ liệu.
| Cơ chế | Ý nghĩa | Ví dụ với khảo sát sàn X |
|---|---|---|
| MCAR (thiếu hoàn toàn ngẫu nhiên) | Việc thiếu không liên quan đến bất kỳ biến nào | Người trả lời vô tình lướt qua một câu |
| MAR (thiếu ngẫu nhiên) | Việc thiếu liên quan đến biến khác đã đo được | Người trẻ hay bỏ câu thu nhập hơn người lớn tuổi |
| MNAR (thiếu không ngẫu nhiên) | Việc thiếu liên quan đến chính giá trị bị thiếu | Người rất không hài lòng cố tình bỏ qua câu hài lòng |
Với MCAR, loại phiếu thiếu chỉ làm giảm cỡ mẫu chứ không làm lệch kết quả. Với MAR và MNAR, loại phiếu thiếu có thể khiến mẫu còn lại không còn đại diện.
Đo mức độ thiếu
Hàm NMISS đếm số câu bị thiếu trong mỗi phiếu:
COMPUTE SOTHIEU = NMISS(XN1 TO HL2, HL3 TO YD4).
FREQUENCIES SOTHIEU /STATISTICS=NONE.
DESCRIPTIVES XN1 TO HL2 HL3 TO YD4 /STATISTICS=MEAN MIN MAX.
Hình 4 đếm số câu Likert bị thiếu trong mỗi phiếu.
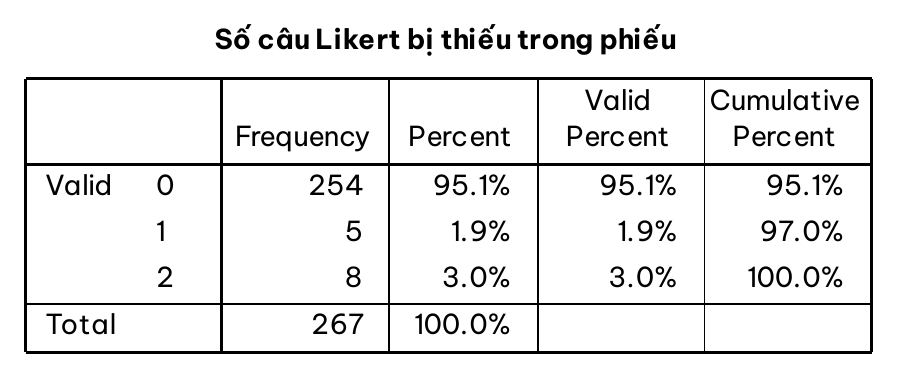
Hình 4. Trong 267 phiếu hợp lệ, 254 phiếu đầy đủ, 5 phiếu thiếu 1 câu và 8 phiếu thiếu 2 câu.
Cột N trong bảng DESCRIPTIVES cho biết số giá trị hợp lệ của từng biến. Tổng hợp lại, dữ liệu mẫu có 21 ô thiếu trên tổng số 267 × 20 = 5.340 ô, tức 0,39%. Biến thiếu nhiều nhất là XN3 và YD1, mỗi biến 3 ô (1,1%). 13 phiếu có ít nhất một ô thiếu chiếm 4,9% số phiếu và không phiếu nào thiếu quá 2 trong 20 câu.
Mức độ này rất thấp. Hair và cộng sự (2019) cho rằng mức thiếu dưới 10% ở một phiếu hay một biến thường có thể bỏ qua nếu việc thiếu diễn ra ngẫu nhiên. Tabachnick và Fidell (2019) cũng nhận xét rằng khi chỉ dưới 5% dữ liệu bị thiếu một cách ngẫu nhiên trong một bộ dữ liệu lớn, các cách xử lý khác nhau cho kết quả gần như nhau.
Kiểm tra việc thiếu có ngẫu nhiên không
Little (1988) đề xuất kiểm định MCAR cho dữ liệu nhiều biến. SPSS có kiểm định này trong mô-đun Missing Value Analysis, còn PSPP chưa có. Một cách kiểm tra sơ bộ là so sánh nhóm phiếu có ô thiếu với nhóm phiếu đầy đủ ở các biến khác:
COMPUTE CO_THIEU = (SOTHIEU > 0).
T-TEST GROUPS=CO_THIEU(0 1) /VARIABLES=TUOI TANSUAT.
CROSSTABS /TABLES=GIOITINH BY CO_THIEU /STATISTICS=CHISQ.
Kết quả trên dữ liệu mẫu:
- Giới tính: tỷ lệ phiếu có ô thiếu không khác nhau giữa nam, nữ và giới tính khác (χ²(2) = 2,54; p = ,280).
- Số lần mua: không khác biệt (4,67 so với 4,23 lần; p = ,808).
- Tuổi: nhóm có ô thiếu trẻ hơn (26,5 so với 31,7 tuổi). Kiểm định t với phương sai bằng nhau không có ý nghĩa (p = ,074), nhưng kiểm định Welch thì có (p = ,030).
Kết quả về tuổi cần được ghi nhận trung thực. Nhóm có ô thiếu chỉ có 13 phiếu, nên khác biệt này có thể do ngẫu nhiên. Ngay cả khi người trẻ có xu hướng bỏ câu nhiều hơn (cơ chế MAR theo tuổi), tỷ lệ 0,39% số ô là quá nhỏ để làm lệch kết quả đáng kể. Khi viết báo cáo, hãy nêu rõ kết quả kiểm tra này thay vì chỉ viết "dữ liệu thiếu ngẫu nhiên".
Chọn cách xử lý
Ba thông tin ở trên, gồm cơ chế thiếu, mức độ thiếu và kết quả kiểm tra tính ngẫu nhiên, dẫn đến quyết định xử lý theo Hình 5.
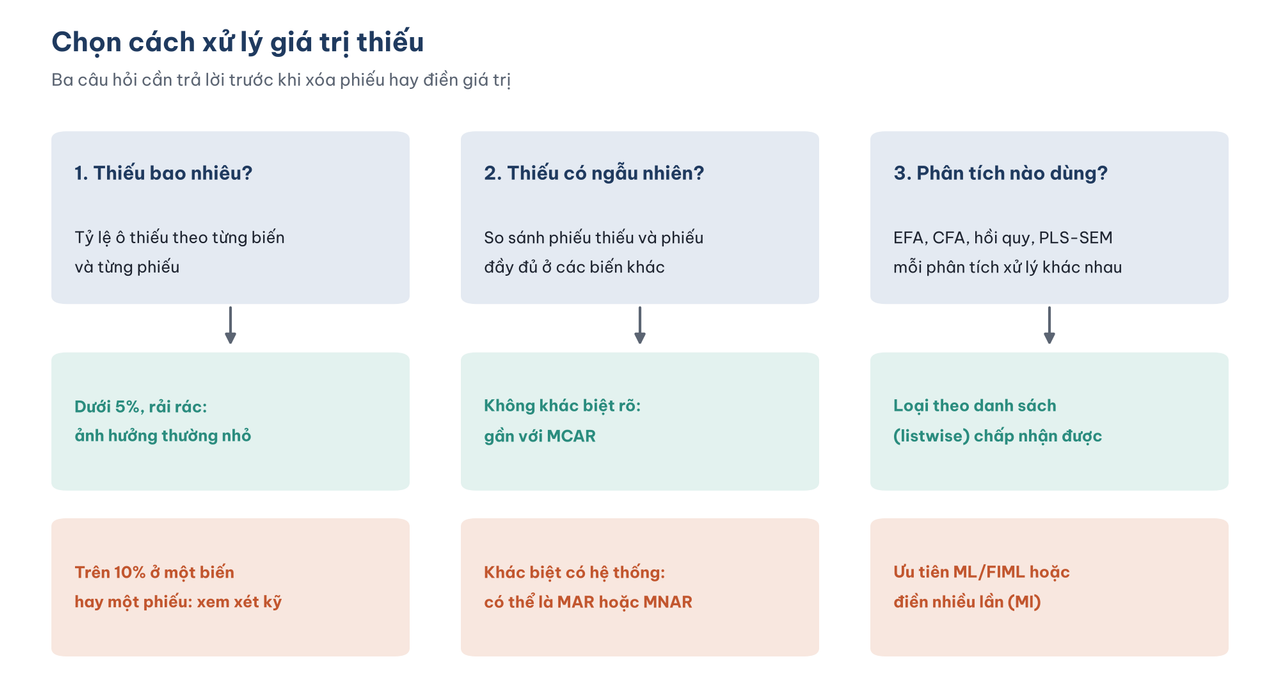
Hình 5. Ba câu hỏi dẫn đến quyết định xử lý giá trị thiếu.
Bảng 3 so sánh các cách xử lý thường dùng.
Bảng 3. Các cách xử lý giá trị thiếu.
| Cách xử lý | Cách làm | Khi nào dùng |
|---|---|---|
| Loại theo danh sách (listwise) | Bỏ phiếu thiếu bất kỳ biến nào trong phân tích | Tỷ lệ thiếu thấp, gần MCAR; mặc định của EFA, hồi quy |
| Loại theo cặp (pairwise) | Mỗi hệ số tương quan dùng mọi phiếu có đủ hai biến đó | Dùng thận trọng: ma trận tương quan có thể không nhất quán |
| Điền bằng trung bình (mean substitution) | Thay ô thiếu bằng trung bình của biến | Không khuyến khích: làm giảm phương sai và tương quan (Newman, 2014) |
| Ước lượng hợp lý cực đại (ML/FIML) hoặc điền nhiều lần (MI) | Dùng thông tin của mọi biến để ước lượng | Tỷ lệ thiếu cao hơn hoặc nghi ngờ MAR (Enders, 2010) |
Newman (2014) khuyến nghị dùng ML hoặc MI khi tỷ lệ thiếu đáng kể và tránh điền trung bình vì cách này làm hệ số tương quan nhỏ đi một cách giả tạo. PSPP chưa có ML hay MI cho dữ liệu thiếu. AMOS có ước lượng FIML, sẽ được giới thiệu ở cụm bài AMOS.
Quyết định cho bộ dữ liệu mẫu: giữ cả 267 phiếu, để nguyên các ô thiếu, không điền giá trị. Khi chạy EFA và hồi quy, phần mềm loại theo danh sách và còn 254 phiếu, vẫn vượt mức tối thiểu 200 cho EFA đã tính trong bài cỡ mẫu bao nhiêu là đủ. Khi tính biến đại diện, hàm MEAN.3 sẽ tính trung bình cho phiếu trả lời ít nhất 3 trong 4 câu của một thang đo.
6. Bước 5: Phát hiện ngoại lai đơn biến
Ngoại lai (outlier) là quan sát khác biệt rõ rệt so với phần lớn dữ liệu. Aguinis và cộng sự (2013) nhấn mạnh phải phân biệt ngoại lai do lỗi (cần sửa hoặc loại) với ngoại lai thật (quan sát hợp lệ nhưng hiếm, cần cân nhắc và báo cáo). Lỗi đã được xử lý ở Bước 3. Bước này tìm các quan sát hợp lệ nhưng bất thường.
Điểm z
Lệnh DESCRIPTIVES với tùy chọn /SAVE tạo thêm biến điểm z (Z + tên biến) cho mỗi biến. Trên giao diện, đánh dấu ô Save Z-scores of selected variables as new variables trong hộp thoại Descriptives (trong SPSS là Save standardized values as variables).
DESCRIPTIVES TUOI TANSUAT XN1 TO HL2 HL3 TO YD4 /SAVE.
COMPUTE NGOAILAI_Z = ANY(1, ABS(ZTUOI) > 3.29, ABS(ZTANSUAT) > 3.29).
Tabachnick và Fidell (2019) đề xuất ngưỡng |z| > 3,29 (tương ứng p < ,001, hai phía) cho mẫu lớn. Kết quả: chỉ phiếu 99 vượt ngưỡng, với TANSUAT = 95 và z = 14,44. Tuổi sau khi sửa lỗi không còn ngoại lai.
Với câu Likert, điểm z ít có ý nghĩa. Ba người chọn mức 1 ở câu XN2 có |z| ≈ 3,3, nhưng "Hoàn toàn không đồng ý" là một câu trả lời hoàn toàn hợp lệ trên thang đo. Không loại phiếu chỉ vì người trả lời chọn mức thấp nhất hay cao nhất.
Biểu đồ hộp
Lệnh EXAMINE (menu Analyze > Descriptive Statistics > Explore) vẽ biểu đồ hộp và liệt kê 5 giá trị lớn nhất, nhỏ nhất:
EXAMINE VARIABLES=TANSUAT /ID=ID /PLOT=BOXPLOT /STATISTICS=EXTREME(5).
Hình 6 cho thấy các giá trị cực trị và biểu đồ hộp của biến số lần mua.
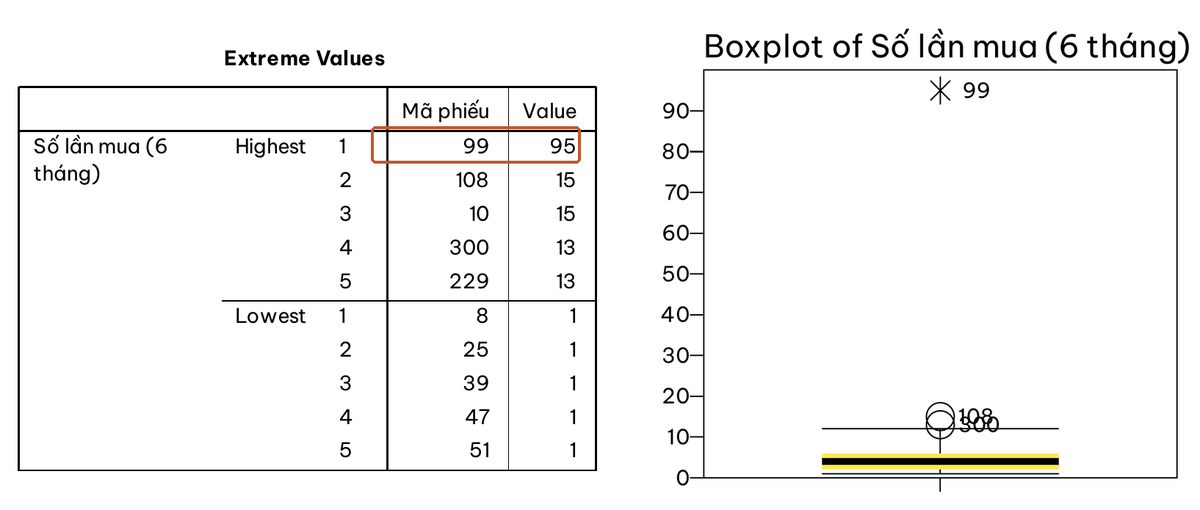
Hình 6. Phiếu 99 (TANSUAT = 95) là điểm cực trị, được vẽ bằng dấu sao. Các phiếu 108 và 300 (15 và 13 lần) là ngoại lai nhẹ, được vẽ bằng vòng tròn.
Trên biểu đồ hộp của PSPP và SPSS, vòng tròn là giá trị nằm cách cạnh hộp từ 1,5 đến 3 lần khoảng tứ phân vị (IQR), còn dấu sao là giá trị cách cạnh hộp hơn 3 lần IQR. Hãy luôn thêm /ID=ID. Nếu không, nhãn bên cạnh điểm là số thứ tự dòng chứ không phải mã phiếu. Sau khi đã loại 33 phiếu, số thứ tự dòng không còn trùng với ID: phiếu ID 99 nằm ở dòng 89.
Xử lý ngoại lai đơn biến
Mua 95 lần trong 6 tháng là cao nhưng có thể xảy ra, ví dụ với người kinh doanh nhỏ nhập hàng qua sàn. Không có lý do để coi đây là lỗi. Quyết định cho bộ dữ liệu mẫu:
- Giữ phiếu 99, vì các câu trả lời Likert của phiếu này bình thường và TANSUAT không nằm trong mô hình nghiên cứu.
- Nếu sau này dùng TANSUAT trong phân tích, hãy chạy hai lần, có và không có phiếu 99, để xem kết quả có thay đổi không. Có thể thay thế bằng cách chuyển TANSUAT thành nhóm (1–2, 3–5, 6–10, trên 10 lần).
Leys và cộng sự (2013) lưu ý rằng chính ngoại lai làm tăng độ lệch chuẩn, nên phương pháp điểm z có thể bỏ sót ngoại lai trong mẫu nhỏ. Họ đề xuất dùng khoảng cách tới trung vị tính theo độ lệch tuyệt đối trung vị (MAD). Với mẫu 267 phiếu và một giá trị cực đoan như 95, cả hai cách đều cho cùng kết luận.
7. Bước 6: Phát hiện ngoại lai đa biến
Một phiếu có thể không bất thường ở từng câu nhưng lại bất thường ở sự kết hợp các câu trả lời. Ví dụ, một người hoàn toàn không đồng ý rằng sàn X đáp ứng kỳ vọng (XN thấp) nhưng hoàn toàn hài lòng (HL cao). Loại ngoại lai này được phát hiện bằng khoảng cách Mahalanobis (D²), đo khoảng cách từ một phiếu tới tâm của dữ liệu có tính đến tương quan giữa các biến (Tabachnick & Fidell, 2019).
D² tuân theo phân phối khi bình phương với số bậc tự do bằng số biến. Với 20 câu Likert, ngưỡng tại p < ,001 là χ²(20) = 45,31. SPSS tính D² qua hộp thoại hồi quy tuyến tính (Save > Mahalanobis). PSPP chưa có tùy chọn này, nên file cú pháp tính trực tiếp bằng lệnh MATRIX, trên 254 phiếu đầy đủ:
MATRIX.
GET X /VARIABLES=XN1 TO YD4.
GET MAID /VARIABLES=ID.
COMPUTE N = NROW(X).
COMPUTE XC = X - MAKE(N, 1, 1) * CSUM(X) / N.
COMPUTE S = T(XC) * XC / (N - 1).
COMPUTE D2 = RSUM((XC * INV(S)) &* XC).
SAVE {MAID, D2} /OUTFILE=* /VARIABLES=ID MAHAL.
END MATRIX.
COMPUTE P_MAHAL = SIG.CHISQ(MAHAL, 20).
Ý nghĩa từng dòng: XC là dữ liệu đã trừ trung bình của từng cột, S là ma trận hiệp phương sai, còn D2 là khoảng cách Mahalanobis của từng phiếu. Hàm SIG.CHISQ đổi D² thành giá trị p. Trước khối MATRIX, file cú pháp tạo một bản sao dữ liệu chỉ gồm ID và 20 câu Likert của các phiếu đầy đủ. Sau khối này, khoảng cách được ghép lại vào dữ liệu chính theo ID (Hình 7).
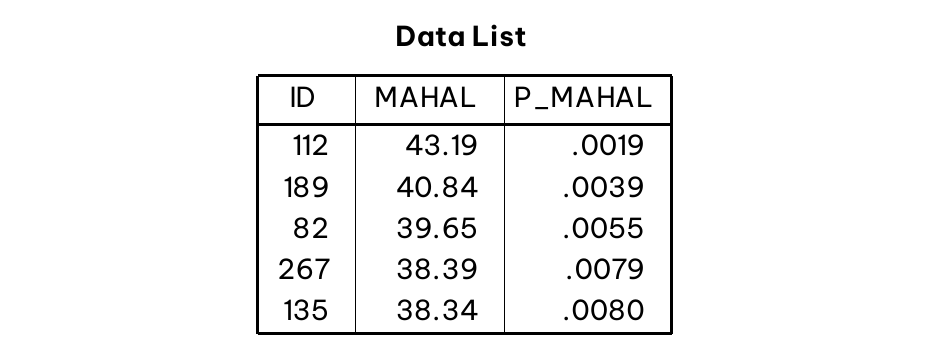
Hình 7. Phiếu có D² lớn nhất là phiếu 112 (D² = 43,19; p = ,0019), vẫn dưới ngưỡng 45,31.
Không phiếu nào vượt ngưỡng p < ,001. Kết quả này được kiểm chứng lại bằng Python (numpy), cho cùng giá trị D². Phiếu 112 có D² lớn nhất vì trả lời thiếu nhất quán trong cùng một thang đo: XN1 = 1 nhưng XN3 = 4; HI1 = 5 nhưng HI4 = 3. Đây vẫn là câu trả lời hợp lệ, nên không có lý do để loại.
Khi có phiếu vượt ngưỡng, đừng xóa tự động. Hãy mở phiếu đó ra xem, tìm hiểu vì sao nó khác biệt và chạy phân tích chính có và không có các phiếu đó. Nếu kết luận không đổi, giữ lại và báo cáo. Nếu kết luận thay đổi, báo cáo cả hai kết quả và lý do lựa chọn (Aguinis và cộng sự, 2013). Lưu ý thêm, khi chạy lại D² sau khi xóa ngoại lai, các phiếu khác thường trở thành "ngoại lai mới" vì tâm và hiệp phương sai thay đổi. Vì vậy chỉ nên kiểm tra một lần, không lặp lại cho đến khi "sạch".
8. Bước 7: Lưu dữ liệu sạch và ghi nhật ký
Bước cuối lưu bộ dữ liệu thành file mới và bỏ các biến trung gian:
SAVE OUTFILE='../du-lieu/du_lieu_sach.sav'
  /DROP=SAI_THANG LOI_GANLOC LOI_CHUY LOI_MOTMUC LOAI CO_THIEU NGOAILAI_Z
        ZTUOI ZTANSUAT ZXN1 TO ZYD4.
File du_lieu_sach.sav có 267 phiếu và giữ lại ba biến hữu ích cho các bài sau: DOLECH (độ lệch chuẩn trong phiếu), SOTHIEU (số câu thiếu) và MAHAL (khoảng cách Mahalanobis). Đây là bộ dữ liệu dùng cho toàn bộ cụm bài SPSS tiếp theo.
Song song với file dữ liệu, hãy ghi nhật ký làm sạch. Phần phương pháp của luận văn hay bài báo cần những con số này (Bảng 4):
Bảng 4. Nhật ký làm sạch dữ liệu của bộ dữ liệu mẫu.
| Bước | Tiêu chí | Số phiếu hoặc số ô bị ảnh hưởng | Xử lý |
|---|---|---|---|
| Gạn lọc | SL1 = 2 (chưa mua trên sàn X) | 14 phiếu | Loại |
| Kiểm tra chú ý | AC1 ≠ 2 | 19 phiếu (gồm 8 phiếu trả lời một mức) | Loại |
| Lỗi nhập liệu | Tuổi ngoài 18–60; Likert ngoài 1–5 | 2 ô (phiếu 59, 257) | Chuyển thành giá trị thiếu |
| Giá trị thiếu | Ô bỏ trống | 21 ô (0,39%), 13 phiếu | Giữ nguyên, loại theo danh sách khi phân tích |
| Ngoại lai đơn biến | Trị tuyệt đối của z lớn hơn 3,29 | 1 phiếu (99, TANSUAT = 95) | Giữ, ghi chú |
| Ngoại lai đa biến | D² > χ²(20) = 45,31 | 0 phiếu | Không xử lý |
| Mẫu cuối cùng | 267 phiếu (254 phiếu đầy đủ) |
Câu mẫu khi viết phần phương pháp: "Trong 300 phiếu thu về, 33 phiếu (11%) bị loại do không thỏa câu gạn lọc (14 phiếu) hoặc trả lời sai câu kiểm tra chú ý (19 phiếu, trong đó 8 phiếu chọn cùng một mức cho mọi câu). Hai giá trị nằm ngoài khoảng hợp lệ được chuyển thành giá trị thiếu. Dữ liệu thiếu chiếm 0,39% số ô của thang đo; không phiếu nào thiếu quá 2 trong 20 câu. Không phát hiện ngoại lai đa biến theo khoảng cách Mahalanobis (p < ,001). Mẫu phân tích gồm 267 phiếu."
Năm lỗi thường gặp
Các lỗi dưới đây làm sai lệch kết quả mà phần mềm không cảnh báo.
- Tìm ngoại lai trước khi loại phiếu không hợp lệ, khiến trung bình và độ lệch chuẩn dùng để tính điểm z bị sai lệch.
- Coi mọi ngoại lai là lỗi và xóa đi. Chỉ giá trị không thể xảy ra mới là lỗi. Ngoại lai thật cần được cân nhắc và báo cáo.
- Điền giá trị thiếu bằng trung bình cho tiện, làm giảm phương sai và tương quan giữa các biến.
- Ghi đè file dữ liệu gốc, khiến không thể kiểm tra lại hoặc thay đổi quyết định làm sạch.
- Không báo cáo quá trình làm sạch, khiến người đọc không biết mẫu 267 phiếu đến từ đâu khi bảng hỏi phát ra 300 phiếu.
Tài liệu tham khảo
Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
Curran, P. G. (2016). Methods for the detection of carelessly invalid responses in survey data. Journal of Experimental Social Psychology, 66, 4–19. https://doi.org/10.1016/j.jesp.2015.07.006
Enders, C. K. (2010). Applied missing data analysis. Guilford Press. https://www.guilford.com/books/Applied-Missing-Data-Analysis/Craig-Enders/9781606236390
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
GNU Project. (n.d.). GNU PSPP manual. Retrieved October 30, 2026, from https://www.gnu.org/software/pspp/manual/
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Huang, J. L., Curran, P. G., Keeney, J., Poposki, E. M., & DeShon, R. P. (2012). Detecting and deterring insufficient effort responding to surveys. Journal of Business and Psychology, 27(1), 99–114. https://doi.org/10.1007/s10869-011-9231-8
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
Newman, D. A. (2014). Missing data: Five practical guidelines. Organizational Research Methods, 17(4), 372–411. https://doi.org/10.1177/1094428114548590
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003097