
MÃ HÓA LẠI VÀ TÍNH BIẾN ĐẠI DIỆN TRONG SPSS/PSPP
Mã hóa ngược câu đảo chiều, nhóm biến định lượng và tính điểm trung bình thang đo bằng hàm MEAN có kiểm tra
Bài nên đọc trước
Sau khi làm sạch dữ liệu, bộ dữ liệu mẫu có 20 câu Likert đo năm khái niệm: Xác nhận kỳ vọng, Nhận thức hữu ích, Sự hài lòng, Niềm tin và Ý định mua lại. Các phân tích ở những bài sau, như tương quan, hồi quy, T-test, ANOVA, cần mỗi khái niệm được thể hiện bằng một biến duy nhất: biến đại diện, thường là trung bình của các câu trong thang đo.
Trước khi tính trung bình, có một việc phải làm: mã hóa ngược câu đảo chiều. Bài thống kê mô tả đã cho thấy câu NT4 "Tôi lo ngại sàn X không giữ đúng cam kết" có trung bình chỉ 2,11 trong khi ba câu còn lại của thang Niềm tin đều gần 3,9. Nếu cộng NT4 với ba câu kia mà không mã hóa ngược, biến Niềm tin sẽ sai.
Bài viết này hướng dẫn hai lệnh RECODE và COMPUTE trong PSPP, cả bằng giao diện và cú pháp, trên bộ dữ liệu du_lieu_sach.sav (267 phiếu). Mọi ảnh là ảnh chụp giao diện PSPP 2.0 thật và kết quả thật từ file cú pháp bien_dai_dien.sps đi kèm (Free Software Foundation, 2023). Thao tác trong SPSS giống hệt (GNU Project, n.d.).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
10-tinh-bien-dai-dien-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Quy trình từ câu hỏi đến biến đại diện
Từ các câu hỏi riêng lẻ đến biến đại diện cần đi qua năm bước theo đúng thứ tự (Hình 1).
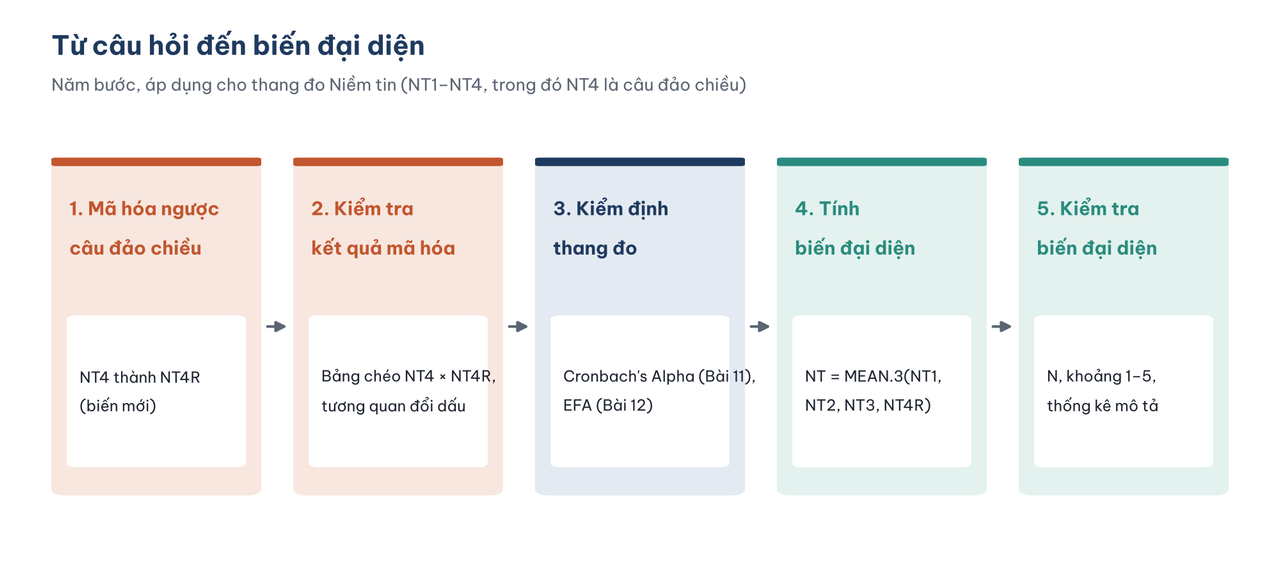
Hình 1. Năm bước từ các câu hỏi riêng lẻ đến biến đại diện của một thang đo.
Bước 3 nằm giữa quy trình có lý do. Biến đại diện chỉ có ý nghĩa khi các câu trong thang đo thực sự đo cùng một khái niệm. Điều này được kiểm định bằng Cronbach's Alpha và phân tích nhân tố khám phá (EFA), hai bước tiếp theo của loạt bài. Nếu kiểm định cho thấy một câu cần loại, biến đại diện phải được tính lại không có câu đó. Bài này tính biến đại diện trước để minh họa lệnh và file cú pháp được viết sao cho chỉ cần sửa một dòng là tính lại được.
2. Mã hóa ngược câu đảo chiều
Câu đảo chiều phải được mã hóa ngược trước mọi phép tính trên thang đo.
Vì sao cần mã hóa ngược?
Câu đảo chiều (reversed item) được viết theo hướng ngược với khái niệm cần đo. Với thang Niềm tin, ba câu NT1–NT3 là câu thuận: đồng ý nghĩa là tin tưởng. Câu NT4 là câu đảo chiều: đồng ý nghĩa là không tin tưởng. Mã hóa ngược đưa NT4 về cùng hướng với các câu còn lại (Bảng 1):
Bảng 1. Mã hóa ngược câu NT4 trên thang Likert 5 mức.
| Câu trả lời ở NT4 | Mã gốc | Mã sau khi đảo (NT4R) | Ý nghĩa sau khi đảo |
|---|---|---|---|
| Hoàn toàn không đồng ý | 1 | 5 | Rất tin tưởng |
| Không đồng ý | 2 | 4 | Tin tưởng |
| Trung lập | 3 | 3 | Trung lập |
| Đồng ý | 4 | 2 | Không tin tưởng |
| Hoàn toàn đồng ý | 5 | 1 | Rất không tin tưởng |
Với thang 1–5, mã mới luôn bằng 6 trừ mã cũ. Tổng quát, mã mới = (giá trị nhỏ nhất + giá trị lớn nhất) − mã cũ. Với thang 1–7, mã mới bằng 8 trừ mã cũ.
Câu đảo chiều giúp phát hiện người trả lời qua loa, như bài làm sạch dữ liệu đã dùng để nhận diện 8 phiếu chọn cùng một mức. Tuy vậy, Weijters và Baumgartner (2012) và Suárez-Alvarez và cộng sự (2018) lưu ý rằng người trả lời thường hiểu sai câu đảo chiều, nhất là câu có từ phủ định và điều này có thể làm giảm độ tin cậy của thang đo. Nếu dùng, hãy viết câu đảo chiều rõ ràng và không dùng phủ định kép.
Mã hóa ngược bằng giao diện
Chọn menu Transform > Recode into Different Variables (Hình 2). Luôn chọn Recode into Different Variables (mã hóa vào biến mới), không chọn Recode into Same Variables. Mã hóa vào chính biến cũ sẽ ghi đè dữ liệu gốc. Nếu lỡ chạy hai lần, NT4 sẽ quay về mã ban đầu mà bạn không hề hay biết.
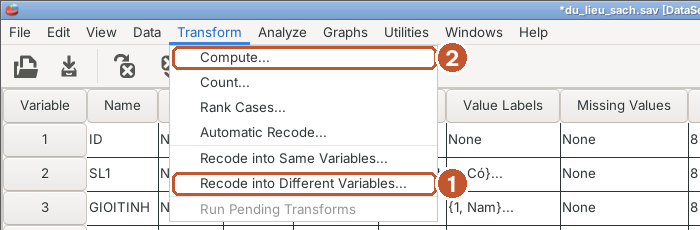
Hình 2. Menu Transform: Recode into Different Variables (1) dùng để mã hóa lại; Compute (2) dùng để tính biến đại diện ở mục 3.
Trong hộp thoại Recode into Different Variables (Hình 3):
- Chọn biến NT4 ở danh sách bên trái, bấm mũi tên để đưa sang ô Variables (1).
- Bấm vào dòng NT4 vừa chuyển sang. Ở khung Output Variable, gõ tên biến mới
NT4Rvào ô Name và một nhãn mô tả vào ô Label (2). - Bấm Change (3). Cột New hiện tên NT4R.
- Bấm Old and New Values (4) để khai báo quy tắc mã hóa.
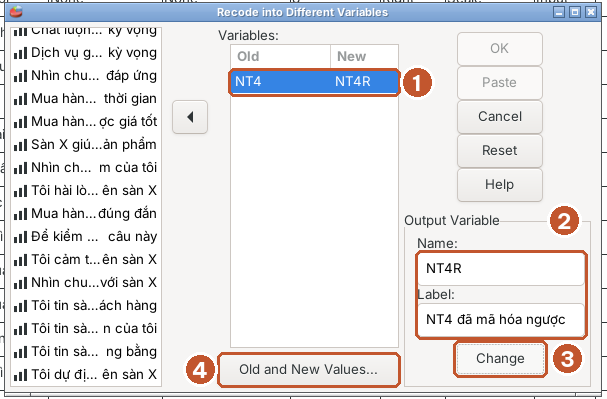
Hình 3. Khai báo biến gốc NT4 và biến mới NT4R.
Trong hộp thoại Old and New Values (Hình 4), với từng cặp giá trị: gõ giá trị cũ vào ô Value bên trái (1), gõ giá trị mới vào ô Value của khung New Value (2), rồi bấm Add (3). Lặp lại cho đủ 5 cặp: 1→5, 2→4, 3→3, 4→2, 5→1. Kiểm tra danh sách bên phải, rồi bấm Continue (4).
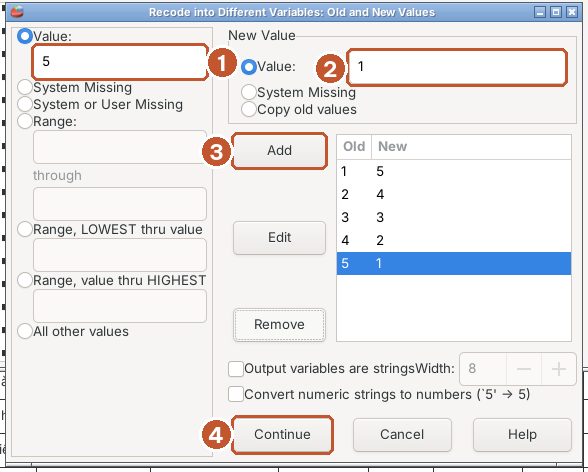
Hình 4. Năm quy tắc mã hóa ngược trong danh sách Old → New.
Đừng bỏ qua cặp 3→3. Với Recode into Different Variables, mọi giá trị không có trong danh sách quy tắc sẽ trở thành giá trị thiếu ở biến mới. Nếu quên cặp 3→3, 63 người trả lời "Trung lập" sẽ mất dữ liệu ở NT4R.
Quay lại hộp thoại chính, bấm Paste thay vì OK. PSPP mở cửa sổ Syntax với lệnh tương ứng (Hình 5). Chọn Run > All để chạy và lưu file cú pháp này lại.
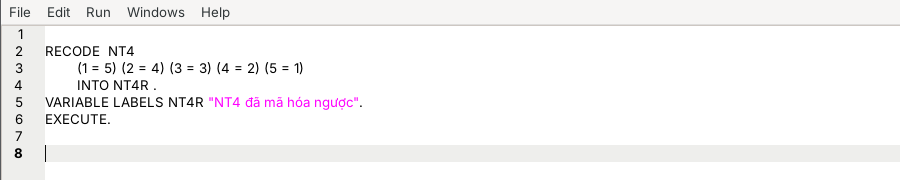
Hình 5. Lệnh RECODE ... INTO do PSPP sinh ra khi bấm Paste.
Mã hóa ngược bằng cú pháp
File bien_dai_dien.sps viết đầy đủ hơn, gồm cả nhãn giá trị, định dạng và cấp độ đo lường cho biến mới:
RECODE NT4 (1=5) (2=4) (3=3) (4=2) (5=1) INTO NT4R.
VARIABLE LABELS NT4R 'NT4 đã mã hóa ngược: Tôi KHÔNG lo ngại sàn X không giữ cam kết'.
VALUE LABELS NT4R 1 'Hoàn toàn không đồng ý' 2 'Không đồng ý' 3 'Trung lập'
  4 'Đồng ý' 5 'Hoàn toàn đồng ý'.
FORMATS NT4R (F1.0).
VARIABLE LEVEL NT4R (ORDINAL).
EXECUTE.
Biến mới tạo bằng RECODE không thừa hưởng nhãn giá trị của biến gốc, nên phải khai báo lại. Với thang 1–5, cách viết ngắn COMPUTE NT4R = 6 - NT4. cho kết quả giống hệt.
Kiểm tra kết quả mã hóa
Mã hóa xong phải kiểm tra, vì một lỗi gõ nhầm như (2=2) sẽ không gây báo lỗi nào. Có hai cách kiểm tra nhanh.
Bảng chéo giữa biến gốc và biến mới. Mọi phiếu phải nằm trên đường chéo ngược: NT4 = 1 ứng với NT4R = 5 và cứ thế.
CROSSTABS /TABLES=NT4 BY NT4R.
Bảng chéo ở Hình 6 xác nhận việc mã hóa ngược đã đúng.
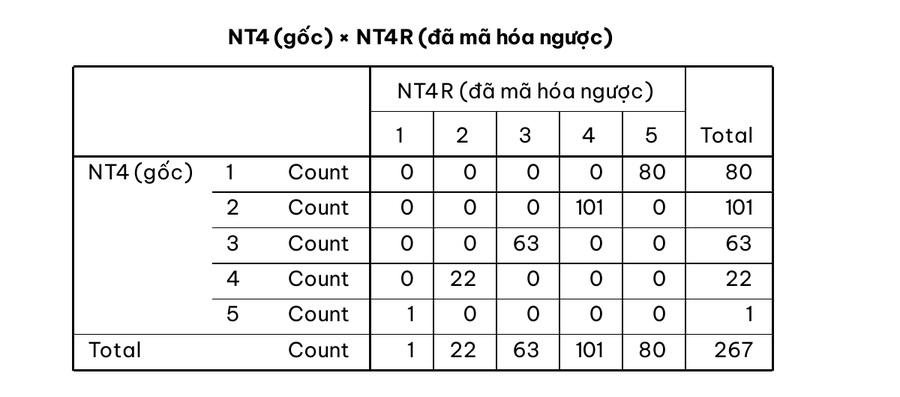
Hình 6. Cả 267 phiếu nằm trên đường chéo ngược. 80 người chọn mức 1 ở NT4 đều có NT4R = 5.
Tương quan với các câu cùng thang đo. Trước khi mã hóa, NT4 tương quan âm với NT1, NT2, NT3. Sau khi mã hóa, NT4R phải tương quan dương với cùng độ lớn (Bảng 2):
Bảng 2. Tương quan của NT4 trước và sau khi mã hóa ngược với các câu cùng thang đo.
| Tương quan với | NT4 (gốc) | NT4R (đã đảo) |
|---|---|---|
| NT1 | −0,546 | 0,546 |
| NT2 | −0,591 | 0,591 |
| NT3 | −0,476 | 0,476 |
Bảng tương quan cũng là cách phát hiện câu đảo chiều mà bạn có thể đã bỏ sót: câu nào tương quan âm với các câu khác cùng thang đo thì cần xem lại nội dung câu hỏi.
3. Tính biến đại diện bằng COMPUTE
Biến đại diện của một thang đo thường là trung bình các câu thuộc thang đo đó, tính bằng lệnh COMPUTE.
Tính bằng giao diện
Chọn Transform > Compute (Hình 2, mục 2). Trong hộp thoại Compute Variable (Hình 7):
- Gõ tên biến mới vào ô Target Variable (1), ví dụ
XN. - Gõ biểu thức vào ô Numeric Expressions (2):
MEAN.3(XN1, XN2, XN3, XN4). Cũng có thể chọn hàm MEAN trong danh sách Functions rồi chọn biến từ danh sách bên trái. - Bấm OK (3), hoặc Paste để lấy cú pháp.
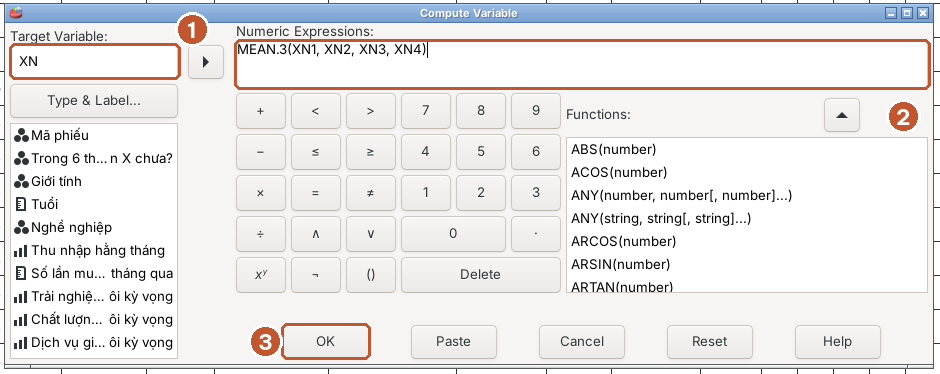
Hình 7. Tính biến đại diện XN bằng hàm MEAN.3.
Ba cách tính trung bình và sự khác nhau
Có ba cách viết công thức trung bình. Chúng cho kết quả giống nhau ở phiếu đầy đủ, nhưng xử lý phiếu có ô thiếu khác nhau:
COMPUTE XN_CONG = (XN1 + XN2 + XN3 + XN4) / 4.
COMPUTE XN_MEAN = MEAN(XN1, XN2, XN3, XN4).
COMPUTE XN_MEAN3 = MEAN.3(XN1, XN2, XN3, XN4).
Hình 8 so sánh kết quả của ba cách tính.
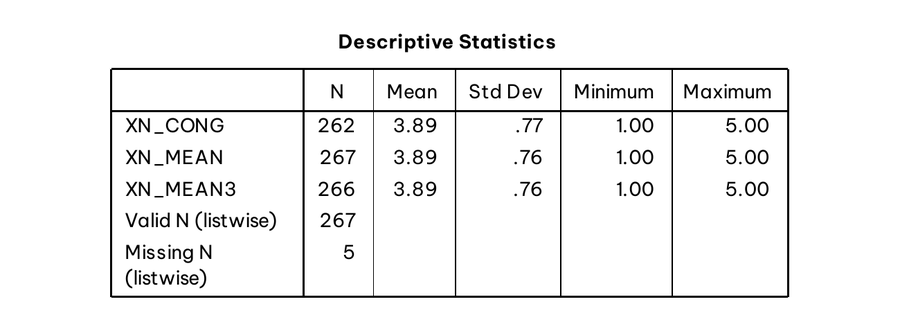
Hình 8. Cùng thang đo XN nhưng số phiếu có giá trị khác nhau: 262, 267 và 266.
Bảng 3 tóm tắt sự khác nhau giữa ba cách tính.
Bảng 3. Ba cách tính trung bình thang đo XN và số phiếu có giá trị.
| Công thức | Khi phiếu thiếu một câu | Số phiếu có giá trị |
|---|---|---|
(XN1 + XN2 + XN3 + XN4) / 4 |
Kết quả là giá trị thiếu, vì phép cộng với giá trị thiếu cho ra giá trị thiếu | 262 |
MEAN(XN1, XN2, XN3, XN4) |
Tính trung bình các câu có trả lời, dù chỉ có một câu | 267 |
MEAN.3(XN1, XN2, XN3, XN4) |
Tính trung bình khi có ít nhất 3 câu có trả lời | 266 |
Cách cộng rồi chia làm mất 5 phiếu chỉ vì mỗi phiếu thiếu một câu. Hàm MEAN không mất phiếu nào, nhưng có một phiếu trả lời 2 trong 4 câu XN vẫn được tính và biến đại diện của phiếu này dựa trên một nửa thang đo. Hàm MEAN.n là cách dung hòa: con số n sau dấu chấm là số câu tối thiểu phải có trả lời.
Quy tắc hay dùng là yêu cầu trả lời ít nhất một nửa đến ba phần tư số câu của thang đo. Với thang 4 câu, MEAN.3 là lựa chọn hợp lý. Tính trung bình trên các câu có trả lời là một cách xử lý giá trị thiếu ở cấp độ câu hỏi, chấp nhận được khi tỷ lệ thiếu thấp và các câu trong thang đo tương quan chặt với nhau (Newman, 2014). Hãy ghi rõ quy tắc đã chọn trong phần phương pháp.
Trung bình hay tổng?
Có thể dùng tổng thay cho trung bình (hàm SUM) và Pallant (2020) hướng dẫn cả hai cách. Trong nghiên cứu kinh doanh, trung bình được dùng phổ biến hơn vì hai lý do. Thứ nhất, trung bình giữ nguyên thang đo 1–5, nên 3,90 vẫn đọc được là "gần mức Đồng ý". Thứ hai, trung bình so sánh được giữa các thang đo có số câu khác nhau. Nếu một thang đo bị loại một câu khi kiểm định Cronbach's Alpha, tổng sẽ thay đổi thang (từ 4–20 thành 3–15), còn trung bình vẫn ở 1–5.
Một lựa chọn khác là điểm nhân tố (factor score) lưu từ EFA, trong đó mỗi câu có trọng số khác nhau. DiStefano và cộng sự (2009) chỉ ra rằng trung bình cộng đơn giản (trọng số bằng nhau) dễ hiểu, ổn định giữa các mẫu và là lựa chọn phổ biến khi các câu có hệ số tải tương đối đồng đều.
4. Hai lỗi hay gặp khi tính biến đại diện
Hai lỗi dưới đây không làm PSPP báo lỗi nhưng làm biến đại diện sai lệch: từ khóa TO lấy nhầm biến và quên dùng câu đã mã hóa ngược.
Lỗi 1: từ khóa TO lấy cả biến không thuộc thang đo
Từ khóa TO trong PSPP và SPSS lấy mọi biến nằm giữa hai biến theo vị trí trong file, không theo tên. Trong bộ dữ liệu mẫu, câu kiểm tra chú ý AC1 nằm giữa HL2 và HL3, đúng như vị trí của nó trong bảng hỏi (Hình 9):
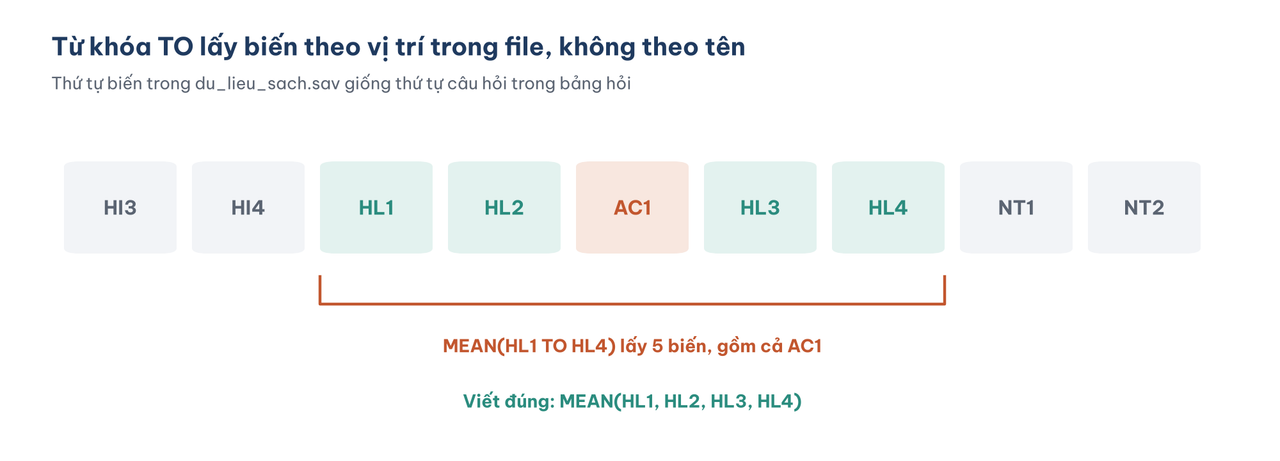
Hình 9. HL1 TO HL4 gồm 5 biến chứ không phải 4.
Lỗi thứ hai có cùng bản chất: quên thay NT4 bằng NT4R khi tính biến Niềm tin. File cú pháp tính cả cách sai và cách đúng để so sánh:
COMPUTE HL_SAI = MEAN(HL1 TO HL4).
COMPUTE HL_DUNG = MEAN(HL1, HL2, HL3, HL4).
COMPUTE NT_SAI = MEAN(NT1, NT2, NT3, NT4).
COMPUTE NT_DUNG = MEAN(NT1, NT2, NT3, NT4R).
Hình 10 so sánh kết quả của cách tính sai và cách tính đúng.
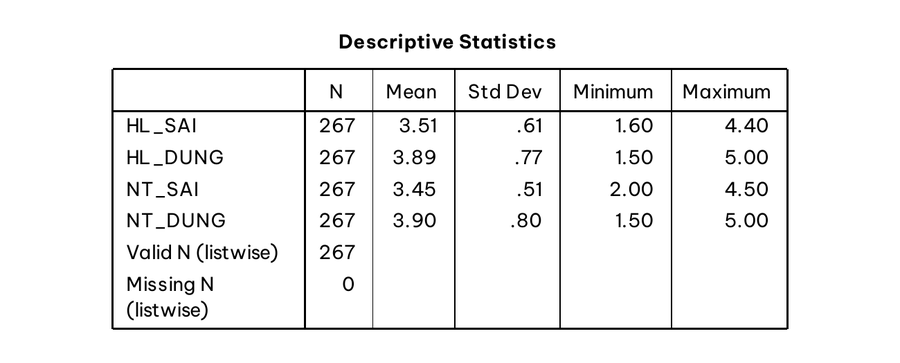
Hình 10. HL_SAI có trung bình 3,51 và không bao giờ đạt tới 5; NT_SAI có độ lệch chuẩn chỉ 0,51.
Với HL: trung bình giảm từ 3,89 xuống 3,51, giá trị lớn nhất chỉ còn 4,40. Lý do là sau khi làm sạch, mọi phiếu đều có AC1 = 2, nên câu này kéo trung bình của mọi người về phía mức 2. Điều đáng chú ý là tương quan giữa HL_SAI và HL_DUNG bằng 1,000. Vì AC1 là hằng số, HL_SAI chỉ là một phép biến đổi tuyến tính của HL_DUNG. Kết quả tương quan và hồi quy sẽ không đổi, nhưng mọi con số mô tả và mọi so sánh với giá trị trung lập 3 đều sai. Lỗi này đặc biệt nguy hiểm vì nó không làm hỏng kết quả nào trông có vẻ quan trọng.
Với NT: đưa NT4 chưa đảo vào làm câu "chống" lại ba câu còn lại. Độ lệch chuẩn giảm từ 0,80 xuống 0,51 và tương quan của biến Niềm tin với câu YD1 giảm từ 0,295 xuống 0,250. Khi kiểm định Cronbach's Alpha, bạn sẽ thấy lỗi này còn làm Cronbach's Alpha giảm mạnh.
Cách phòng tránh: liệt kê từng biến trong hàm MEAN thay vì dùng TO và đặt tên biến đã đảo có hậu tố R để không nhầm.
5. Tính và kiểm tra biến đại diện cho cả mô hình
File cú pháp tính biến đại diện cho cả năm thang đo:
COMPUTE XN = MEAN.3(XN1, XN2, XN3, XN4).
COMPUTE HI = MEAN.3(HI1, HI2, HI3, HI4).
COMPUTE HL = MEAN.3(HL1, HL2, HL3, HL4).
COMPUTE NT = MEAN.3(NT1, NT2, NT3, NT4R).
COMPUTE YD = MEAN.3(YD1, YD2, YD3, YD4).
VARIABLE LABELS XN 'Xác nhận kỳ vọng (trung bình XN1-XN4)'
  /HI 'Nhận thức hữu ích (trung bình HI1-HI4)'
  /HL 'Sự hài lòng (trung bình HL1-HL4)'
  /NT 'Niềm tin (trung bình NT1-NT3, NT4R)'
  /YD 'Ý định mua lại (trung bình YD1-YD4)'.
FORMATS XN HI HL NT YD (F4.2).
VARIABLE LEVEL XN HI HL NT YD (SCALE).
DESCRIPTIVES XN HI HL NT YD /STATISTICS=MEAN STDDEV MIN MAX SKEWNESS KURTOSIS.
Ba lệnh sau COMPUTE quan trọng không kém. Nhãn biến ghi rõ biến đại diện gồm những câu nào. Định dạng F4.2 giúp hiển thị hai chữ số thập phân, vì COMPUTE tạo biến mặc định F8.2. Cấp độ đo lường Scale báo rằng biến đại diện là biến định lượng, khác với các câu Likert riêng lẻ được khai báo là Ordinal (Hình 11).
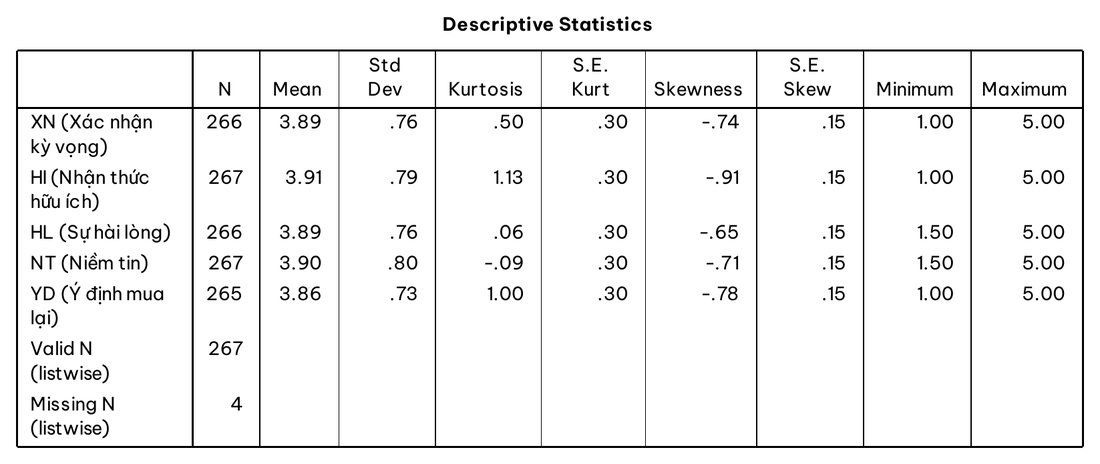
Hình 11. Năm biến đại diện có trung bình từ 3,86 (YD) đến 3,91 (HI), độ lệch chuẩn từ 0,73 đến 0,80.
Kiểm tra ba điểm:
- Số phiếu (N). XN, HL và YD mất 1–2 phiếu vì phiếu đó trả lời ít hơn 3 trong 4 câu. Tổng cộng 4 phiếu thiếu ít nhất một biến đại diện, nên phân tích hồi quy sau này sẽ dùng 263 phiếu.
- Khoảng giá trị. Mọi biến nằm trong khoảng 1–5. Một giá trị ngoài khoảng này cho thấy có lỗi trong công thức.
- Hình dạng phân phối. Độ lệch từ −0,91 đến −0,65, độ nhọn từ −0,09 đến 1,13, tương tự các câu riêng lẻ trong bài thống kê mô tả và nằm trong ngưỡng ±2 và ±7. Theo ngưỡng chặt ±1, HI (1,13) và YD (1,00) có độ nhọn ở mức giới hạn. Khác với câu Likert chỉ có 5 giá trị, biến đại diện có ít nhất 17 giá trị (1,00; 1,25; ...; 5,00), chưa kể các giá trị như 3,67 của phiếu chỉ trả lời 3 câu, nên phù hợp hơn với các phân tích dành cho biến định lượng.
6. Nhóm biến định lượng bằng RECODE
RECODE còn dùng để chuyển biến định lượng thành biến thứ bậc, ví dụ tuổi thành nhóm tuổi để mô tả mẫu:
RECODE TUOI (LOWEST THRU 24=1) (25 THRU 34=2) (35 THRU 44=3) (45 THRU HIGHEST=4) INTO NHOMTUOI.
VALUE LABELS NHOMTUOI 1 '18-24 tuổi' 2 '25-34 tuổi' 3 '35-44 tuổi' 4 'Từ 45 tuổi'.
LOWEST và HIGHEST đại diện cho giá trị nhỏ nhất và lớn nhất có thể có, nên không cần biết trước tuổi nhỏ nhất trong mẫu. Phiếu có tuổi bị thiếu (phiếu 59 ở bước làm sạch) vẫn là giá trị thiếu ở NHOMTUOI. Kiểm tra ranh giới các nhóm bằng lệnh MEANS (Hình 12):
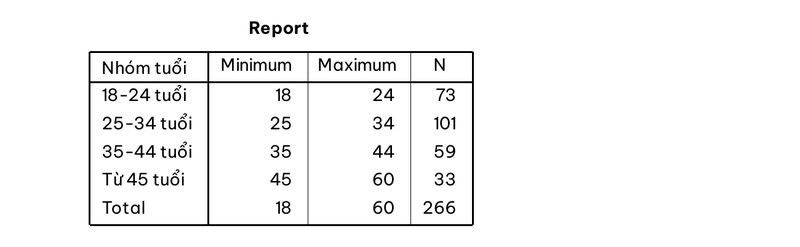
Hình 12. Tuổi nhỏ nhất và lớn nhất của mỗi nhóm đúng với quy định; tổng 266 phiếu.
Kết quả: 73 người 18–24 tuổi, 101 người 25–34 tuổi, 59 người 35–44 tuổi và 33 người từ 45 tuổi. File cú pháp làm tương tự với số lần mua (1–2, 3–5, 6–10 và trên 10 lần).
Một lưu ý quan trọng: chỉ nhóm biến để mô tả, không thay biến gốc trong phân tích. MacCallum và cộng sự (2002) chỉ ra rằng chia một biến định lượng thành nhóm làm mất thông tin, giảm hệ số tương quan và giảm khả năng phát hiện mối quan hệ. Hai người 25 và 34 tuổi bị coi là như nhau, trong khi hai người 34 và 35 tuổi bị coi là khác nhóm. Khi đưa tuổi vào hồi quy, hãy dùng biến TUOI gốc.
7. Lưu file phân tích
SAVE OUTFILE='../du-lieu/du_lieu_phan_tich.sav'
  /DROP=XN_CONG XN_MEAN XN_MEAN3 HL_SAI HL_DUNG NT_SAI NT_DUNG.
File du_lieu_phan_tich.sav gồm toàn bộ biến của bộ dữ liệu sạch, cộng thêm NT4R, năm biến đại diện XN, HI, HL, NT, YD và hai biến nhóm NHOMTUOI, NHOMTS. Các biến minh họa cách tính sai được bỏ đi. Đây là file dùng cho các bài phân tích tiếp theo.
Năm lỗi thường gặp
Năm lỗi dưới đây tổng hợp những điểm dễ sai nhất trong toàn bài.
- Dùng Recode into Same Variables cho câu đảo chiều, làm mất dữ liệu gốc và có nguy cơ đảo hai lần.
- Quên quy tắc cho giá trị giữa (3→3), khiến mọi câu trả lời "Trung lập" thành giá trị thiếu ở biến mới.
- Dùng TO trong hàm MEAN khi giữa các câu của thang đo có biến khác, như câu kiểm tra chú ý.
- Tính biến đại diện bằng phép cộng rồi chia, làm mất mọi phiếu thiếu dù chỉ một câu.
- Tính biến đại diện trước khi kiểm định thang đo rồi quên tính lại sau khi loại câu ở bước Cronbach's Alpha hoặc EFA.
Tài liệu tham khảo
DiStefano, C., Zhu, M., & Mîndrilă, D. (2009). Understanding and using factor scores: Considerations for the applied researcher. Practical Assessment, Research, and Evaluation, 14(20). https://doi.org/10.7275/da8t-4g52
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
GNU Project. (n.d.). GNU PSPP manual. Retrieved October 30, 2026, from https://www.gnu.org/software/pspp/manual/
MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
Newman, D. A. (2014). Missing data: Five practical guidelines. Organizational Research Methods, 17(4), 372–411. https://doi.org/10.1177/1094428114548590
Pallant, J. (2020). SPSS survival manual: A step by step guide to data analysis using IBM SPSS (7th ed.). Routledge. https://doi.org/10.4324/9781003117452
Suárez-Alvarez, J., Pedrosa, I., Lozano, L. M., García-Cueto, E., Cuesta, M., & Muñiz, J. (2018). Using reversed items in Likert scales: A questionable practice. Psicothema, 30(2), 149–158. https://doi.org/10.7334/psicothema2018.33
Weijters, B., & Baumgartner, H. (2012). Misresponse to reversed and negated items in surveys: A review. Journal of Marketing Research, 49(5), 737–747. https://doi.org/10.1509/jmr.11.0368