
PHÂN TÍCH NHÂN TỐ KHÁM PHÁ EFA TRONG SPSS/PSPP
KMO và Bartlett, chọn PAF với Promax, xác định số nhân tố bằng phân tích song song và đọc ma trận mẫu
Bài nên đọc trước
Bài Cronbach's Alpha cho thấy cả năm thang đo đều có Cronbach's Alpha tốt. Nhưng Alpha chỉ cho biết các câu trong một thang đo tương quan với nhau. Alpha không cho biết câu HI4 "Nhìn chung, sàn X hữu ích cho nhu cầu mua sắm của tôi" có thực sự đo Nhận thức hữu ích, hay đáp viên hiểu nó gần với Sự hài lòng hơn. Muốn biết 20 câu hỏi có tách thành đúng 5 nhóm như mô hình không, cần phân tích nhân tố khám phá (Exploratory Factor Analysis, EFA).
Bài viết này hướng dẫn chạy EFA trong PSPP cho 20 câu đo lường của bộ dữ liệu mẫu (du_lieu_phan_tich.sav). Bài đi qua sáu bước: kiểm tra dữ liệu, chọn phương pháp, xác định số nhân tố, đọc ma trận xoay, xử lý câu có vấn đề và báo cáo. Bài cũng chỉ ra ba điểm PSPP khác SPSS mà nếu không biết, bạn sẽ ra kết quả sai. Mọi ảnh là ảnh chụp giao diện PSPP 2.0 thật và kết quả thật từ file cú pháp efa.sps đi kèm (Free Software Foundation, 2023).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
12-phan-tich-nhan-to-kham-pha-efacủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. EFA làm gì và quy trình sáu bước
EFA tìm một số ít nhân tố (factor) giải thích được phần lớn tương quan giữa nhiều câu hỏi. Nếu bốn câu HL1–HL4 tương quan chặt với nhau nhưng ít tương quan với các câu khác, EFA sẽ gom chúng vào cùng một nhân tố. Với một thang đo đã có cơ sở lý thuyết như trong nghiên cứu này, EFA kiểm tra xem dữ liệu có ủng hộ cấu trúc 5 khái niệm đã đề xuất không. Việc kiểm định chặt chẽ cấu trúc đó bằng mô hình sẽ là phân tích nhân tố khẳng định (CFA) ở cụm bài AMOS (Hình 1).
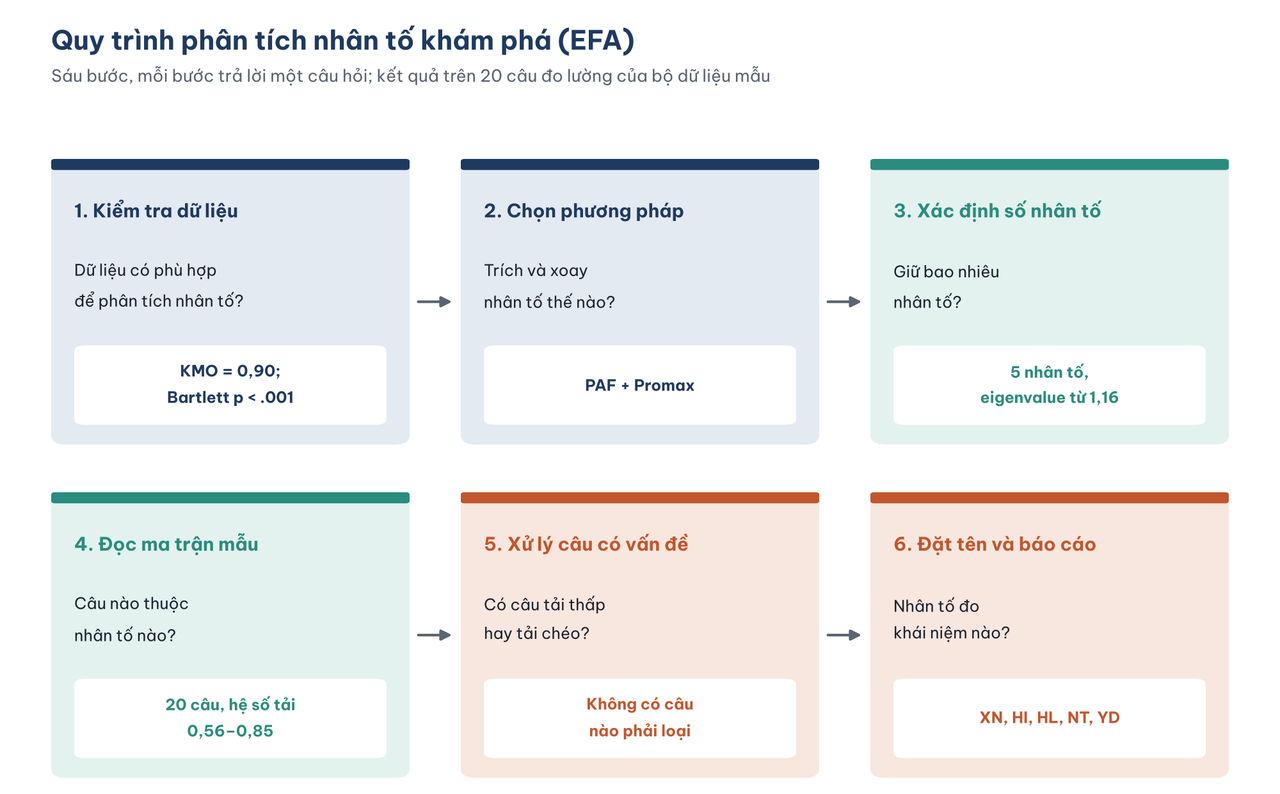
Hình 1. Sáu bước của EFA và kết quả của từng bước trên bộ dữ liệu mẫu.
Một câu hỏi thường gặp là nên chạy EFA riêng cho biến độc lập và biến phụ thuộc, hay chạy chung. Nhiều luận văn chạy riêng. Bài này chạy chung 20 câu, vì hai lý do. Thứ nhất, mô hình có biến trung gian (Sự hài lòng vừa là kết quả của XN, HI vừa là nguyên nhân của YD), nên khó phân chia "độc lập" và "phụ thuộc". Thứ hai, chạy chung kiểm tra được các câu của Ý định mua lại có tách biệt với các câu của Sự hài lòng không, một bằng chứng sơ bộ về giá trị phân biệt.
2. Kiểm tra điều kiện trước khi chạy EFA
EFA chỉ cho kết quả đáng tin khi mẫu đủ lớn và các câu đủ tương quan với nhau.
Cỡ mẫu
EFA dùng loại theo danh sách: phiếu thiếu bất kỳ câu nào trong 20 câu sẽ bị loại. Từ 267 phiếu, EFA dùng 254 phiếu đầy đủ (bài làm sạch dữ liệu). Hair và cộng sự (2019) đề nghị tối thiểu 5 quan sát cho mỗi biến, tốt hơn là 10. Tỷ lệ ở đây là 254 / 20 ≈ 12,7, đạt cả hai mức và cao hơn mức tối thiểu 200 đã tính cho EFA ở bài cỡ mẫu.
KMO và kiểm định Bartlett
Hai chỉ số này cho biết các câu có đủ tương quan với nhau để phân tích nhân tố hay không. Chúng nằm trong bảng đầu tiên của kết quả (Hình 2).
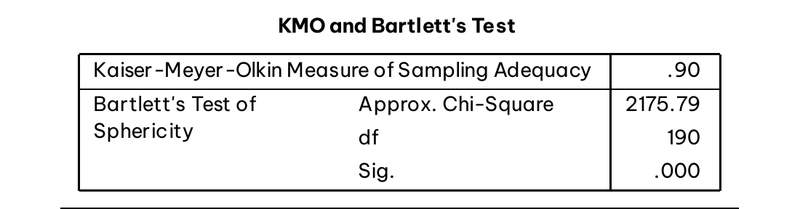
Hình 2. KMO = 0,90; kiểm định Bartlett χ²(190) = 2175,79, p < ,001.
Hệ số KMO (Kaiser-Meyer-Olkin) so sánh độ lớn của tương quan thông thường với tương quan riêng phần giữa các câu. KMO gần 1 nghĩa là tương quan giữa hai câu bất kỳ phần lớn được giải thích bởi các câu khác, đúng như khi có nhân tố chung. Kaiser (1974) xếp hạng KMO như sau: từ 0,90 là "tuyệt vời", từ 0,80 là "rất tốt", từ 0,70 là "khá", từ 0,60 là "tạm được", từ 0,50 là "kém" và dưới 0,50 là "không chấp nhận được". Dữ liệu mẫu có KMO = 0,90.
Kiểm định Bartlett kiểm tra giả thuyết ma trận tương quan là ma trận đơn vị, tức các câu hoàn toàn không tương quan. Kết quả p < ,001 bác bỏ giả thuyết này. Với cỡ mẫu vài trăm, kiểm định Bartlett gần như luôn có ý nghĩa, nên đây là điều kiện cần chứ không đủ.
Bên cạnh KMO chung, nên xem chỉ số MSA của từng câu (KMO riêng từng biến). Câu nào có MSA dưới 0,50 nên được xem xét loại trước khi chạy EFA (Hair và cộng sự, 2019). PSPP in các giá trị này trên đường chéo của ma trận anti-image (/PRINT=AIC), nhưng bảng rất lớn. Script efa_bo_sung.py đi kèm tính gọn cả 20 giá trị: thấp nhất là NT2 (0,84), cao nhất là HI4 (0,93). Script cũng tính định thức của ma trận tương quan là 1,42 × 10⁻⁴, lớn hơn ngưỡng 10⁻⁵ mà Field (2024) dùng để cảnh báo đa cộng tuyến quá cao giữa các câu.
3. Chọn phương pháp trích và phép xoay
Hai lựa chọn quan trọng nhất khi chạy EFA là phương pháp trích nhân tố và phép xoay.
Phương pháp trích: PAF hay PCA?
Có hai lựa chọn phổ biến:
- Phân tích thành phần chính (Principal Components Analysis, PCA) tóm tắt toàn bộ phương sai của các câu thành các thành phần. PCA là phương pháp mặc định trong SPSS và PSPP.
- Phân tích nhân tố trục chính (Principal Axis Factoring, PAF) chỉ phân tích phần phương sai chung giữa các câu, bỏ qua phương sai riêng và sai số đo lường của từng câu.
Về lý thuyết, PCA là kỹ thuật giảm số biến, còn PAF mới đúng là phân tích nhân tố, tức tìm các khái niệm tiềm ẩn gây ra câu trả lời. Fabrigar và cộng sự (1999) và Costello và Osborne (2005) đều khuyến nghị dùng PAF hoặc ước lượng hợp lý cực đại (ML) khi mục tiêu là xác định cấu trúc khái niệm. Bài này dùng PAF. Mục 7 so sánh với PCA để bạn thấy sự khác nhau.
Phép xoay: Promax hay Varimax?
Ma trận nhân tố chưa xoay thường khó đọc: hầu hết các câu tải mạnh lên nhân tố thứ nhất. Phép xoay phân bố lại hệ số tải để mỗi câu tải mạnh lên một nhân tố duy nhất. Có hai nhóm:
- Xoay vuông góc (orthogonal), như Varimax, giả định các nhân tố không tương quan với nhau.
- Xoay xiên (oblique), như Promax hay Direct Oblimin, cho phép các nhân tố tương quan.
Trong nghiên cứu hành vi khách hàng, các khái niệm gần như luôn tương quan: người hài lòng hơn thường có ý định mua lại cao hơn. Giả định chúng không tương quan là không thực tế. Tabachnick và Fidell (2019) đề xuất chạy xoay xiên trước, rồi xem ma trận tương quan nhân tố. Nếu có tương quan từ 0,32 trở lên, xoay xiên là phù hợp. Bài này dùng Promax và mục 6 sẽ cho thấy tương quan giữa các nhân tố lên đến 0,62.
4. Chạy EFA trong PSPP
PSPP chạy EFA bằng lệnh FACTOR, qua giao diện hoặc cú pháp.
Bằng giao diện
Chọn Analyze > Factor Analysis. Trong hộp thoại Factor Analysis (Hình 3), đưa 20 câu đo lường vào ô Variables (1). Dùng NT4R đã mã hóa ngược, không dùng NT4 và không đưa câu kiểm tra chú ý AC1 hay các biến đại diện vào. Sau đó bấm Extraction (2) và Rotations (3) để thiết lập.
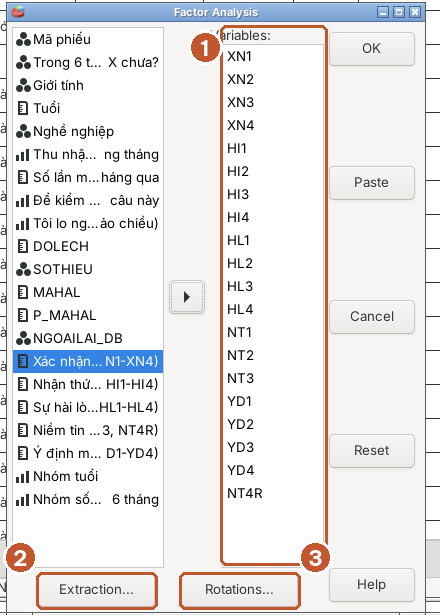
Hình 3. 20 câu đo lường trong ô Variables, với NT4R thay cho NT4.
Hộp thoại Extraction (Hình 4) có một cái bẫy: PSPP mặc định chọn Covariance matrix (ma trận hiệp phương sai) ở mục Analyze, khác với SPSS mặc định dùng ma trận tương quan. Thiết lập như sau:
- Method: chọn Principal Axis Factoring.
- Analyze: chọn Correlation matrix. Phân tích trên ma trận tương quan nghĩa là chuẩn hóa mọi câu trước khi phân tích và kết quả mới so sánh được với các hướng dẫn và nghiên cứu khác.
- Display: đánh dấu Scree plot.
- Extract: giữ Eigenvalues over 1.00 times the mean eigenvalue. Với ma trận tương quan, eigenvalue trung bình bằng 1, nên tiêu chí này chính là tiêu chí Kaiser: giữ nhân tố có eigenvalue lớn hơn 1.
- Maximum iterations: tăng từ 25 lên 100, để PAF có đủ số vòng lặp để hội tụ.
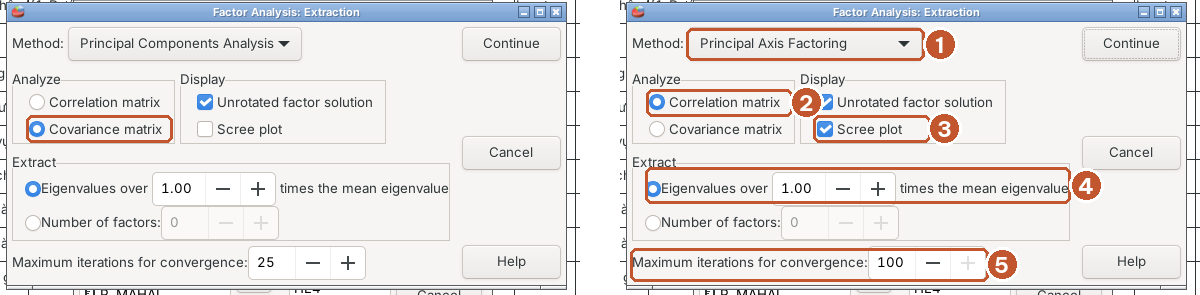
Hình 4. Trái: mặc định của PSPP là PCA trên ma trận hiệp phương sai (khung đỏ). Phải: sau khi chỉnh sang PAF trên ma trận tương quan.
Hộp thoại Rotation (Hình 5) có điểm khác thứ hai: PSPP 2.0 chỉ cho chọn None, Varimax, Quartimax và Equimax trên giao diện. Promax chỉ có trong cú pháp. Chọn tạm Varimax, bấm Continue, rồi bấm Paste ở hộp thoại chính để lấy cú pháp và sửa.
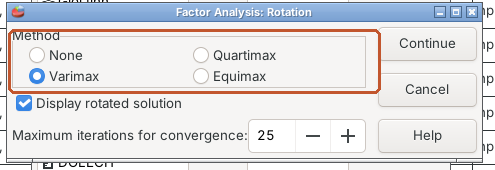
Hình 5. Giao diện PSPP không có lựa chọn Promax.
Sửa cú pháp
Cú pháp do PSPP sinh ra cần thêm ba chỗ (Hình 6). Đây cũng là điểm khác thứ ba: giao diện PSPP không có ô chọn KMO, nên phải thêm bằng tay.
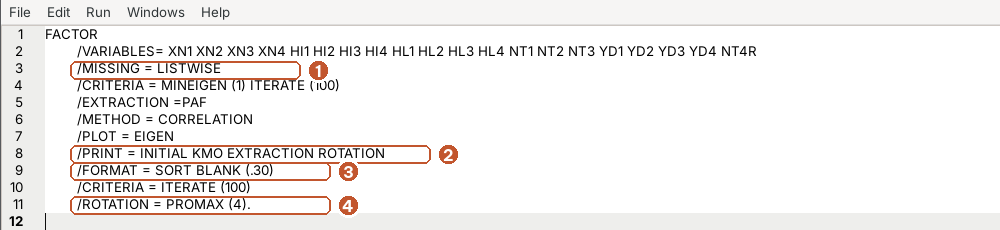
Hình 6. Bốn dòng được thêm hoặc sửa: loại theo danh sách (1), in KMO (2), sắp xếp và ẩn hệ số tải nhỏ (3), xoay Promax (4).
File efa.sps đi kèm viết gọn lại như sau:
FACTOR
  /VARIABLES=XN1 XN2 XN3 XN4 HI1 HI2 HI3 HI4 HL1 HL2 HL3 HL4 NT1 NT2 NT3 NT4R YD1 YD2 YD3 YD4
  /MISSING=LISTWISE
  /PRINT=INITIAL KMO EXTRACTION ROTATION
  /PLOT=EIGEN
  /FORMAT=SORT BLANK(.30)
  /CRITERIA=MINEIGEN(1) ITERATE(100)
  /EXTRACTION=PAF
  /ROTATION=PROMAX(4).
/FORMAT=SORT BLANK(.30) sắp xếp các câu theo nhân tố mà chúng tải mạnh nhất và ẩn các hệ số tải dưới 0,30, giúp ma trận dễ đọc hơn nhiều. Trong SPSS, tùy chọn tương ứng nằm ở nút Options (Sorted by size, Suppress small coefficients), còn KMO nằm ở nút Descriptives. Con số 4 trong PROMAX(4) là tham số kappa, giá trị mặc định của SPSS.
5. Xác định số nhân tố
Số nhân tố cần giữ là quyết định quan trọng nhất của EFA. Ba tiêu chí dưới đây nên được xem cùng nhau.
Eigenvalue và phương sai trích
Bảng Total Variance Explained cho biết eigenvalue và phần phương sai mà mỗi nhân tố giải thích (Hình 7).
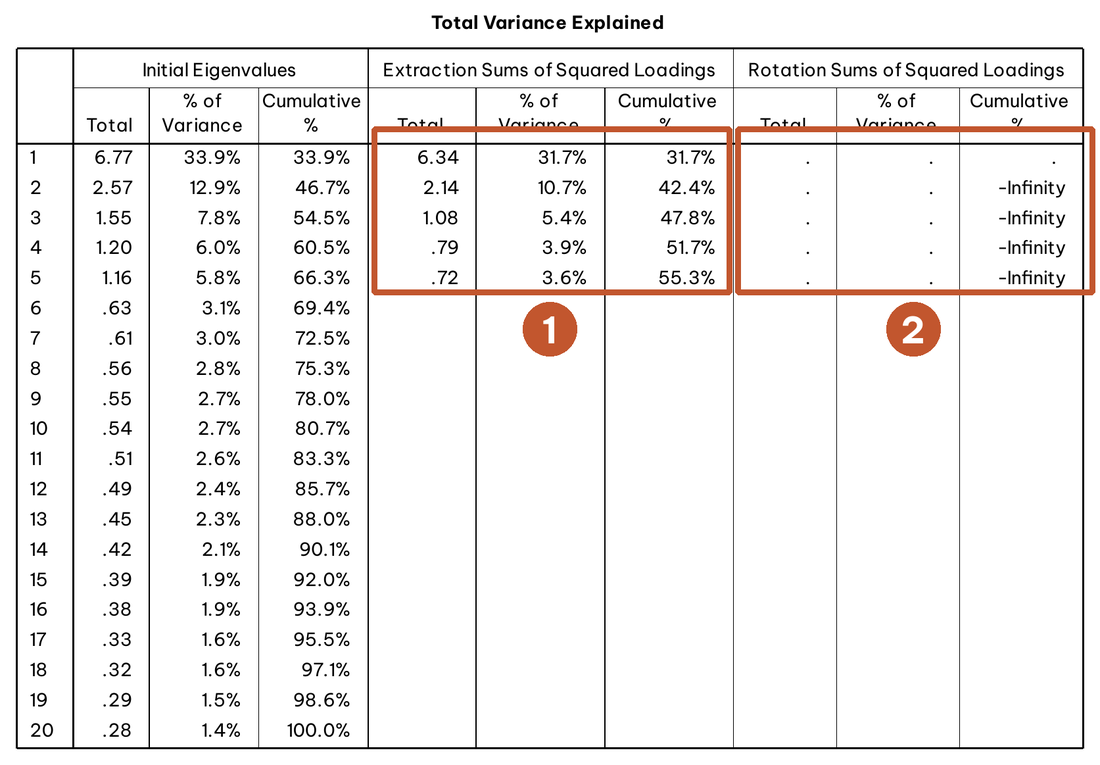
Hình 7. Năm nhân tố có eigenvalue ban đầu lớn hơn 1, giải thích 55,3% phương sai sau khi trích bằng PAF (1). Cột Rotation Sums of Squared Loadings của PSPP hiển thị dấu chấm và "-Infinity" với phép xoay xiên (2).
Bảng này có ba nhóm cột:
- Initial Eigenvalues: eigenvalue của ma trận tương quan ban đầu. Năm nhân tố đầu có eigenvalue 6,77; 2,57; 1,55; 1,20 và 1,16. Nhân tố thứ sáu chỉ còn 0,63. Theo tiêu chí Kaiser, giữ 5 nhân tố, giải thích 66,3% tổng phương sai.
- Extraction Sums of Squared Loadings: phương sai mà 5 nhân tố giải thích sau khi trích bằng PAF, là 55,3%. Con số này luôn thấp hơn ở PCA, vì PAF không tính phần phương sai riêng của từng câu. Hair và cộng sự (2019) cho rằng trong khoa học xã hội, các nhân tố giải thích từ 60% phương sai là đạt yêu cầu và mức thấp hơn vẫn thường gặp. Vì PAF chỉ tính phần phương sai chung, phương sai trích của PAF thường thấp hơn PCA khoảng 10 điểm phần trăm, như ở đây (55,3% so với 66,3%).
- Rotation Sums of Squared Loadings: với phép xoay xiên, các nhân tố tương quan với nhau nên phương sai của chúng chồng lấn, không cộng được thành tỷ lệ phần trăm. SPSS chỉ in cột Total trong trường hợp này. PSPP 2.0 in dấu chấm và "-Infinity". Đây là lỗi hiển thị của PSPP, không phải lỗi dữ liệu; hãy bỏ qua nhóm cột này và báo cáo phương sai trích ở nhóm cột thứ hai.
Biểu đồ scree
Biểu đồ scree vẽ eigenvalue theo thứ tự nhân tố để tìm điểm gãy của đường cong (Hình 8).
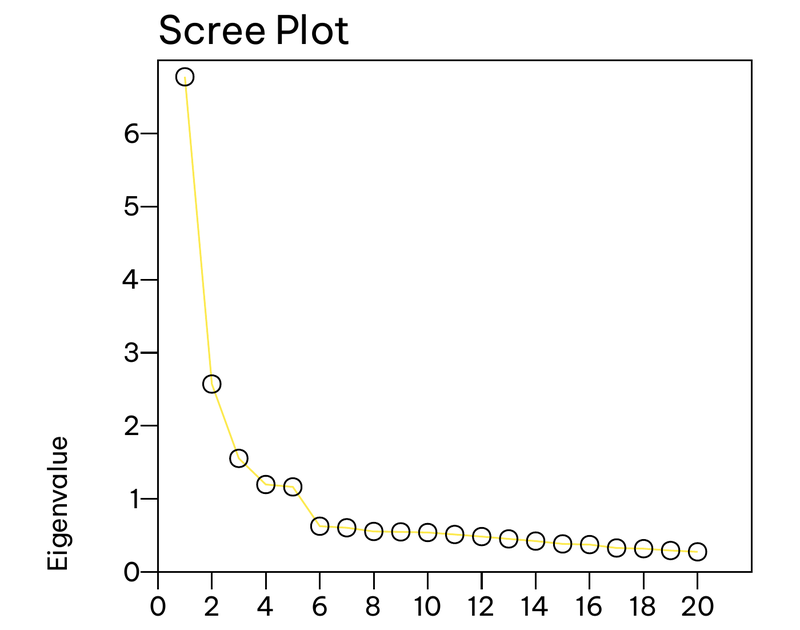
Hình 8. Đường eigenvalue gãy rõ sau nhân tố thứ năm.
Biểu đồ scree vẽ eigenvalue theo thứ tự nhân tố. Số nhân tố cần giữ là số điểm nằm trước chỗ đường cong chuyển sang nằm ngang. Ở đây, đường gãy rõ giữa nhân tố thứ năm (1,16) và thứ sáu (0,63), ủng hộ 5 nhân tố.
Phân tích song song
Tiêu chí eigenvalue lớn hơn 1 có xu hướng giữ quá nhiều nhân tố khi có nhiều câu hỏi (Costello & Osborne, 2005). Phân tích song song (parallel analysis) của Horn (1965) là cách đáng tin cậy hơn: so sánh eigenvalue của dữ liệu thật với eigenvalue của dữ liệu ngẫu nhiên cùng kích thước và chỉ giữ nhân tố có eigenvalue thật lớn hơn. PSPP và SPSS không có sẵn phép tính này. Script efa_bo_sung.py chạy 1.000 lần mô phỏng và cho một kết quả đáng chú ý (Hình 9):
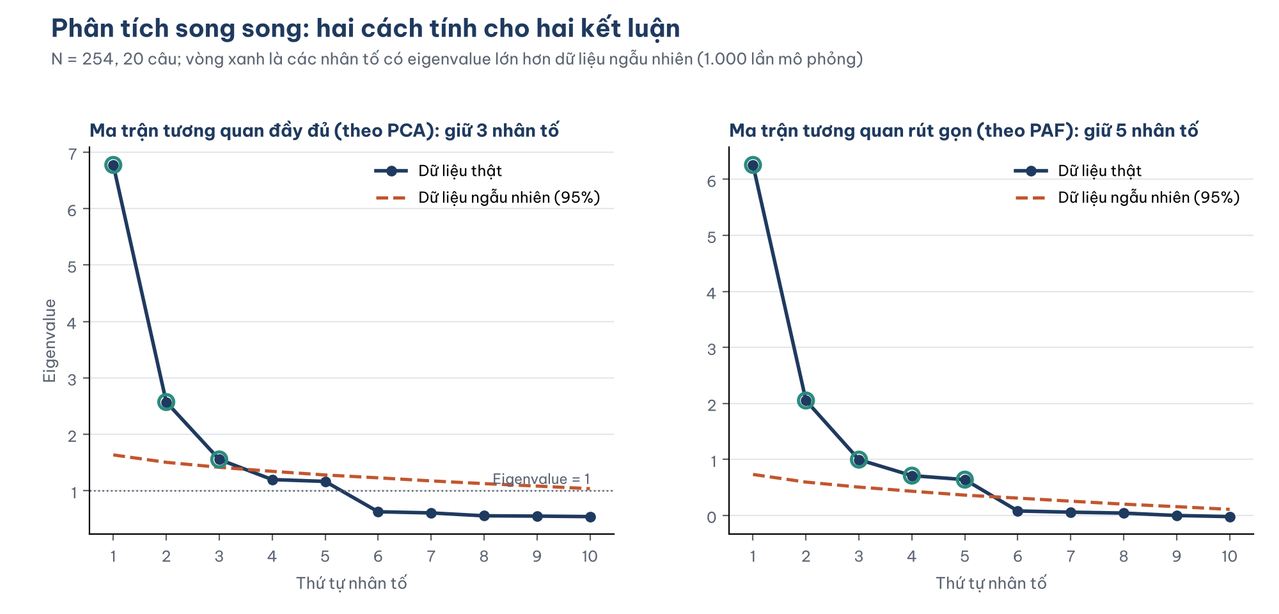
Hình 9. Tính trên ma trận tương quan đầy đủ (kiểu PCA), phân tích song song gợi ý 3 nhân tố. Tính trên ma trận rút gọn (kiểu PAF), kết quả là 5 nhân tố.
Bảng 1 ghi các eigenvalue thực và eigenvalue ngẫu nhiên của từng cách tính.
Bảng 1. Phân tích song song trên ma trận đầy đủ và ma trận rút gọn.
| Thứ tự | Eigenvalue (PCA) | Ngẫu nhiên, 95% (PCA) | Eigenvalue (PAF) | Ngẫu nhiên, 95% (PAF) |
|---|---|---|---|---|
| 3 | 1,554 | 1,415 | 0,995 | 0,504 |
| 4 | 1,197 | 1,344 | 0,709 | 0,431 |
| 5 | 1,165 | 1,279 | 0,638 | 0,361 |
| 6 | 0,627 | 1,228 | 0,078 | 0,308 |
Hai cách cho hai kết luận khác nhau. Crawford và cộng sự (2010) chỉ ra rằng phân tích song song dựa trên PCA có xu hướng giữ quá ít nhân tố khi các nhân tố tương quan với nhau, đúng như trường hợp này. Để kiểm tra, file cú pháp chạy thêm EFA với đúng 3 nhân tố (/CRITERIA=FACTORS(3)). Kết quả ở Hình 12 (mục 7): 12 câu của XN, HI và HL bị gộp vào một nhân tố duy nhất, trong khi lý thuyết ECM coi đây là ba khái niệm khác nhau, có quan hệ nhân quả với nhau.
Tổng hợp các bằng chứng: tiêu chí Kaiser, biểu đồ scree, phân tích song song dựa trên PAF và lý thuyết đều ủng hộ 5 nhân tố. Đây là cách ra quyết định nên làm: không dựa vào một tiêu chí duy nhất và khi các tiêu chí mâu thuẫn, hãy xem nghiệm nào có ý nghĩa về mặt lý thuyết.
6. Đọc ma trận xoay
Với phép xoay xiên, PSPP in hai ma trận: Pattern Matrix (ma trận mẫu) và Structure Matrix (ma trận cấu trúc). Ma trận mẫu cho biết tác động riêng của mỗi nhân tố lên một câu, sau khi đã tính đến tương quan giữa các nhân tố. Ma trận cấu trúc là tương quan đơn giản giữa câu và nhân tố, nên bị "thổi phồng" bởi tương quan giữa các nhân tố. Khi diễn giải và báo cáo, hãy dùng ma trận mẫu (Tabachnick & Fidell, 2019) (Hình 10).
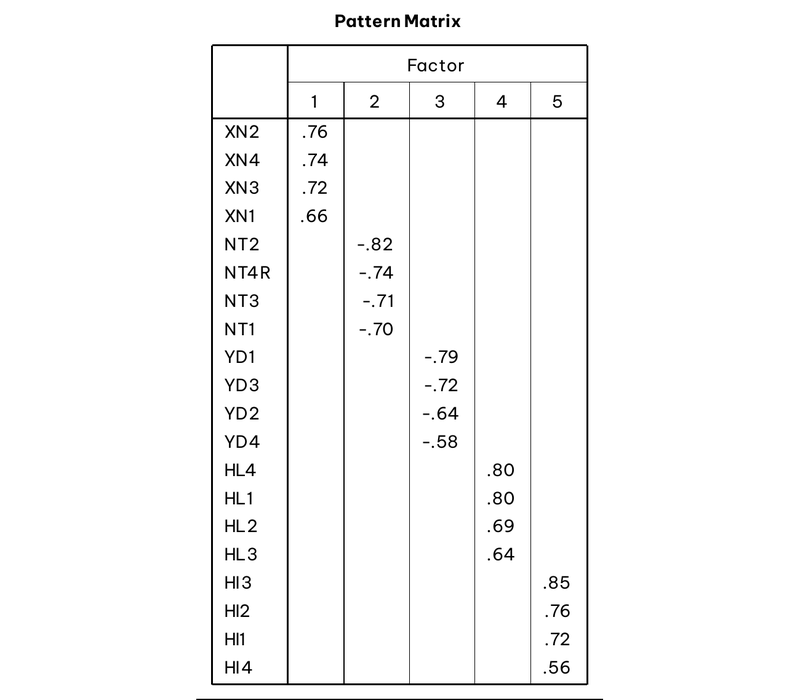
Hình 10. Mỗi câu tải mạnh lên đúng một nhân tố, không có hệ số tải chéo nào từ 0,30 trở lên.
Đánh giá hệ số tải
Hệ số tải (factor loading) là mức độ một câu phản ánh nhân tố. Hai ngưỡng hay dùng:
- Ngưỡng theo cỡ mẫu: Hair và cộng sự (2019) cho rằng với cỡ mẫu khoảng 250, hệ số tải từ 0,35 là có ý nghĩa thống kê.
- Ngưỡng thực tiễn: hệ số tải từ 0,50 được coi là có ý nghĩa thực tiễn, từ 0,70 là cấu trúc rõ ràng (Hair và cộng sự, 2019).
Kết quả của 5 nhân tố (Bảng 2):
Bảng 2. Năm nhân tố rút trích và hệ số tải.
| Nhân tố | Các câu | Hệ số tải | Khái niệm |
|---|---|---|---|
| 1 | XN1–XN4 | 0,66 đến 0,76 | Xác nhận kỳ vọng |
| 2 | NT1–NT3, NT4R | −0,70 đến −0,82 | Niềm tin |
| 3 | YD1–YD4 | −0,58 đến −0,79 | Ý định mua lại |
| 4 | HL1–HL4 | 0,64 đến 0,80 | Sự hài lòng |
| 5 | HI1–HI4 | 0,56 đến 0,85 | Nhận thức hữu ích |
Cả 20 câu tải lên đúng nhân tố theo lý thuyết, với hệ số tải từ 0,56 trở lên. Câu yếu nhất là HI4 (0,56), cũng là câu có tương quan biến-tổng thấp nhất ở bài Cronbach's Alpha và có hệ số chung (communality) thấp nhất (0,44). Đây là sự nhất quán đáng chú ý giữa hai phân tích.
Vì sao có hệ số tải âm?
Nhân tố 2 và 3 có toàn bộ hệ số tải âm. Đây không phải dấu hiệu các câu đo ngược chiều. Hướng của một nhân tố là tùy ý về mặt toán học: đổi dấu toàn bộ hệ số tải của một nhân tố cho một nghiệm hoàn toàn tương đương. Khi tất cả các câu của một nhân tố cùng dấu âm, chỉ cần hiểu nhân tố đó "ngược chiều" và đổi dấu khi báo cáo. Điều cần lo là khi các câu trong cùng một nhân tố có dấu khác nhau, như NT4 chưa mã hóa ngược sẽ có dấu ngược với NT1–NT3.
Tương quan giữa các nhân tố
Với phép xoay Promax, PSPP in thêm ma trận tương quan giữa các nhân tố (Hình 11).
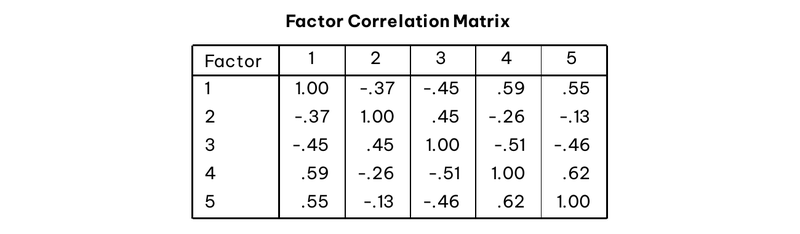
Hình 11. Tương quan giữa các nhân tố sau khi xoay Promax.
Sau khi đổi dấu nhân tố 2 (NT) và 3 (YD), mọi tương quan đều dương, đúng với kỳ vọng lý thuyết (Bảng 3):
Bảng 3. Tương quan giữa các nhân tố sau khi đổi dấu.
| XN | NT | YD | HL | HI | |
|---|---|---|---|---|---|
| XN | 1 | ||||
| NT | 0,37 | 1 | |||
| YD | 0,45 | 0,45 | 1 | ||
| HL | 0,59 | 0,26 | 0,51 | 1 | |
| HI | 0,55 | 0,13 | 0,46 | 0,62 | 1 |
Tương quan lớn nhất là giữa HL và HI (0,62), tiếp theo là HL và XN (0,59), khớp với giả thuyết H2 và H3 rằng XN và HI tác động đến HL. Nhiều tương quan vượt 0,32, xác nhận lựa chọn xoay xiên là đúng. Không có tương quan nào vượt 0,70, mức thường được coi là dấu hiệu hai nhân tố khó phân biệt. Giá trị phân biệt sẽ được kiểm định chặt chẽ hơn bằng AVE và HTMT ở các cụm bài AMOS và SmartPLS.
7. So sánh với các lựa chọn khác
Kết quả trên dùng PAF và Promax. Phần này so sánh với các lựa chọn khác mà nhiều luận văn hay dùng.
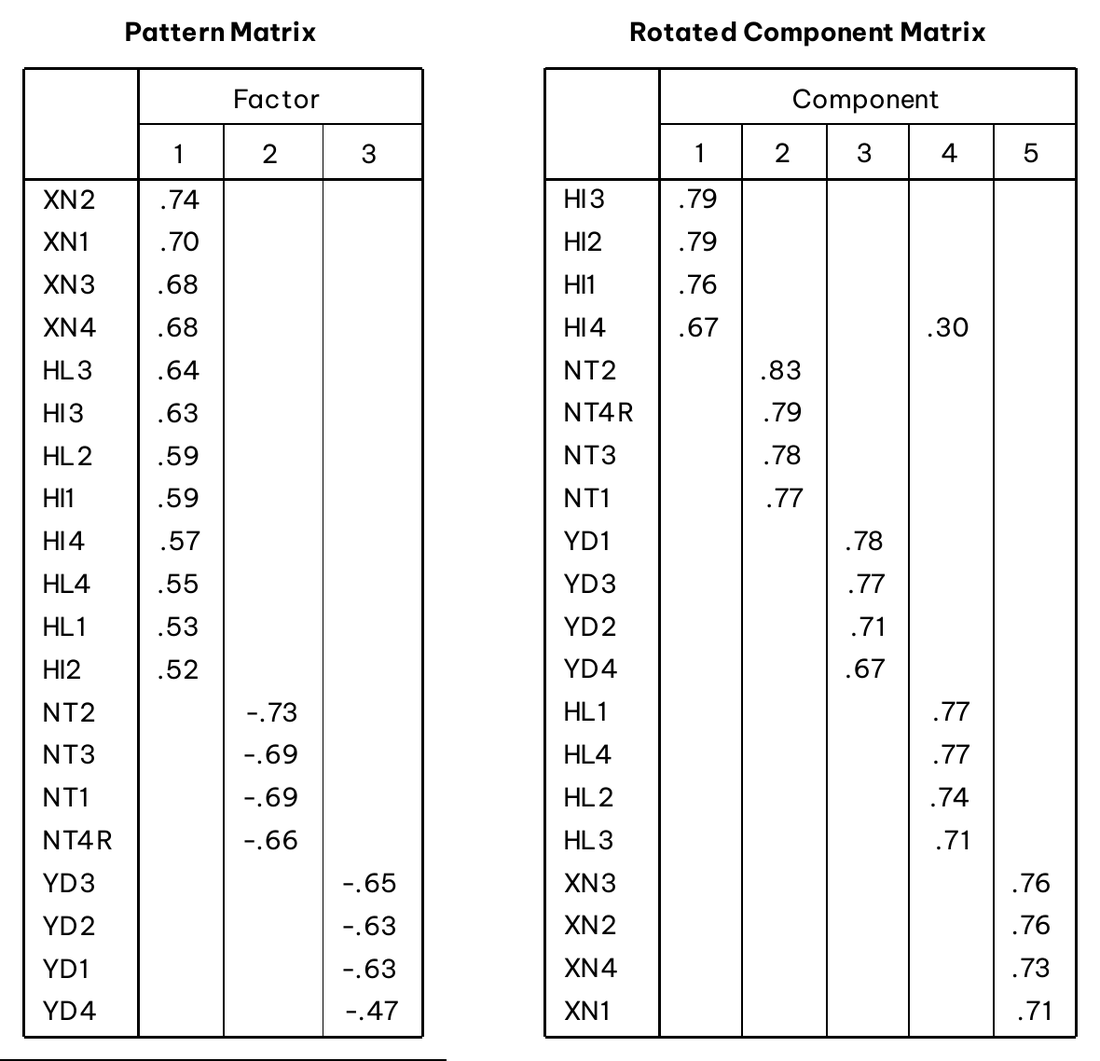
Hình 12. Trái: ép 3 nhân tố (PAF + Promax), 12 câu XN, HI, HL gộp vào nhân tố 1. Phải: PCA + Varimax cho cùng cấu trúc 5 nhóm như PAF + Promax.
Nghiệm 3 nhân tố (bên trái) gộp Xác nhận kỳ vọng, Nhận thức hữu ích và Sự hài lòng thành một nhân tố, với hệ số tải từ 0,52 đến 0,74. Về mặt thống kê, nghiệm này không "sai", nhưng nó không phân biệt được ba khái niệm mà mô hình cần tách riêng để kiểm định giả thuyết.
PCA + Varimax (bên phải) là cách làm mặc định trong nhiều luận văn. Với dữ liệu mẫu, cách này cho cùng 5 nhóm câu, hệ số tải cao hơn (0,67 đến 0,83) và tổng phương sai trích cao hơn (66,3%). Hệ số tải cao hơn không có nghĩa là thang đo tốt hơn: PCA tính cả phần phương sai riêng của từng câu vào thành phần. Có một khác biệt đáng chú ý: với Varimax, HI4 có hệ số tải chéo 0,30 lên thành phần Sự hài lòng, do phép xoay vuông góc buộc các thành phần không tương quan trong khi HI và HL tương quan 0,62. Với Promax, tải chéo này biến mất. Khi các khái niệm tương quan, xoay vuông góc có thể tạo ra tải chéo "giả".
8. Khi nào cần loại câu?
Dữ liệu mẫu cho kết quả gọn, nhưng với dữ liệu thật bạn thường gặp ba tình huống:
- Hệ số tải thấp: câu có hệ số tải lớn nhất dưới 0,50 (hoặc dưới 0,40 trong nghiên cứu khám phá). Câu này không phản ánh tốt nhân tố nào.
- Tải chéo: câu tải từ 0,32 trở lên trên hai nhân tố (Costello & Osborne, 2005), hoặc hai hệ số tải xấp xỉ nhau. Câu này không phân biệt được hai khái niệm.
- Câu tải sai nhân tố: ví dụ một câu HI tải lên nhân tố của HL. Đây có thể là dấu hiệu câu hỏi được diễn đạt mơ hồ.
Nguyên tắc xử lý giống bài Cronbach's Alpha: mỗi lần chỉ loại một câu (câu có vấn đề nặng nhất), rồi chạy lại EFA, vì loại một câu làm thay đổi toàn bộ nghiệm. Cân nhắc nội dung trước khi loại, đảm bảo mỗi nhân tố còn ít nhất 3 câu và ghi rõ các câu bị loại cùng lý do. Sau khi loại câu, chạy lại Cronbach's Alpha và tính lại biến đại diện.
9. Trình bày kết quả EFA trong báo cáo
Bảng kết quả EFA trong luận văn thường gồm các câu xếp theo nhân tố, hệ số tải trên ma trận mẫu và các chỉ số tổng hợp ở cuối bảng (Bảng 4):
Bảng 4. Kết quả EFA trình bày theo chuẩn luận văn.
| Câu | Nhân tố 1 (XN) | Nhân tố 2 (NT) | Nhân tố 3 (YD) | Nhân tố 4 (HL) | Nhân tố 5 (HI) |
|---|---|---|---|---|---|
| XN2 | 0,76 | ||||
| XN4 | 0,74 | ||||
| XN3 | 0,72 | ||||
| XN1 | 0,66 | ||||
| NT2 | 0,82 | ||||
| NT4R | 0,74 | ||||
| NT3 | 0,71 | ||||
| NT1 | 0,70 | ||||
| YD1 | 0,79 | ||||
| YD3 | 0,72 | ||||
| YD2 | 0,64 | ||||
| YD4 | 0,58 | ||||
| HL4 | 0,80 | ||||
| HL1 | 0,80 | ||||
| HL2 | 0,69 | ||||
| HL3 | 0,64 | ||||
| HI3 | 0,85 | ||||
| HI2 | 0,76 | ||||
| HI1 | 0,72 | ||||
| HI4 | 0,56 | ||||
| Eigenvalue ban đầu | 6,77 | 2,57 | 1,55 | 1,20 | 1,16 |
Ghi chú: N = 254. Trích nhân tố trục chính, xoay Promax (kappa = 4). Hệ số tải dưới 0,30 không hiển thị. Dấu của nhân tố 2 và 3 đã được đổi. KMO = 0,90; Bartlett χ²(190) = 2175,79, p < ,001. Tổng phương sai trích: 55,3%.
Lưu ý: thứ tự eigenvalue ở dòng cuối là thứ tự của nhân tố trước khi xoay, không nhất thiết trùng với thứ tự cột sau khi xoay. Nhiều tác giả chỉ báo cáo tổng phương sai trích để tránh nhầm lẫn này.
Đoạn văn mẫu: "Phân tích nhân tố khám phá được thực hiện trên 20 câu đo lường (N = 254) bằng phương pháp trích nhân tố trục chính với phép xoay Promax. Dữ liệu phù hợp để phân tích nhân tố (KMO = 0,90; kiểm định Bartlett χ²(190) = 2175,79, p < ,001; MSA của từng câu từ 0,84 đến 0,93). Tiêu chí eigenvalue lớn hơn 1, biểu đồ scree và phân tích song song dựa trên ma trận tương quan rút gọn cùng ủng hộ 5 nhân tố, giải thích 55,3% phương sai. Cả 20 câu tải lên đúng nhân tố theo lý thuyết với hệ số tải từ 0,56 đến 0,85 và không có tải chéo từ 0,30 trở lên. Tương quan giữa các nhân tố từ 0,13 đến 0,62."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chạy và báo cáo EFA.
- Để PSPP phân tích ma trận hiệp phương sai (mặc định của giao diện) thay vì ma trận tương quan.
- Dùng câu đảo chiều chưa mã hóa ngược, khiến câu đó tải âm trong khi các câu cùng nhân tố tải dương.
- Dùng xoay vuông góc khi các khái niệm tương quan, có thể tạo ra tải chéo không có thật.
- Chỉ dựa vào tiêu chí eigenvalue lớn hơn 1 để quyết định số nhân tố, không kiểm tra scree, phân tích song song và lý thuyết.
- Đọc ma trận cấu trúc thay cho ma trận mẫu khi dùng xoay xiên, thấy hàng loạt "tải chéo" do tương quan giữa các nhân tố.
Tài liệu tham khảo
Costello, A. B., & Osborne, J. W. (2005). Best practices in exploratory factor analysis: Four recommendations for getting the most from your analysis. Practical Assessment, Research, and Evaluation, 10(7). https://doi.org/10.7275/jyj1-4868
Crawford, A. V., Green, S. B., Levy, R., Lo, W.-J., Scott, L., Svetina, D., & Thompson, M. S. (2010). Evaluation of parallel analysis methods for determining the number of factors. Educational and Psychological Measurement, 70(6), 885–901. https://doi.org/10.1177/0013164410379332
Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989X.4.3.272
Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/discovering-statistics-using-ibm-spss-statistics-6-285130
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003097