
THỐNG KÊ MÔ TẢ VÀ CÁCH ĐỌC KẾT QUẢ TRONG SPSS/PSPP
Bảng tần số mô tả mẫu, trung bình, độ lệch chuẩn, độ lệch và độ nhọn, cách trình bày theo chuẩn luận văn
Bài nên đọc trước
Thống kê mô tả là phần đầu tiên của chương kết quả trong mọi luận văn định lượng và cũng là phần dễ bị viết qua loa nhất. Một bảng tần số giới tính, một bảng trung bình các câu hỏi, vài dòng "phần lớn đáp viên đồng ý" là xong. Thật ra phần này có hai nhiệm vụ quan trọng: cho người đọc biết mẫu nghiên cứu là ai và cho biết dữ liệu trông như thế nào trước khi đưa vào các kiểm định phức tạp hơn.
Bài viết này hướng dẫn chạy và đọc thống kê mô tả trong PSPP trên bộ dữ liệu đã làm sạch (du_lieu_sach.sav, 267 phiếu). Mọi bảng và biểu đồ trong bài là kết quả thật do PSPP 2.0 (Free Software Foundation, 2023) xuất ra từ file cú pháp thong_ke_mo_ta.sps đi kèm. Lệnh và menu trong SPSS giống hệt.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
09-thong-ke-mo-ta-spsscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Chọn thống kê phù hợp với cấp độ đo lường
Không phải thống kê nào cũng dùng được cho mọi biến. Hình 1 cho biết nên chọn thống kê nào theo cấp độ đo lường của biến.
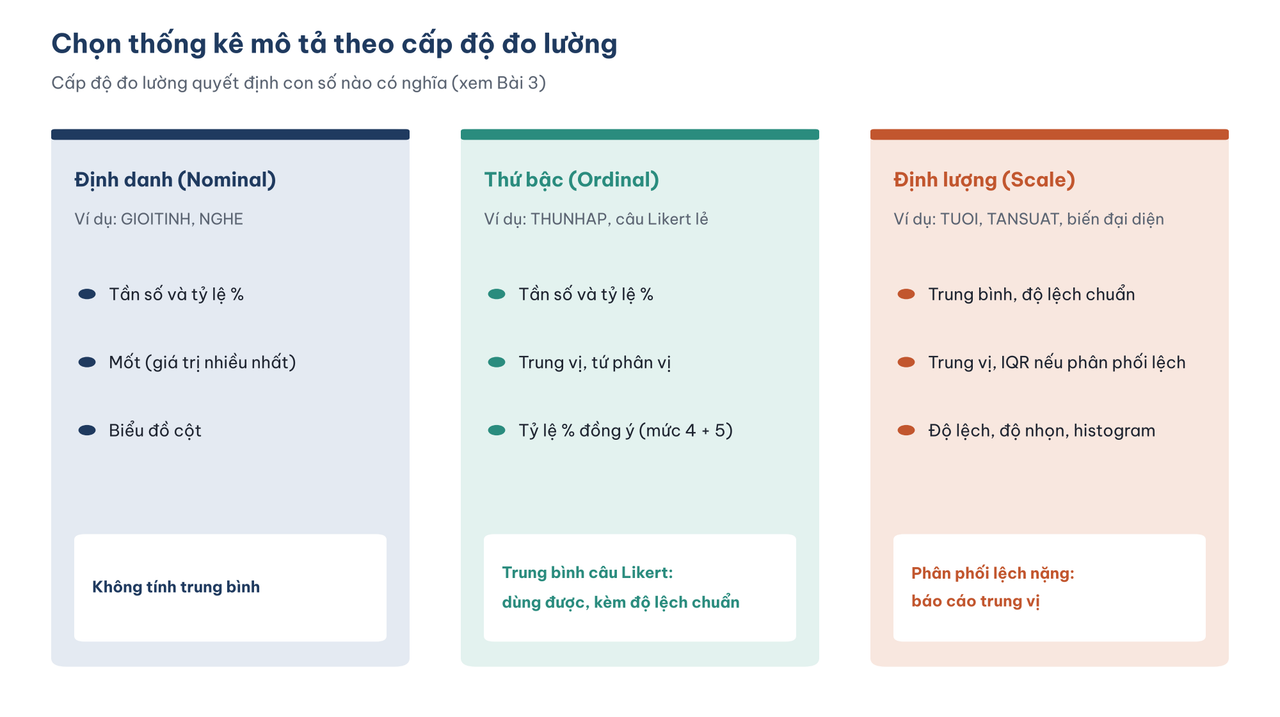
Hình 1. Cấp độ đo lường của biến quyết định thống kê nào có ý nghĩa.
Nguyên tắc đã nêu trong bài các loại thang đo áp dụng trực tiếp ở đây:
- Biến định danh (giới tính, nghề nghiệp) chỉ có tần số, tỷ lệ phần trăm và mốt. "Giới tính trung bình 1,55" là con số vô nghĩa.
- Biến thứ bậc (nhóm thu nhập) có thêm trung vị và tứ phân vị, vì các mức có thứ tự nhưng khoảng cách giữa chúng không bằng nhau.
- Biến định lượng (tuổi, số lần mua) dùng được trung bình và độ lệch chuẩn. Nếu phân phối lệch nặng, trung vị và khoảng tứ phân vị (IQR) mô tả chính xác hơn.
Câu Likert nằm ở vùng tranh luận. Jamieson (2004) cho rằng câu Likert là thang thứ bậc nên chỉ nên báo cáo trung vị và tần số. Ngược lại, Norman (2010) và Carifio và Perla (2007) chỉ ra rằng các phép tính dựa trên trung bình vẫn cho kết quả đáng tin cậy với dữ liệu Likert, đặc biệt khi gộp nhiều câu thành một thang đo. Thực tế trong nghiên cứu kinh doanh là báo cáo trung bình và độ lệch chuẩn của từng câu, kèm phân bố tần số để người đọc thấy rõ hình dạng câu trả lời. Bài này làm theo cách đó.
2. Mô tả đặc điểm mẫu bằng bảng tần số
Các biến định danh như giới tính, nghề nghiệp được mô tả bằng tần số và tỷ lệ phần trăm.
Chạy lệnh FREQUENCIES
Trên giao diện, chọn Analyze > Descriptive Statistics > Frequencies, đưa các biến nhân khẩu học vào ô Variable(s). Bấm Charts để chọn biểu đồ cột. Cú pháp tương ứng:
FREQUENCIES GIOITINH NGHE THUNHAP /STATISTICS=NONE /BARCHART.
/STATISTICS=NONE bỏ bảng thống kê (trung bình, độ lệch chuẩn) vốn không có ý nghĩa với biến định danh (Hình 2).
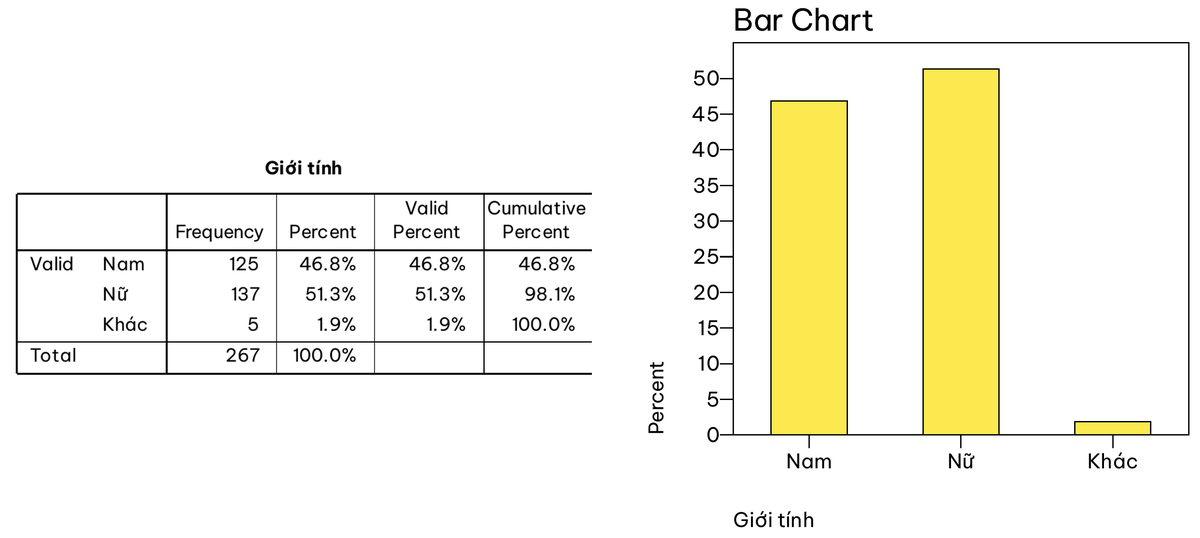
Hình 2. Bảng tần số và biểu đồ cột của biến GIOITINH do PSPP xuất ra.
Đọc bảng tần số
Bảng tần số có bốn cột số (Bảng 1):
Bảng 1. Ý nghĩa các cột trong bảng tần số.
| Cột | Ý nghĩa | Ví dụ: Nữ |
|---|---|---|
| Frequency | Số phiếu chọn mức này | 137 |
| Percent | Tỷ lệ trên tổng số phiếu, kể cả phiếu bỏ trống | 51,3% |
| Valid Percent | Tỷ lệ trên số phiếu có trả lời câu này | 51,3% |
| Cumulative Percent | Tỷ lệ cộng dồn từ mức đầu tiên đến mức này | 98,1% |
Khi biến không có giá trị thiếu, Percent và Valid Percent bằng nhau. Khi có giá trị thiếu, hãy báo cáo Valid Percent, vì nó là tỷ lệ trên những người thực sự trả lời câu hỏi. Cột Cumulative Percent chỉ có ý nghĩa với biến có thứ tự như thu nhập: "61,0% đáp viên có thu nhập dưới 20 triệu đồng/tháng".
Trình bày bảng đặc điểm mẫu
Trong luận văn, các bảng tần số được gộp thành một bảng đặc điểm mẫu (Bảng 2):
Bảng 2. Đặc điểm mẫu nghiên cứu.
| Đặc điểm | Nhóm | Số lượng | Tỷ lệ (%) |
|---|---|---|---|
| Giới tính | Nam | 125 | 46,8 |
| Nữ | 137 | 51,3 | |
| Khác | 5 | 1,9 | |
| Nghề nghiệp | Sinh viên | 83 | 31,1 |
| Nhân viên văn phòng | 112 | 41,9 | |
| Kinh doanh tự do | 45 | 16,9 | |
| Khác | 27 | 10,1 | |
| Thu nhập hằng tháng | Dưới 10 triệu | 73 | 27,3 |
| Từ 10 đến dưới 20 triệu | 90 | 33,7 | |
| Từ 20 đến dưới 30 triệu | 78 | 29,2 | |
| Từ 30 triệu trở lên | 26 | 9,7 | |
| Tuổi | Trung bình (độ lệch chuẩn) | 31,45 (10,19) | Từ 18 đến 60 tuổi, n = 266 |
Ghi chú: N = 267. Một phiếu thiếu thông tin tuổi do giá trị nhập sai đã được chuyển thành giá trị thiếu ở bước làm sạch dữ liệu.
Phần bình luận nên làm hai việc. Thứ nhất, nêu những điểm nổi bật: mẫu khá cân bằng về giới tính, nhân viên văn phòng chiếm tỷ lệ lớn nhất (41,9%). Thứ hai, đánh giá tính đại diện nếu có số liệu tổng thể để so sánh, ví dụ cơ cấu khách hàng của sàn X. Cũng nên lưu ý những nhóm quá nhỏ: nhóm giới tính "Khác" chỉ có 5 người, nên không thể so sánh nhóm này với nam và nữ ở các phân tích sau.
3. Mô tả biến định lượng: tuổi và số lần mua
Tuổi và số lần mua là biến định lượng, nên được mô tả bằng trung bình, trung vị và độ lệch chuẩn thay vì bảng tần số.
Chạy thống kê cho biến định lượng
Với biến định lượng, lệnh FREQUENCIES cho nhiều thống kê hơn DESCRIPTIVES, gồm cả trung vị và phân vị. Tùy chọn /FORMAT=NOTABLE bỏ bảng tần số dài (TUOI có hơn 40 giá trị khác nhau):
FREQUENCIES TUOI TANSUAT /FORMAT=NOTABLE
  /STATISTICS=MEAN MEDIAN STDDEV MINIMUM MAXIMUM SKEWNESS SESKEW KURTOSIS SEKURT
  /PERCENTILES=25 75 /HISTOGRAM=NORMAL.
Trên giao diện, các thống kê này nằm trong nút Statistics của hộp thoại Frequencies (Hình 3).
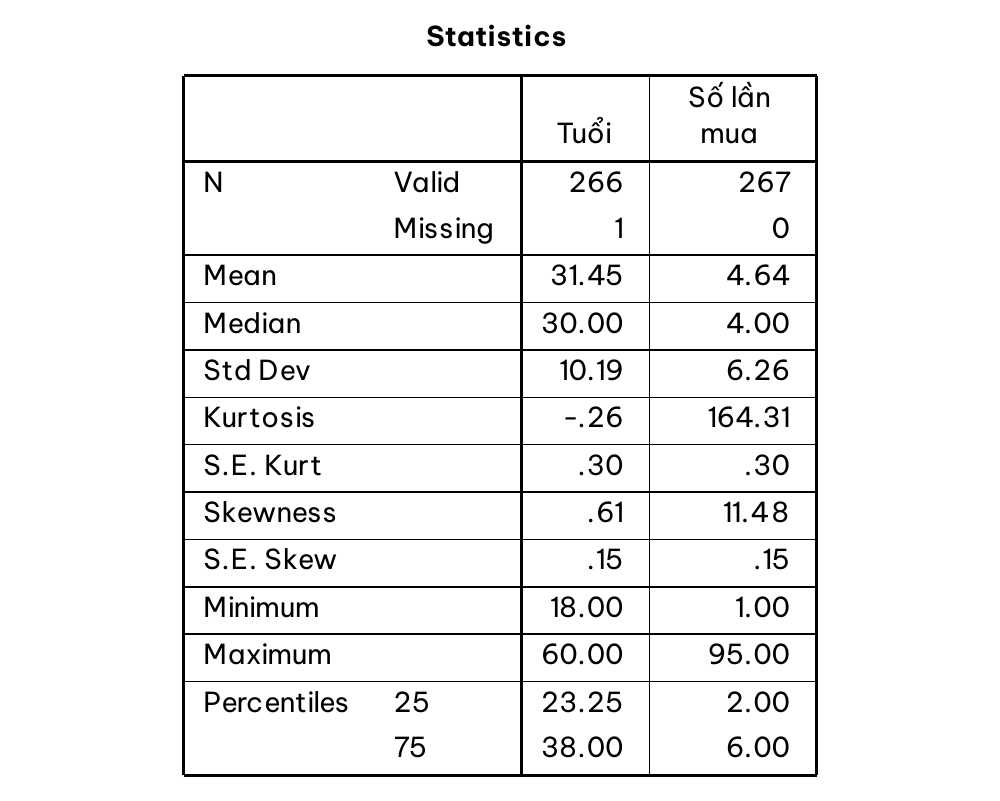
Hình 3. Trung bình, trung vị, độ lệch chuẩn, độ nhọn (Kurtosis), độ lệch (Skewness) và tứ phân vị của TUOI và TANSUAT.
Đọc kết quả: trung bình hay trung vị?
Tuổi có trung bình 31,45 và trung vị 30. Hai con số gần nhau, cho thấy phân phối tương đối cân đối. Độ lệch chuẩn 10,19 tuổi nghĩa là khoảng hai phần ba đáp viên ở độ tuổi từ 21 đến 42 (trung bình cộng trừ một độ lệch chuẩn). Một nửa số đáp viên ở độ tuổi từ 23 đến 38 (tứ phân vị thứ nhất và thứ ba).
Số lần mua kể một câu chuyện khác. Trung bình 4,64 lần nhưng độ lệch chuẩn tới 6,26, lớn hơn cả trung bình. Đây là dấu hiệu phân phối bị kéo lệch bởi giá trị cực đoan, cụ thể là phiếu 99 với 95 lần mua mà bước làm sạch dữ liệu đã quyết định giữ lại. So sánh khi có và không có phiếu này (Bảng 3):
Bảng 3. Thống kê số lần mua khi có và không có phiếu 99.
| Thống kê | 267 phiếu | Bỏ phiếu 99 (266 phiếu) |
|---|---|---|
| Trung bình | 4,64 | 4,30 |
| Trung vị | 4,00 | 4,00 |
| Độ lệch chuẩn | 6,26 | 2,89 |
| Độ lệch (Skewness) | 11,48 | 1,14 |
| Độ nhọn (Kurtosis) | 164,31 | 1,19 |
Một phiếu duy nhất làm độ lệch chuẩn tăng hơn gấp đôi, nhưng trung vị không đổi. Vì vậy với TANSUAT, hãy báo cáo trung vị và khoảng tứ phân vị: "Số lần mua trên sàn X trong 6 tháng qua có trung vị là 4 lần (IQR = 2–6)". Hai biểu đồ histogram cho thấy rõ sự khác biệt về hình dạng (Hình 4):
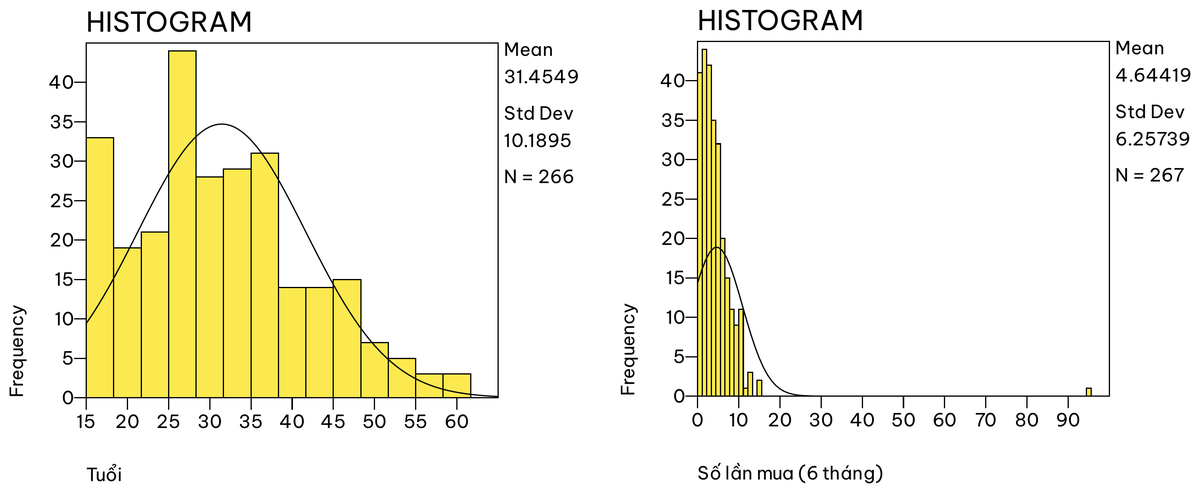
Hình 4. Tuổi có phân phối lệch phải nhẹ; số lần mua dồn về phía trái với một điểm đơn độc ở mức 95. Đường cong là phân phối chuẩn có cùng trung bình và độ lệch chuẩn.
Lưu ý nhỏ: PSPP tính phân vị theo cách nội suy, nên tứ phân vị thứ nhất của tuổi là 23,25 chứ không phải một số nguyên. Các phần mềm khác nhau có thể cho phân vị hơi khác nhau; đó không phải là lỗi.
4. Độ lệch và độ nhọn: đánh giá hình dạng phân phối
Độ lệch (skewness) đo mức độ mất cân đối của phân phối. Giá trị bằng 0 là cân đối, giá trị dương là lệch phải (đuôi kéo dài về phía giá trị lớn), giá trị âm là lệch trái. Độ nhọn (kurtosis) đo độ "nặng" của hai đuôi so với phân phối chuẩn. PSPP và SPSS báo cáo độ nhọn vượt mức (excess kurtosis), nên phân phối chuẩn có độ nhọn bằng 0.
Có hai cách dùng hai chỉ số này:
- Kiểm định ý nghĩa: chia độ lệch cho sai số chuẩn của nó (S.E. Skew) để được điểm z. Với cỡ mẫu từ 50 đến 300, Kim (2013) đề xuất coi phân phối là không chuẩn khi |z| > 3,29. Cách này rất nhạy với cỡ mẫu: khi mẫu lớn, sai số chuẩn nhỏ (0,15 với 267 phiếu) nên độ lệch rất nhỏ cũng có ý nghĩa thống kê. Kim (2013) khuyên với mẫu trên 300 nên dùng trực tiếp giá trị tuyệt đối thay cho điểm z.
- So với ngưỡng tuyệt đối: điều quan trọng là phân phối lệch nhiều đến mức nào, không phải có lệch hay không. West và cộng sự (1995) và Curran và cộng sự (1996) cho thấy các phương pháp ước lượng trong mô hình cấu trúc bắt đầu bị ảnh hưởng đáng kể khi |độ lệch| > 2 hoặc |độ nhọn| > 7. Với mô hình cấu trúc, Bentler (2005) còn khuyến nghị xem hệ số Mardia chuẩn hóa cho độ nhọn đa biến; giá trị lớn hơn 5 cho thấy dữ liệu không chuẩn đa biến. Hair và cộng sự (2022) dùng ngưỡng chặt hơn là ±1 để nhận diện phân phối lệch đáng kể.
Áp dụng cho dữ liệu mẫu (Bảng 4):
Bảng 4. Độ lệch và độ nhọn của các biến trong dữ liệu mẫu.
| Biến | Độ lệch | Độ nhọn | Đánh giá |
|---|---|---|---|
| TUOI | 0,61 | −0,26 | Lệch phải nhẹ, gần chuẩn |
| TANSUAT | 11,48 | 164,31 | Lệch rất nặng do một giá trị cực đoan |
| 20 câu Likert | −0,99 đến −0,58 (riêng NT4: 0,48) | −0,55 đến 1,07 | Lệch trái nhẹ đến vừa, trong ngưỡng ±2 và ±7 |
Các câu Likert đều lệch trái vì phần lớn đáp viên chọn "Đồng ý" và "Hoàn toàn đồng ý". Điều này rất phổ biến với khảo sát về khách hàng hiện tại, những người vốn đã chọn tiếp tục dùng dịch vụ. Nếu tính điểm z (ví dụ XN1: −0,85 / 0,15 ≈ −5,7), hầu hết các câu sẽ bị coi là "không chuẩn", nhưng mức độ lệch vẫn nằm trong ngưỡng ±2 và ±7. Theo ngưỡng chặt ±1 của Hair và cộng sự (2022), chỉ HI3 có độ nhọn (1,07) vượt nhẹ. Vấn đề phân phối chuẩn sẽ được bàn kỹ hơn trong bài về kiểm định phân phối chuẩn.
5. Mô tả các câu hỏi Likert
Câu Likert chiếm phần lớn bảng mô tả trong luận văn. Ba cách trình bày dưới đây bổ sung cho nhau: bảng trung bình, bảng tần số và biểu đồ.
Bảng trung bình và độ lệch chuẩn
DESCRIPTIVES XN1 TO HL2 HL3 TO YD4
  /STATISTICS=MEAN STDDEV MIN MAX SKEWNESS KURTOSIS.
Danh sách biến bỏ qua câu kiểm tra chú ý AC1, vốn không phải là một câu đo lường (Hình 5).
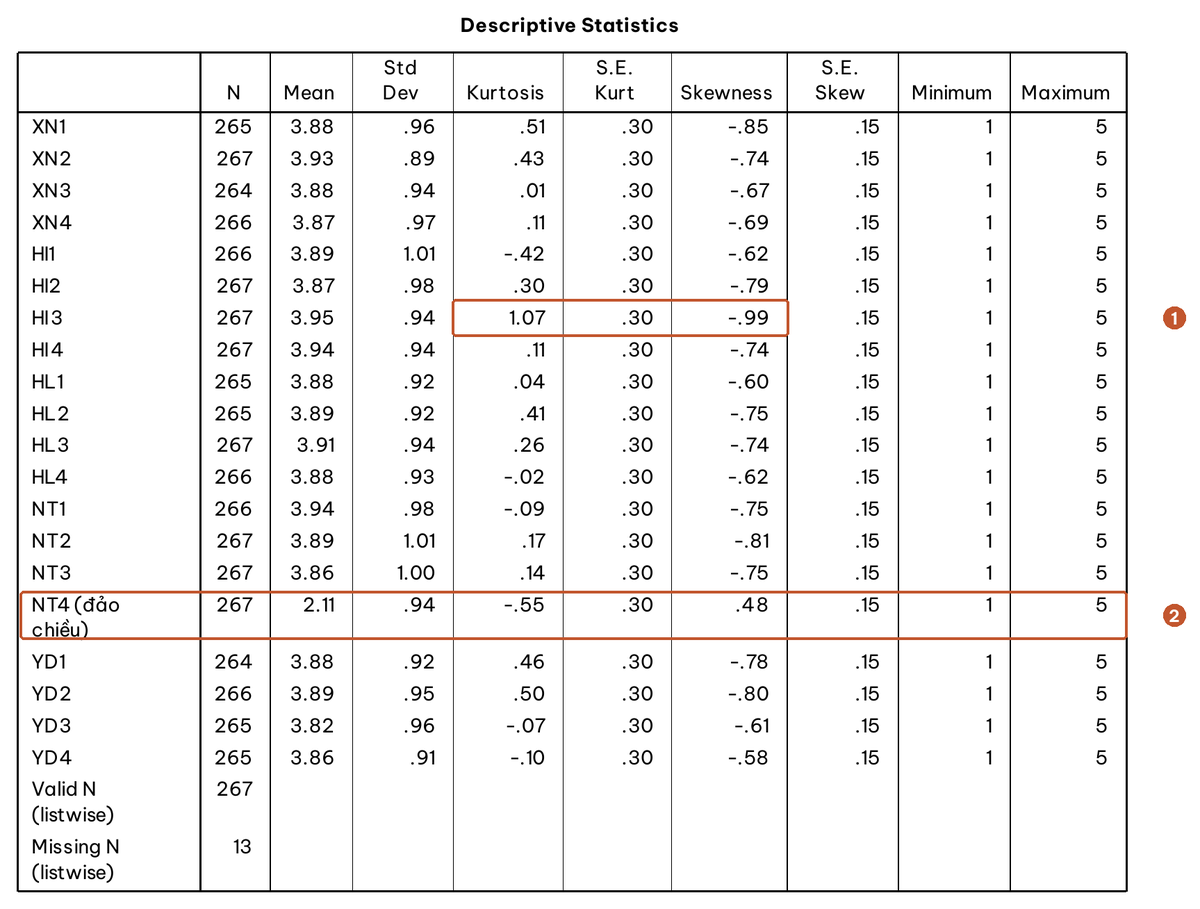
Hình 5. Trung bình các câu dao động từ 3,82 đến 3,95. HI3 có độ nhọn lớn nhất (1,07) và lệch trái nhiều nhất (−0,99) (1). NT4 có trung bình chỉ 2,11 vì là câu đảo chiều chưa được mã hóa lại (2).
Ba điểm cần đọc trong bảng này:
- Trung bình các câu rất gần nhau, từ 3,82 (YD3) đến 3,95 (HI3). Đáp viên nhìn chung đồng ý với các phát biểu tích cực về sàn X.
- Độ lệch chuẩn từ 0,89 đến 1,01. Câu trả lời phân tán khoảng một mức quanh giá trị trung bình. Nếu một câu có độ lệch chuẩn rất nhỏ (dưới 0,5), hầu như mọi người trả lời giống nhau và câu đó khó phân biệt được các đáp viên.
- NT4 khác hẳn các câu còn lại với trung bình 2,11 và độ lệch dương. Đây không phải dấu hiệu khách hàng thiếu niềm tin, mà vì NT4 hỏi theo chiều ngược ("Tôi lo ngại sàn X không giữ đúng cam kết"). Phải mã hóa lại câu này trước khi gộp vào thang đo Niềm tin. Bài mã hóa lại và tính biến đại diện hướng dẫn cách làm.
Bảng tần số của từng câu
Trung bình 3,88 của câu HL1 không cho biết bao nhiêu người thực sự hài lòng. Bảng tần số trả lời câu hỏi đó:
FREQUENCIES HL1 HL2 HL3 HL4 /STATISTICS=MEDIAN MODE.
Hình 6 là bảng tần số của câu HL1.
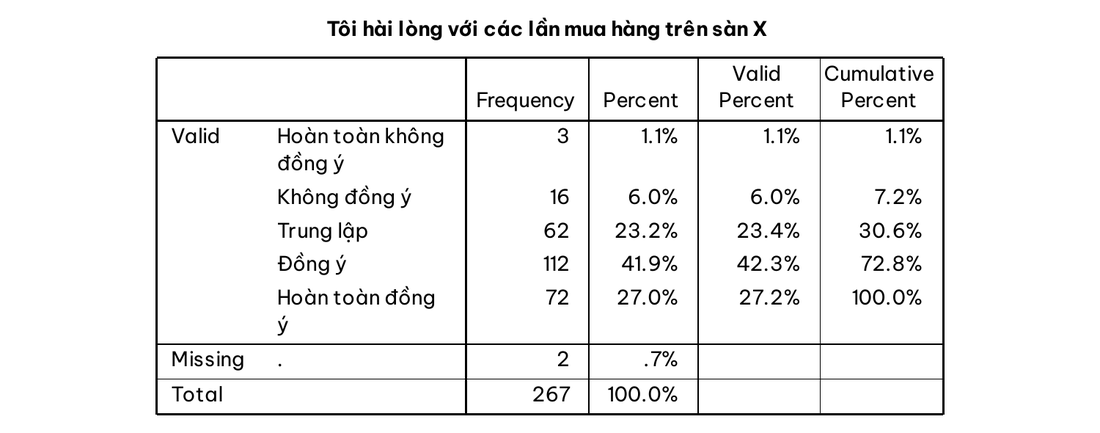
Hình 6. 42,3% đáp viên chọn "Đồng ý" và 27,2% chọn "Hoàn toàn đồng ý" ở câu HL1 (Valid Percent).
Gộp hai mức cao nhất, 69,4% đáp viên hài lòng với các lần mua hàng trên sàn X, 23,4% trung lập và 7,2% không hài lòng. Cách báo cáo tỷ lệ đồng ý này (thường gọi là top-2-box) dễ hiểu với người đọc không chuyên và dễ so sánh giữa các lần khảo sát. Trung vị và mốt của cả bốn câu HL đều là 4 ("Đồng ý").
Biểu đồ phân bố câu trả lời
Với nhiều câu Likert, biểu đồ thanh xếp chồng phân kỳ (diverging stacked bar) cho cái nhìn tổng quát nhanh hơn bảng số. Các mức không đồng ý nằm bên trái trục 0, các mức đồng ý nằm bên phải, mức trung lập được chia đôi qua trục (Hình 7):
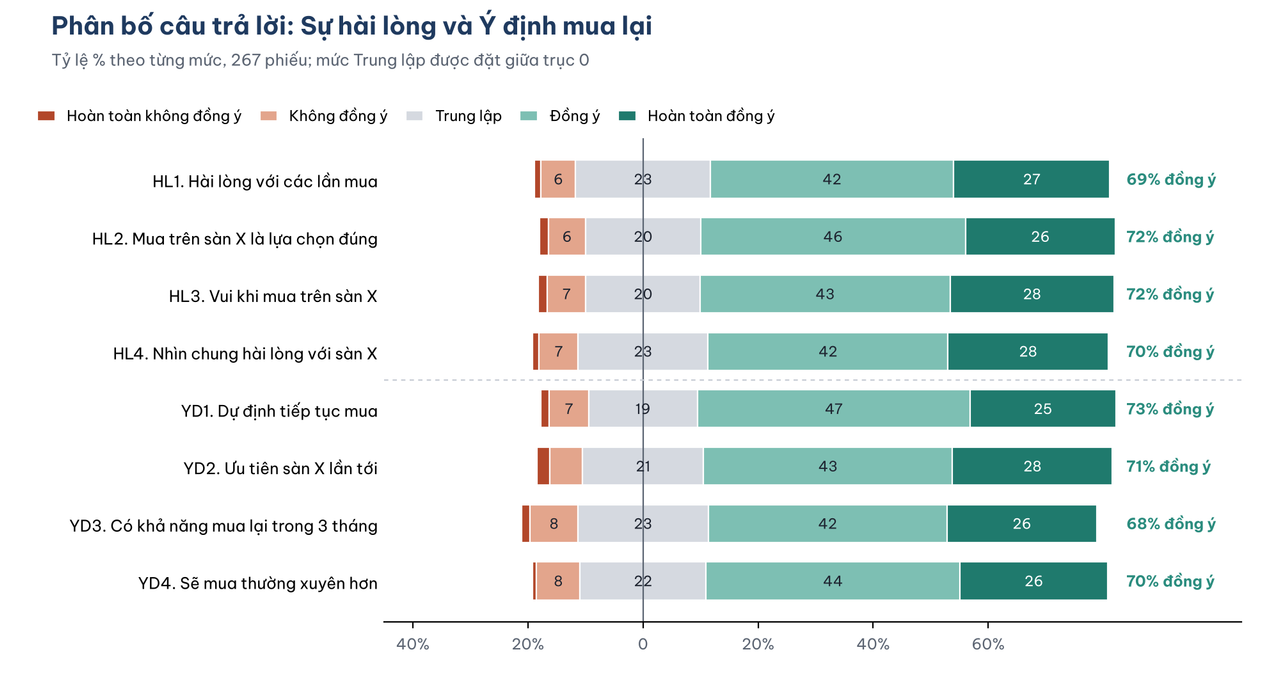
Hình 7. Tỷ lệ đồng ý của 8 câu dao động từ 68% (YD3) đến 73% (YD1). Biểu đồ vẽ bằng Python từ dữ liệu sạch (script tao_hinh.py đi kèm).
Biểu đồ cho thấy hai thang đo có hình dạng câu trả lời gần như giống nhau. Câu YD3 "Tôi có khả năng mua lại trên sàn X trong 3 tháng tới" có tỷ lệ đồng ý thấp nhất (67,5%) và tỷ lệ không đồng ý cao nhất (9,8%). Đây là câu hỏi về một hành vi cụ thể trong khung thời gian cụ thể, nên đáp viên thận trọng hơn khi cam kết.
Có nên quy đổi trung bình thành mức "cao, trung bình, thấp"?
Nhiều luận văn ở Việt Nam chia thang 1–5 thành năm khoảng đều nhau, mỗi khoảng rộng (5 − 1) / 5 = 0,8: từ 1,00 đến 1,80 là "rất thấp", ..., từ 4,21 đến 5,00 là "rất cao". Theo cách này, trung bình 3,88 rơi vào mức "cao". Cách quy đổi này tiện nhưng có hai hạn chế. Thứ nhất, ranh giới là quy ước, không có cơ sở thống kê: 3,40 là "trung bình" còn 3,41 là "cao". Thứ hai, nó che mất phân bố: hai câu cùng trung bình 3,5 có thể một câu phần lớn chọn 3 và 4, câu kia chia đôi giữa 1 và 5. Nếu dùng, hãy nêu rõ đây là quy ước và luôn kèm tỷ lệ đồng ý hoặc biểu đồ phân bố.
6. Mô tả theo nhóm
Lệnh MEANS (menu Analyze > Compare Means > Means) tính trung bình của biến định lượng cho từng nhóm:
FORMATS TUOI TANSUAT YD1 (F5.2).
MEANS TABLES=TUOI TANSUAT YD1 BY GIOITINH /CELLS=MEAN COUNT STDDEV.
Lệnh FORMATS phía trước là cần thiết. Bảng kết quả của MEANS hiển thị số theo định dạng của biến. TUOI được khai báo là F3.0 (số nguyên), nên nếu bỏ lệnh FORMATS, PSPP in trung bình tuổi là "31" và độ lệch chuẩn của YD1 là "1", làm mất thông tin (Hình 8).
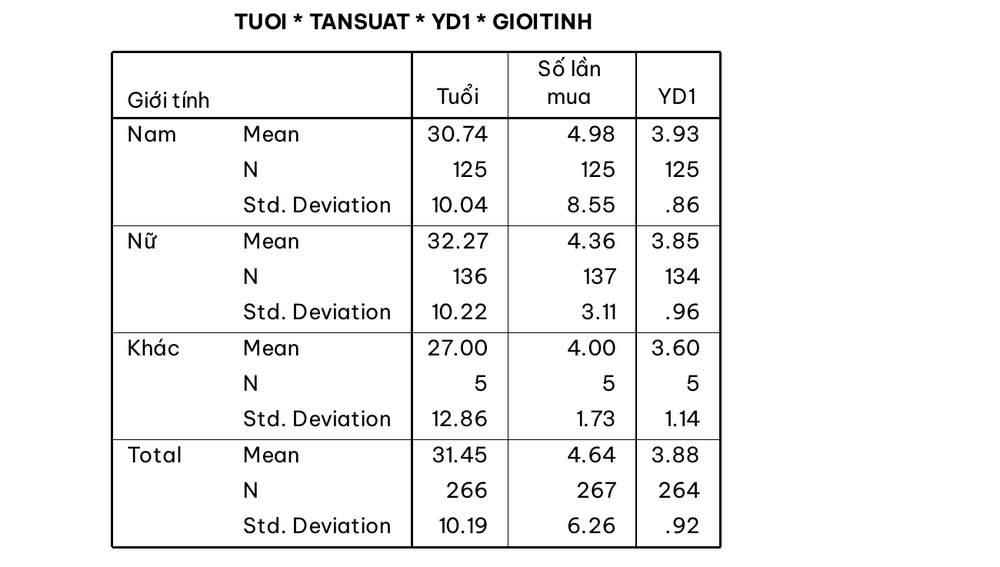
Hình 8. Trung bình, số phiếu và độ lệch chuẩn của tuổi, số lần mua và câu YD1 theo giới tính.
Bảng cho thấy độ lệch chuẩn số lần mua của nam (8,55) gấp gần ba lần của nữ (3,11). Lý do lại là phiếu 99: người này là nam. Bỏ phiếu 99, độ lệch chuẩn của nhóm nam chỉ còn 2,69. Đây là ví dụ cho thấy vì sao cần quay lại kết quả làm sạch dữ liệu khi đọc thống kê mô tả.
Thống kê mô tả theo nhóm chỉ mô tả sự khác biệt trong mẫu. Muốn kết luận nam và nữ có ý định mua lại khác nhau trong tổng thể, cần kiểm định Independent Samples T-test hoặc ANOVA, sẽ được hướng dẫn ở các bài sau.
7. Trình bày thống kê mô tả trong báo cáo
Một số quy ước theo chuẩn APA 7 (American Psychological Association, 2020):
- Ký hiệu trung bình là M, độ lệch chuẩn là SD, cỡ mẫu là N (toàn mẫu) hoặc n (nhóm con), viết nghiêng.
- Trung bình và độ lệch chuẩn làm tròn đến hai chữ số thập phân, tỷ lệ phần trăm làm tròn đến một chữ số.
- Không lặp lại trong văn bản mọi con số đã có trong bảng. Văn bản chỉ nêu điểm nổi bật.
- Trong văn bản tiếng Việt, dùng dấu phẩy thập phân (3,88) và giữ nhất quán trong toàn bài.
Bảng mô tả các câu đo lường thường có dạng (Bảng 5):
Bảng 5. Thống kê mô tả các câu đo lường Sự hài lòng.
| Mã | Phát biểu | M | SD | Độ lệch | Độ nhọn |
|---|---|---|---|---|---|
| HL1 | Tôi hài lòng với các lần mua hàng trên sàn X | 3,88 | 0,92 | −0,60 | 0,04 |
| HL2 | Mua hàng trên sàn X là một lựa chọn đúng đắn | 3,89 | 0,92 | −0,75 | 0,41 |
| HL3 | Tôi cảm thấy vui khi mua hàng trên sàn X | 3,91 | 0,94 | −0,74 | 0,26 |
| HL4 | Nhìn chung, tôi hài lòng với sàn X | 3,88 | 0,93 | −0,62 | −0,02 |
Đoạn văn mẫu: "Các câu đo lường Sự hài lòng có giá trị trung bình từ 3,88 đến 3,91 (SD từ 0,92 đến 0,94), cho thấy đáp viên nhìn chung hài lòng với sàn X: 69% đến 72% đáp viên chọn mức Đồng ý hoặc Hoàn toàn đồng ý. Độ lệch của 20 câu đo lường nằm trong khoảng −0,99 đến 0,48 và độ nhọn trong khoảng −0,55 đến 1,07, đều dưới ngưỡng |2| và |7| của West và cộng sự (1995)."
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp ở phần mô tả mẫu và mô tả thang đo trong luận văn.
- Tính trung bình cho biến định danh, như "giới tính trung bình 1,55" hay "nghề nghiệp trung bình 2,06".
- Báo cáo trung bình cho biến lệch nặng như TANSUAT mà không kèm trung vị, khiến người đọc tưởng đáp viên điển hình mua gần 5 lần.
- Dùng Percent thay cho Valid Percent khi có giá trị thiếu, làm tỷ lệ các nhóm cộng lại không đủ 100%.
- Diễn giải câu đảo chiều như câu thuận, ví dụ kết luận "khách hàng có niềm tin thấp" từ trung bình 2,11 của NT4.
- Quên lệnh FORMATS trước MEANS, khiến trung bình bị làm tròn thành số nguyên trong bảng kết quả.
Tài liệu tham khảo
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Bentler, P. M. (2005). EQS 6 structural equations program manual. Multivariate Software. https://mvsoft.com/
Carifio, J., & Perla, R. J. (2007). Ten common misunderstandings, misconceptions, persistent myths and urban legends about Likert scales and Likert response formats and their antidotes. Journal of Social Sciences, 3(3), 106–116. https://doi.org/10.3844/jssp.2007.106.116
Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16–29. https://doi.org/10.1037/1082-989X.1.1.16
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
Jamieson, S. (2004). Likert scales: How to (ab)use them. Medical Education, 38(12), 1217–1218. https://doi.org/10.1111/j.1365-2929.2004.02012.x
Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
Norman, G. (2010). Likert scales, levels of measurement and the "laws" of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. In R. H. Hoyle (Ed.), Structural equation modeling: Concepts, issues, and applications (pp. 56–75). SAGE Publications. https://collegepublishing.sagepub.com/products/structural-equation-modeling-1-4796