
GIÁ TRỊ HỘI TỤ VÀ GIÁ TRỊ PHÂN BIỆT TRONG CFA
Đánh giá giá trị hội tụ, kiểm tra giá trị phân biệt bằng Fornell-Larcker và HTMT trong JASP và AMOS
Bài nên đọc trước
Đây là bài cuối của chặng mô hình đo lường. Các bài từ phân tích nhân tố khẳng định (CFA) đến độ tin cậy tổng hợp và phương sai trích đã có hệ số tải, độ phù hợp, CR và AVE. Bài này gom lại để trả lời hai câu hỏi mà mọi hội đồng đều hỏi trước khi cho chạy SEM:
- Giá trị hội tụ (convergent validity): các câu hỏi của một thang đo có cùng đo một khái niệm không?
- Giá trị phân biệt (discriminant validity): các thang đo có đo những khái niệm khác nhau không, hay hai thang đo thực chất là một?
Câu hỏi thứ hai đặc biệt quan trọng với mô hình sàn X: Giá trị cảm nhận và Sự hài lòng có tương quan cao nhất (0,64) và bài chỉ số độ phù hợp của mô hình đã cho thấy một mô hình gộp hai khái niệm này vẫn đạt nhiều ngưỡng độ phù hợp.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026), mở tiếp phân tích CFA của các bài trước. Các con số được đối chiếu bằng R với lavaan (Rosseel, 2012) và semTools (Jorgensen và cộng sự, 2022), file gia_tri_phan_biet.R và bằng file Excel htmt_fornell_larcker_mau.xlsx đi kèm. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026) (Hình 1).
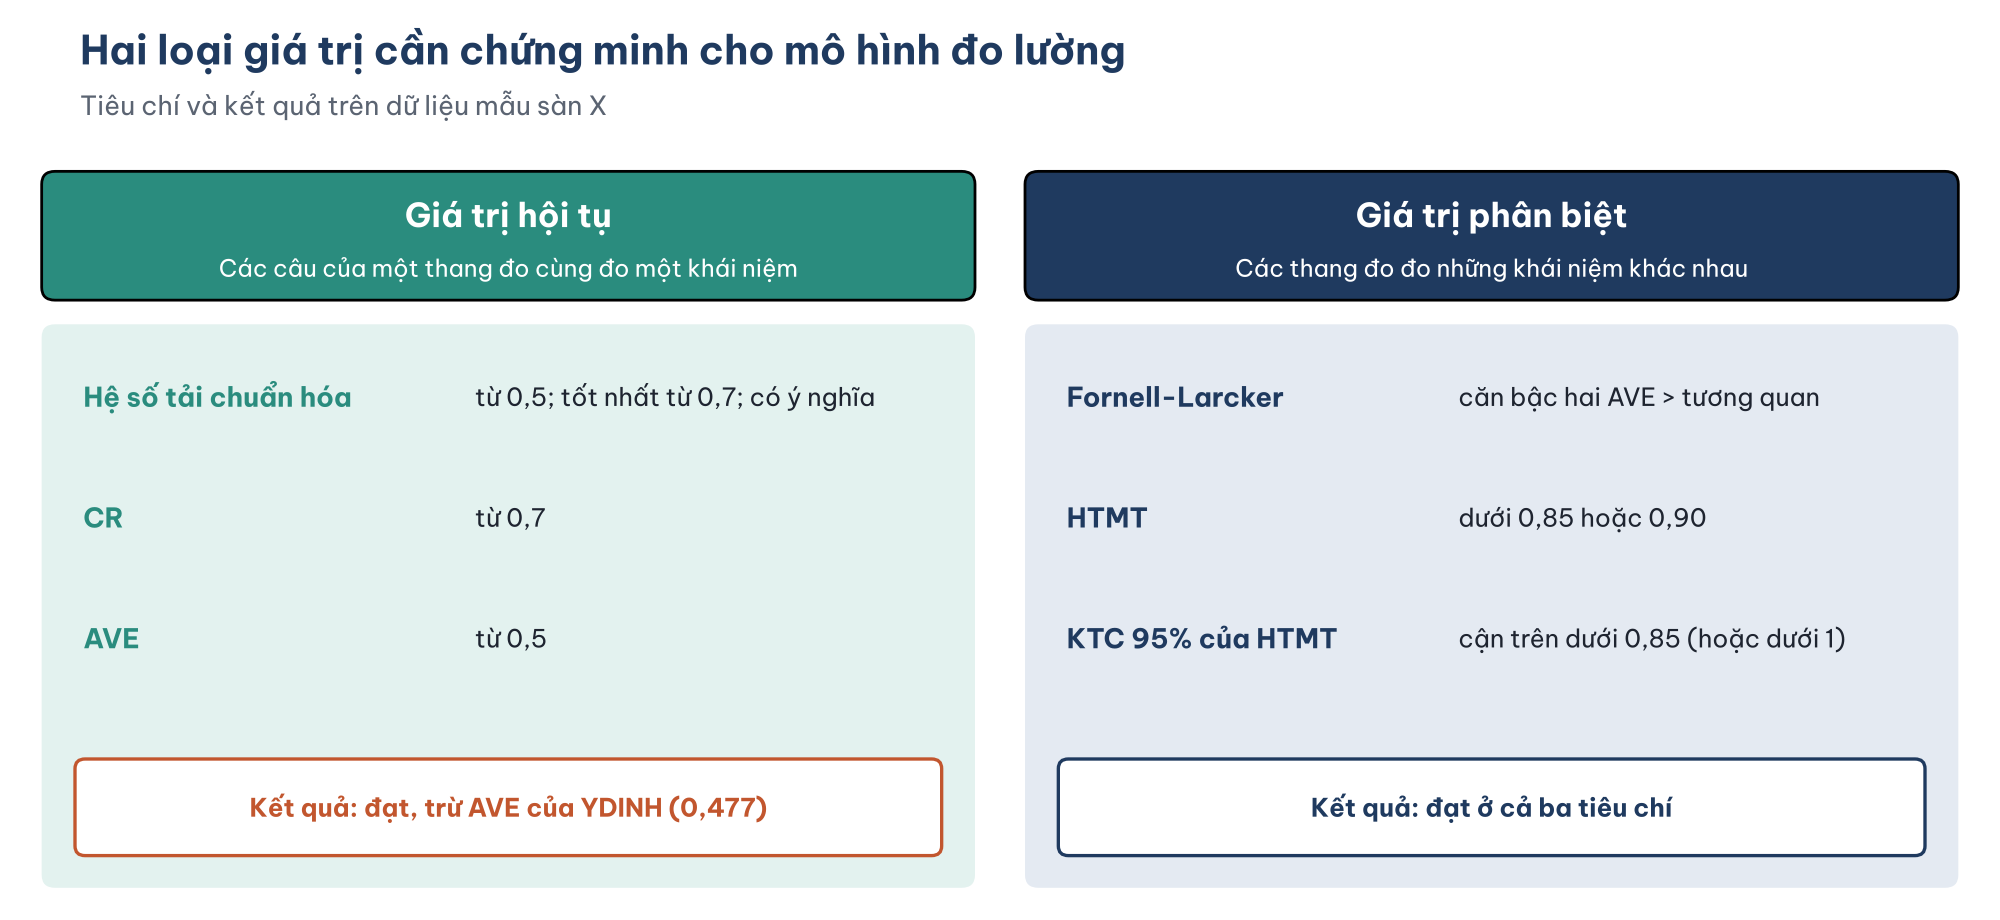
Hình 1. Tiêu chí đánh giá giá trị hội tụ và giá trị phân biệt, cùng kết quả trên dữ liệu mẫu.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
25-gia-tri-hoi-tu-gia-tri-phan-bietcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Giá trị hội tụ
Giá trị hội tụ được đánh giá bằng ba tiêu chí đã tính ở các bài trước (Hair và cộng sự, 2019) (Bảng 1):
Bảng 1. Ba tiêu chí giá trị hội tụ trên dữ liệu mẫu.
| Tiêu chí | Ngưỡng | Kết quả | Bài |
|---|---|---|---|
| Hệ số tải chuẩn hóa | từ 0,5 (tốt nhất từ 0,7), có ý nghĩa | 0,65 đến 0,85; mọi p < 0,001 | 22 |
| CR | từ 0,7 | 0,785 đến 0,844 | 24 |
| AVE | từ 0,5 | 0,538 đến 0,575; riêng YDINH 0,477 | 24 |
Kết luận: giá trị hội tụ đạt với bốn thang đo; thang Ý định mua lại đạt hệ số tải và CR nhưng AVE thấp hơn ngưỡng. Bài độ tin cậy tổng hợp và phương sai trích đã phân tích vì sao vẫn giữ thang đo này và cách báo cáo.
2. Giá trị phân biệt: tiêu chí Fornell-Larcker
Fornell và Larcker (1981) đề xuất: một nhân tố có giá trị phân biệt khi căn bậc hai AVE của nó lớn hơn tương quan của nó với mọi nhân tố khác. Ý nghĩa: nhân tố chia sẻ với các câu hỏi của chính nó nhiều phương sai hơn so với chia sẻ với bất kỳ nhân tố nào khác (Hình 2, Bảng 2).
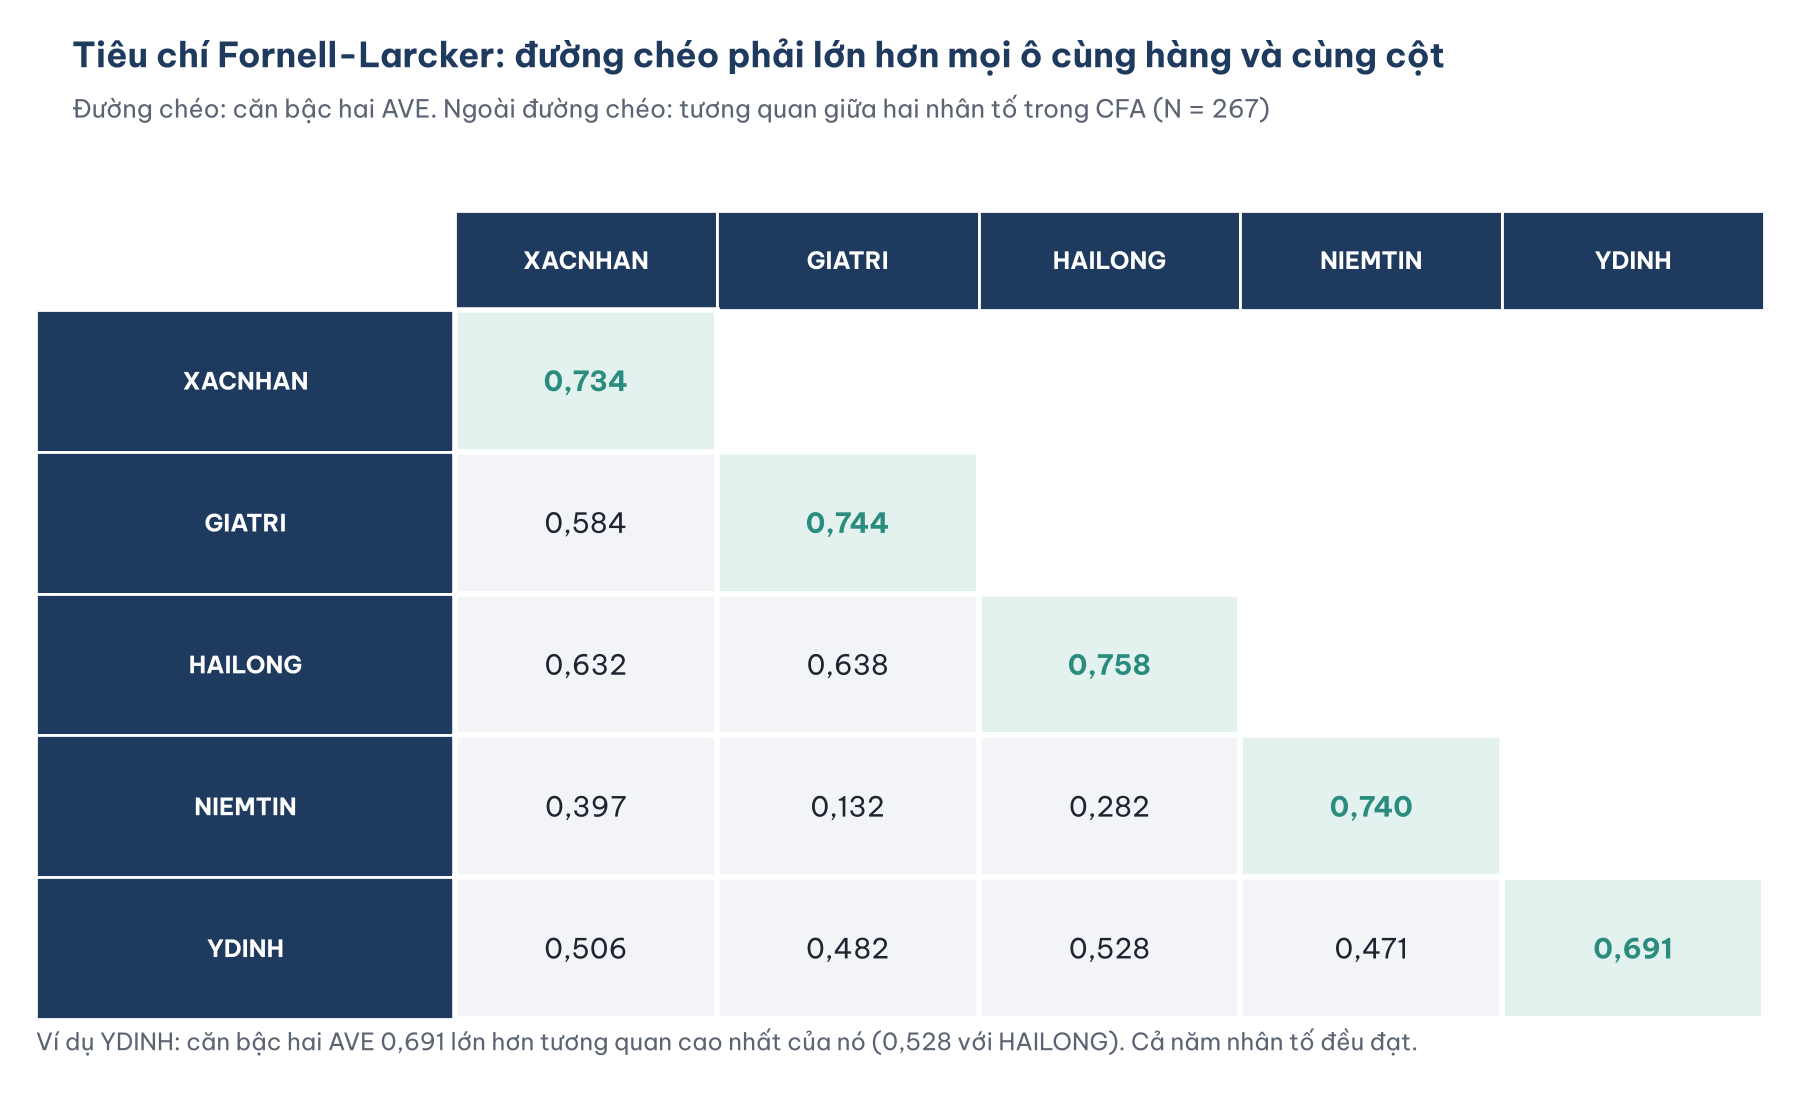
Hình 2. Ma trận Fornell-Larcker. Đường chéo (xanh) là căn bậc hai AVE; các ô còn lại là tương quan giữa hai nhân tố.
Bảng 2. Kiểm tra Fornell-Larcker cho năm nhân tố.
| Nhân tố | Căn bậc hai AVE | Tương quan cao nhất với nhân tố khác | Kết luận |
|---|---|---|---|
| XACNHAN | 0,734 | 0,632 (HAILONG) | Đạt |
| GIATRI | 0,744 | 0,638 (HAILONG) | Đạt |
| HAILONG | 0,758 | 0,638 (GIATRI) | Đạt |
| NIEMTIN | 0,740 | 0,471 (YDINH) | Đạt |
| YDINH | 0,691 | 0,528 (HAILONG) | Đạt |
Cả năm nhân tố đều đạt. Cặp gần nhau nhất là GIATRI và HAILONG: tương quan 0,638, thấp hơn căn bậc hai AVE của cả hai (0,744 và 0,758).
Tiêu chí Fornell-Larcker vẫn được yêu cầu phổ biến, nhưng mô phỏng của Henseler và cộng sự (2015) cho thấy nó thường bỏ sót vấn đề phân biệt khi hệ số tải của các câu hỏi gần nhau, như trong thang Likert. Vì vậy nên báo cáo thêm HTMT.
3. Giá trị phân biệt: HTMT
HTMT (heterotrait-monotrait ratio; Henseler và cộng sự, 2015) so sánh hai loại tương quan giữa các câu hỏi:
- Tương quan khác thang đo (heterotrait): trung bình tương quan giữa các câu của thang đo A với các câu của thang đo B.
- Tương quan cùng thang đo (monotrait): trung bình tương quan giữa các câu trong cùng thang đo.
HTMT = tương quan khác thang đo / căn bậc hai (tích hai tương quan cùng thang đo). HTMT gần 1 nghĩa là các câu của hai thang đo tương quan với nhau gần như mạnh bằng các câu trong cùng một thang đo, tức hai thang đo khó phân biệt.
Ngưỡng thường dùng: dưới 0,85 (thận trọng, cho khái niệm khác nhau rõ) hoặc dưới 0,90 (cho khái niệm gần nhau về lý thuyết, như sự hài lòng và giá trị cảm nhận) (Henseler và cộng sự, 2015). Chặt chẽ hơn, kiểm tra cận trên của khoảng tin cậy 95% bootstrap có dưới ngưỡng không (Hình 3, Bảng 3).
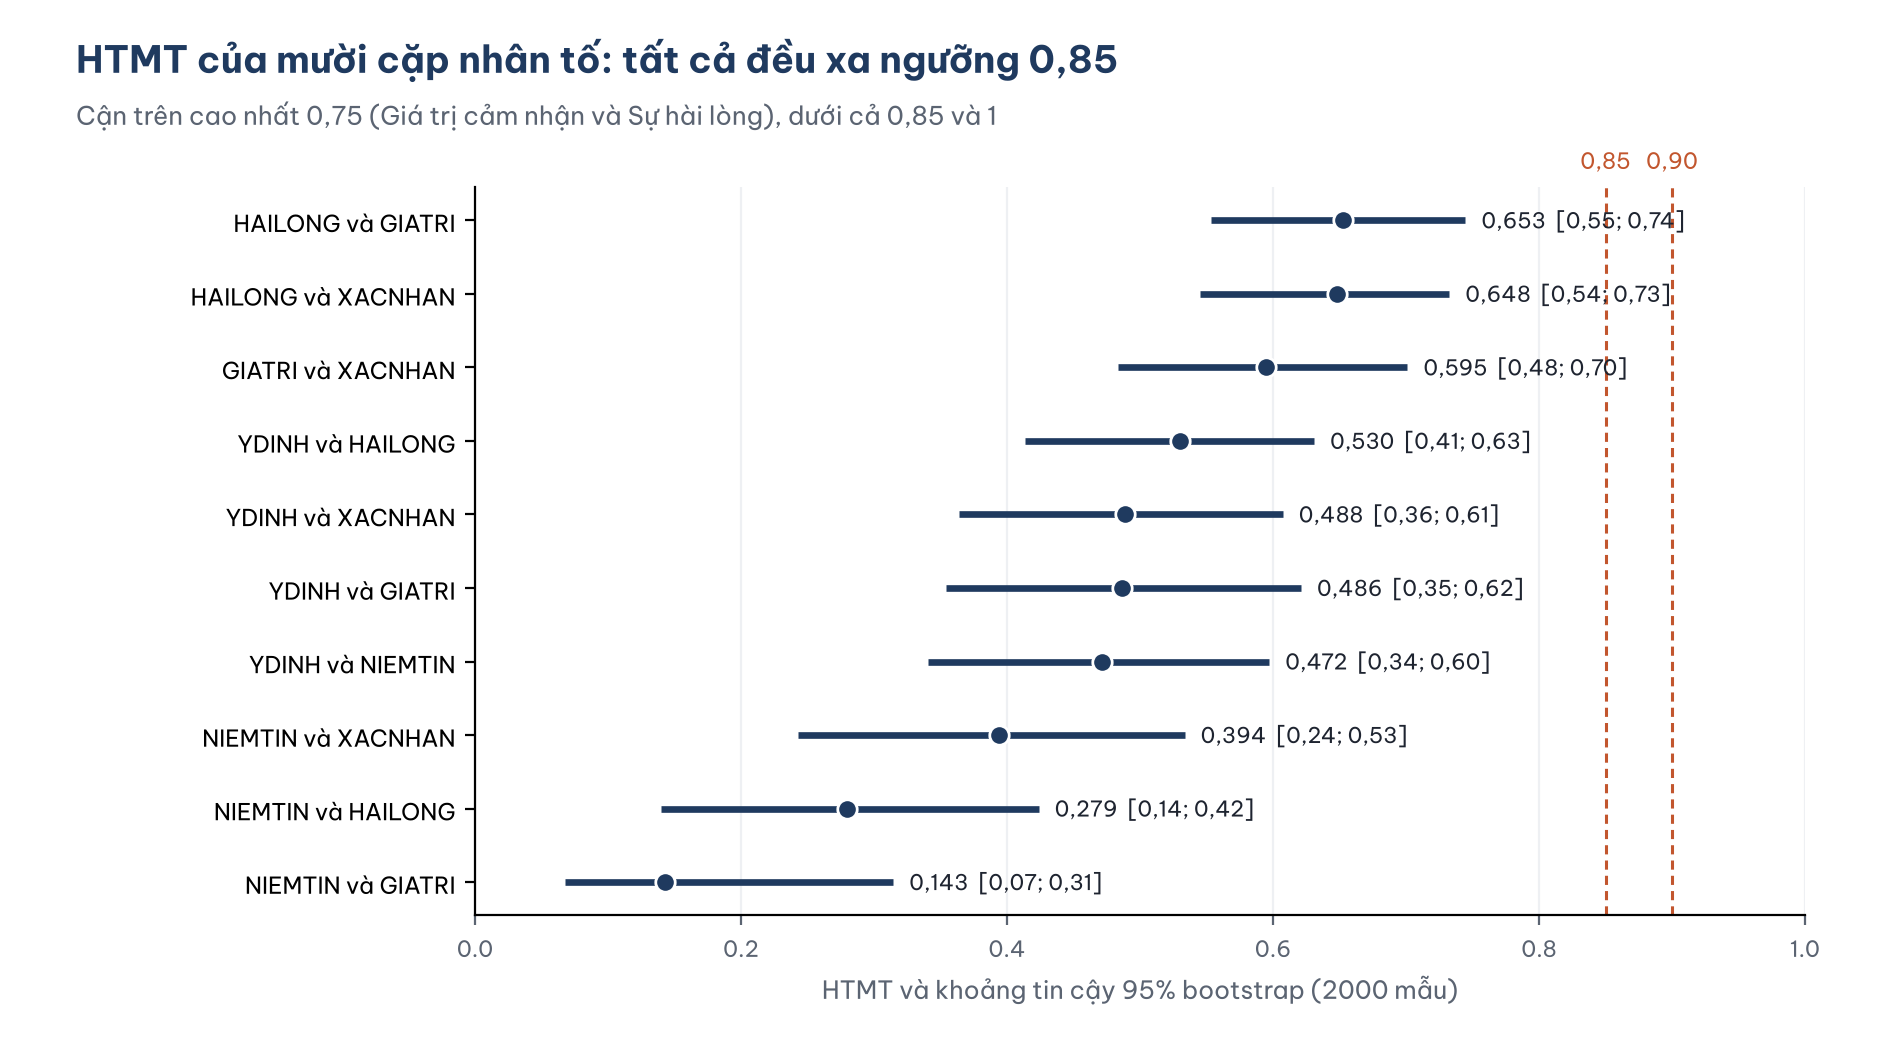
Hình 3. HTMT của mười cặp nhân tố và khoảng tin cậy 95% từ 2000 mẫu bootstrap. Đường đứt đoạn là ngưỡng 0,85 và 0,90.
Bảng 3. HTMT và khoảng tin cậy bootstrap của mười cặp nhân tố.
| Cặp nhân tố | HTMT | KTC 95% bootstrap |
|---|---|---|
| GIATRI và HAILONG | 0,653 | [0,55; 0,74] |
| XACNHAN và HAILONG | 0,648 | [0,54; 0,73] |
| XACNHAN và GIATRI | 0,595 | [0,48; 0,70] |
| HAILONG và YDINH | 0,530 | [0,41; 0,63] |
| XACNHAN và YDINH | 0,488 | [0,36; 0,61] |
| GIATRI và YDINH | 0,486 | [0,35; 0,62] |
| NIEMTIN và YDINH | 0,472 | [0,34; 0,60] |
| XACNHAN và NIEMTIN | 0,394 | [0,24; 0,53] |
| HAILONG và NIEMTIN | 0,279 | [0,14; 0,42] |
| GIATRI và NIEMTIN | 0,143 | [0,07; 0,31] |
HTMT tính trên tương quan pairwise của 20 câu hỏi (N = 267).
HTMT cao nhất là 0,653 (GIATRI và HAILONG), cận trên khoảng tin cậy 0,74, đều xa ngưỡng 0,85. Giá trị phân biệt đạt ở mọi cặp.
4. Lấy HTMT trong JASP
JASP tính sẵn HTMT trong mô-đun CFA:
- Mở phân tích CFA (file
bai-25-gia-tri-phan-biet.jaspđi kèm). - Đánh dấu Heterotrait-monotrait ratio (HTMT) trong mục Additional Output (Hình 4, Hình 5).
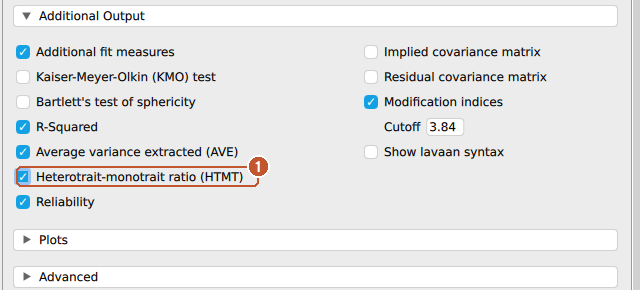
Hình 4. (1) Tùy chọn Heterotrait-monotrait ratio (HTMT).
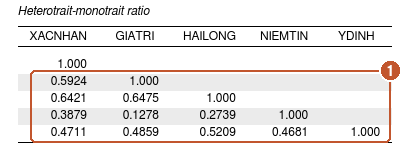
Hình 5. (1) Ma trận HTMT của năm nhân tố, phần tam giác dưới.
Bảng của JASP cho GIATRI và HAILONG là 0,648, hơi khác 0,653 ở bảng trên. JASP dùng HTMT2 (Roemer và cộng sự, 2021): lấy trung bình nhân thay cho trung bình cộng và tính trên ma trận tương quan ước lượng bằng FIML. Hai cách chênh nhau tối đa khoảng 0,02 trên dữ liệu mẫu và cho cùng kết luận. Khi báo cáo, ghi rõ đã dùng HTMT hay HTMT2.
JASP không có tiêu chí Fornell-Larcker và khoảng tin cậy bootstrap cho HTMT. Fornell-Larcker tính nhanh bằng sheet Fornell_Larcker trong file Excel đi kèm: dán AVE (bảng Average variance extracted) và tương quan giữa các nhân tố (bảng Factor Covariances với Standardization = All). Khoảng tin cậy bootstrap của HTMT dùng file gia_tri_phan_biet.R.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, cả hai tiêu chí đều được tính trong Excel từ kết quả của AMOS.
AMOS không tính hai tiêu chí này. File Excel htmt_fornell_larcker_mau.xlsx đi kèm có hai sheet tính sẵn bằng công thức (Hình 6).
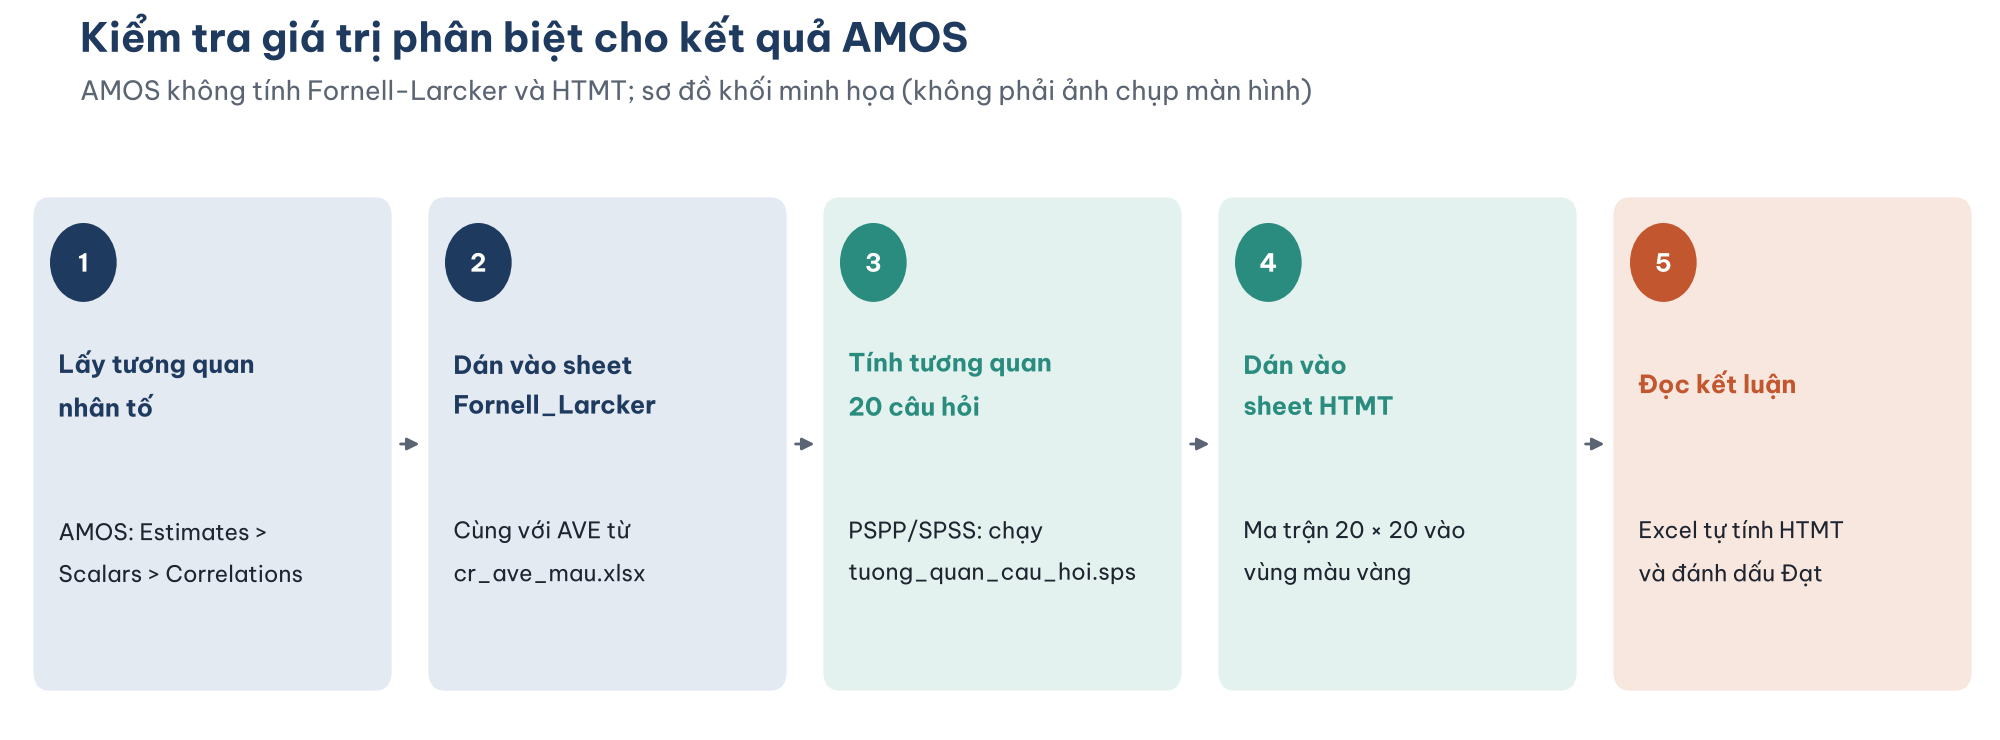
Hình 6. Năm bước lấy số liệu từ AMOS và PSPP/SPSS sang Excel.
Sheet Fornell_Larcker
- Mở View > Text Output, chọn Estimates > Scalars > Correlations. Bảng này là tương quan giữa các nhân tố (có khi chọn Standardized estimates).
- Dán AVE của năm nhân tố (từ file
cr_ave_mau.xlsxở bài độ tin cậy tổng hợp và phương sai trích) vào hàng 4 và tương quan vào phần tam giác dưới (ô màu vàng). - Đọc hàng Kết luận: Excel tự so căn bậc hai AVE với tương quan cao nhất ở cùng hàng và cùng cột.
Sheet HTMT
HTMT tính từ tương quan giữa các câu hỏi, không phải giữa các nhân tố, nên cần ma trận tương quan 20 × 20:
- Chạy file cú pháp
tuong_quan_cau_hoi.spsđi kèm trong PSPP hoặc SPSS (lệnhCORRELATIONSvới/MISSING=PAIRWISE). - Chép ma trận hệ số tương quan Pearson vào vùng màu vàng B5:U24, giữ đúng thứ tự câu hỏi XN1 đến YD4.
- Đọc ma trận HTMT bên dưới. File đã điền sẵn dữ liệu mẫu: HTMT GIATRI và HAILONG = 0,652, chênh không đáng kể so với semTools (0,653) do cách xử lý dữ liệu thiếu.
Khoảng tin cậy bootstrap của HTMT không tính được trong Excel; dùng file gia_tri_phan_biet.R hoặc SmartPLS (cụm bài SmartPLS, Bài 35).
5. Kiểm tra thêm: tương quan có khác 1 không?
Một cách kiểm tra trực tiếp là hỏi: tương quan giữa hai nhân tố có khác 1 có ý nghĩa không (Rönkkö & Cho, 2022)? Với cặp gần nhau nhất:
- Khoảng tin cậy 95% của tương quan GIATRI và HAILONG trong CFA là [0,543; 0,733], không chứa 1 và cũng không chạm 0,8.
- So sánh mô hình: cố định tương quan này bằng 1 làm chi bình phương tăng 162,68 với 1 bậc tự do (p < 0,001). Đây là cùng ý tưởng với mô hình M4 ở bài chỉ số độ phù hợp của mô hình.
Hai kết quả này cùng kết luận với Fornell-Larcker và HTMT.
6. Trình bày kết quả
Giá trị hội tụ được đánh giá qua hệ số tải chuẩn hóa (0,65 đến 0,85; p < 0,001), độ tin cậy tổng hợp (0,785 đến 0,844) và phương sai trích (0,538 đến 0,575 với bốn thang đo; 0,477 với thang Ý định mua lại). Giá trị phân biệt đạt yêu cầu: căn bậc hai AVE của mỗi nhân tố lớn hơn các tương quan của nó với nhân tố khác (Fornell & Larcker, 1981); mọi giá trị HTMT nằm trong khoảng 0,14 đến 0,65, thấp hơn ngưỡng 0,85 (Henseler và cộng sự, 2015), với cận trên khoảng tin cậy 95% bootstrap cao nhất là 0,74 (Giá trị cảm nhận và Sự hài lòng).
Nên kèm bảng gộp: đường chéo là căn bậc hai AVE, tam giác dưới là tương quan giữa các nhân tố, tam giác trên là HTMT. Một bảng như vậy trình bày đủ cả hai tiêu chí.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi đánh giá giá trị hội tụ và giá trị phân biệt.
- So AVE (thay vì căn bậc hai AVE) với tương quan, hoặc so AVE với tương quan chưa bình phương.
- Dùng tương quan giữa điểm trung bình (bài tương quan Pearson) thay cho tương quan giữa nhân tố trong CFA ở tiêu chí Fornell-Larcker.
- Tính HTMT từ tương quan giữa các nhân tố. HTMT dùng tương quan giữa các câu hỏi.
- Chỉ báo cáo Fornell-Larcker dù tiêu chí này hay bỏ sót vấn đề.
- Đưa câu đảo chiều chưa mã hóa lại vào tính HTMT: tương quan âm làm HTMT sai.
Tài liệu tham khảo
Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.2307/3151312
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2022). semTools: Useful tools for structural equation modeling (Version 0.5-6) [Computer software]. https://CRAN.R-project.org/package=semTools
Roemer, E., Schuberth, F., & Henseler, J. (2021). HTMT2: An improved criterion for assessing discriminant validity in structural equation modeling. Industrial Management & Data Systems, 121(12), 2637–2650. https://doi.org/10.1108/IMDS-02-2021-0082
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Rönkkö, M., & Cho, E. (2022). An updated guideline for assessing discriminant validity. Organizational Research Methods, 25(1), 6–14. https://doi.org/10.1177/1094428120968614