
CHỈ SỐ ĐỘ PHÙ HỢP CỦA MÔ HÌNH CFA VÀ SEM
Ý nghĩa và ngưỡng của chi bình phương, CFI, TLI, RMSEA, SRMR, cách đọc trong JASP, AMOS và so sánh mô hình
Bài nên đọc trước
Bài phân tích nhân tố khẳng định (CFA) đã chạy CFA cho năm thang đo và ghi nhận mô hình "phù hợp với dữ liệu". Bài này giải thích từ "phù hợp" đó dựa trên những chỉ số nào, mỗi chỉ số đo điều gì, ngưỡng thường dùng từ đâu ra và vì sao không nên dùng ngưỡng như một bài kiểm tra đạt hay trượt. Để thấy rõ, bài chạy ba mô hình đo lường trên cùng dữ liệu, trong đó hai mô hình cố ý sai và xem các chỉ số phân biệt chúng đến đâu.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026), mở tiếp file phân tích của bài phân tích nhân tố khẳng định (CFA). Các con số được đối chiếu bằng gói lavaan của R (Rosseel, 2012), file so_sanh_do_phu_hop.R đi kèm. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
23-chi-so-do-phu-hop-mo-hinh-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Độ phù hợp là gì?
CB-SEM tìm bộ tham số để ma trận hiệp phương sai do mô hình tái tạo gần nhất với ma trận hiệp phương sai của dữ liệu (bài AMOS và CB-SEM). Độ phù hợp đo mức gần đó. Một mô hình phù hợp tốt nghĩa là các ràng buộc của nó (câu nào không tải lên nhân tố nào, sai số nào không tương quan) không mâu thuẫn rõ với dữ liệu.
Hai điều độ phù hợp không cho biết (Kline, 2023):
- Mô hình có đúng hay không. Nhiều mô hình khác nhau có thể phù hợp như nhau với cùng dữ liệu.
- Các hệ số có lớn hay có ý nghĩa không. Một mô hình có hệ số tải rất thấp vẫn có thể phù hợp tốt nếu tương quan giữa các câu đều thấp.
2. Ba nhóm chỉ số
Các chỉ số độ phù hợp thường được chia thành ba nhóm (Hình 1).
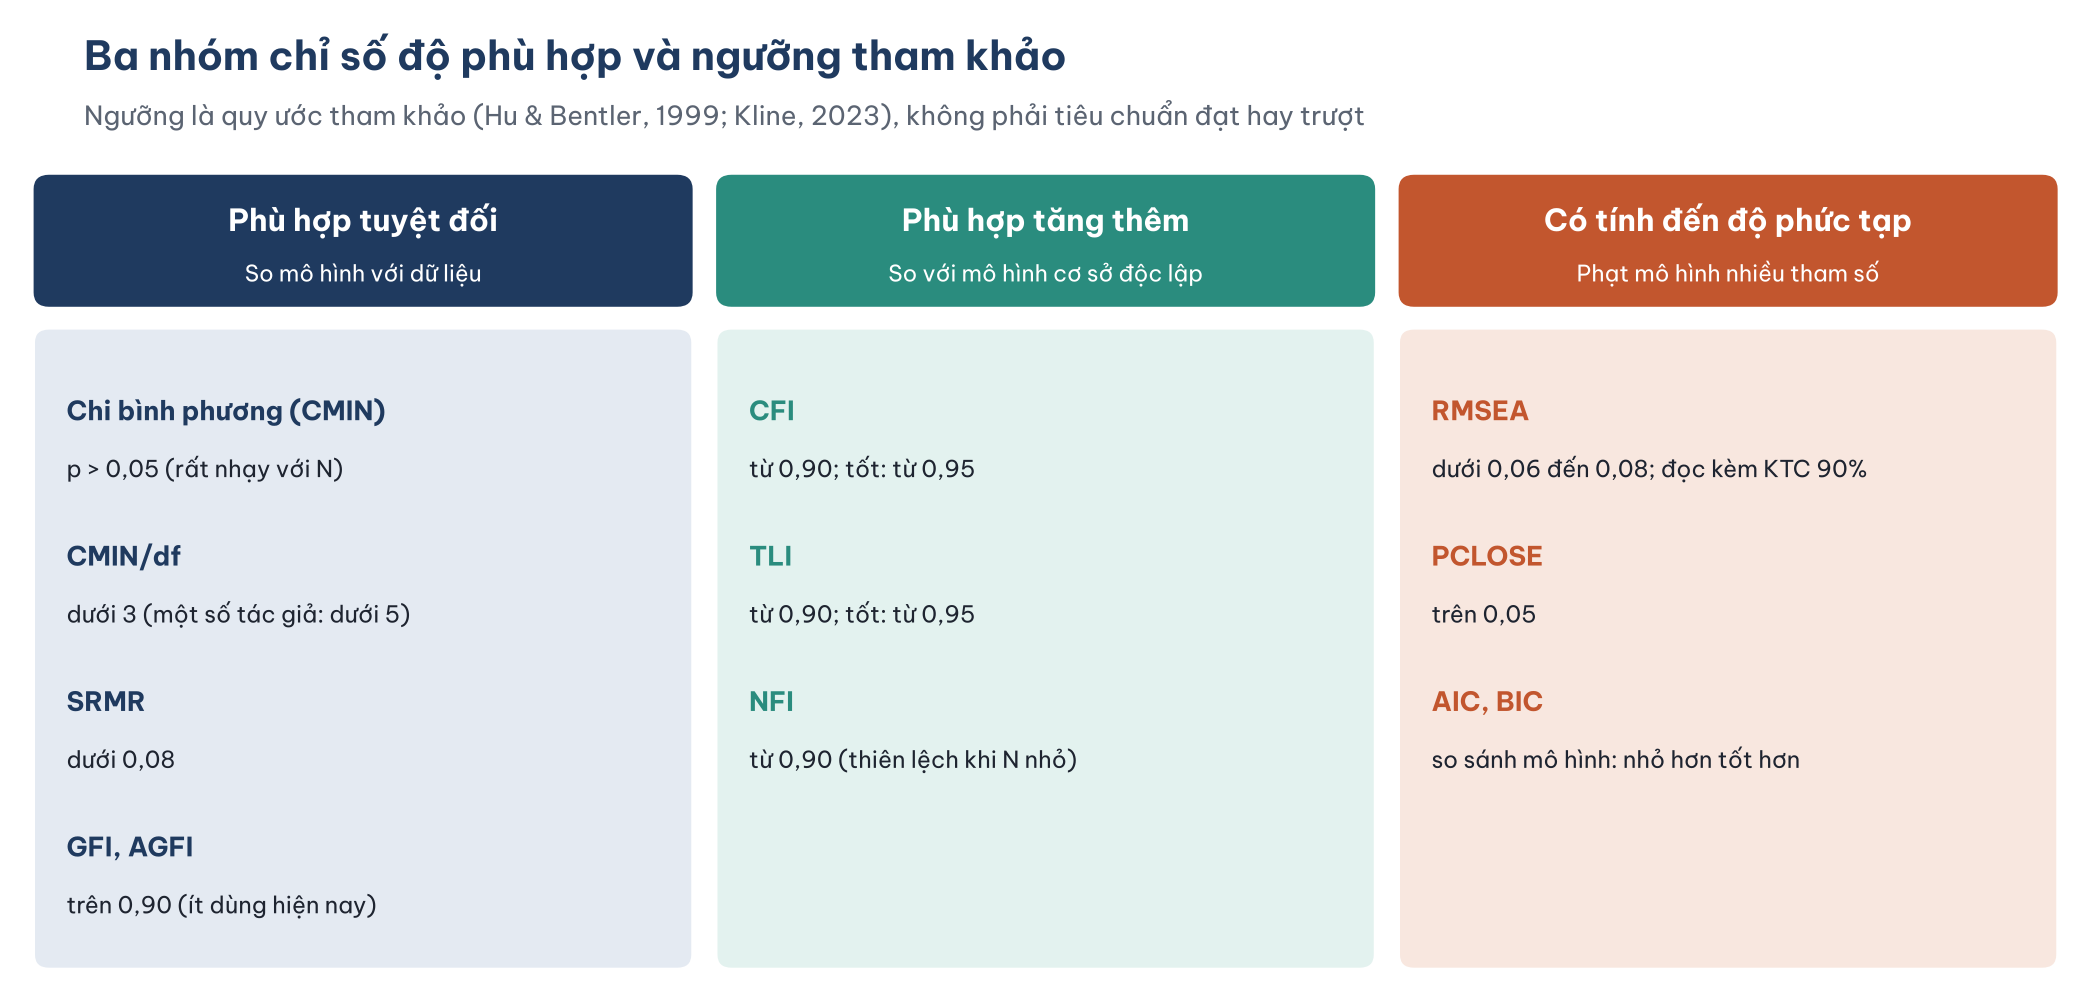
Hình 1. Ba nhóm chỉ số độ phù hợp và ngưỡng tham khảo thường dùng.
Chỉ số phù hợp tuyệt đối
Nhóm này so trực tiếp ma trận do mô hình tái tạo với ma trận của dữ liệu.
- Chi bình phương (AMOS gọi là CMIN). Kiểm định giả thuyết H0: mô hình tái tạo đúng hoàn toàn ma trận hiệp phương sai của tổng thể. p > 0,05 nghĩa là không bác bỏ H0. Chi bình phương tăng tỷ lệ thuận với cỡ mẫu, nên với mẫu vài trăm người trở lên, gần như mọi mô hình thực tế đều bị bác bỏ (mục 5).
- CMIN/df (chi bình phương chia bậc tự do). Một cách giảm phụ thuộc vào cỡ mẫu; thường dùng ngưỡng dưới 3, một số tác giả chấp nhận đến 5. Chỉ số này không có cơ sở thống kê chặt và vẫn tăng theo cỡ mẫu (Kline, 2023).
- SRMR (standardized root mean square residual). Trung bình chênh lệch giữa tương quan quan sát và tương quan do mô hình tái tạo. Dưới 0,08 được coi là tốt (Hu & Bentler, 1999).
- GFI, AGFI. Tỷ lệ phương sai, hiệp phương sai được mô hình giải thích. Hai chỉ số này bị ảnh hưởng mạnh bởi cỡ mẫu và hiện ít được khuyến nghị, nhưng vẫn hay xuất hiện trong luận văn ở Việt Nam.
Chỉ số phù hợp tăng thêm
So sánh mô hình của bạn với mô hình cơ sở độc lập (independence hay baseline model): mô hình giả định mọi câu hỏi không tương quan với nhau.
- CFI (comparative fit index; Bentler, 1990). Từ 0 đến 1; từ 0,90 là chấp nhận được, từ 0,95 là tốt (Hu & Bentler, 1999).
- TLI (Tucker-Lewis index, còn gọi NNFI). Tương tự CFI nhưng phạt mô hình phức tạp; có thể vượt 1 khi chi bình phương nhỏ hơn bậc tự do.
- NFI. Phiên bản cũ, thiên lệch xuống khi mẫu nhỏ; nên dùng CFI thay thế.
Chỉ số có tính đến độ phức tạp
Nhóm này phạt những mô hình có nhiều tham số, nên ưu tiên mô hình gọn.
- RMSEA (root mean square error of approximation). Đo mức sai lệch trên mỗi bậc tự do, nên phạt mô hình nhiều tham số. Dưới 0,06 là tốt (Hu & Bentler, 1999), dưới 0,08 là chấp nhận được. Luôn đọc kèm khoảng tin cậy 90%: với mẫu nhỏ, khoảng này rất rộng.
- PCLOSE (trong AMOS; JASP gọi là RMSEA p-value). Kiểm định H0: RMSEA tổng thể không vượt 0,05. PCLOSE > 0,05 là dấu hiệu tốt.
- AIC, BIC. Không có ngưỡng; chỉ dùng để so sánh các mô hình trên cùng dữ liệu: nhỏ hơn là tốt hơn.
Ngưỡng từ đâu ra?
Ngưỡng phổ biến nhất (CFI từ 0,95; RMSEA không quá 0,06; SRMR không quá 0,08) đến từ mô phỏng của Hu và Bentler (1999). Chính các tác giả và nhiều nghiên cứu sau cảnh báo rằng ngưỡng này chỉ đúng cho những loại mô hình đã mô phỏng và phụ thuộc vào cỡ mẫu, số câu hỏi, độ lớn hệ số tải (Marsh và cộng sự, 2004; McNeish & Wolf, 2023). Ví dụ, với hệ số tải cao, một mô hình sai đáng kể vẫn có thể có RMSEA thấp. Vì vậy:
- Báo cáo nhiều chỉ số thuộc các nhóm khác nhau, không chọn chỉ số "đẹp".
- Coi ngưỡng là tham khảo, kết hợp với phần dư, chỉ số điều chỉnh và lý thuyết.
3. Xem chỉ số độ phù hợp trong JASP
Mở lại phân tích CFA của bài phân tích nhân tố khẳng định (CFA) (file bai-23-do-phu-hop.jasp đi kèm). Kết quả nằm ở ba bảng: Chi-square test, Fit indices và Other fit measures (cần đánh dấu Additional fit measures trong mục Additional Output) (Hình 2, Hình 3).
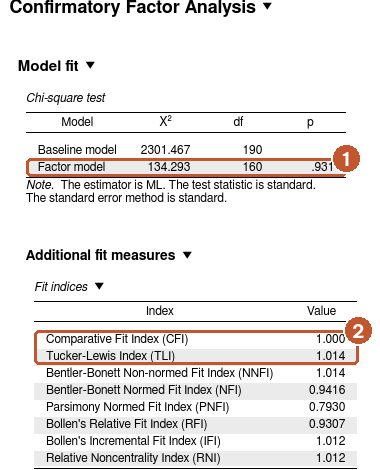
Hình 2. (1) Chi bình phương của mô hình năm nhân tố, (2) CFI và TLI.
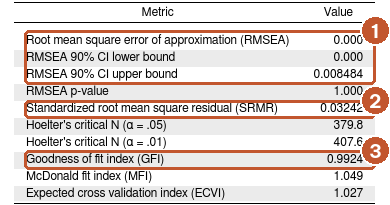
Hình 3. (1) RMSEA và khoảng tin cậy 90%, (2) SRMR, (3) GFI.
Ba lưu ý khi đọc bảng của JASP:
- Dòng Baseline model trong bảng Chi-square test là mô hình cơ sở độc lập (chi bình phương = 2301,47; df = 190), dùng để tính CFI và TLI. Đọc dòng Factor model.
- JASP không tính CMIN/df. Tính tay: 134,293 / 160 = 0,84.
- GFI khi dùng FIML (0,992) được tính trên mô hình có cả trung bình nên cao hơn GFI theo cách của AMOS. AMOS chỉ báo GFI khi dữ liệu đủ; giá trị tương ứng trên 254 người trả lời đủ là 0,950. Khi báo cáo GFI, nên dùng giá trị trên dữ liệu đủ.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, các chỉ số độ phù hợp nằm trong mục Model Fit của Text Output.
Mở View > Text Output (F10), chọn mục Model Fit ở cây mục bên trái (Hình 4, Bảng 1).
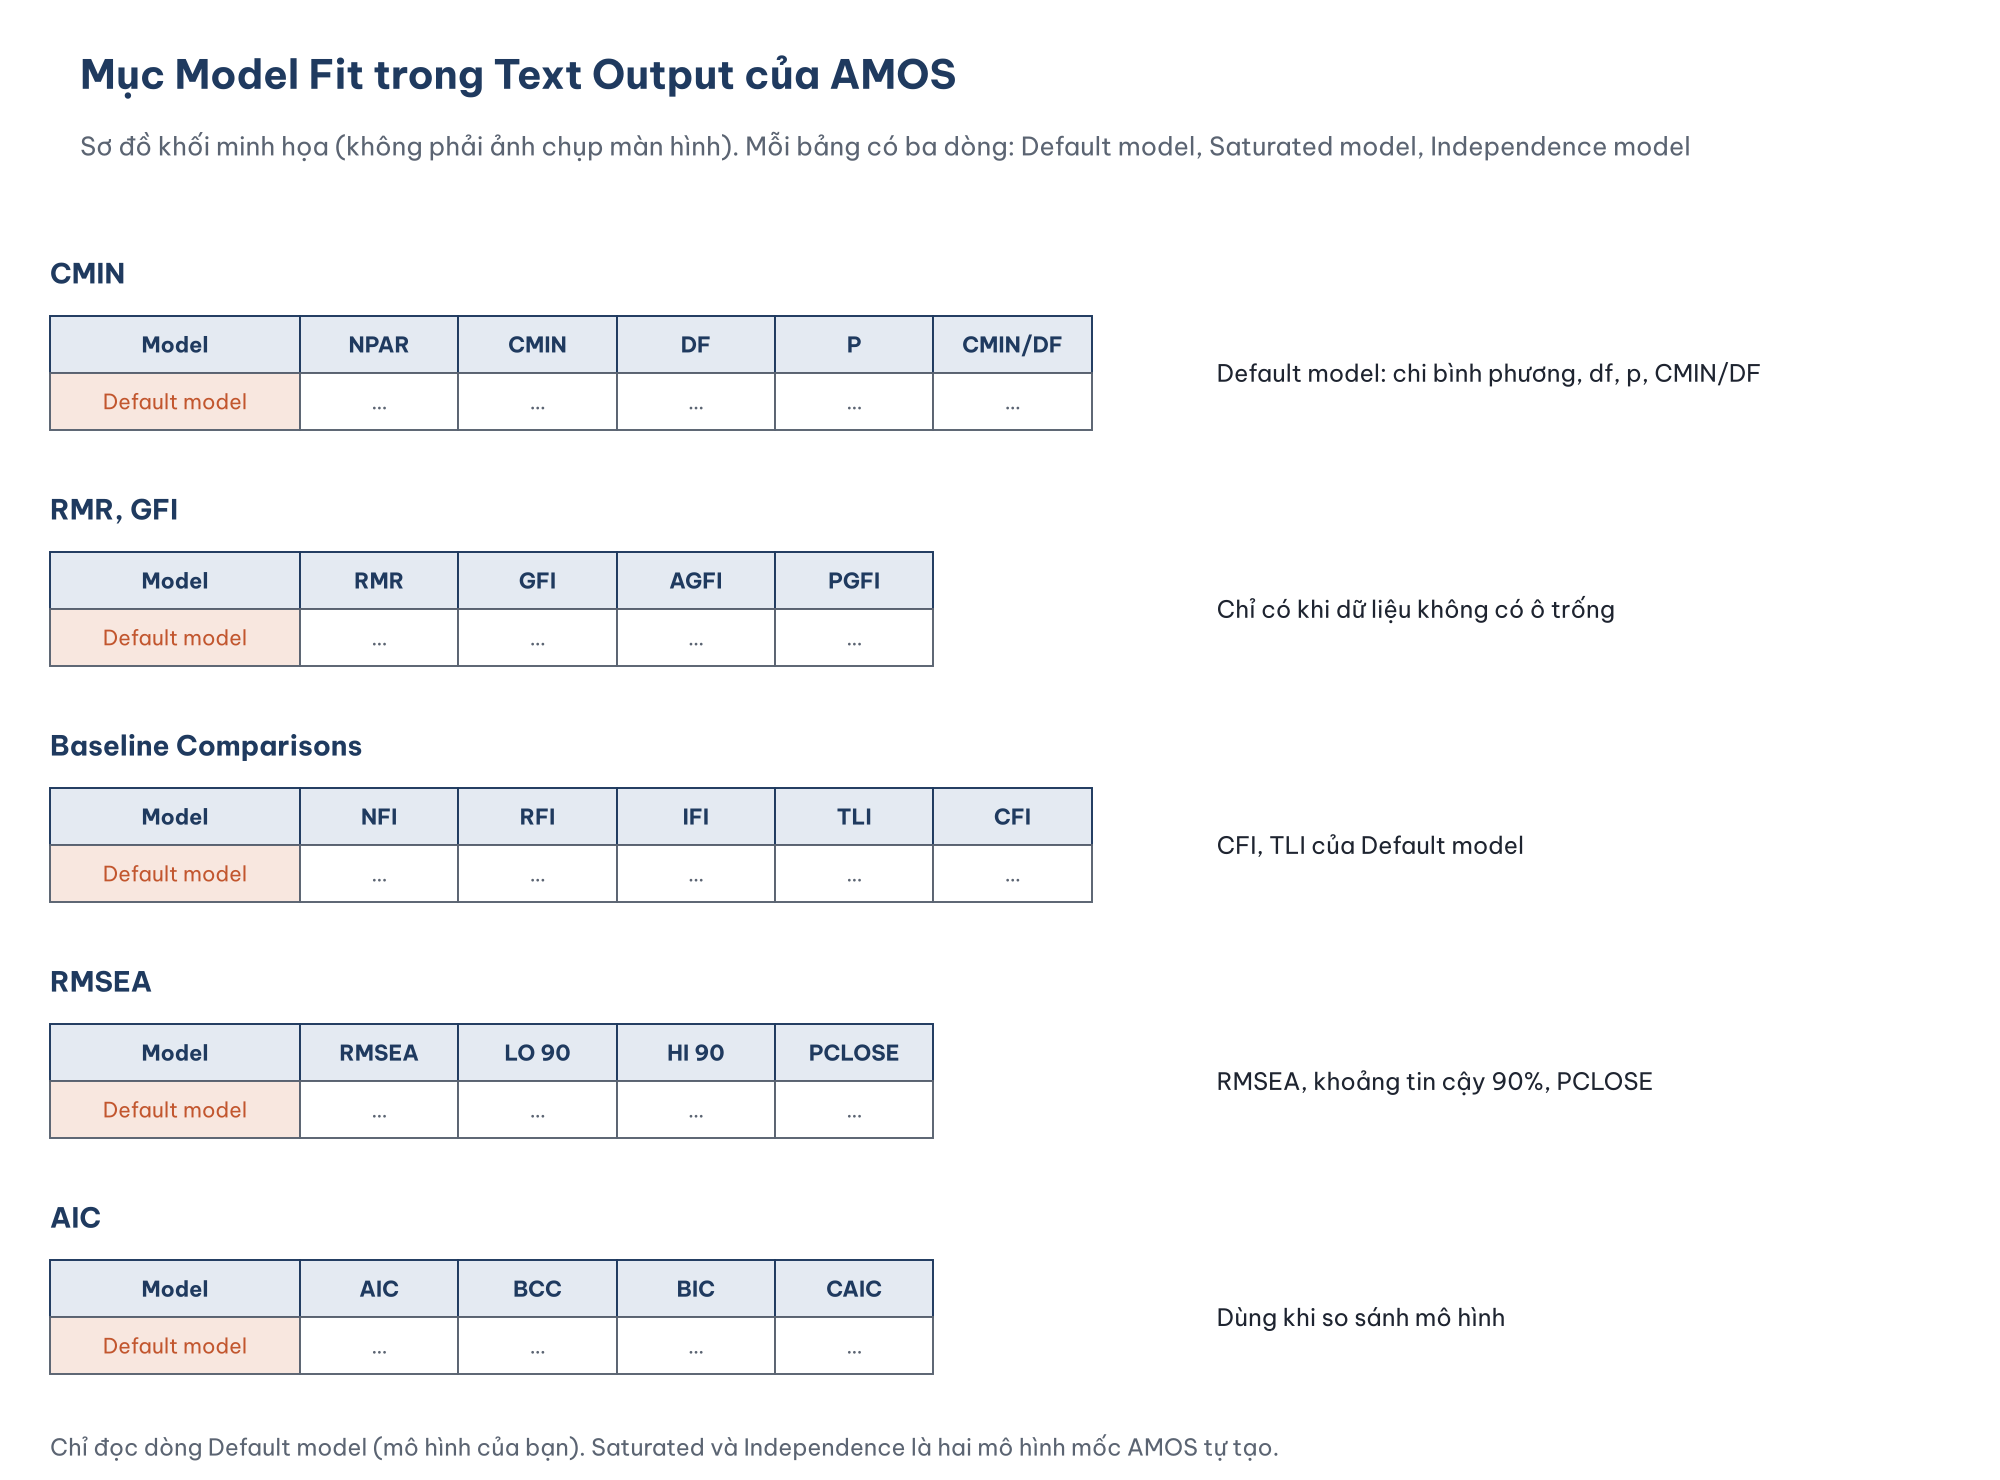
Hình 4. Các bảng trong mục Model Fit. Chỉ đọc dòng Default model.
Bảng 1. Các bảng trong mục Model Fit của AMOS.
| Bảng trong Model Fit | Chỉ số | Ghi chú |
|---|---|---|
| CMIN | CMIN, DF, P, CMIN/DF | NPAR là số tham số tự do |
| RMR, GFI | RMR, GFI, AGFI | Chỉ có khi dữ liệu không có ô trống |
| Baseline Comparisons | NFI, RFI, IFI, TLI, CFI | |
| RMSEA | RMSEA, LO 90, HI 90, PCLOSE | |
| AIC | AIC, BCC, BIC, CAIC | So sánh mô hình |
AMOS không tính SRMR trong Text Output. Có hai cách lấy SRMR: dùng Plugins > Standardized RMR, chạy plugin rồi chạy lại mô hình (AMOS hiện kết quả trong một cửa sổ riêng); hoặc tính từ ma trận phần dư. Khi dữ liệu có ô trống (dùng Estimate means and intercepts), plugin này và bảng RMR, GFI không chạy được, nên lấy SRMR và GFI từ lần chạy trên file 254 người trả lời đủ (bài chuẩn bị dữ liệu cho CFA và SEM, 22).
4. Kết quả của mô hình năm nhân tố
Bảng 2 tổng hợp các chỉ số độ phù hợp của mô hình năm nhân tố cùng ngưỡng tham khảo.
Bảng 2. Chỉ số độ phù hợp của mô hình năm nhân tố.
| Chỉ số | Giá trị | Ngưỡng tham khảo |
|---|---|---|
| Chi bình phương (CMIN), df, p | 134,29; 160; 0,931 | p > 0,05 |
| CMIN/df | 0,84 | dưới 3 |
| CFI | 1,000 | từ 0,95 |
| TLI | 1,014 | từ 0,95 |
| RMSEA (KTC 90%) | 0,000 (0,000 đến 0,008) | dưới 0,06 |
| PCLOSE | 1,000 | trên 0,05 |
| SRMR | 0,032 | dưới 0,08 |
| GFI, AGFI (N = 254 trả lời đủ) | 0,950; 0,935 | trên 0,90 |
Ước lượng ML, FIML, N = 267, trừ GFI và AGFI.
Mọi chỉ số đều vượt xa ngưỡng: CMIN/df dưới 1, TLI lớn hơn 1, RMSEA bằng 0. Kết quả "hoàn hảo" như vậy hiếm gặp với dữ liệu khảo sát thật; ở đây là do dữ liệu được giả lập từ chính cấu trúc năm nhân tố (bài AMOS và CB-SEM). Khi gặp kết quả quá đẹp trên dữ liệu thật, hãy kiểm tra lại: cỡ mẫu có quá nhỏ không (chi bình phương nhỏ vì thiếu lực kiểm định), hay có câu hỏi nào bị nhân đôi.
5. Chi bình phương phụ thuộc cỡ mẫu
Chi bình phương tăng theo cỡ mẫu dù mức sai lệch giữa mô hình và dữ liệu không đổi (Hình 5).
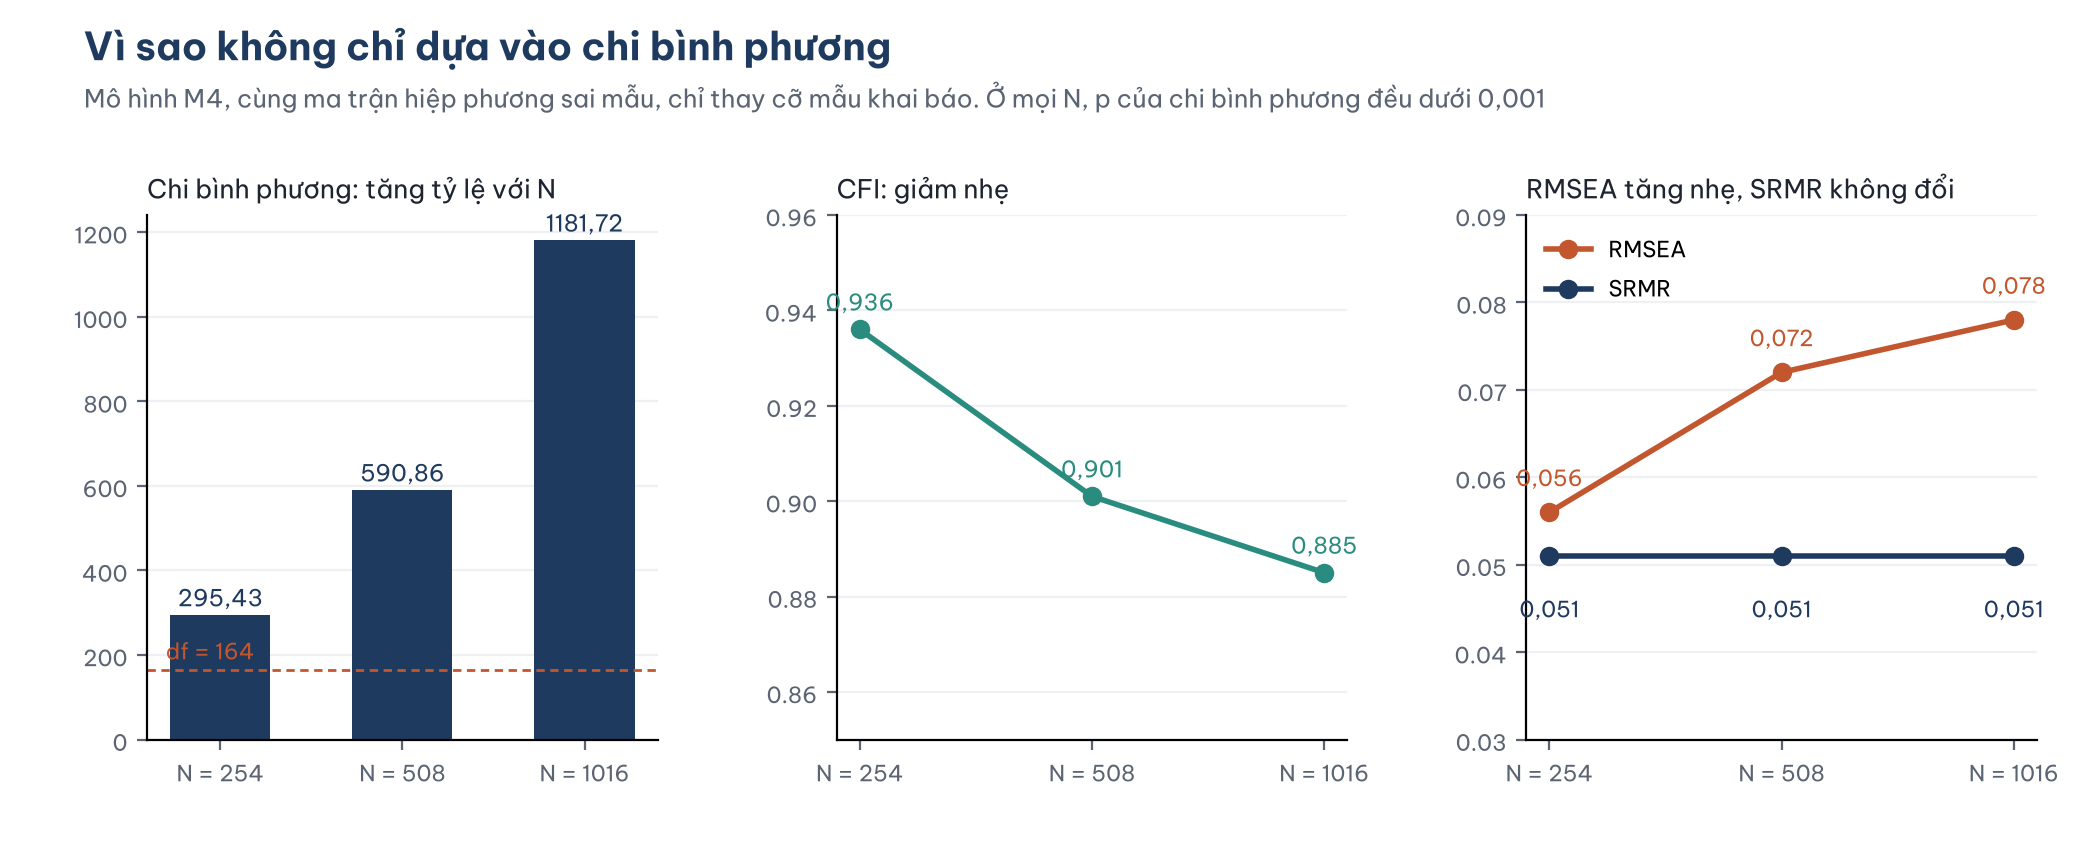
Hình 5. Cùng một mức sai lệch giữa mô hình và dữ liệu, chi bình phương tăng gấp đôi khi cỡ mẫu tăng gấp đôi.
Hình 5 dùng mô hình sai M4 (mục 6) với cùng ma trận hiệp phương sai mẫu, chỉ thay cỡ mẫu khai báo. Chi bình phương tăng đúng tỷ lệ với N (295 lên 591 rồi 1182), trong khi SRMR không đổi (0,051) và RMSEA, CFI thay đổi ít hơn nhiều. Đây là lý do với mẫu lớn, p của chi bình phương gần như luôn nhỏ hơn 0,05 dù mô hình chỉ sai rất ít và người ta dùng thêm các chỉ số khác.
Chiều ngược lại cũng đúng: với mẫu nhỏ, chi bình phương có p lớn chưa chắc vì mô hình tốt, mà có thể vì kiểm định thiếu lực.
6. Các chỉ số có phân biệt được mô hình sai không?
Để kiểm tra, bài chạy thêm hai mô hình sai trên cùng dữ liệu:
- M4: gộp Giá trị cảm nhận (HI) và Sự hài lòng (HL) thành một nhân tố tám câu. Hai khái niệm này có tương quan cao nhất trong mô hình đúng (0,64, bài phân tích nhân tố khẳng định (CFA)), nên đây là lỗi dễ mắc nhất.
- M1: mọi câu đo một nhân tố duy nhất (Hình 6, Bảng 3).
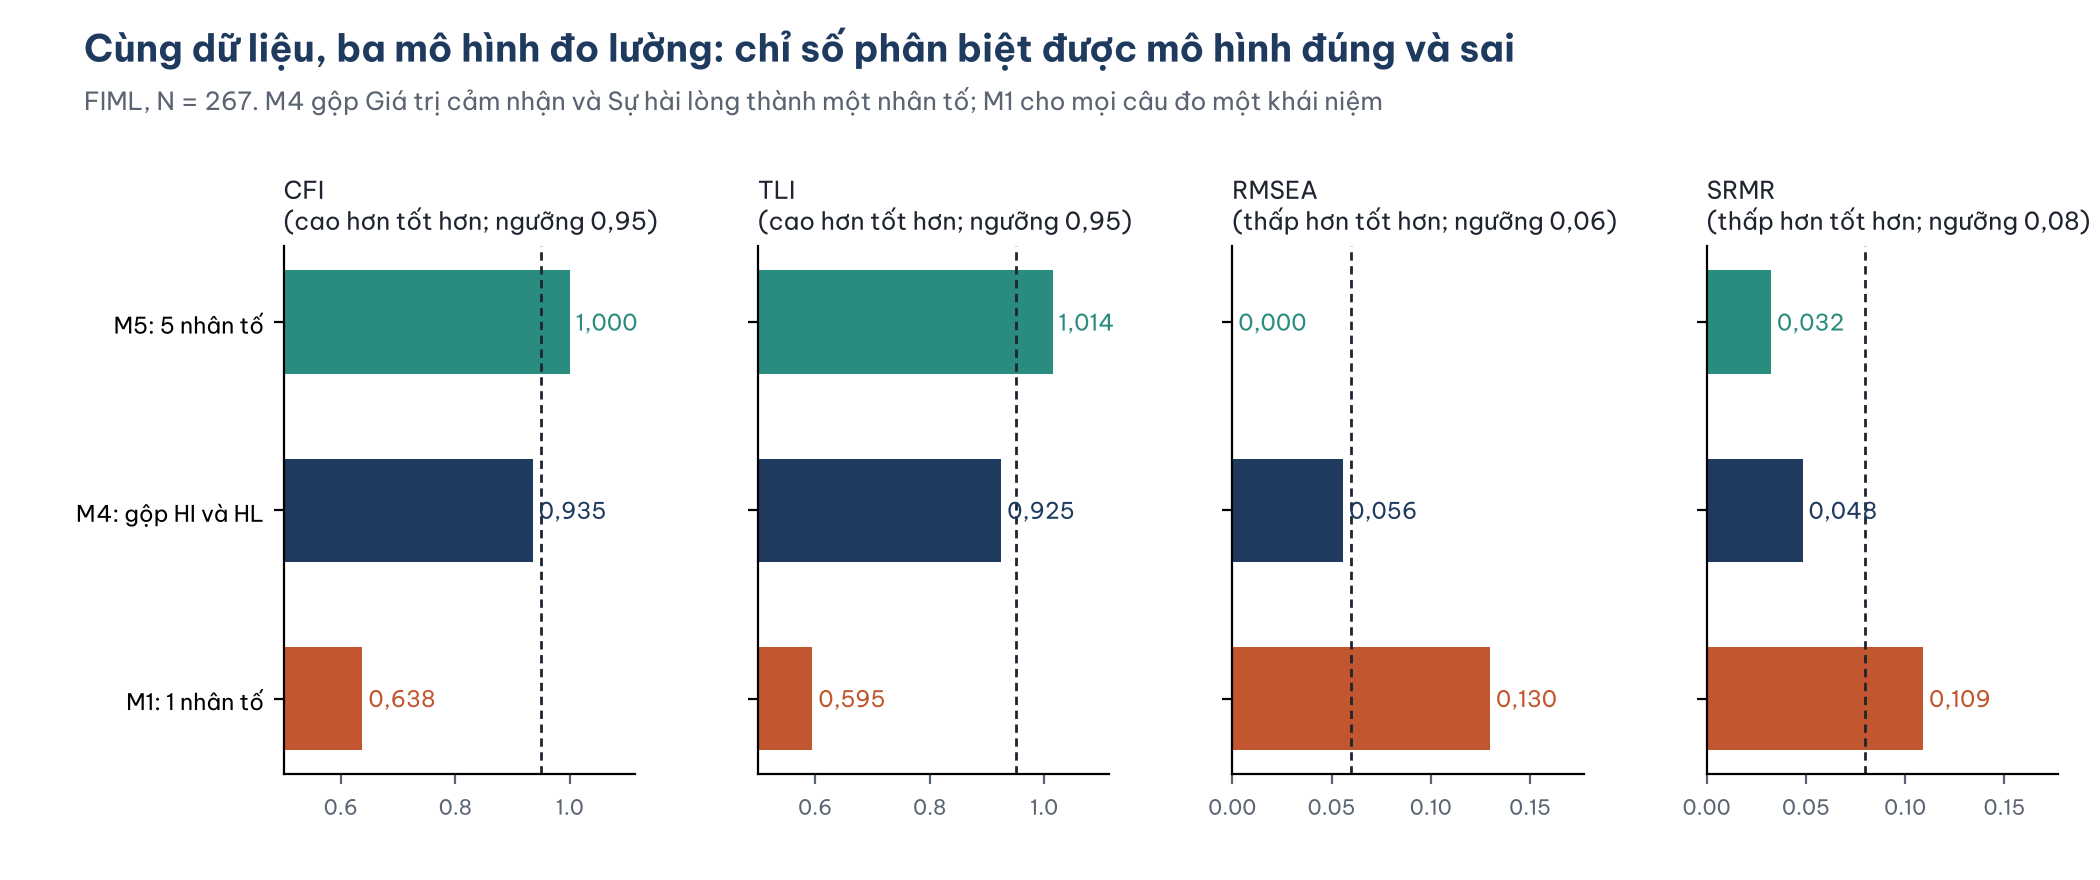
Hình 6. CFI, TLI, RMSEA và SRMR của ba mô hình. Đường đứt đoạn là ngưỡng của Hu và Bentler (1999).
Bảng 3. Chỉ số độ phù hợp của ba mô hình.
| Chỉ số | M5 (đúng) | M4 (gộp HI, HL) | M1 (một nhân tố) |
|---|---|---|---|
| Chi bình phương; df | 134,29; 160 | 300,81; 164 | 935,06; 170 |
| CMIN/df | 0,84 | 1,83 | 5,50 |
| CFI | 1,000 | 0,935 | 0,638 |
| TLI | 1,014 | 0,925 | 0,595 |
| RMSEA (KTC 90%) | 0,000 (0,000; 0,008) | 0,056 (0,046; 0,066) | 0,130 (0,122; 0,138) |
| SRMR | 0,032 | 0,048 | 0,109 |
| AIC | 12507 | 12666 | 13288 |
ML, FIML, N = 267.
Kết quả đáng chú ý nhất là M4: mô hình sai nhưng đạt nhiều ngưỡng quen thuộc. CMIN/df = 1,83 (dưới 3), CFI = 0,935 (trên 0,90), RMSEA = 0,056 (dưới 0,06), SRMR = 0,048 (dưới 0,08). Chỉ CFI và TLI chưa đạt mức "tốt" 0,95. Nếu chỉ đối chiếu ngưỡng, một nhà nghiên cứu có thể kết luận M4 "chấp nhận được" và bỏ qua việc HI và HL là hai khái niệm khác nhau.
Điều phân biệt được M4 với M5 là so sánh trực tiếp hai mô hình:
- Kiểm định chênh lệch chi bình phương. M4 lồng trong M5 (M4 chính là M5 với tương quan HI–HL cố định bằng 1), nên hiệu chi bình phương có phân phối chi bình phương: hiệu chi bình phương = 300,81 − 134,29 = 166,52; hiệu bậc tự do = 164 − 160 = 4; p < 0,001. Gộp hai nhân tố làm mô hình kém đi rõ rệt.
- AIC của M5 nhỏ hơn M4 159 đơn vị.
- Tương quan HI–HL trong M5 là 0,64 với khoảng tin cậy xa 1, nên dữ liệu không ủng hộ việc coi chúng là một.
M1 thì bị mọi chỉ số bác bỏ (CFI 0,64; RMSEA 0,13; SRMR 0,11). Cách so sánh này cũng là một kiểm tra thô cho phương sai phương pháp chung: nếu mô hình một nhân tố phù hợp gần bằng mô hình nhiều nhân tố, câu trả lời có thể bị chi phối bởi cách hỏi hơn là nội dung (bài phương sai phương pháp chung).
So sánh mô hình trong JASP
Mô-đun SEM cho phép khai báo nhiều mô hình trong cùng một phân tích và tự tính kiểm định chênh lệch chi bình phương:
- Mở phân tích Structural Equation Modeling của bài phân tích nhân tố khẳng định (CFA) (đã có mô hình năm nhân tố ở tab Model 1).
- Bấm dấu cộng màu xanh cạnh tab để thêm Model 2; gõ mô hình M4, nhấn Ctrl+Enter (Hình 7). Lặp lại cho M1.
- Bấm đúp vào tên tab để đổi thành M5, M4, M1.
- Chọn Missing data handling = Listwise deletion trong Estimation Options. Lý do: với FIML, mô-đun SEM của JASP 0.99.0 ước lượng thêm trung bình nhân tố và báo sai bậc tự do (bài phân tích nhân tố khẳng định (CFA)). Listwise dùng 254 người trả lời đủ, nên con số khác nhẹ so với bảng ở trên.
- Đánh dấu Additional fit measures trong Output Options (Hình 8, Hình 9).
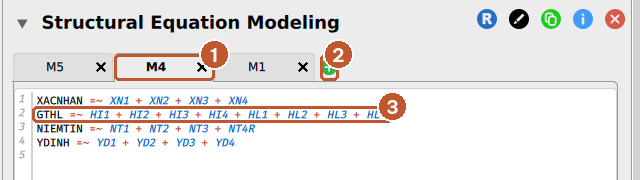
Hình 7. (1) Tab mô hình M4, (2) nút thêm mô hình, (3) nhân tố GTHL gộp tám câu của HI và HL.
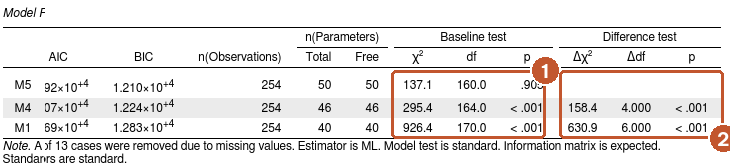
Hình 8. (1) Chi bình phương, df và p của từng mô hình, (2) kiểm định chênh lệch so với mô hình ở dòng trên.
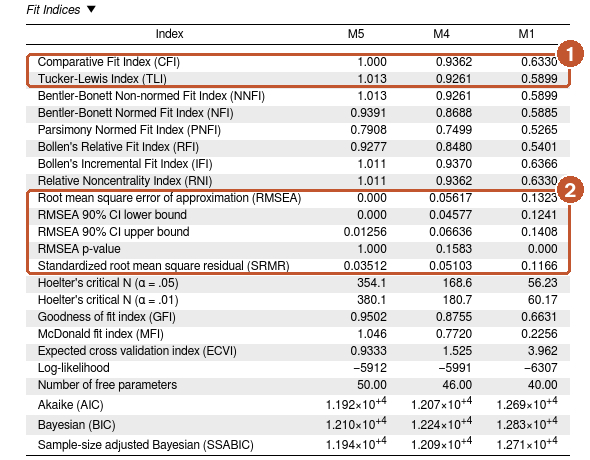
Hình 9. (1) CFI và TLI, (2) RMSEA, khoảng tin cậy và SRMR của M5, M4, M1.
Với 254 người trả lời đủ: hiệu chi bình phương = 158,4 (4 bậc tự do) khi so M4 với M5 và hiệu chi bình phương = 630,9 (6 bậc tự do) khi so M1 với M4, cả hai p < 0,001. Lưu ý JASP đặt tên cột là Baseline test cho kiểm định chi bình phương của từng mô hình, khác với nghĩa "mô hình cơ sở" ở bảng của mô-đun CFA. Cột Difference test so mỗi mô hình với mô hình ngay trên nó, nên thứ tự tab quan trọng: đặt mô hình phức tạp nhất ở tab đầu.
So sánh mô hình trong AMOS
AMOS không có bảng so sánh các mô hình chạy ở file khác nhau. Có hai cách:
- Chạy riêng từng mô hình (ba file
.amw), ghi lại CMIN, DF, AIC từ Text Output và tính chênh lệch bằng tay như trên. Giá trị p của hiệu chi bình phương tra bằng hàm=CHISQ.DIST.RT(166.52; 4)trong Excel. - Dùng nhiều mô hình trong một file: với M4, đặt nhãn cho hiệp phương sai HI–HL (ví dụ
r) trong mô hình M5, rồi ở bảng điều khiển Models bấm đúp Default model, thêm mô hình mới với ràng buộc tương quan bằng 1. Cách này phức tạp hơn vì phải cố định phương sai nhân tố bằng 1; bài phân tích đa nhóm sẽ hướng dẫn chi tiết cách đặt ràng buộc. Khi có nhiều mô hình, mục Model Comparison trong Text Output tự tính hiệu chi bình phương và p.
7. Khi độ phù hợp chưa đạt
Với dữ liệu thật, CFI dưới 0,90 hoặc RMSEA trên 0,08 là chuyện có thể gặp. Thứ tự xử lý hợp lý (Brown, 2015; Kline, 2023):
- Kiểm tra dữ liệu và khai báo. Câu đảo chiều đã mã hóa lại chưa, có đưa nhầm câu vào nhân tố khác không, dữ liệu thiếu xử lý thế nào.
- Xem phần dư chuẩn hóa và chỉ số điều chỉnh (bài phân tích nhân tố khẳng định (CFA)) để biết sai lệch tập trung ở đâu: một câu hỏi, một cặp câu, hay cả một nhân tố.
- Sửa có lý do lý thuyết. Ví dụ hai câu có cách diễn đạt gần giống nhau có thể cho phép sai số tương quan. Loại một câu tải thấp và tải chéo cũng là lựa chọn hợp lý nếu không làm mất nội dung.
- Báo cáo mọi thay đổi và độ phù hợp trước và sau khi sửa.
Không nên sửa liên tục theo chỉ số điều chỉnh lớn nhất cho đến khi đạt ngưỡng: mô hình cuối cùng sẽ khớp với đặc thù của mẫu và khó lặp lại (MacCallum và cộng sự, 1992).
8. Trình bày kết quả
Mô hình đo lường năm nhân tố phù hợp với dữ liệu: chi bình phương = 134,29; df = 160; p = 0,931; CMIN/df = 0,84; CFI = 1,000; TLI = 1,014; RMSEA = 0,000 (KTC 90% [0,000; 0,008]); SRMR = 0,032. Mô hình thay thế gộp Giá trị cảm nhận và Sự hài lòng thành một nhân tố phù hợp kém hơn có ý nghĩa, hiệu chi bình phương = 166,52 với 4 bậc tự do; p < 0,001; CFI = 0,935; RMSEA = 0,056; mô hình một nhân tố phù hợp kém, CFI = 0,638; RMSEA = 0,130; SRMR = 0,109.
Nên báo cáo tối thiểu chi bình phương với df và p, CFI, TLI, RMSEA kèm khoảng tin cậy 90% và SRMR. CMIN/df, GFI, AGFI có thể thêm nếu hội đồng hoặc tạp chí yêu cầu.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi đọc và báo cáo độ phù hợp của mô hình.
- Chỉ báo cáo các chỉ số đạt ngưỡng và bỏ qua chỉ số không đạt.
- Kết luận mô hình "đúng" vì đạt ngưỡng. Mô hình M4 sai nhưng đạt nhiều ngưỡng.
- Bỏ qua khoảng tin cậy của RMSEA, đặc biệt khi mẫu nhỏ hoặc bậc tự do thấp.
- Dùng GFI, AGFI làm tiêu chí chính. Hai chỉ số này phụ thuộc nhiều vào cỡ mẫu.
- Sửa mô hình theo chỉ số điều chỉnh để đạt ngưỡng mà không có lý do lý thuyết.
Tài liệu tham khảo
Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
Brown, T. A. (2015). Confirmatory factor analysis for applied research (2nd ed.). Guilford Press. https://www.guilford.com/books/Confirmatory-Factor-Analysis-for-Applied-Research/Timothy-Brown/9781462515363
Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
McNeish, D., & Wolf, M. G. (2023). Dynamic fit index cutoffs for confirmatory factor analysis models. Psychological Methods, 28(1), 61–88. https://doi.org/10.1037/met0000425
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02