
PHÂN TÍCH NHÂN TỐ KHẲNG ĐỊNH CFA VỚI JASP VÀ AMOS
Chạy CFA năm thang đo trong JASP và AMOS, đọc hệ số tải, tương quan, chỉ số điều chỉnh và kiểm định Mardia
Bài nên đọc trước
Bài phân tích nhân tố khám phá dùng EFA để khám phá xem 20 câu hỏi nhóm lại thế nào và thấy năm nhân tố đúng như thiết kế. Phân tích nhân tố khẳng định (CFA) đi bước ngược lại: khai báo trước câu nào đo khái niệm nào, rồi kiểm tra dữ liệu có ủng hộ cấu trúc đó không (Brown, 2015). CFA là bước bắt buộc trước khi chạy SEM: nếu mô hình đo lường không đạt, kết luận về các giả thuyết ở mô hình cấu trúc không còn đáng tin (Anderson & Gerbing, 1988).
Bài này chạy CFA cho năm thang đo của mô hình sàn X (20 câu hỏi), đọc các kết quả cốt lõi và thực hiện kiểm định phân phối chuẩn đa biến Mardia, bước kiểm tra phân phối chuẩn mà bài thống kê mô tả khuyên để dành đến giai đoạn CFA. Ba bài tiếp theo đi sâu vào từng nhóm chỉ số: độ phù hợp (bài chỉ số độ phù hợp của mô hình), CR và AVE (bài độ tin cậy tổng hợp và phương sai trích), giá trị phân biệt (bài giá trị hội tụ và giá trị phân biệt).
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026) trên file du_lieu_amos.sav chuẩn bị ở bài chuẩn bị dữ liệu cho CFA và SEM. Các con số được đối chiếu bằng gói lavaan của R (Rosseel, 2012), file cfa_5_nhan_to.R đi kèm. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
22-phan-tich-cfa-jasp-amoscủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Mô hình đo lường cần kiểm định
Mô hình đo lường gồm năm nhân tố với 20 câu hỏi (Bảng 1).
Bảng 1. Năm nhân tố của mô hình đo lường.
| Nhân tố (tên trong mô hình) | Câu hỏi | Nguồn gốc thang đo |
|---|---|---|
| Xác nhận kỳ vọng (XACNHAN) | XN1 đến XN4 | bài các loại thang đo |
| Giá trị cảm nhận (GIATRI) | HI1 đến HI4 | bài các loại thang đo |
| Sự hài lòng (HAILONG) | HL1 đến HL4 | bài các loại thang đo |
| Niềm tin (NIEMTIN) | NT1, NT2, NT3, NT4R | bài các loại thang đo, NT4 đảo chiều ở bài tính biến đại diện |
| Ý định mua lại (YDINH) | YD1 đến YD4 | bài các loại thang đo |
Trong CFA, mỗi câu hỏi chỉ tải lên một nhân tố, các sai số đo lường không tương quan với nhau và mọi cặp nhân tố được phép tương quan (10 hiệp phương sai). Tên nhân tố không trùng tên cột nào trong file dữ liệu (bài vẽ mô hình đầu tiên, 21).
Với 20 câu hỏi, dữ liệu có 20 × 21 / 2 = 210 phương sai và hiệp phương sai. Mô hình ước lượng 50 tham số: 15 hệ số tải (5 hệ số còn lại cố định bằng 1), 20 phương sai sai số, 5 phương sai nhân tố và 10 hiệp phương sai giữa các nhân tố. Bậc tự do là 210 − 50 = 160.
2. Chạy CFA trong JASP
CFA trong JASP được khai báo bằng cách kéo câu hỏi vào từng nhân tố, không cần vẽ sơ đồ.
Khai báo năm nhân tố
Năm nhân tố được khai báo lần lượt trong khung tùy chọn của phân tích.
- Mở file
du_lieu_amos.sav(các câu hỏi đã ở kiểu Scale nhờ bước chuẩn bị ở bài chuẩn bị dữ liệu cho CFA và SEM), chọn Factor > Confirmatory Factor Analysis. - Đưa XN1 đến XN4 vào ô Factor 1, bấm đúp vào tiêu đề và đổi tên thành XACNHAN.
- Bấm dấu cộng màu xanh dưới các ô nhân tố để thêm nhân tố mới; lặp lại cho GIATRI, HAILONG, NIEMTIN và YDINH (Hình 1).
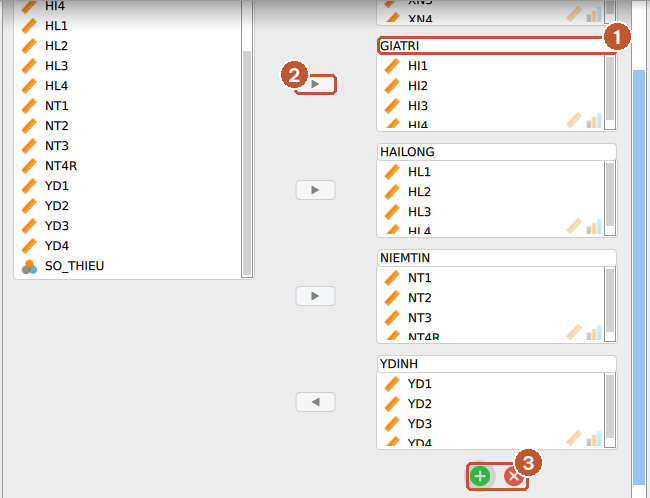
Hình 1. (1) Tên nhân tố, (2) mũi tên chuyển câu hỏi vào nhân tố, (3) nút thêm hoặc xóa nhân tố.
JASP mặc định cho mọi cặp nhân tố tương quan và cố định hệ số tải đầu tiên bằng 1 (mục Model Options), giống AMOS. Trong danh sách biến bên trái, các câu đã đưa vào nhân tố vẫn hiện, vì JASP cho phép một câu tải lên nhiều nhân tố; cẩn thận không đưa nhầm một câu vào hai nhân tố.
Chọn tùy chọn
Trước khi chạy, cần chọn các tùy chọn trong ba mục Advanced, Additional Output và Plots (Bảng 2).
Bảng 2. Tùy chọn cần chọn khi chạy CFA trong JASP.
| Mục | Tùy chọn | Dùng để |
|---|---|---|
| Advanced | Missing data handling = FIML | Dùng đủ 267 người (bài chuẩn bị dữ liệu cho CFA và SEM) |
| Advanced | Standardization = All | Hệ số tải và tương quan chuẩn hóa |
| Additional Output | Additional fit measures | CFI, TLI, RMSEA, SRMR (bài chỉ số độ phù hợp của mô hình) |
| Additional Output | R-Squared | R² của từng câu hỏi |
| Additional Output | Modification indices (ngưỡng 3,84) | Tìm chỗ mô hình chưa khớp dữ liệu |
| Plots | Model plot, Show parameter estimates, Standardized | Sơ đồ mô hình |
Khác với AMOS, JASP tính được chỉ số điều chỉnh khi dùng FIML, nên chỉ cần chạy một lần với cả 267 người.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, mô hình được vẽ trên sơ đồ, chọn kết quả cần xuất rồi đọc trong Text Output.
Vẽ mô hình
- Kết nối file
du_lieu_amos.savbằng File > Data Files (bài chuẩn bị dữ liệu cho CFA và SEM). - Vẽ nhân tố thứ nhất bằng công cụ Draw a latent variable or add an indicator to a latent variable, bấm bốn lần để có bốn câu hỏi, rồi xoay câu hỏi xuống dưới bằng Rotate the indicators of a latent variable (bài vẽ mô hình đầu tiên).
- Nhân bản nhân tố đó bốn lần: chọn cả cụm bằng Select all objects, dùng công cụ Duplicate objects (biểu tượng máy photocopy) và kéo sang phải. Cách này giữ đúng kích thước và khoảng cách.
- Gán tên câu hỏi bằng cách kéo từ View > Variables in Dataset; đặt tên năm nhân tố là XACNHAN, GIATRI, HAILONG, NIEMTIN, YDINH bằng cách bấm đúp vào từng hình bầu dục.
- Đặt tên sai số bằng Plugins > Name Unobserved Variables (e1 đến e20).
- Vẽ hiệp phương sai giữa mọi cặp nhân tố: chọn năm hình bầu dục bằng Select one object at a time, rồi chọn Plugins > Draw Covariances. AMOS vẽ đủ 10 mũi tên hai chiều.
Hình 3 ở mục 3 là sơ đồ mô hình sau khi chạy.
Chọn kết quả cần xuất
Mở View > Analysis Properties (Ctrl+A) (Bảng 3):
Bảng 3. Tùy chọn trong Analysis Properties của AMOS.
| Thẻ | Tùy chọn | Dùng để |
|---|---|---|
| Estimation | Estimate means and intercepts | FIML với 267 người (bài chuẩn bị dữ liệu cho CFA và SEM) |
| Output | Standardized estimates | Hệ số tải và tương quan chuẩn hóa |
| Output | Squared multiple correlations | R² của từng câu hỏi |
| Output | Modification indices (ngưỡng 4) | Tìm chỗ mô hình chưa khớp dữ liệu |
| Output | Tests for normality and outliers | Kiểm định Mardia và khoảng cách Mahalanobis |
| Bootstrap | Perform bootstrap, 2000 mẫu, Bollen-Stine bootstrap | Hiệu chỉnh khi dữ liệu lệch chuẩn |
Ba tùy chọn cuối (chỉ số điều chỉnh, kiểm định phân phối chuẩn, bootstrap) không chạy được khi dữ liệu có ô trống (Byrne, 2016). Cách làm thực tế là chạy hai lần:
- Chạy với
du_lieu_amos_du.sav(254 người trả lời đủ), bỏ Estimate means and intercepts, chọn đủ ba tùy chọn trên để kiểm tra phân phối chuẩn, ngoại lai, chỉ số điều chỉnh và bootstrap. - Chạy với
du_lieu_amos.sav(267 người), chọn Estimate means and intercepts, để lấy ước lượng chính thức báo cáo trong luận văn.
Bài chuẩn bị dữ liệu cho CFA và SEM đã cho thấy hai cách gần như trùng kết quả với dữ liệu mẫu. Lưu file mô hình (ví dụ cfa_5_nhan_to.amw) rồi bấm Analyze > Calculate Estimates (Ctrl+F9).
Các mục cần xem trong Text Output
Mở View > Text Output (F10) (Bảng 4):
Bảng 4. Các mục cần xem trong Text Output của AMOS.
| Mục | Nội dung | Mục của bài |
|---|---|---|
| Notes for Model | Bậc tự do, dòng Minimum was achieved | 3, bước 1 |
| Assessment of normality | Độ lệch, độ nhọn từng câu và hệ số Mardia | 4 |
| Observations farthest from the centroid | Khoảng cách Mahalanobis | 4 |
| Estimates | Regression Weights, Standardized Regression Weights, Covariances, Correlations, Variances, Squared Multiple Correlations | 3 |
| Modification Indices | Covariances và Regression Weights đề xuất thêm | 3, bước 5 |
| Model Fit | CMIN, CFI, TLI, RMSEA… | bài chỉ số độ phù hợp của mô hình |
Với Estimate means and intercepts, mục Notes for Model ghi 230 thông tin (210 phương sai, hiệp phương sai và 20 trung bình) và 70 tham số (50 tham số ở trên và 20 hệ số chặn); bậc tự do vẫn là 160.
3. Đọc kết quả theo sáu bước
Kết quả CFA nên được đọc theo một trình tự cố định, từ việc mô hình có chạy được hay không đến chỉ số điều chỉnh (Hình 2).
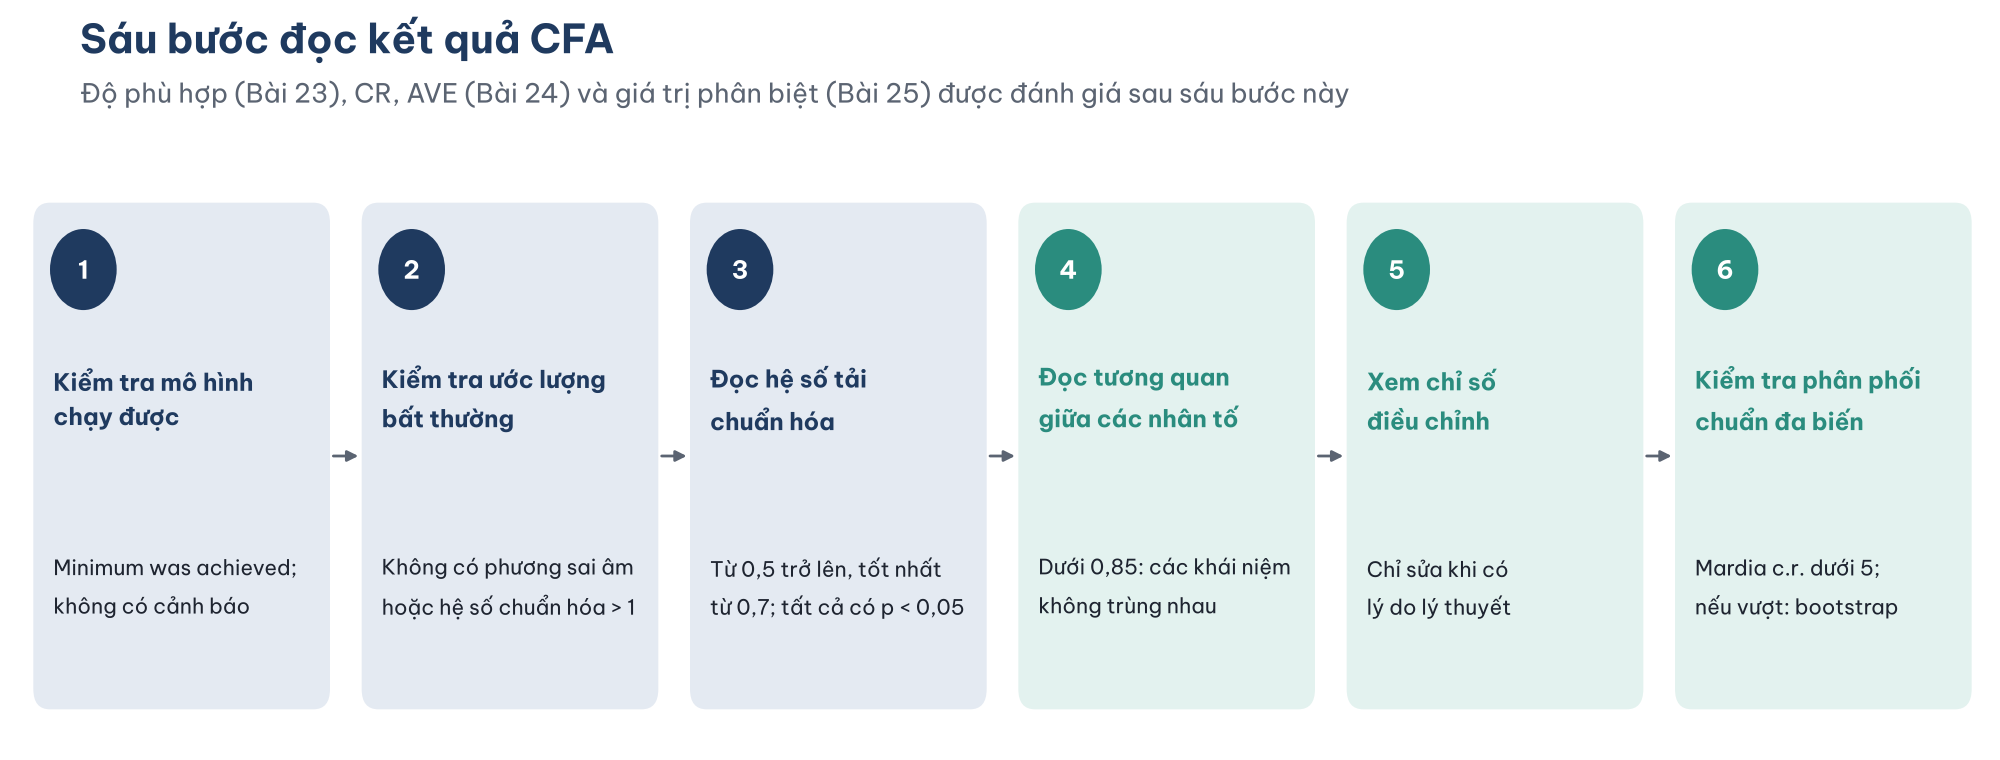
Hình 2. Sáu bước kiểm tra kết quả CFA trước khi đánh giá độ phù hợp, độ tin cậy và giá trị phân biệt.
Bước 1. Kiểm tra mô hình chạy được
Bảng Chi-square test ở khung kết quả bên phải hiện chi bình phương kèm ghi chú The estimator is ML. Nếu lavaan không hội tụ hoặc có ước lượng bất thường, JASP hiện dòng cảnh báo màu đỏ ngay dưới tiêu đề phân tích.
Với dữ liệu mẫu, mô hình chạy bình thường. Chi bình phương = 134,29; df = 160; p = 0,931; CFI = 1,000; RMSEA = 0,000; SRMR = 0,032. Bài chỉ số độ phù hợp của mô hình sẽ phân tích các chỉ số này; ở đây chỉ cần ghi nhận mô hình phù hợp với dữ liệu. Mức phù hợp gần như hoàn hảo là do dữ liệu được giả lập từ đúng cấu trúc này (bài AMOS và CB-SEM).
Trong Notes for Model, dòng Minimum was achieved cho biết AMOS tìm được nghiệm. Nếu thấy The following variances are negative hoặc This solution is not admissible, phải xử lý trước khi đọc tiếp.
Bước 2. Kiểm tra ước lượng bất thường
Hai dấu hiệu cần dò (Kline, 2023):
- Phương sai âm của sai số hoặc nhân tố (trường hợp Heywood).
- Hệ số chuẩn hóa lớn hơn 1 về trị tuyệt đối.
Không có trường hợp nào trong dữ liệu mẫu: phương sai sai số chuẩn hóa nhỏ nhất là 0,28 (HI3).
Bước 3. Đọc hệ số tải chuẩn hóa
Hệ số tải chuẩn hóa được xem trên sơ đồ vẽ lại (Hình 3), trong bảng Factor loadings của JASP (Hình 4) và tóm tắt ở Bảng 5.
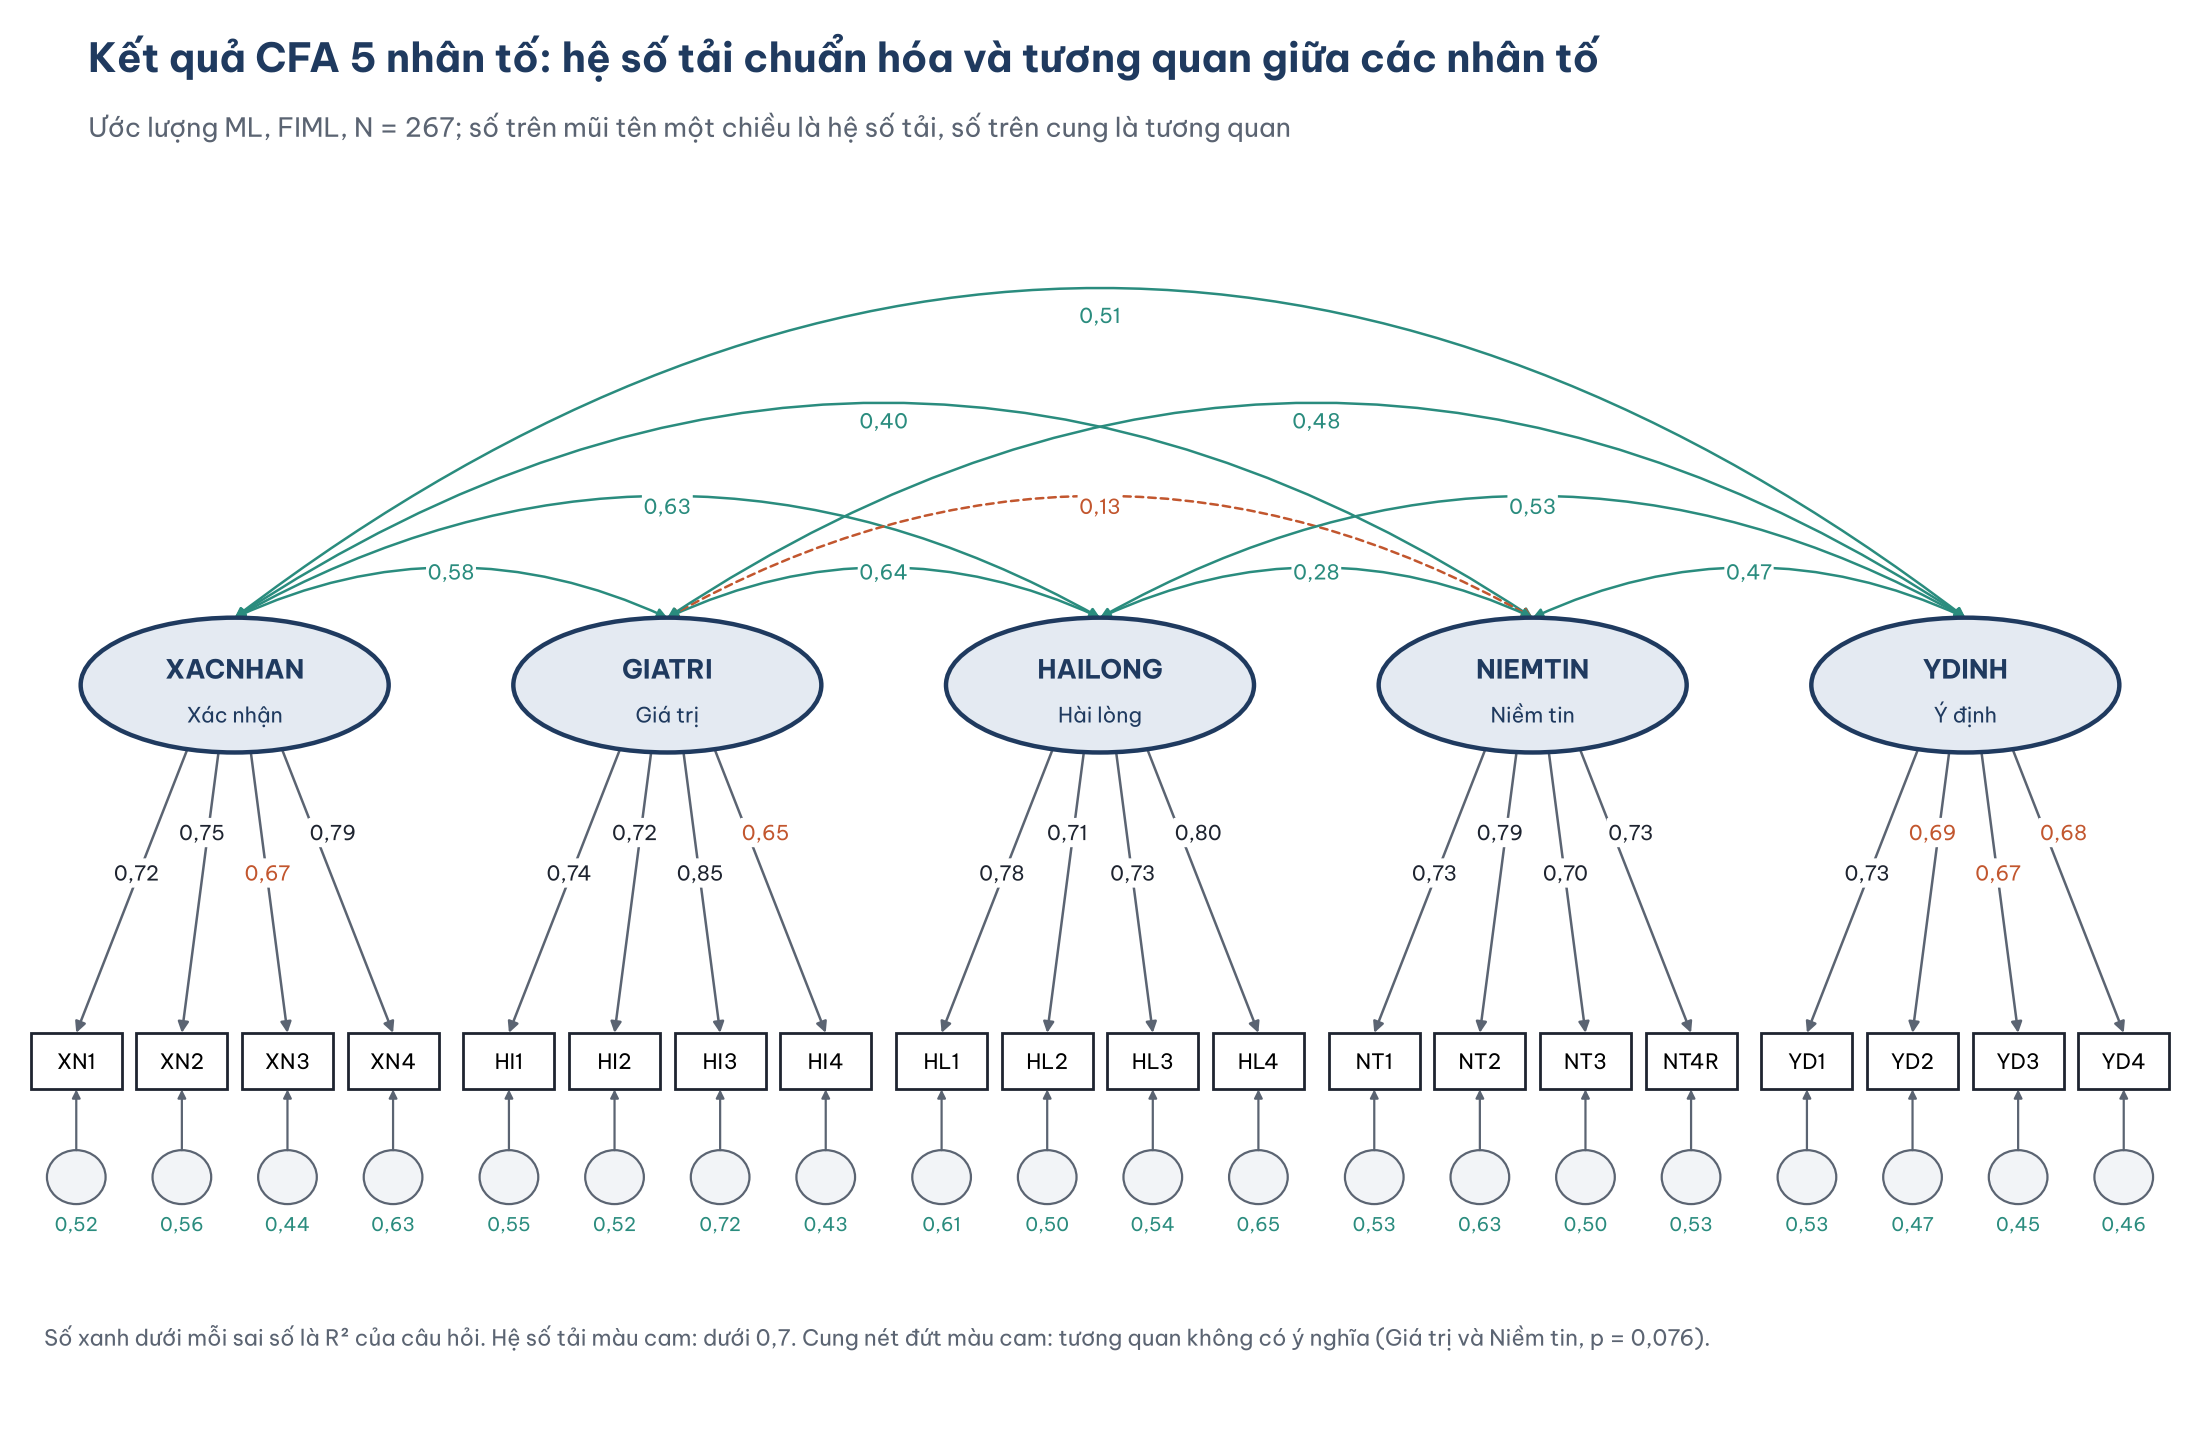
Hình 3. Hệ số tải chuẩn hóa, R² của từng câu hỏi và tương quan giữa năm nhân tố. Sơ đồ vẽ lại từ kết quả để dễ đọc.
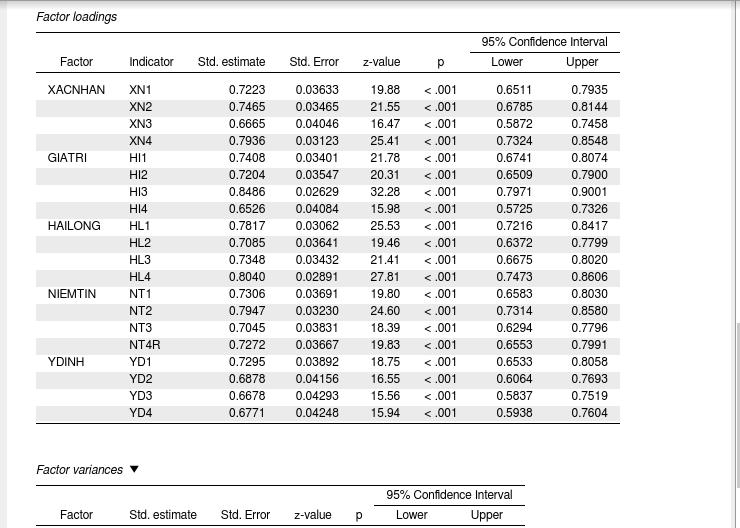
Hình 4. Bảng Factor loadings với Standardization = All: cột Std. estimate là hệ số tải chuẩn hóa.
Bảng 5. Hệ số tải chuẩn hóa và R² của năm nhân tố.
| Nhân tố | Câu hỏi: hệ số tải chuẩn hóa | Khoảng R² |
|---|---|---|
| XACNHAN | XN1 0,72; XN2 0,75; XN3 0,67; XN4 0,79 | 0,44 đến 0,63 |
| GIATRI | HI1 0,74; HI2 0,72; HI3 0,85; HI4 0,65 | 0,43 đến 0,72 |
| HAILONG | HL1 0,78; HL2 0,71; HL3 0,73; HL4 0,80 | 0,50 đến 0,65 |
| NIEMTIN | NT1 0,73; NT2 0,79; NT3 0,70; NT4R 0,73 | 0,50 đến 0,63 |
| YDINH | YD1 0,73; YD2 0,69; YD3 0,67; YD4 0,68 | 0,45 đến 0,53 |
- Mọi hệ số tải có ý nghĩa (p < 0,001; tỷ số tới hạn từ 9,47 đến 13,08 cho các hệ số không cố định).
- Mọi hệ số tải chuẩn hóa từ 0,65 trở lên. Ngưỡng tối thiểu thường dùng là 0,5, mức lý tưởng là từ 0,7 (Hair và cộng sự, 2019). Năm câu nằm trong khoảng 0,65 đến 0,69 (XN3, HI4, YD2, YD3, YD4). Đây là mức chấp nhận được; không loại câu nào chỉ vì hệ số tải dưới 0,7 nếu thang đo vẫn đạt CR và AVE (bài độ tin cậy tổng hợp và phương sai trích) và câu hỏi quan trọng về nội dung.
- R² là bình phương hệ số tải chuẩn hóa: HI3 có 72% phương sai do Giá trị cảm nhận giải thích, HI4 chỉ 43%.
Thứ tự hệ số tải khá giống EFA ở bài phân tích nhân tố khám phá (ví dụ HI3 cao nhất trong thang Giá trị cảm nhận), nhưng giá trị không trùng hẳn: CFA không cho phép câu hỏi tải phụ lên nhân tố khác như EFA.
Bước 4. Đọc tương quan giữa các nhân tố
Tương quan giữa các nhân tố nằm trong bảng Factor Covariances của JASP (Hình 5) và được tóm tắt ở Bảng 6.
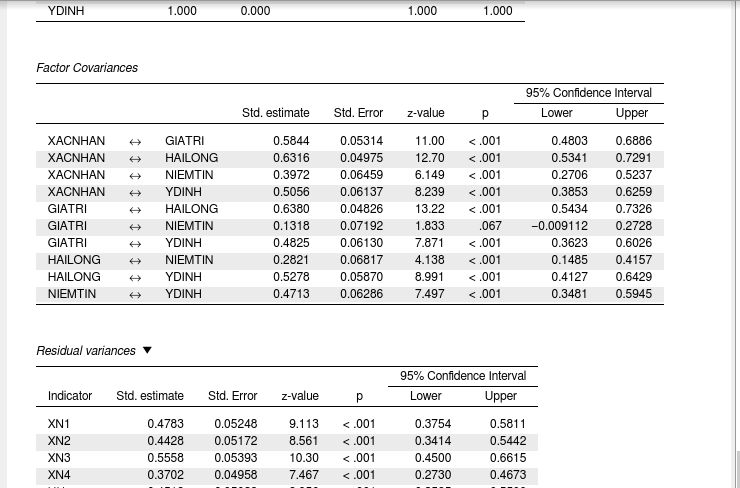
Hình 5. Bảng Factor Covariances; với Standardization = All, cột Std. estimate là tương quan.
Bảng 6. Tương quan giữa năm nhân tố.
| XACNHAN | GIATRI | HAILONG | NIEMTIN | |
|---|---|---|---|---|
| GIATRI | 0,58 | |||
| HAILONG | 0,63 | 0,64 | ||
| NIEMTIN | 0,40 | 0,13 (p = 0,076) | 0,28 | |
| YDINH | 0,51 | 0,48 | 0,53 | 0,47 |
- Tương quan cao nhất là 0,64 (Giá trị cảm nhận và Sự hài lòng), thấp xa ngưỡng 0,85 thường dùng để cảnh báo hai khái niệm trùng nhau (Kline, 2023). Bài giá trị hội tụ và giá trị phân biệt sẽ kiểm tra giá trị phân biệt kỹ hơn bằng Fornell-Larcker và HTMT.
- Giá trị cảm nhận và Niềm tin gần như không tương quan (0,13; p = 0,076), giống kết quả tương quan Pearson trên điểm trung bình ở bài tương quan Pearson (r = 0,12; p = 0,051).
- Các tương quan trong CFA cao hơn tương quan giữa điểm trung bình ở bài tương quan Pearson, vì CFA đã loại sai số đo lường (bài AMOS và CB-SEM).
Bước 5. Xem chỉ số điều chỉnh
JASP liệt kê chỉ số điều chỉnh cho hệ số tải chéo và cho hiệp phương sai giữa các sai số (Hình 6).
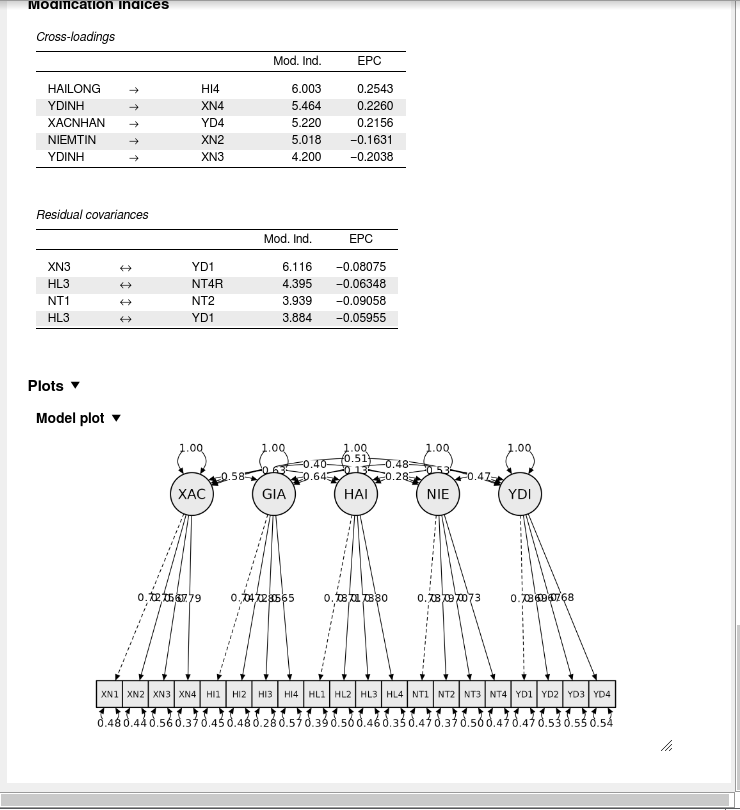
Hình 6. Bảng Modification Indices (Cross-loadings và Residual covariances) và sơ đồ mô hình do JASP vẽ. Với 20 câu hỏi, sơ đồ của JASP khá chật; kéo góc dưới phải để phóng to, hoặc vẽ lại như Hình 3 để đưa vào báo cáo.
Chỉ số điều chỉnh (modification index, MI) ước tính chi bình phương sẽ giảm bao nhiêu nếu giải phóng một tham số đang bị cố định (Brown, 2015). Các MI lớn nhất trên dữ liệu mẫu (Bảng 7):
Bảng 7. Các chỉ số điều chỉnh lớn nhất.
| Tham số đề xuất | MI | Thay đổi kỳ vọng (chuẩn hóa) |
|---|---|---|
| Hiệp phương sai sai số XN3 và YD1 | 6,12 | −0,18 |
| HI4 tải thêm lên HAILONG | 6,00 | 0,19 |
| XN4 tải thêm lên YDINH | 5,46 | 0,16 |
| YD4 tải thêm lên XACNHAN | 5,22 | 0,17 |
| XN2 tải thêm lên NIEMTIN | 5,02 | −0,13 |
Không nên sửa mô hình theo các MI này. Ba lý do:
- MI nhỏ. Giá trị lớn nhất 6,12 chỉ vừa vượt 3,84 (ngưỡng chi bình phương 1 bậc tự do ở mức 0,05). Với 190 tham số có thể giải phóng, vài MI vượt 3,84 do ngẫu nhiên là chuyện bình thường.
- Không có lý do lý thuyết. Không có cơ sở nào để sai số của câu về dịch vụ giao hàng (XN3) tương quan với câu về dự định mua tiếp (YD1).
- Mô hình đã phù hợp tốt. Sửa thêm chỉ làm mô hình khớp với đặc thù của mẫu này, khó lặp lại ở mẫu khác (MacCallum và cộng sự, 1992).
Một kiểm tra bổ sung là phần dư chuẩn hóa (standardized residuals): chỉ 1 trong 190 phần dư vượt 2,58 về trị tuyệt đối (lớn nhất 2,82), cho thấy không có cặp câu hỏi nào bị mô hình tái tạo kém.
Lưu ý: các MI ở bảng trên tính bằng FIML trên 267 người. AMOS chỉ tính MI trên file 254 người trả lời đủ, nên con số trong AMOS sẽ chênh nhẹ nhưng thứ tự và kết luận không đổi.
4. Kiểm định phân phối chuẩn đa biến
Ước lượng ML giả định dữ liệu có phân phối chuẩn đa biến. Khi độ nhọn đa biến cao, chi bình phương bị thổi phồng và sai số chuẩn bị ước lượng thấp, dẫn đến bác bỏ mô hình và tìm thấy ý nghĩa nhiều hơn thực tế (Kline, 2023). Đây là lý do nên kiểm tra phân phối chuẩn ở bước CFA thay vì kiểm định từng câu bằng Shapiro-Wilk.
Phân phối của từng câu hỏi
Bước đầu tiên là xem độ lệch và độ nhọn của từng câu (Hình 7).
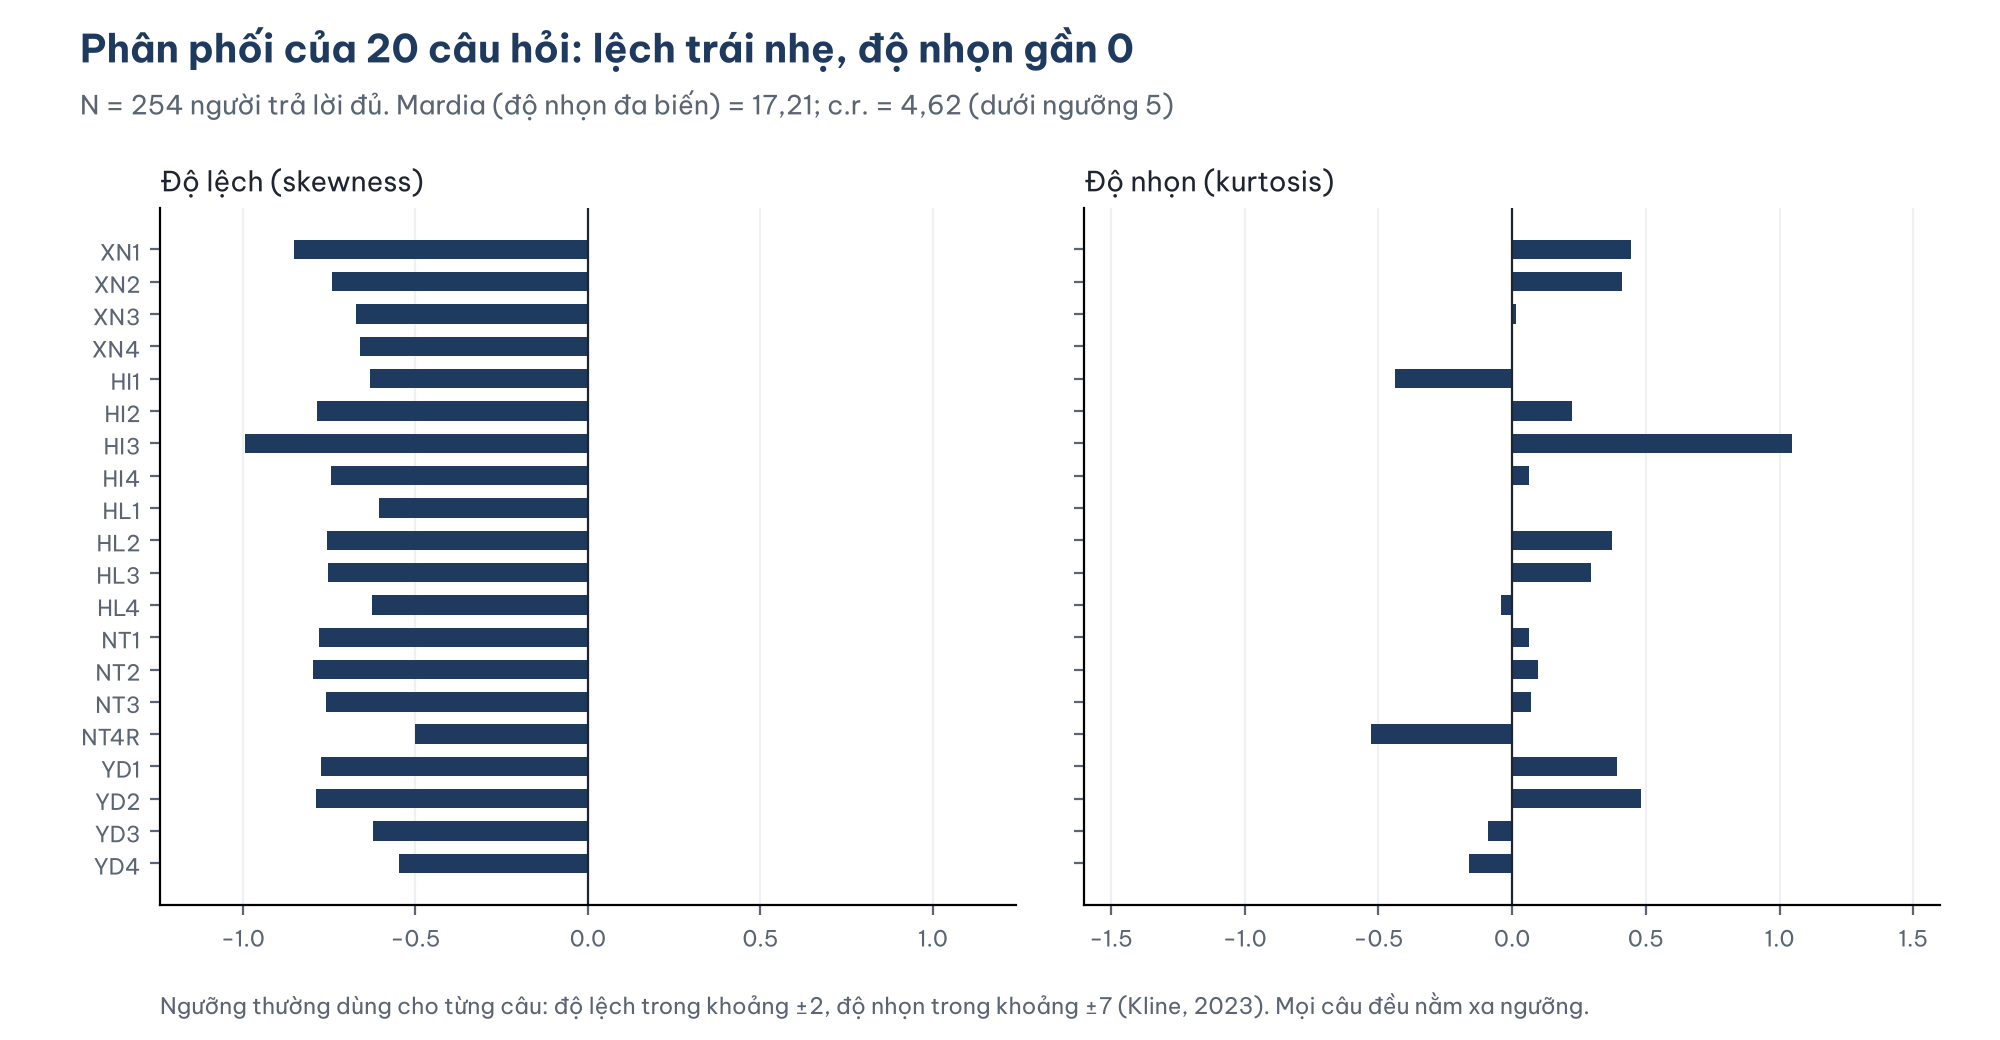
Hình 7. Độ lệch và độ nhọn của từng câu (N = 254 người trả lời đủ).
- Độ lệch từ −0,99 (HI3) đến −0,50 (NT4R): mọi câu lệch trái nhẹ, vì phần lớn người trả lời chọn "Đồng ý". Độ nhọn từ −0,53 đến 1,05.
- Cả hai đều nằm xa ngưỡng thường dùng cho từng biến: |độ lệch| < 2 và |độ nhọn| < 7 (Kline, 2023).
- Tỷ số tới hạn (c.r.) của độ lệch từ −6,46 đến −3,27, đều vượt 1,96. Điều này không có nghĩa là phân phối lệch nghiêm trọng: c.r. bằng độ lệch chia cho sai số chuẩn, mà sai số chuẩn giảm khi mẫu tăng, nên với 254 người, một độ lệch nhỏ cũng cho c.r. lớn. Hãy đọc độ lớn của độ lệch, không đọc c.r. của từng câu.
Hệ số Mardia
Mô-đun Factor của JASP không có kiểm định Mardia. Mô-đun SEM có:
- Bật mô-đun SEM bằng nút dấu cộng ở góc phải thanh công cụ, đánh dấu SEM.
- Chọn SEM > Structural Equation Modeling (Hình 8).
- Gõ mô hình bằng cú pháp lavaan vào ô soạn thảo, nhấn Ctrl+Enter (Hình 9, ô 1):
XACNHAN =~ XN1 + XN2 + XN3 + XN4
GIATRI =~ HI1 + HI2 + HI3 + HI4
HAILONG =~ HL1 + HL2 + HL3 + HL4
NIEMTIN =~ NT1 + NT2 + NT3 + NT4R
YDINH =~ YD1 + YD2 + YD3 + YD4
- Đánh dấu Mardia's coefficient trong mục Output Options (Hình 9, ô 2) (Hình 10).
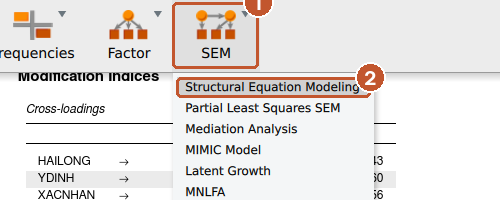
Hình 8. (1) Mô-đun SEM sau khi bật, (2) Structural Equation Modeling.
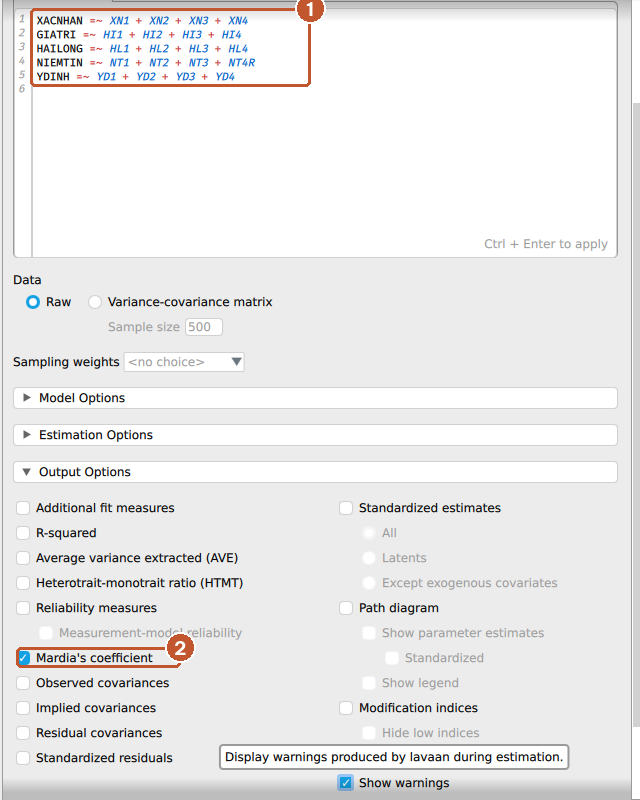
Hình 9. (1) Mô hình CFA viết bằng cú pháp lavaan, (2) tùy chọn Mardia's coefficient.
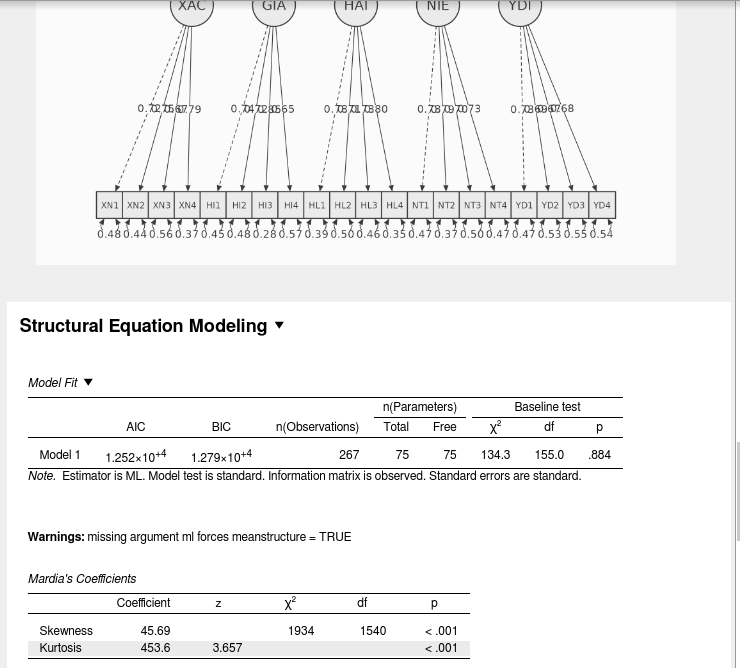
Hình 10. Bảng Mardia's Coefficients: hệ số độ lệch và độ nhọn đa biến.
JASP tính Mardia trên 254 người trả lời đủ: hệ số độ nhọn (Kurtosis) = 453,6, z = 3,66. Con số 453,6 là giá trị b2 của Mardia; giá trị kỳ vọng khi dữ liệu chuẩn là p(p + 2) = 20 × 22 = 440. AMOS báo phần vượt so với 440, nên để so với cách báo cáo quen thuộc trong luận văn dùng AMOS, lấy 453,6 − 440 = 13,6. Tính theo công thức gốc của Mardia (1970), dùng ma trận hiệp phương sai chia cho N thay vì N − 1 như JASP:
Độ nhọn đa biến = 17,21; tỷ số tới hạn = 4,62.
Trong AMOS, hệ số này nằm ở dòng Multivariate cuối bảng Assessment of normality, kèm tỷ số tới hạn.
Bentler (2005) đề xuất coi dữ liệu là không chuẩn đa biến khi tỷ số tới hạn của hệ số Mardia lớn hơn 5. Với 4,62, dữ liệu mẫu nằm dưới ngưỡng, nên ước lượng ML là phù hợp.
Giá trị z = 3,66 của JASP thấp hơn 4,62 vì cách chia mẫu số khác nhau như trên; cả hai đều dưới 5. Bảng của JASP còn có kiểm định độ lệch đa biến (Skewness: chi bình phương = 1934; df = 1540; p < 0,001). Kiểm định này rất nhạy với cỡ mẫu và với độ lệch đồng hướng của thang Likert. Ước lượng ML nhạy với độ nhọn hơn độ lệch, nên quy tắc của Bentler dựa trên độ nhọn (Kline, 2023). Dù vậy, độ lệch có ý nghĩa là một lý do để kiểm tra lại bằng bootstrap Bollen-Stine ở dưới.
Lưu ý thêm: bảng Model Fit của mô-đun SEM ghi df = 155 thay vì 160. Khi dùng FIML, mô-đun SEM của JASP 0.99.0 ước lượng thêm trung bình của năm nhân tố (bảng Intercepts cho thấy các giá trị này xấp xỉ 0); chi bình phương không đổi. Vì vậy bài dùng mô-đun Factor cho kết quả CFA chính thức, còn mô-đun SEM chỉ để lấy hệ số Mardia.
Ngoại lai đa biến
Khoảng cách Mahalanobis (d²) đo mức "xa tâm" của từng người trên cả 20 câu cùng lúc. Năm người xa tâm nhất có d² từ 38,65 đến 43,53 (ID 112, 189, 82, 267, 135), tương ứng p từ 0,002 đến 0,007. Không ai có p < 0,001, ngưỡng thường dùng để coi là ngoại lai đa biến (Tabachnick & Fidell, 2019), khớp với kết luận của bài làm sạch dữ liệu.
Trong AMOS, kết quả này nằm ở mục Observations farthest from the centroid (Mahalanobis distance), có thêm cột p2: xác suất để quan sát xa tâm thứ k có d² lớn như vậy nếu dữ liệu chuẩn. p2 nhỏ ở những dòng đầu là dấu hiệu cần chú ý.
Bootstrap Bollen-Stine
Khi tỷ số tới hạn của Mardia vượt 5, có thể giữ ước lượng ML nhưng thay giá trị p của chi bình phương bằng p bootstrap Bollen-Stine (Bollen & Stine, 1992). Phương pháp này biến đổi dữ liệu để mô hình đúng hoàn toàn, rút 2000 mẫu lặp, rồi đếm tỷ lệ mẫu có chi bình phương lớn hơn giá trị thực.
Dù dữ liệu mẫu không cần đến, bài vẫn chạy để minh họa: trên 254 người trả lời đủ, chi bình phương = 137,05, p Bollen-Stine = 0,922 (2000 mẫu), gần với p = 0,931 của kiểm định thông thường. Kết luận về độ phù hợp không thay đổi.
JASP 0.99.0 không có tùy chọn Bollen-Stine trong giao diện; file cfa_5_nhan_to.R đi kèm tính trực tiếp bằng lavaan. Trong AMOS, vào Analysis Properties > Bootstrap, đánh dấu Perform bootstrap (2000 mẫu) và Bollen-Stine bootstrap; kết quả nằm ở mục Model Fit của Text Output, dòng Bollen-Stine bootstrap. Chức năng này chỉ chạy với file trả lời đủ.
5. Trình bày kết quả CFA trong luận văn
Phân tích nhân tố khẳng định với ước lượng hợp lý cực đại và FIML cho dữ liệu thiếu (N = 267) cho thấy mô hình đo lường năm nhân tố phù hợp với dữ liệu, chi bình phương = 134,29; df = 160; p = 0,931; CFI = 1,000; TLI = 1,014; RMSEA = 0,000 (KTC 90% [0,000; 0,008]); SRMR = 0,032. Mọi hệ số tải chuẩn hóa có ý nghĩa thống kê (p < 0,001) và nằm trong khoảng 0,65 đến 0,85. Tương quan giữa các nhân tố từ 0,13 đến 0,64. Hệ số Mardia của độ nhọn đa biến bằng 17,21 (c.r. = 4,62), dưới ngưỡng 5 của Bentler (2005); p bootstrap Bollen-Stine bằng 0,922 (2000 mẫu), cùng kết luận với kiểm định chi bình phương thông thường.
Nên kèm theo bảng hệ số tải chuẩn hóa (mục 3, bước 3) và bảng tương quan giữa các nhân tố (bước 4). CR, AVE và giá trị phân biệt sẽ được bổ sung vào cùng bảng sau hai bài về độ tin cậy tổng hợp, phương sai trích và giá trị phân biệt.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chạy và đọc kết quả CFA trong luận văn.
- Quên vẽ hiệp phương sai giữa các nhân tố. Mô hình trở thành năm nhân tố độc lập, độ phù hợp rất kém và hệ số tải sai.
- Đưa một câu vào hai nhân tố do kéo nhầm. Kiểm tra lại từng nhóm câu trước khi chạy.
- Loại câu chỉ vì hệ số tải dưới 0,7 mà không xét CR, AVE và nội dung thang đo.
- Thêm hiệp phương sai sai số theo MI cho đến khi chỉ số "đẹp". Mỗi sửa đổi cần lý do lý thuyết và phải báo cáo.
- Đọc tỷ số tới hạn của độ lệch từng câu và kết luận dữ liệu không chuẩn. Với mẫu vài trăm người, hãy đọc độ lớn của độ lệch, độ nhọn và hệ số Mardia.
Tài liệu tham khảo
Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
Bentler, P. M. (2005). EQS 6 structural equations program manual. Multivariate Software. https://mvsoft.com/
Bollen, K. A., & Stine, R. A. (1992). Bootstrapping goodness-of-fit measures in structural equation models. Sociological Methods & Research, 21(2), 205–229. https://doi.org/10.1177/0049124192021002004
Brown, T. A. (2015). Confirmatory factor analysis for applied research (2nd ed.). Guilford Press. https://www.guilford.com/books/Confirmatory-Factor-Analysis-for-Applied-Research/Timothy-Brown/9781462515363
Byrne, B. M. (2016). Structural equation modeling with AMOS: Basic concepts, applications, and programming (3rd ed.). Routledge. https://www.routledge.com/Structural-Equation-Modeling-With-AMOS-Basic-Concepts-Applications-and/Byrne/p/book/9781138797031
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning. https://www.cengage.co.in/book-list/print/multivariate-data-analysis-8e-2t
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003097