
PHƯƠNG SAI PHƯƠNG PHÁP CHUNG TRONG DỮ LIỆU KHẢO SÁT
Kiểm định Harman, mô hình một nhân tố và nhân tố phương pháp chung CLF trong JASP, AMOS và cách diễn giải
Bài nên đọc trước
Trong đề tài sàn X, mỗi người trả lời cả 20 câu hỏi về xác nhận kỳ vọng, giá trị, hài lòng, niềm tin và ý định mua lại, trong cùng một lần khảo sát, trên cùng một thang Likert 5 mức. Người phản biện sẽ hỏi: tương quan giữa các khái niệm có bị phóng đại chỉ vì chúng được đo theo cùng một cách không? Đó là câu hỏi về phương sai phương pháp chung (common method variance) và sai lệch do phương pháp chung (common method bias, CMB).
Bài này hướng dẫn hai kiểm tra phổ biến nhất trong luận văn: kiểm định một nhân tố của Harman và nhân tố phương pháp chung (common latent factor, CLF). Quan trọng không kém: bài chỉ ra mỗi kiểm tra nói được gì và không nói được gì, bằng kết quả thật trên dữ liệu mẫu.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026). Các con số được đối chiếu bằng PSPP (Free Software Foundation, 2023) với file harman.sps và gói lavaan của R (Rosseel, 2012), file cmb.R. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
30-phuong-sai-phuong-phap-chung-cmbcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Phương sai phương pháp chung là gì?
Mỗi điểm số trả lời gồm ba phần: phần do khái niệm cần đo, phần do cách đo và sai số ngẫu nhiên. Khi hai khái niệm được đo bằng cùng một cách, phần do cách đo của chúng có thể tương quan với nhau và cộng thêm vào tương quan giữa hai khái niệm (Podsakoff và cộng sự, 2003) (Hình 1).
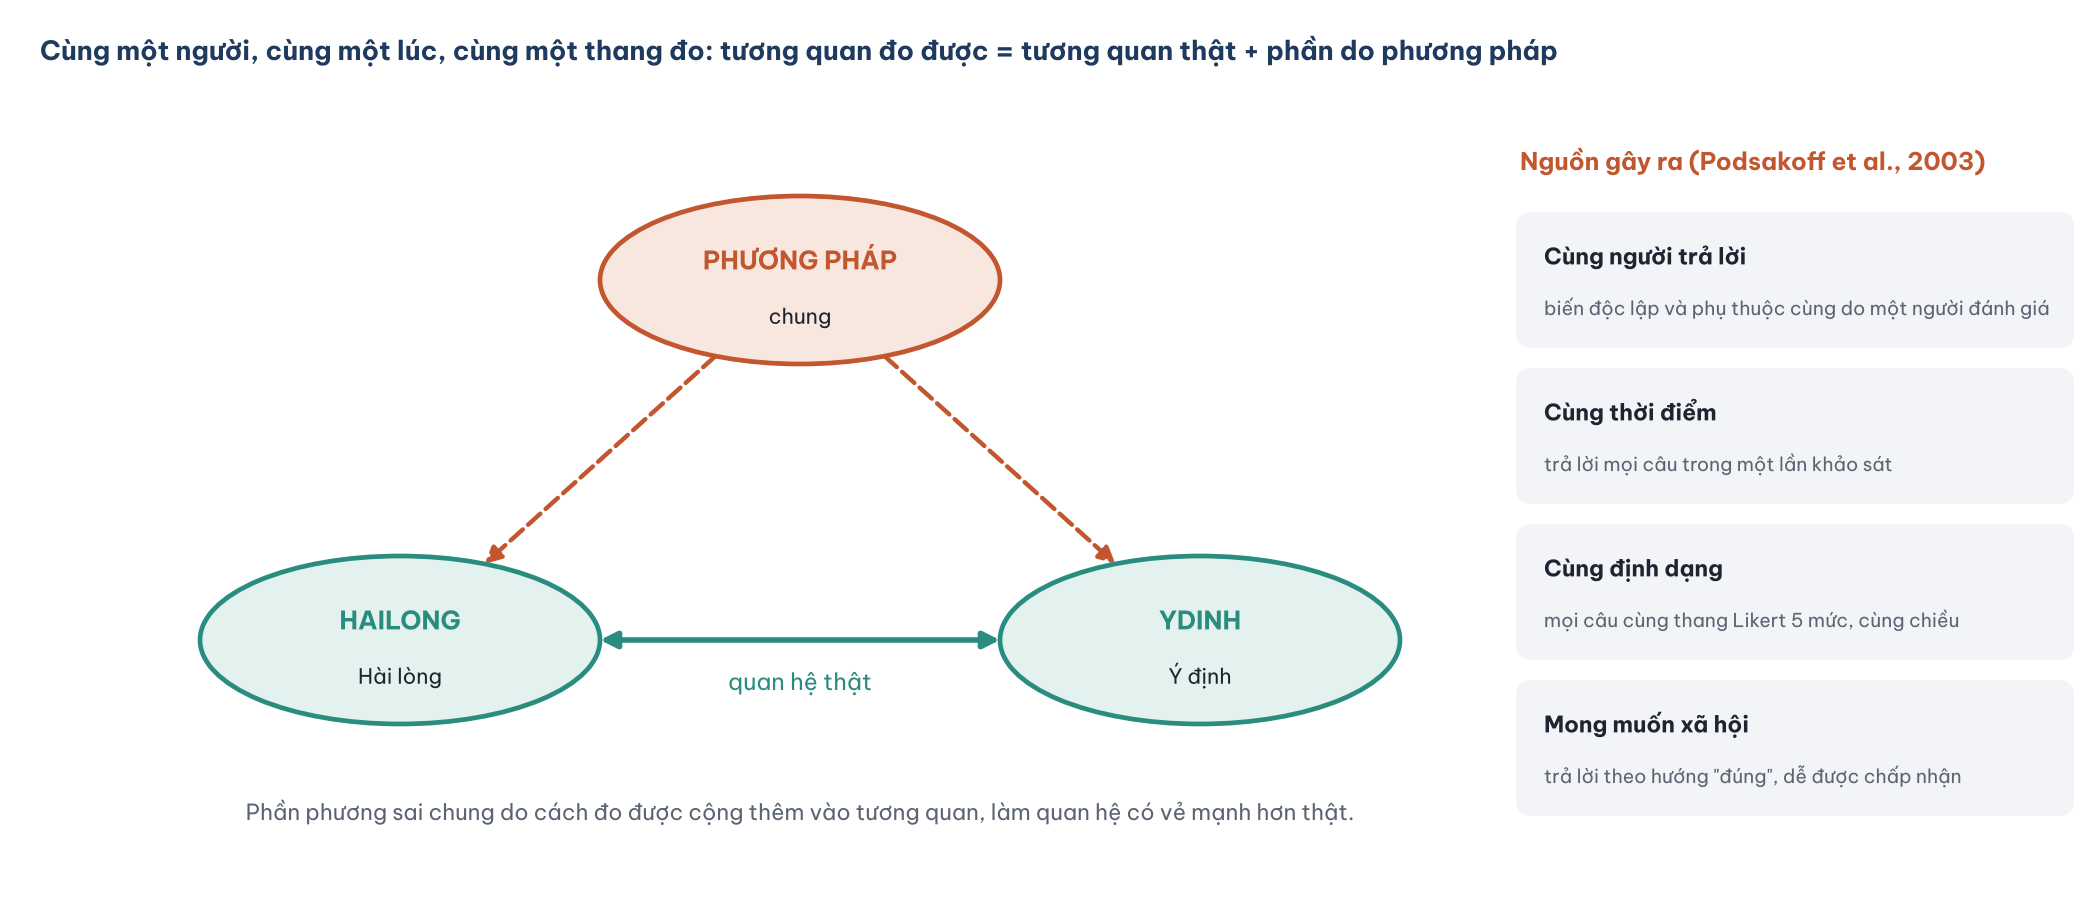
Hình 1. Phương sai phương pháp chung cộng thêm vào tương quan thật giữa hai khái niệm.
Phương sai phương pháp không phải lúc nào cũng làm phồng hệ số: nó cũng có thể làm giảm hệ số khi có nhiều biến độc lập (Podsakoff và cộng sự, 2012). Nó cũng không chắc chắn xảy ra chỉ vì dùng bảng hỏi tự đánh giá. Vì vậy, câu hỏi đúng là: có bằng chứng phương sai phương pháp đủ lớn để thay đổi kết luận không?
Phòng ngừa quan trọng hơn kiểm định. Cách tốt nhất là thiết kế bảng hỏi để giảm nguy cơ ngay từ đầu (Podsakoff và cộng sự, 2012):
- Tách biến độc lập và biến phụ thuộc: khác thời điểm, khác nguồn (ví dụ ý định mua lại lấy từ dữ liệu mua hàng thật), hoặc ít nhất khác phần của bảng hỏi.
- Dùng định dạng thang đo khác nhau cho một số khái niệm.
- Đảm bảo ẩn danh và nói rõ không có câu trả lời đúng sai, để giảm trả lời theo mong muốn xã hội.
- Viết câu hỏi rõ, ngắn, không dẫn dắt; xen câu đảo chiều như NT4 (bài tính biến đại diện).
Các kiểm định bên dưới là kiểm tra sau khi đã thu dữ liệu. Chúng chỉ bổ sung, không thay thế phòng ngừa.
2. Kiểm định một nhân tố của Harman
Ý tưởng (Harman, 1976; Podsakoff và cộng sự, 2003): nếu phương sai phương pháp chiếm ưu thế, đưa toàn bộ câu hỏi vào phân tích nhân tố không xoay sẽ cho một nhân tố duy nhất, hoặc một nhân tố giải thích phần lớn phương sai. Ngưỡng hay dùng trong luận văn là nhân tố đầu tiên giải thích dưới 50% phương sai.
Có hai cách trích, cho con số khác nhau (Bảng 1):
Bảng 1. Hai cách trích nhân tố trong kiểm định Harman.
| Cách trích | Tỷ lệ nhân tố đầu tiên | Ghi chú |
|---|---|---|
| Thành phần chính (PCA), giá trị riêng lớn hơn 1 | 33,9% | Mặc định của SPSS; con số hay gặp nhất |
| Trục chính (PAF), ép trích 1 nhân tố | 30,6% | Chỉ tính phần phương sai chung, nhỏ hơn PCA |
254 người trả lời đủ 20 câu.
Báo cáo rõ cách nào đã dùng. Kết luận của hai cách ở đây giống nhau.
Thao tác trong JASP
Trong JASP, kiểm định Harman chạy bằng phân tích nhân tố khám phá ép trích một nhân tố.
- Mở
du_lieu_amos.sav, chọn Factor > Exploratory Factor Analysis. - Đưa 20 câu hỏi của mô hình (XN1 đến YD4, dùng NT4R thay cho NT4) vào ô Variables.
- Chọn Number of Factors > Manual, Number of factors = 1 (Hình 2, ô 1).
- Chọn Rotation Method > Orthogonal và none (ô 2). Mặc định của JASP là Oblique / promax.
- Chọn Factoring Method = Principal axis factoring (ô 3).
- Mở Output Options: kéo Display loadings above về 0 để hiện mọi hệ số tải, chọn Missing Values > Exclude cases listwise, đánh dấu Scree plot.
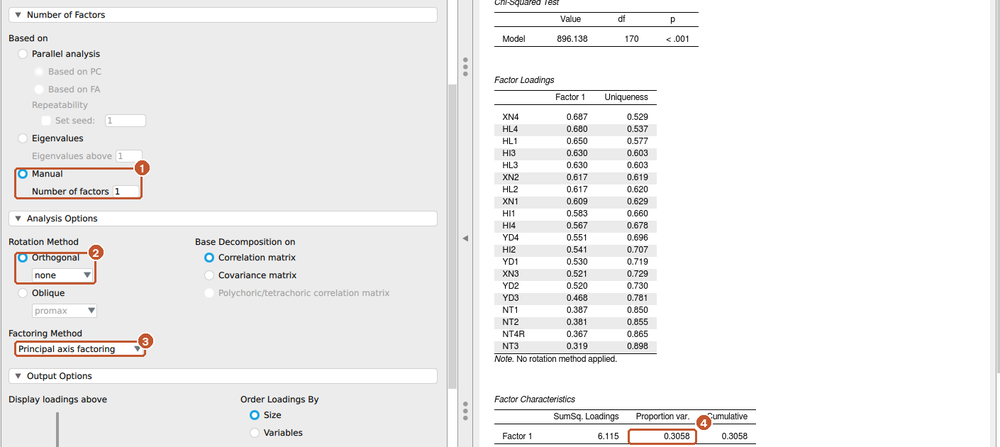
Hình 2. (1) Ép trích 1 nhân tố, (2) không xoay, (3) trục chính, (4) tỷ lệ phương sai của nhân tố: 0,3058, tức 30,6%.
JASP không in bảng giá trị riêng của mọi thành phần như SPSS. Biểu đồ scree (Hình 3) cho thấy giá trị riêng đầu tiên khoảng 6,8, tức 6,8 / 20 = 33,9% (cách PCA). Muốn bảng đầy đủ, dùng Factor > Principal Component Analysis hoặc file harman.sps trên PSPP (Hình 4).
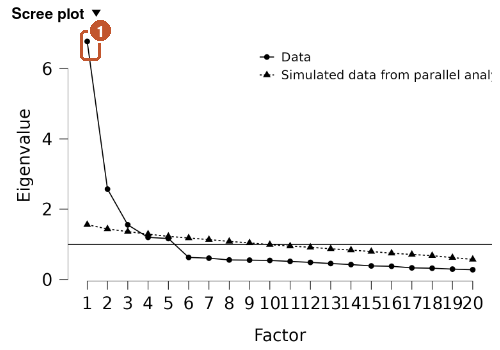
Hình 3. (1) Giá trị riêng đầu tiên khoảng 6,8; năm giá trị riêng đầu nằm trên đường song song (parallel analysis).
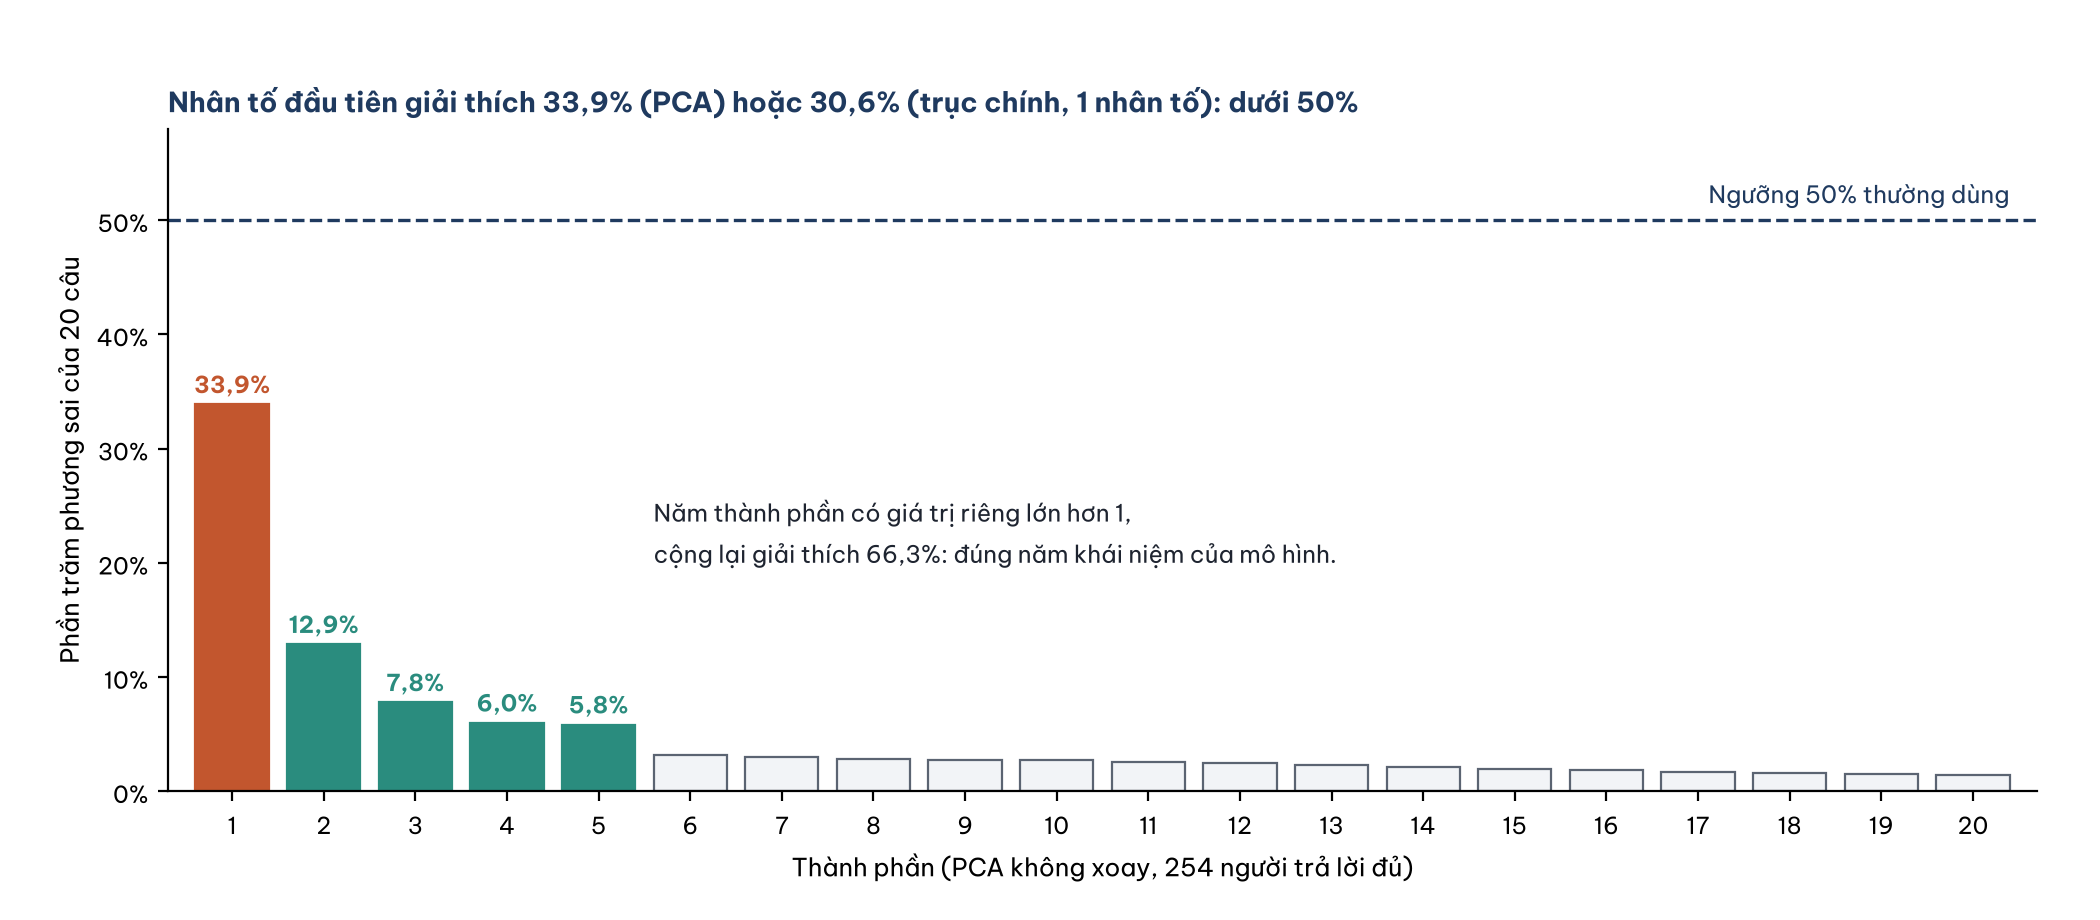
Hình 4. Phần trăm phương sai của 20 thành phần chính, không xoay.
Đọc kết quả. Nhân tố đầu tiên giải thích 33,9% (PCA) hoặc 30,6% (trục chính), dưới ngưỡng 50%. Năm thành phần có giá trị riêng lớn hơn 1, đúng bằng số khái niệm của mô hình. Không có dấu hiệu một nhân tố chung chi phối dữ liệu.
Giới hạn. Podsakoff và cộng sự (2003), chính nhóm tác giả hay được trích khi nói về kiểm định này, đánh giá nó là kiểm định yếu:
- Kiểm định chỉ phát hiện được phương sai phương pháp khi nó cực lớn, đủ để gom 20 câu thành một nhân tố. Phương sai phương pháp vừa phải vẫn có thể làm lệch hệ số mà không bị phát hiện.
- Ngưỡng 50% là quy ước, không có cơ sở lý thuyết chặt chẽ. Fuller và cộng sự (2016) cho thấy phương sai phương pháp chỉ làm lệch hệ số đáng kể khi nó rất lớn và ở mức đó kiểm định Harman thường phát hiện được. Vì vậy kiểm định không vô dụng, nhưng chỉ bắt được trường hợp nặng.
- Nhân tố đầu tiên lớn cũng có thể do các khái niệm thật sự tương quan mạnh với nhau (ở đây XACNHAN, GIATRI và HAILONG tương quan 0,58 đến 0,64), không phải do phương pháp.
Kết luận đúng mực: "kiểm định Harman không cho thấy một nhân tố chung chi phối", không phải "dữ liệu không có CMB".
Thao tác trong SPSS
Nếu dùng SPSS thay cho JASP, kiểm định Harman chạy bằng menu Factor hoặc bằng cú pháp.
- Mở
du_lieu_amos.sav, chọn Analyze > Dimension Reduction > Factor. - Đưa 20 câu hỏi của mô hình (XN1 đến YD4, dùng NT4R thay cho NT4) vào ô Variables.
- Bấm Extraction: chọn Method = Principal axis factoring, Fixed number of factors = 1, bấm Continue.
- Bấm Rotation: chọn None, bấm Continue.
- Bấm Options: chọn Exclude cases listwise. Bấm OK.
- Đọc bảng Total Variance Explained, cột Extraction Sums of Squared Loadings, ô % of Variance: 30,6%. Cột Initial Eigenvalues cho 33,9% ở dòng 1, là con số của PCA.
Cú pháp tương đương (có trong harman.sps):
FACTOR /VARIABLES=XN1 XN2 XN3 XN4 HI1 HI2 HI3 HI4 HL1 HL2 HL3 HL4
    NT1 NT2 NT3 NT4R YD1 YD2 YD3 YD4
  /MISSING=LISTWISE
  /EXTRACTION=PAF
  /CRITERIA=FACTORS(1) ITERATE(100)
  /ROTATION=NOROTATE
  /PRINT=INITIAL EXTRACTION.
3. Harman dạng CFA: mô hình một nhân tố
Một cách chặt hơn là so sánh hai mô hình CFA: tất cả 20 câu tải lên một nhân tố, so với mô hình năm nhân tố của bài phân tích nhân tố khẳng định (CFA). Nếu phương sai phương pháp chiếm ưu thế, mô hình một nhân tố sẽ phù hợp gần bằng mô hình năm nhân tố.
Trong JASP, mở SEM > Structural Equation Modeling và dùng nhiều thẻ mô hình (Model 1, Model 2, Model 3, thêm bằng nút dấu cộng xanh). JASP tự so sánh các mô hình trong cùng bảng Model Fit.
- Model 1 (năm nhân tố): cú pháp CFA của bài phân tích nhân tố khẳng định (CFA), thêm dòng
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1. - Model 2 (một nhân tố):
CHUNG =~ XN1 + XN2 + XN3 + XN4 + HI1 + HI2 + HI3 + HI4 + HL1 + HL2 + HL3 + HL4 + NT1 + NT2 + NT3 + NT4R + YD1 + YD2 + YD3 + YD4
CHUNG ~ 0*1
Kết quả của hai mô hình được trình bày ở Bảng 2.
Bảng 2. Độ phù hợp của mô hình một nhân tố và năm nhân tố.
| Mô hình | Chi bình phương (df) | CFI | RMSEA | SRMR |
|---|---|---|---|---|
| Một nhân tố | 935,06 (170) | 0,638 | 0,130 | 0,109 |
| Năm nhân tố (bài phân tích nhân tố khẳng định (CFA)) | 134,29 (160) | 1,000 | 0,000 | 0,032 |
FIML, N = 267. Chênh lệch chi bình phương = 800,8; df = 10; p < 0,001 (Hình 7, ô 2).
Mô hình một nhân tố phù hợp rất kém (CFI khoảng 0,63), xấu hơn mô hình năm nhân tố một cách có ý nghĩa. Một nhân tố chung không giải thích được dữ liệu. Giới hạn của cách này giống kiểm định Harman: nó chỉ loại trừ trường hợp phương sai phương pháp chiếm toàn bộ.
Trong AMOS: lưu bản sao file CFA của bài phân tích nhân tố khẳng định (CFA), xóa năm hình elip, vẽ một hình elip đặt tên CHUNG, vẽ mũi tên từ CHUNG đến cả 20 câu hỏi, cố định hệ số tải đầu tiên bằng 1, chạy Calculate Estimates và đọc Model Fit. Kết quả FIML trên 267 người: chi bình phương 935,06 (170), CFI 0,638, RMSEA 0,130.
4. Nhân tố phương pháp chung (CLF)
CLF đi thêm một bước: giữ nguyên mô hình năm nhân tố và thêm một nhân tố tải lên cả 20 câu hỏi (Podsakoff và cộng sự, 2003; Williams và cộng sự, 1989). Nhân tố này đại diện cho phần phương sai mà mọi câu dùng chung, ngoài phần do năm khái niệm (Hình 5).
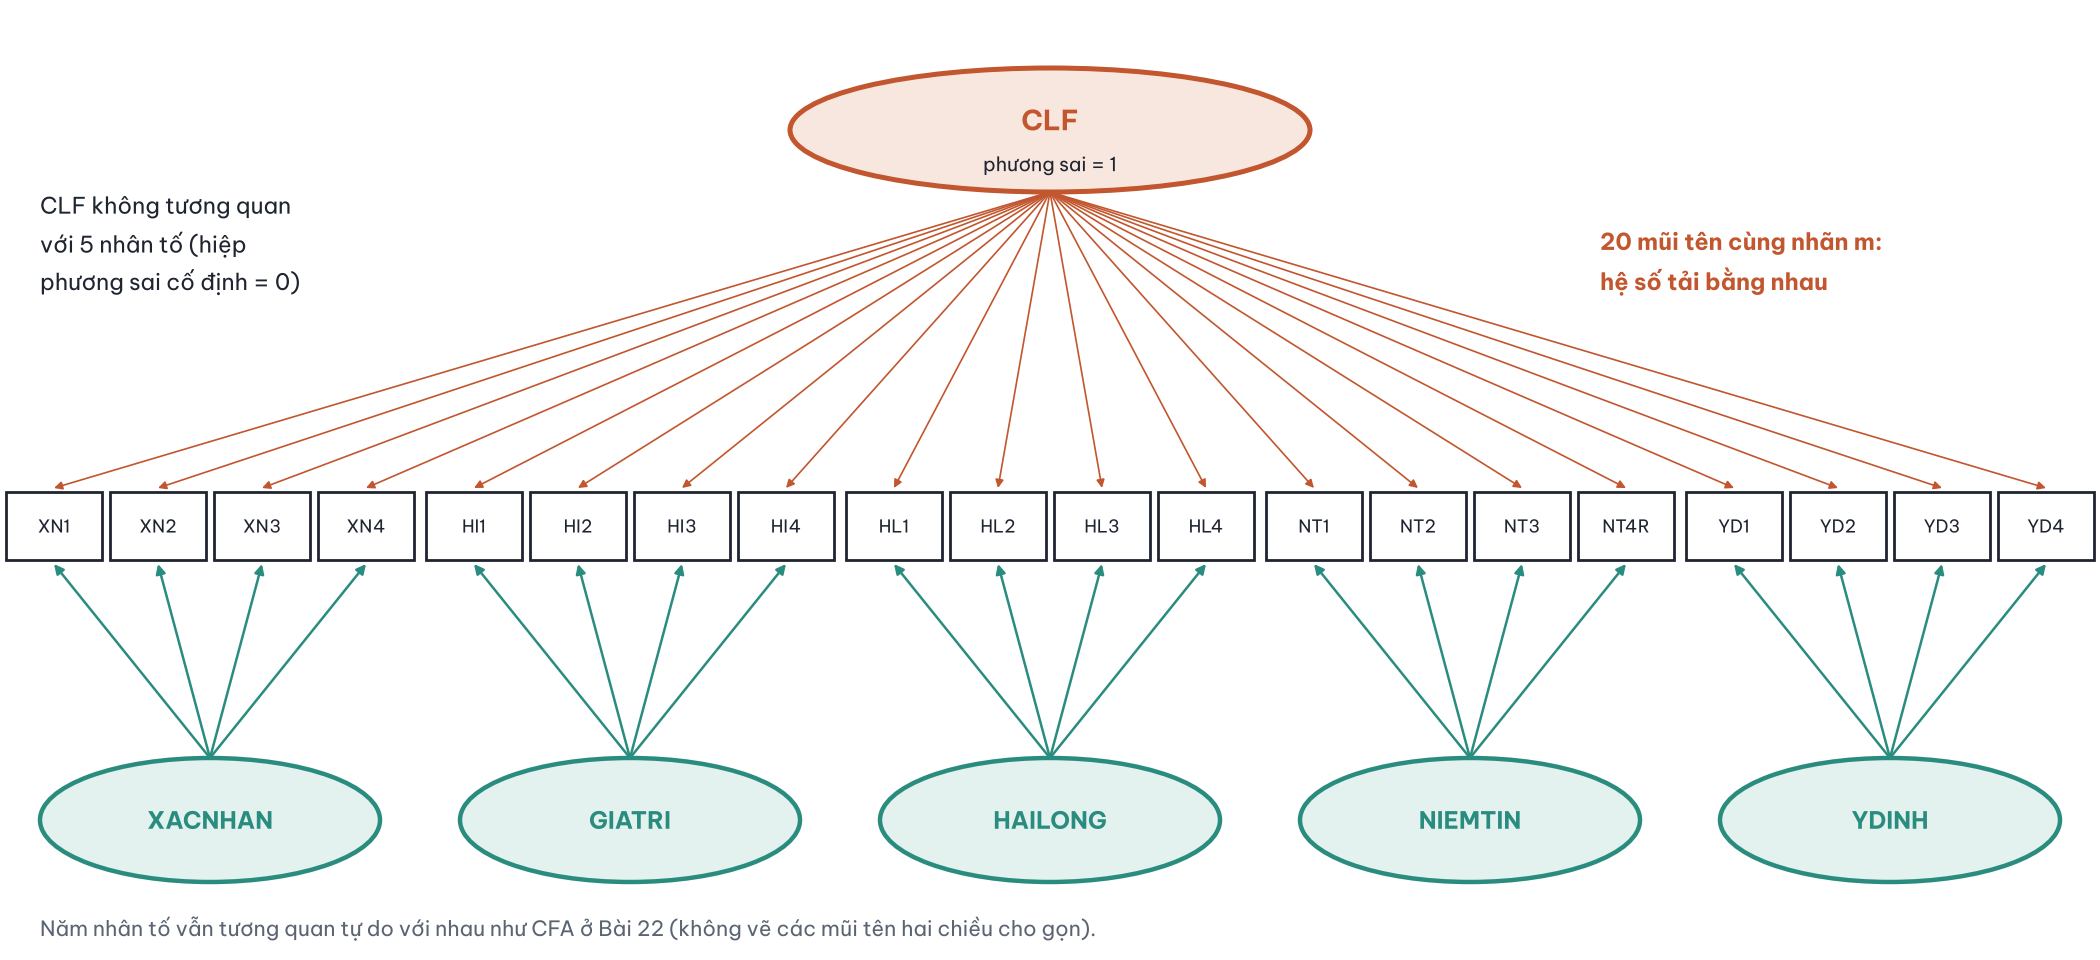
Hình 5. Mô hình CFA năm nhân tố có thêm nhân tố phương pháp chung (CLF).
Ba ràng buộc để mô hình ước lượng được:
- CLF không tương quan với năm nhân tố (hiệp phương sai bằng 0). Nếu cho tương quan, mô hình không xác định được phần nào là khái niệm, phần nào là phương pháp.
- Phương sai CLF bằng 1 để cố định thang đo.
- Hệ số tải lên CLF bằng nhau cho cả 20 câu (cùng nhãn m). Bản để tự do 20 hệ số tải không hội tụ trên dữ liệu sàn X: 20 hệ số tải phương pháp cộng 20 hệ số tải khái niệm cho mỗi câu là quá nhiều để dữ liệu phân biệt được. Ràng buộc bằng nhau là cách xử lý thường dùng và giả định phương pháp ảnh hưởng mọi câu như nhau.
Thao tác trong JASP
Model 3 (năm nhân tố cộng CLF):
XACNHAN =~ XN1 + XN2 + XN3 + XN4
GIATRI  =~ HI1 + HI2 + HI3 + HI4
HAILONG =~ HL1 + HL2 + HL3 + HL4
NIEMTIN =~ NT1 + NT2 + NT3 + NT4R
YDINH   =~ YD1 + YD2 + YD3 + YD4
CLF =~ NA*XN1 + m*XN1 + m*XN2 + m*XN3 + m*XN4 + m*HI1 + m*HI2 + m*HI3 + m*HI4 + m*HL1 + m*HL2 + m*HL3 + m*HL4 + m*NT1 + m*NT2 + m*NT3 + m*NT4R + m*YD1 + m*YD2 + m*YD3 + m*YD4
CLF ~~ 1*CLF
CLF ~~ 0*XACNHAN + 0*GIATRI + 0*HAILONG + 0*NIEMTIN + 0*YDINH
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH + CLF ~ 0*1
NA*XN1 bỏ quy tắc mặc định cố định hệ số tải đầu tiên bằng 1, để cả 20 hệ số tải dùng chung nhãn m và được ước lượng tự do; thang đo của CLF được cố định bằng CLF ~~ 1*CLF (Hình 6).
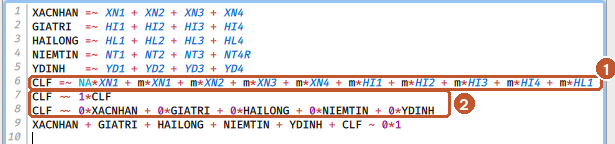
Hình 6. (1) CLF tải lên 20 câu với cùng nhãn m, (2) phương sai CLF bằng 1 và không tương quan với năm nhân tố.
Bấm Ctrl + Enter. Bảng Model Fit tự xếp mô hình theo bậc tự do và so sánh từng mô hình với mô hình liền trước (Hình 7).
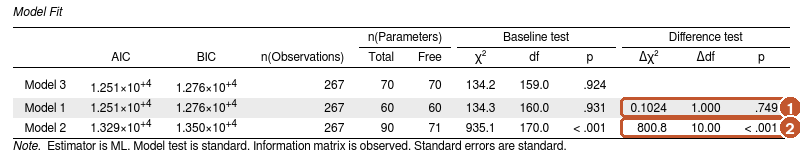
Hình 7. (1) Model 1 (năm nhân tố) so với Model 3 (có CLF): chênh lệch chi bình phương 0,10 với 1 bậc tự do, p = 0,749; (2) Model 2 (một nhân tố) so với Model 1: 800,8 với 10 bậc tự do.
Đánh dấu Output Options > Additional fit measures để có CFI, RMSEA, SRMR của cả ba mô hình (Hình 8) và Standardized estimates để có hệ số tải chuẩn hóa (Hình 9).
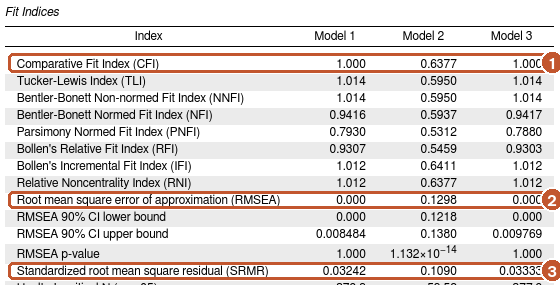
Hình 8. (1) CFI, (2) RMSEA, (3) SRMR của Model 1 (năm nhân tố), Model 2 (một nhân tố) và Model 3 (có CLF).
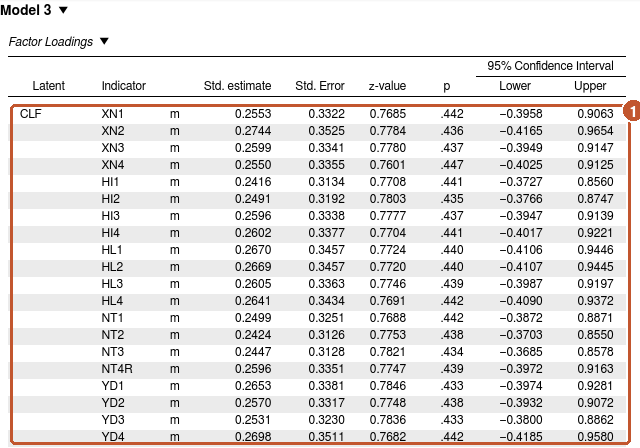
Hình 9. (1) Hệ số tải chuẩn hóa của 20 câu lên CLF: 0,24 đến 0,27, không có ý nghĩa (p khoảng 0,44).
Thao tác trong AMOS
Nếu bạn dùng AMOS thay cho JASP, nhân tố phương pháp chung được vẽ thêm trên bản sao sơ đồ CFA (Hình 10).
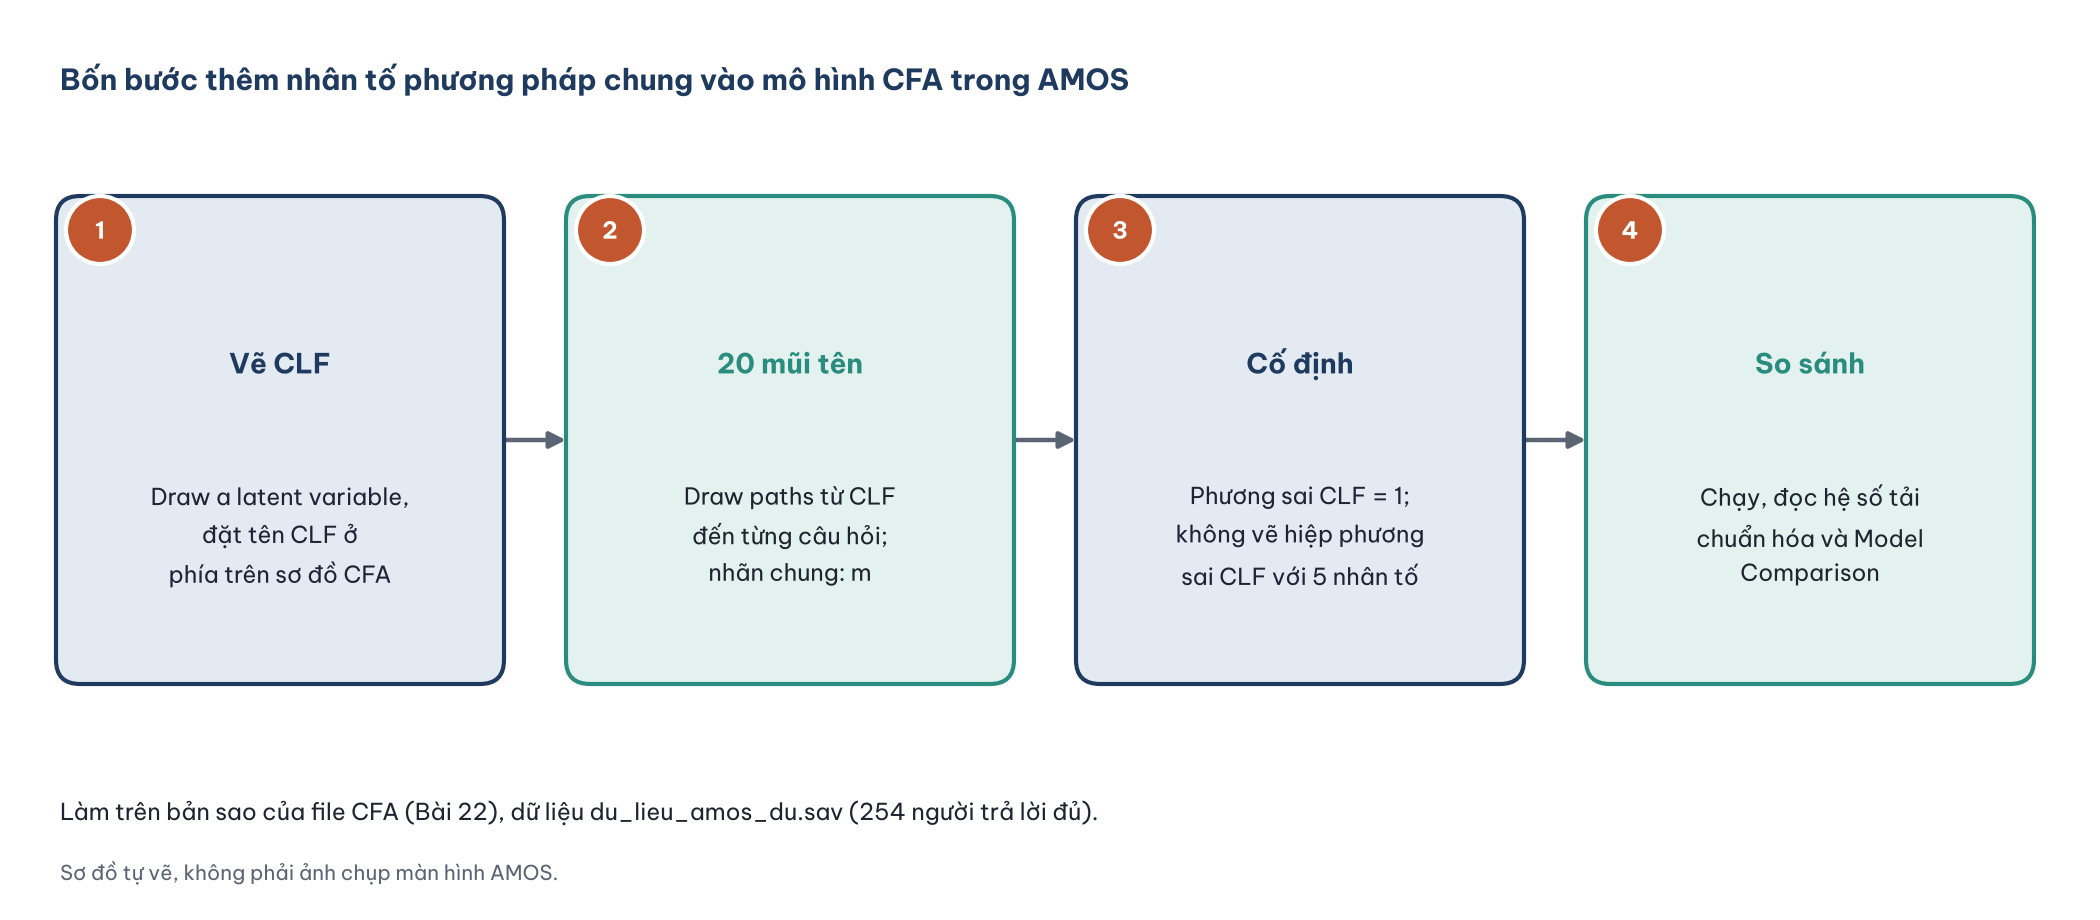
Hình 10. Bốn bước thêm nhân tố phương pháp chung vào mô hình CFA (sơ đồ tự vẽ).
- Mở bản sao file CFA của bài phân tích nhân tố khẳng định (CFA), dữ liệu
du_lieu_amos_du.sav. - Vẽ một hình elip phía trên sơ đồ bằng nút Draw a latent variable. Nhấp đúp, thẻ Text, đặt Variable name = CLF.
- Vẽ 20 mũi tên một chiều từ CLF đến 20 câu hỏi bằng nút Draw paths.
- Gán nhãn chung cho 20 mũi tên: nhấp đúp một mũi tên, thẻ Parameters, ô Regression weight nhập m. Giữ hộp thoại Object Properties mở và nhấp lần lượt từng mũi tên còn lại để nhập m (hoặc chọn cả 20 mũi tên bằng nút Select one object at a time rồi đặt nhãn một lần).
- Cố định phương sai CLF: nhấp đúp CLF, thẻ Parameters, ô Variance nhập 1.
- Không vẽ mũi tên hai chiều giữa CLF và năm nhân tố. Trong AMOS, không vẽ nghĩa là hiệp phương sai bằng 0.
- Bấm Calculate Estimates. Mở Text Output > Estimates > Standardized Regression Weights và Model Fit.
Muốn kiểm định CLF bằng chênh lệch chi bình phương, so sánh Model Fit của mô hình có CLF với mô hình CFA năm nhân tố (cùng dữ liệu), hoặc dùng Manage Models tạo thêm mô hình có ràng buộc m = 0.
5. Đọc kết quả CLF
Bảng 3 so mô hình có và không có nhân tố phương pháp chung trên hai cách xử lý dữ liệu.
Bảng 3. Kết quả mô hình có nhân tố phương pháp chung.
| Chỉ số | FIML, N = 267 (JASP) | Dữ liệu đủ, N = 254 |
|---|---|---|
| Chi bình phương (df), không có CLF | 134,29 (160) | 137,05 (160) |
| Chi bình phương (df), có CLF | 134,19 (159) | 136,88 (159) |
| Chênh lệch chi bình phương (1 df) | 0,10; p = 0,749 | 0,17; p = 0,676 |
| Hệ số tải chuẩn hóa lên CLF | 0,24 đến 0,27 | 0,29 đến 0,32 |
| Phương sai do phương pháp (bình phương hệ số tải, trung bình) | 6,7% | 9,3% |
| Hệ số tải chưa chuẩn hóa m, p (kiểm định z) | 0,244; p = 0,439 | 0,290; p = 0,031 |
| Thay đổi lớn nhất của hệ số tải khái niệm | 0,063 | 0,092 |
Có ba cách đọc thường gặp và chúng cho kết quả không giống nhau:
- Chênh lệch chi bình phương: thêm CLF không cải thiện mô hình (p = 0,749 và 0,676). Dữ liệu không cần nhân tố phương pháp.
- Phương sai do phương pháp: khoảng 7% đến 9%, thấp hơn nhiều so với mức khoảng 25% mà Williams và cộng sự (1989) ghi nhận trong các nghiên cứu dùng thang đo tự đánh giá.
- Thay đổi hệ số tải khái niệm khi thêm CLF: lớn nhất 0,063 (FIML) và 0,092 (dữ liệu đủ). Quy tắc thực hành hay gặp là thay đổi trên 0,2 thì đáng lo; ở đây thấp hơn nhiều. Quy tắc này không có nguồn gốc thống kê rõ ràng, nên chỉ dùng để tham khảo.
Một điểm cần nói thẳng: kiểm định z của m trên dữ liệu đủ cho p = 0,031. Nếu chỉ nhìn con số này, có thể viết "CLF có ý nghĩa, có CMB". Nhưng kiểm định chênh lệch chi bình phương trên cùng dữ liệu cho p = 0,676. Hai kiểm định mâu thuẫn vì kiểm định z dựa trên sai số chuẩn, mà sai số chuẩn không đáng tin khi mặt hợp lý gần phẳng (Hình 11). Khi hai kiểm định mâu thuẫn, dùng kiểm định chênh lệch chi bình phương.
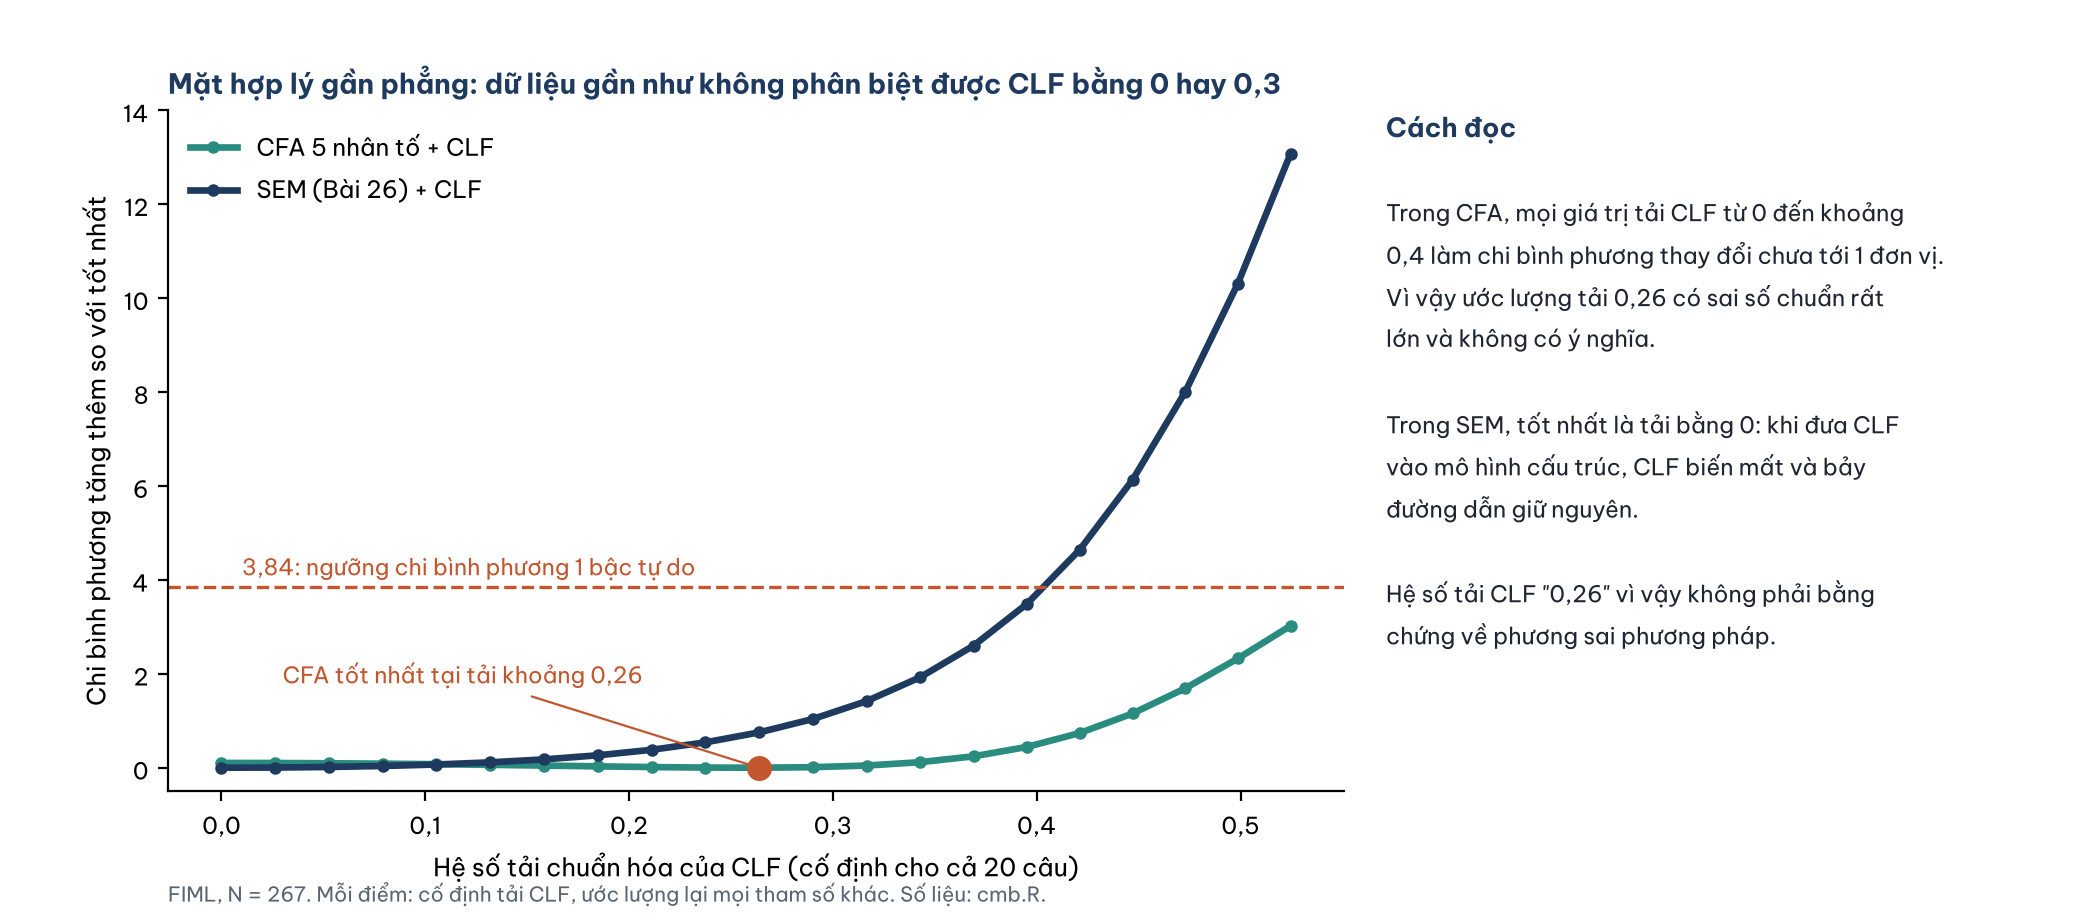
Hình 11. Chi bình phương khi cố định hệ số tải CLF ở các mức khác nhau (FIML, N = 267).
Hình 11 giải thích vì sao. Cố định hệ số tải CLF ở mọi mức từ 0 đến khoảng 0,4, chi bình phương của CFA chỉ thay đổi chưa tới 1 đơn vị. Dữ liệu không phân biệt được "không có phương sai phương pháp" với "phương sai phương pháp khoảng 10%". Ước lượng 0,26 chỉ là điểm thấp nhất của một vùng gần như phẳng, nên không nên coi nó là bằng chứng có CMB.
Dữ liệu mẫu được tạo không có phương sai phương pháp. Bộ dữ liệu sàn X là dữ liệu giả lập (xem README trong thư mục du-lieu-mau): các câu hỏi được sinh từ năm khái niệm và sai số độc lập, không có nhân tố phương pháp nào. Vậy mà CLF vẫn "tìm thấy" 7% đến 9% phương sai phương pháp. Đây là minh họa trực tiếp cho nhận định của Richardson và cộng sự (2009): kỹ thuật CLF dễ nhầm phần phương sai chung giữa các khái niệm thành phương sai phương pháp và không nên dùng một mình để kết luận.
Bằng chứng nhất quán với điều đó: khi thêm CLF, tương quan giữa các khái niệm giảm (ví dụ GIATRI với NIEMTIN từ 0,13 xuống 0,03; XACNHAN với HAILONG từ 0,63 xuống 0,58). CLF đã hút một phần tương quan thật giữa các khái niệm.
6. CMB có làm thay đổi kết luận không?
Câu hỏi quan trọng nhất không phải "có CMB không" mà là "nếu có, kết luận có đổi không" (Podsakoff và cộng sự, 2012). Kiểm tra bằng cách đưa CLF vào mô hình SEM của bài mô hình cấu trúc SEM và so sánh bảy hệ số đường dẫn.
Kết quả: trong mô hình SEM, hệ số tải CLF tốt nhất bằng 0 (đường SEM trong Hình 11), nên bảy hệ số đường dẫn, giá trị p và R² giữ nguyên đến chữ số thập phân thứ ba (FIML: H1 = 0,577; H4 = 0,091 với p = 0,375; H5 = 0,233 với p = 0,015; H7 = 0,337). Dữ liệu đủ cũng vậy. Lý do: mô hình cấu trúc đã giải thích tương quan giữa các khái niệm qua các đường dẫn, không còn phần tương quan chung nào để CLF hút vào.
Kết luận: không có bằng chứng phương sai phương pháp làm thay đổi kết quả kiểm định giả thuyết.
7. Các cách khác
Ngoài Harman và CLF còn một số cách khác để phát hiện hoặc kiểm soát phương sai phương pháp chung (Bảng 4).
Bảng 4. Các cách khác để kiểm soát phương sai phương pháp chung.
| Cách | Ý tưởng | Khi nào dùng |
|---|---|---|
| Biến đánh dấu (marker variable) | Thêm vào bảng hỏi một câu không liên quan lý thuyết đến mô hình; tương quan của nó với các câu khác ước lượng phương sai phương pháp (Lindell & Whitney, 2001) | Phải thiết kế từ trước khi thu dữ liệu |
| Nhân tố phương pháp đo được | Đo trực tiếp nguồn gây sai lệch, ví dụ thang đo mong muốn xã hội, rồi đưa vào CFA | Khi nghi một nguồn cụ thể |
| Đa cộng tuyến toàn phần (full collinearity VIF) | VIF của mọi biến tiềm ẩn; trên 3,3 là dấu hiệu CMB (Kock, 2015) | Phổ biến trong PLS-SEM (cụm SmartPLS) |
Dữ liệu sàn X không có biến đánh dấu, nên bài không minh họa cách này. Nếu đang thiết kế bảng hỏi, nên thêm một câu đánh dấu: chi phí rất thấp mà cho kiểm định mạnh hơn hẳn Harman và CLF.
8. Trình bày kết quả
Phương sai phương pháp chung được kiểm tra theo ba cách. Thứ nhất, kiểm định một nhân tố của Harman (phân tích trục chính, không xoay, 254 người trả lời đủ) cho thấy một nhân tố duy nhất chỉ giải thích 30,6% phương sai của 20 biến quan sát (33,9% theo phân tích thành phần chính), dưới ngưỡng 50%. Thứ hai, mô hình CFA một nhân tố phù hợp kém hơn rõ rệt so với mô hình năm nhân tố (FIML, N = 267: chi bình phương = 935,06, df = 170, CFI = 0,638 so với chi bình phương = 134,29, df = 160, CFI = 1,000; chênh lệch chi bình phương = 800,76, df = 10, p < 0,001). Thứ ba, thêm nhân tố phương pháp chung với hệ số tải bằng nhau không cải thiện độ phù hợp (chênh lệch chi bình phương = 0,10, df = 1, p = 0,749); phương sai do phương pháp trung bình 6,7% và hệ số tải các khái niệm thay đổi tối đa 0,063. Đưa nhân tố phương pháp vào mô hình cấu trúc không làm thay đổi hệ số đường dẫn nào. Các kiểm tra này không cho thấy phương sai phương pháp chung đe dọa kết quả, dù chúng không loại trừ được hoàn toàn khả năng này (Podsakoff và cộng sự, 2012).
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi kiểm tra và báo cáo phương sai phương pháp chung.
- Viết "dữ liệu không có CMB" chỉ dựa trên kiểm định Harman. Kiểm định này chỉ loại trừ trường hợp cực đoan.
- Xoay nhân tố khi làm kiểm định Harman (mặc định của JASP là promax). Kiểm định yêu cầu không xoay.
- Cho CLF tương quan với các nhân tố khái niệm, hoặc để 20 hệ số tải tự do rồi báo cáo một mô hình không hội tụ.
- Dựa vào giá trị p của hệ số tải CLF thay vì kiểm định chênh lệch chi bình phương.
- Bỏ qua phòng ngừa khi thiết kế bảng hỏi, rồi hy vọng kiểm định sau sẽ "cứu" nghiên cứu.
Tài liệu tham khảo
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Fuller, C. M., Simmering, M. J., Atinc, G., Atinc, Y., & Babin, B. J. (2016). Common methods variance detection in business research. Journal of Business Research, 69(8), 3192–3198. https://doi.org/10.1016/j.jbusres.2015.12.008
Harman, H. H. (1976). Modern factor analysis (3rd ed.). University of Chicago Press.
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1–10. https://doi.org/10.4018/ijec.2015100101
Lindell, M. K., & Whitney, D. J. (2001). Accounting for common method variance in cross-sectional research designs. Journal of Applied Psychology, 86(1), 114–121. https://doi.org/10.1037/0021-9010.86.1.114
Podsakoff, P. M., MacKenzie, S. B., & Podsakoff, N. P. (2012). Sources of method bias in social science research and recommendations on how to control it. Annual Review of Psychology, 63, 539–569. https://doi.org/10.1146/annurev-psych-120710-100452
Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
Richardson, H. A., Simmering, M. J., & Sturman, M. C. (2009). A tale of three perspectives: Examining post hoc statistical techniques for detection and correction of common method variance. Organizational Research Methods, 12(4), 762–800. https://doi.org/10.1177/1094428109332834
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Williams, L. J., Cote, J. A., & Buckley, M. R. (1989). Lack of method variance in self-reported affect and perceptions at work: Reality or artifact? Journal of Applied Psychology, 74(3), 462–468. https://doi.org/10.1037/0021-9010.74.3.462