
MÔ HÌNH CẤU TRÚC SEM VỚI JASP VÀ AMOS
Chuyển CFA thành mô hình cấu trúc trong JASP và AMOS, đọc hệ số đường dẫn, R² và tác động gián tiếp
Bài nên đọc trước
Các bài từ phân tích nhân tố khẳng định (CFA) đến giá trị hội tụ và giá trị phân biệt đã chứng minh mô hình đo lường đạt yêu cầu: năm thang đo phù hợp với dữ liệu, tin cậy, hội tụ (trừ AVE của Ý định mua lại) và phân biệt. Theo quy trình hai bước (Anderson & Gerbing, 1988), giờ có thể chuyển sang bước thứ hai: mô hình cấu trúc, nơi các mũi tên hai chiều giữa các nhân tố được thay bằng các đường tác động theo giả thuyết.
Bài này hướng dẫn chuyển mô hình CFA thành SEM, chạy và đọc các kết quả tổng quát: độ phù hợp, hệ số đường dẫn và R². Bài kiểm định giả thuyết trong SEM sẽ đi sâu vào kiểm định từng giả thuyết và cách diễn giải hệ số chuẩn hóa.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026) trên file du_lieu_amos.sav của bài chuẩn bị dữ liệu cho CFA và SEM. Các con số được đối chiếu bằng gói lavaan của R (Rosseel, 2012), file sem_cau_truc.R đi kèm. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
26-mo-hinh-cau-truc-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Từ CFA đến SEM: thay đổi những gì?
Mô hình cấu trúc giữ nguyên phần đo lường của CFA và thay các tương quan tự do giữa nhân tố bằng các đường tác động theo giả thuyết (Hình 1).
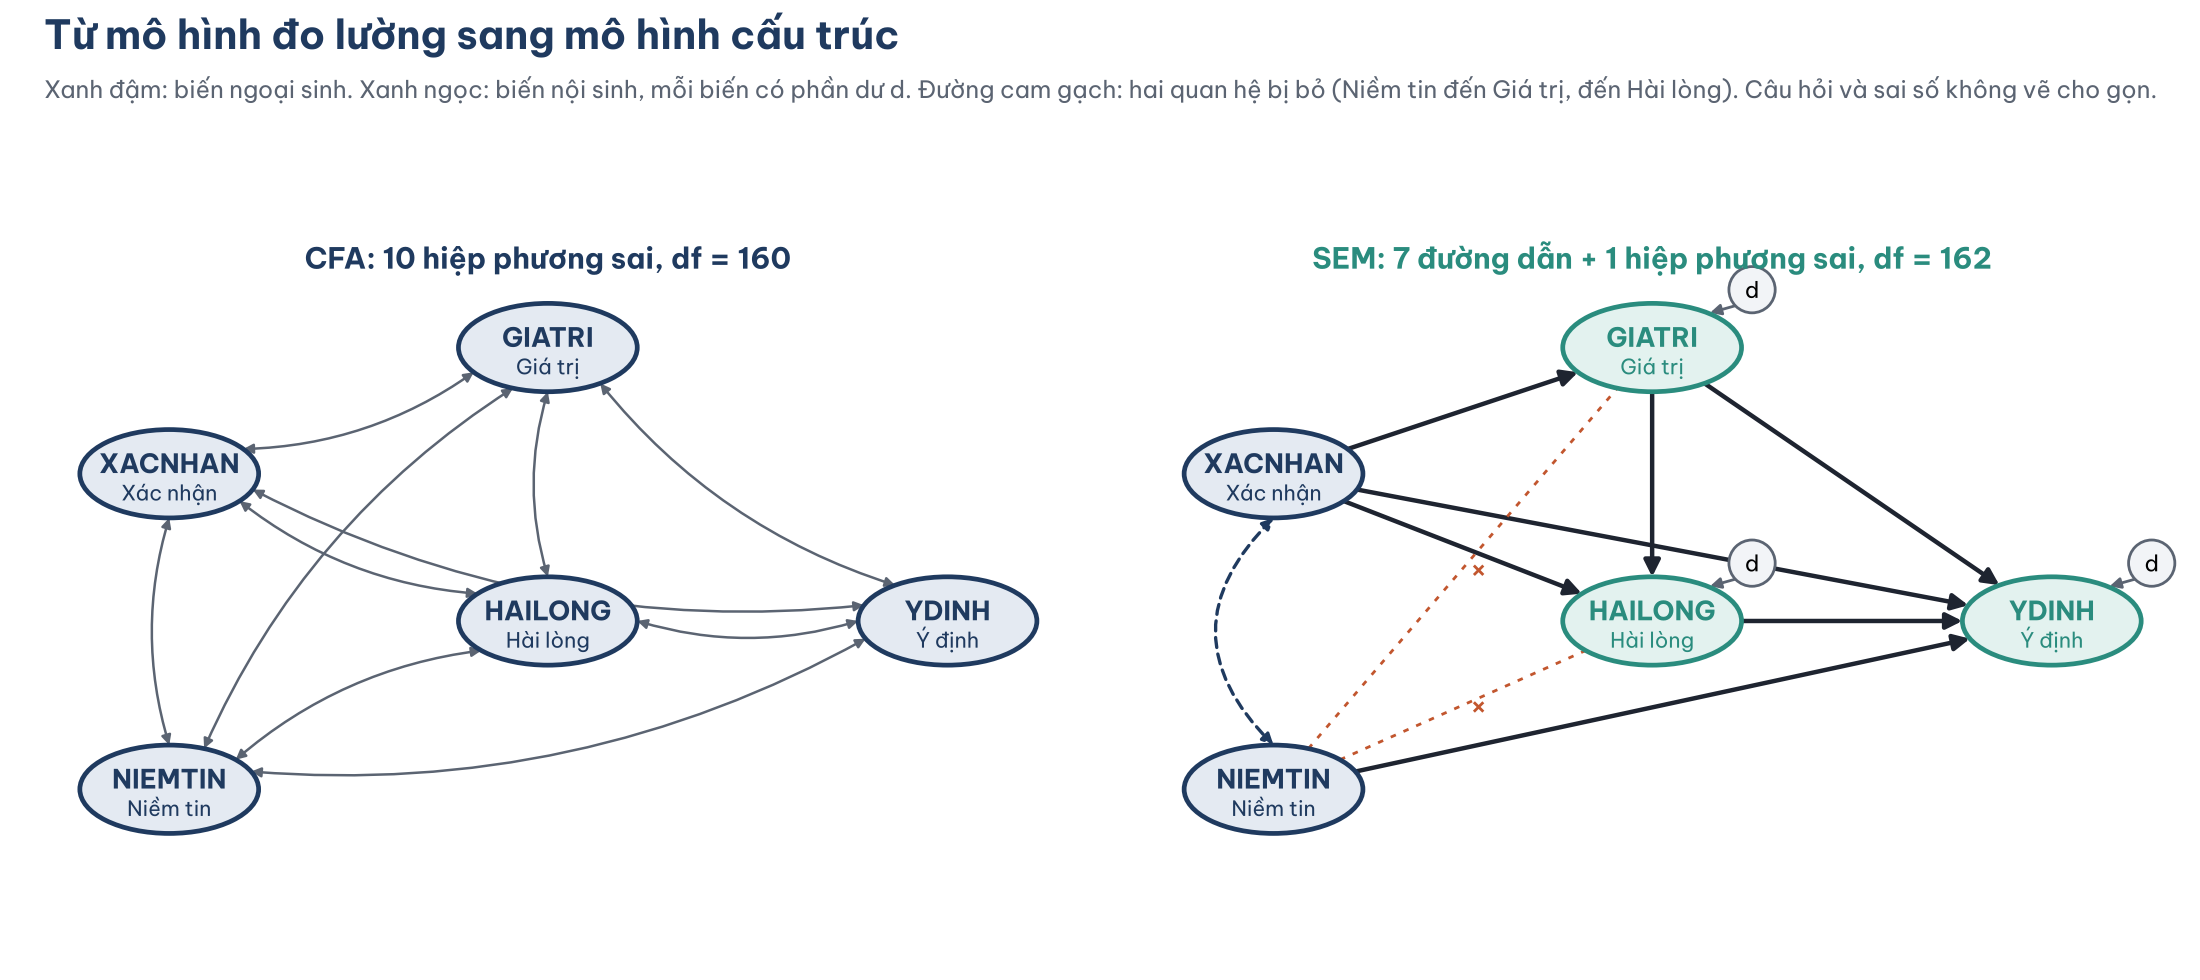
Hình 1. Bên trái: CFA, mọi cặp nhân tố tương quan tự do. Bên phải: SEM, các tương quan được thay bằng bảy đường tác động theo giả thuyết.
Biến ngoại sinh và biến nội sinh
Trong mô hình cấu trúc, mỗi khái niệm đóng một trong hai vai trò.
- Biến ngoại sinh (exogenous) không có mũi tên nào chỉ vào: XACNHAN và NIEMTIN. Mô hình không giải thích chúng, chỉ dùng chúng để giải thích biến khác.
- Biến nội sinh (endogenous) có ít nhất một mũi tên chỉ vào: GIATRI, HAILONG, YDINH. Mỗi biến nội sinh cần một phần dư cấu trúc (d, disturbance): phần biến thiên không được các biến đứng trước giải thích.
HAILONG vừa là kết quả (của XACNHAN, GIATRI) vừa là nguyên nhân (của YDINH). Đây là điều hồi quy thông thường không làm được trong một phương trình, nhưng SEM ước lượng cùng lúc (bài AMOS và CB-SEM).
Bảy giả thuyết
Mô hình sàn X có bảy giả thuyết về quan hệ giữa năm khái niệm (Bảng 1).
Bảng 1. Bảy giả thuyết của mô hình sàn X.
| Giả thuyết | Đường dẫn |
|---|---|
| H1 | XACNHAN đến GIATRI |
| H2 | XACNHAN đến HAILONG |
| H3 | GIATRI đến HAILONG |
| H4 | XACNHAN đến YDINH |
| H5 | GIATRI đến YDINH |
| H6 | HAILONG đến YDINH |
| H7 | NIEMTIN đến YDINH |
Bậc tự do tăng ở đâu?
CFA có 10 hiệp phương sai giữa năm nhân tố. SEM thay chúng bằng 7 đường dẫn và giữ lại 1 hiệp phương sai giữa hai biến ngoại sinh XACNHAN và NIEMTIN. Như vậy SEM ít hơn CFA 2 tham số: hai quan hệ không có trong giả thuyết là NIEMTIN đến GIATRI và NIEMTIN đến HAILONG (đường cam gạch ở Hình 1). Bậc tự do tăng từ 160 lên 162.
Quy tắc quan trọng: luôn cho các biến ngoại sinh tương quan với nhau, trừ khi lý thuyết khẳng định chúng độc lập (Kline, 2023). AMOS không tự vẽ hiệp phương sai này; quên vẽ là lỗi rất hay gặp (mục 5).
2. Khai báo mô hình cấu trúc trong JASP
Mô-đun Factor chỉ chạy CFA. Mô hình cấu trúc dùng mô-đun SEM (bật bằng nút dấu cộng ở góc phải thanh công cụ, bài phân tích nhân tố khẳng định (CFA)):
- Mở file
du_lieu_amos.sav, chọn SEM > Structural Equation Modeling. - Gõ mô hình vào ô soạn thảo theo cú pháp lavaan, rồi nhấn Ctrl+Enter (Hình 2):
# Mo hinh do luong
XACNHAN =~ XN1 + XN2 + XN3 + XN4
GIATRI =~ HI1 + HI2 + HI3 + HI4
HAILONG =~ HL1 + HL2 + HL3 + HL4
NIEMTIN =~ NT1 + NT2 + NT3 + NT4R
YDINH =~ YD1 + YD2 + YD3 + YD4
# Mo hinh cau truc
GIATRI ~ XACNHAN
HAILONG ~ XACNHAN + GIATRI
YDINH ~ XACNHAN + GIATRI + HAILONG + NIEMTIN
XACNHAN ~~ NIEMTIN
# Co dinh trung binh nhan to bang 0 (giong AMOS)
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1
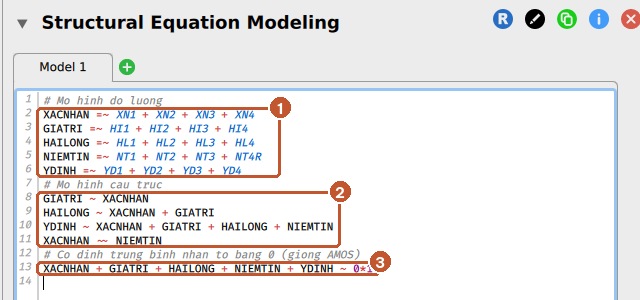
Hình 2. (1) Mô hình đo lường, (2) mô hình cấu trúc và hiệp phương sai giữa hai biến ngoại sinh, (3) dòng cố định trung bình nhân tố.
Ba kí hiệu cần nhớ (Bảng 2):
Bảng 2. Ba kí hiệu của cú pháp lavaan.
| Kí hiệu | Nghĩa | Tương đương trong AMOS |
|---|---|---|
=~ |
được đo bởi (nhân tố và câu hỏi) | mũi tên từ hình bầu dục đến hình chữ nhật |
~ |
được giải thích bởi (đường tác động) | mũi tên một chiều giữa hai nhân tố |
~~ |
tương quan với | mũi tên hai chiều |
lavaan tự thêm phần dư cho mọi biến nội sinh, nên không cần khai báo d1, d2, d3. Tên biến tiềm ẩn phải viết đúng như tên dùng ở phần đo lường; dòng chú thích bắt đầu bằng dấu # và không được có dấu tiếng Việt trong cú pháp.
Dòng cuối là bắt buộc khi dùng FIML. Như đã gặp ở bài phân tích nhân tố khẳng định (CFA), mô-đun SEM của JASP 0.99.0 ước lượng thêm trung bình của các nhân tố khi chọn FIML, làm bậc tự do bị đếm sai (157 thay vì 162). Cố định trung bình nhân tố bằng 0, giống cách AMOS và mô-đun CFA làm, cho đúng bậc tự do và chi bình phương.
- Kiểm tra Missing data handling trong Estimation Options là FIML (mặc định của mô-đun SEM).
- Đánh dấu trong Output Options (Hình 3): Additional fit measures, R-squared, Standardized estimates (chọn All), Path diagram kèm Show parameter estimates và Standardized.
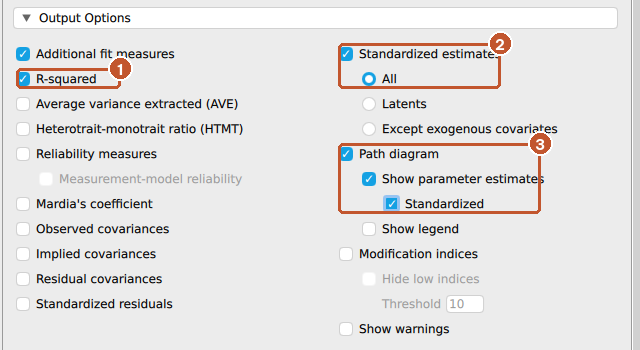
Hình 3. (1) R² của biến nội sinh, (2) hệ số chuẩn hóa, (3) sơ đồ với hệ số chuẩn hóa.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, mô hình cấu trúc được tạo bằng cách sửa trực tiếp sơ đồ CFA đã vẽ (Hình 4).
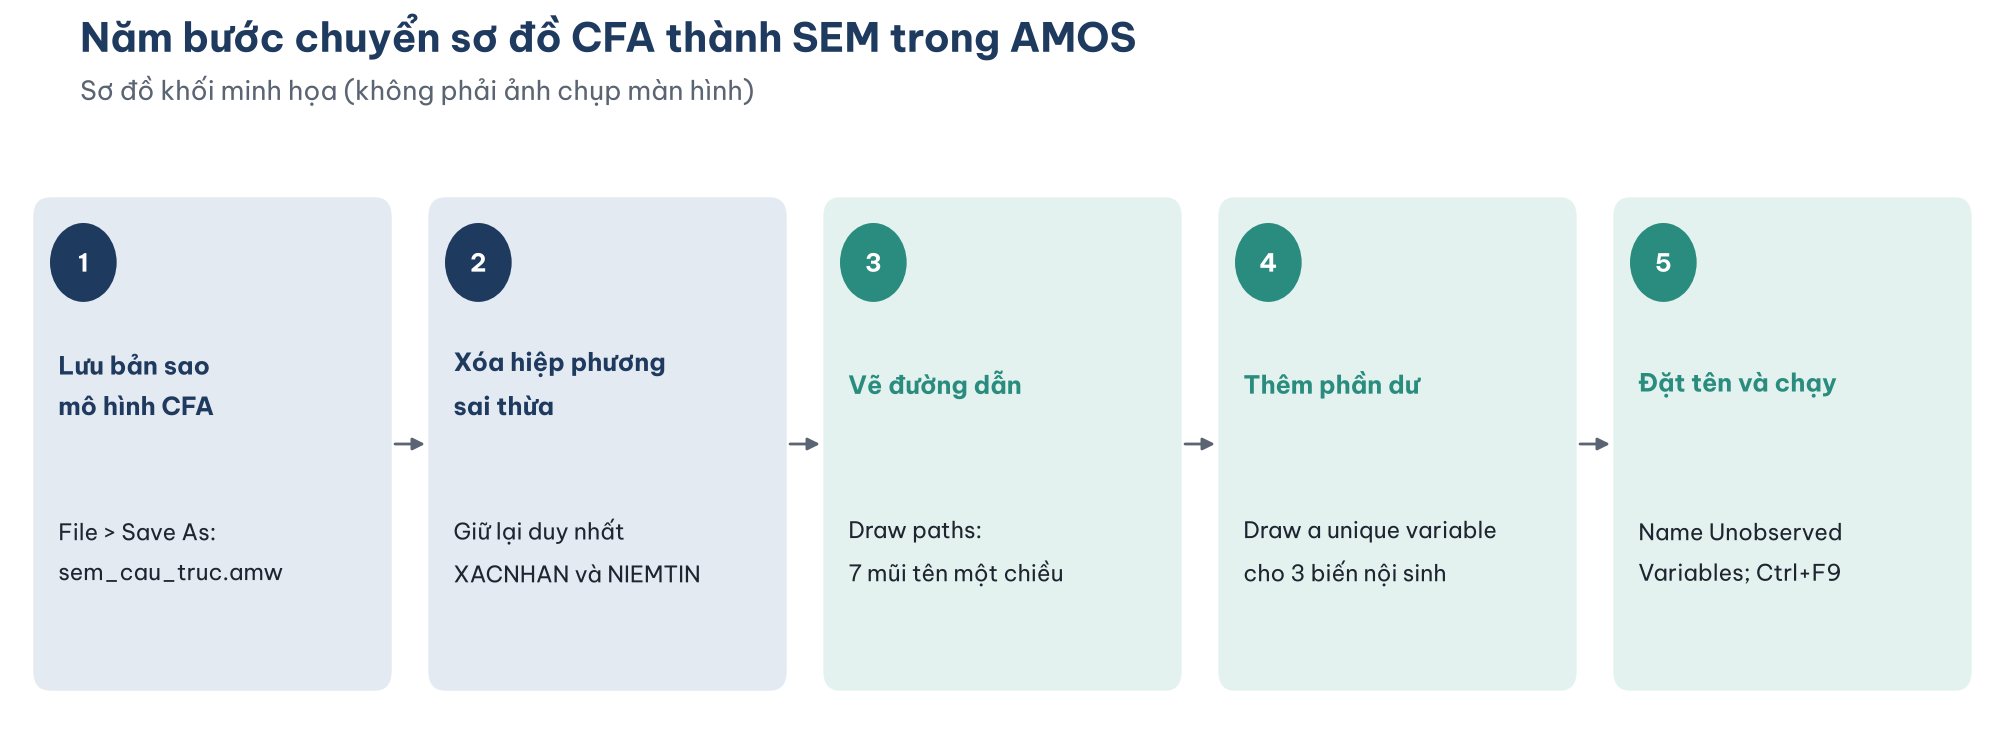
Hình 4. Năm bước chuyển sơ đồ CFA của bài phân tích nhân tố khẳng định (CFA) thành mô hình cấu trúc.
- Lưu bản sao file CFA bằng File > Save As, đặt tên
sem_cau_truc.amw. Giữ file CFA gốc để so sánh. - Xóa hiệp phương sai thừa. Chọn công cụ Erase objects (biểu tượng xe tải), bấm vào 9 mũi tên hai chiều, chỉ giữ lại mũi tên giữa XACNHAN và NIEMTIN.
- Vẽ đường dẫn. Chọn công cụ Draw paths (single headed arrows), kéo từ nhân tố nguyên nhân đến nhân tố kết quả cho 7 giả thuyết ở bảng trên.
- Thêm phần dư. Chọn công cụ Add a unique variable to an existing variable (biểu tượng hình tròn nhỏ gắn vào hình chữ nhật), bấm vào GIATRI, HAILONG, YDINH. AMOS thêm một hình tròn kèm mũi tên có hệ số 1. Bấm thêm vài lần để xoay vị trí hình tròn.
- Đặt tên phần dư bằng Plugins > Name Unobserved Variables (AMOS đặt e21, e22, e23; có thể đổi thành d1, d2, d3 bằng cách bấm đúp). Kiểm tra View > Analysis Properties: giữ Estimate means and intercepts và các kết quả đã chọn ở bài phân tích nhân tố khẳng định (CFA), đánh dấu thêm Squared multiple correlations. Chạy bằng Analyze > Calculate Estimates (Ctrl+F9).
Nên sắp xếp sơ đồ từ trái sang phải theo chiều tác động: biến ngoại sinh bên trái, biến kết quả cuối cùng bên phải. Bỏ bớt hình chữ nhật câu hỏi ra rìa để các mũi tên cấu trúc dễ đọc.
Nếu AMOS báo lỗi
- "The following variables are endogenous, but have no residual (error) variables": quên thêm phần dư cho một biến nội sinh.
- "The model is probably unidentified": thường do quên số 1 trên mũi tên phần dư, hoặc xóa nhầm hệ số tải cố định bằng 1 của một nhân tố.
3. Đọc kết quả
Kết quả mô hình cấu trúc được đọc theo ba phần: độ phù hợp, hệ số đường dẫn và R² của biến nội sinh.
Độ phù hợp: SEM so với CFA
JASP in độ phù hợp của mô hình cấu trúc ở đầu kết quả (Hình 5); Bảng 3 so các chỉ số này với CFA.
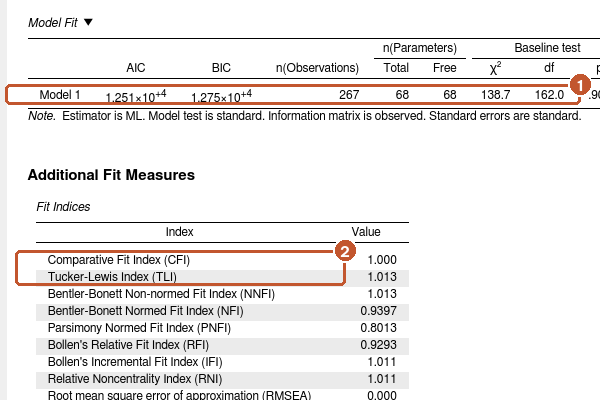
Hình 5. (1) Chi bình phương, df và p của mô hình cấu trúc, (2) CFI và TLI.
Bảng 3. Độ phù hợp của CFA và SEM.
| Chỉ số | CFA (bài phân tích nhân tố khẳng định (CFA)) | SEM |
|---|---|---|
| Chi bình phương; df; p | 134,29; 160; 0,931 | 138,67; 162; 0,908 |
| CFI | 1,000 | 1,000 |
| TLI | 1,014 | 1,013 |
| RMSEA (KTC 90%) | 0,000 (0,000; 0,008) | 0,000 (0,000; 0,012) |
| SRMR | 0,032 | 0,035 |
ML, FIML, N = 267.
Mô hình cấu trúc không thể phù hợp tốt hơn CFA, vì nó chỉ là CFA với thêm ràng buộc (Anderson & Gerbing, 1988). Câu hỏi đúng là: các ràng buộc đó có làm mất nhiều độ phù hợp không? So sánh hai mô hình lồng nhau: chi bình phương tăng 4,38 với 2 bậc tự do, p = 0,112. Hai quan hệ bị bỏ (Niềm tin đến Giá trị và đến Hài lòng) không cần thiết để giải thích dữ liệu. Các chỉ số khác gần như không đổi.
Hệ số tải chuẩn hóa trong SEM chênh tối đa 0,002 so với CFA. Nếu hệ số tải thay đổi đáng kể khi chuyển sang SEM, đó là dấu hiệu mô hình cấu trúc bị khai báo sai và đang "kéo" mô hình đo lường (Kline, 2023).
Hệ số đường dẫn
Hệ số đường dẫn nằm trong bảng Regression Coefficients của JASP (Hình 6), được vẽ lại trên sơ đồ ở Hình 7 và tóm tắt ở Bảng 4.
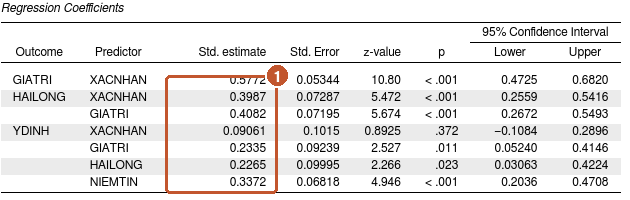
Hình 6. Bảng Regression Coefficients với Standardization = All: (1) cột Std. estimate là hệ số đường dẫn chuẩn hóa.
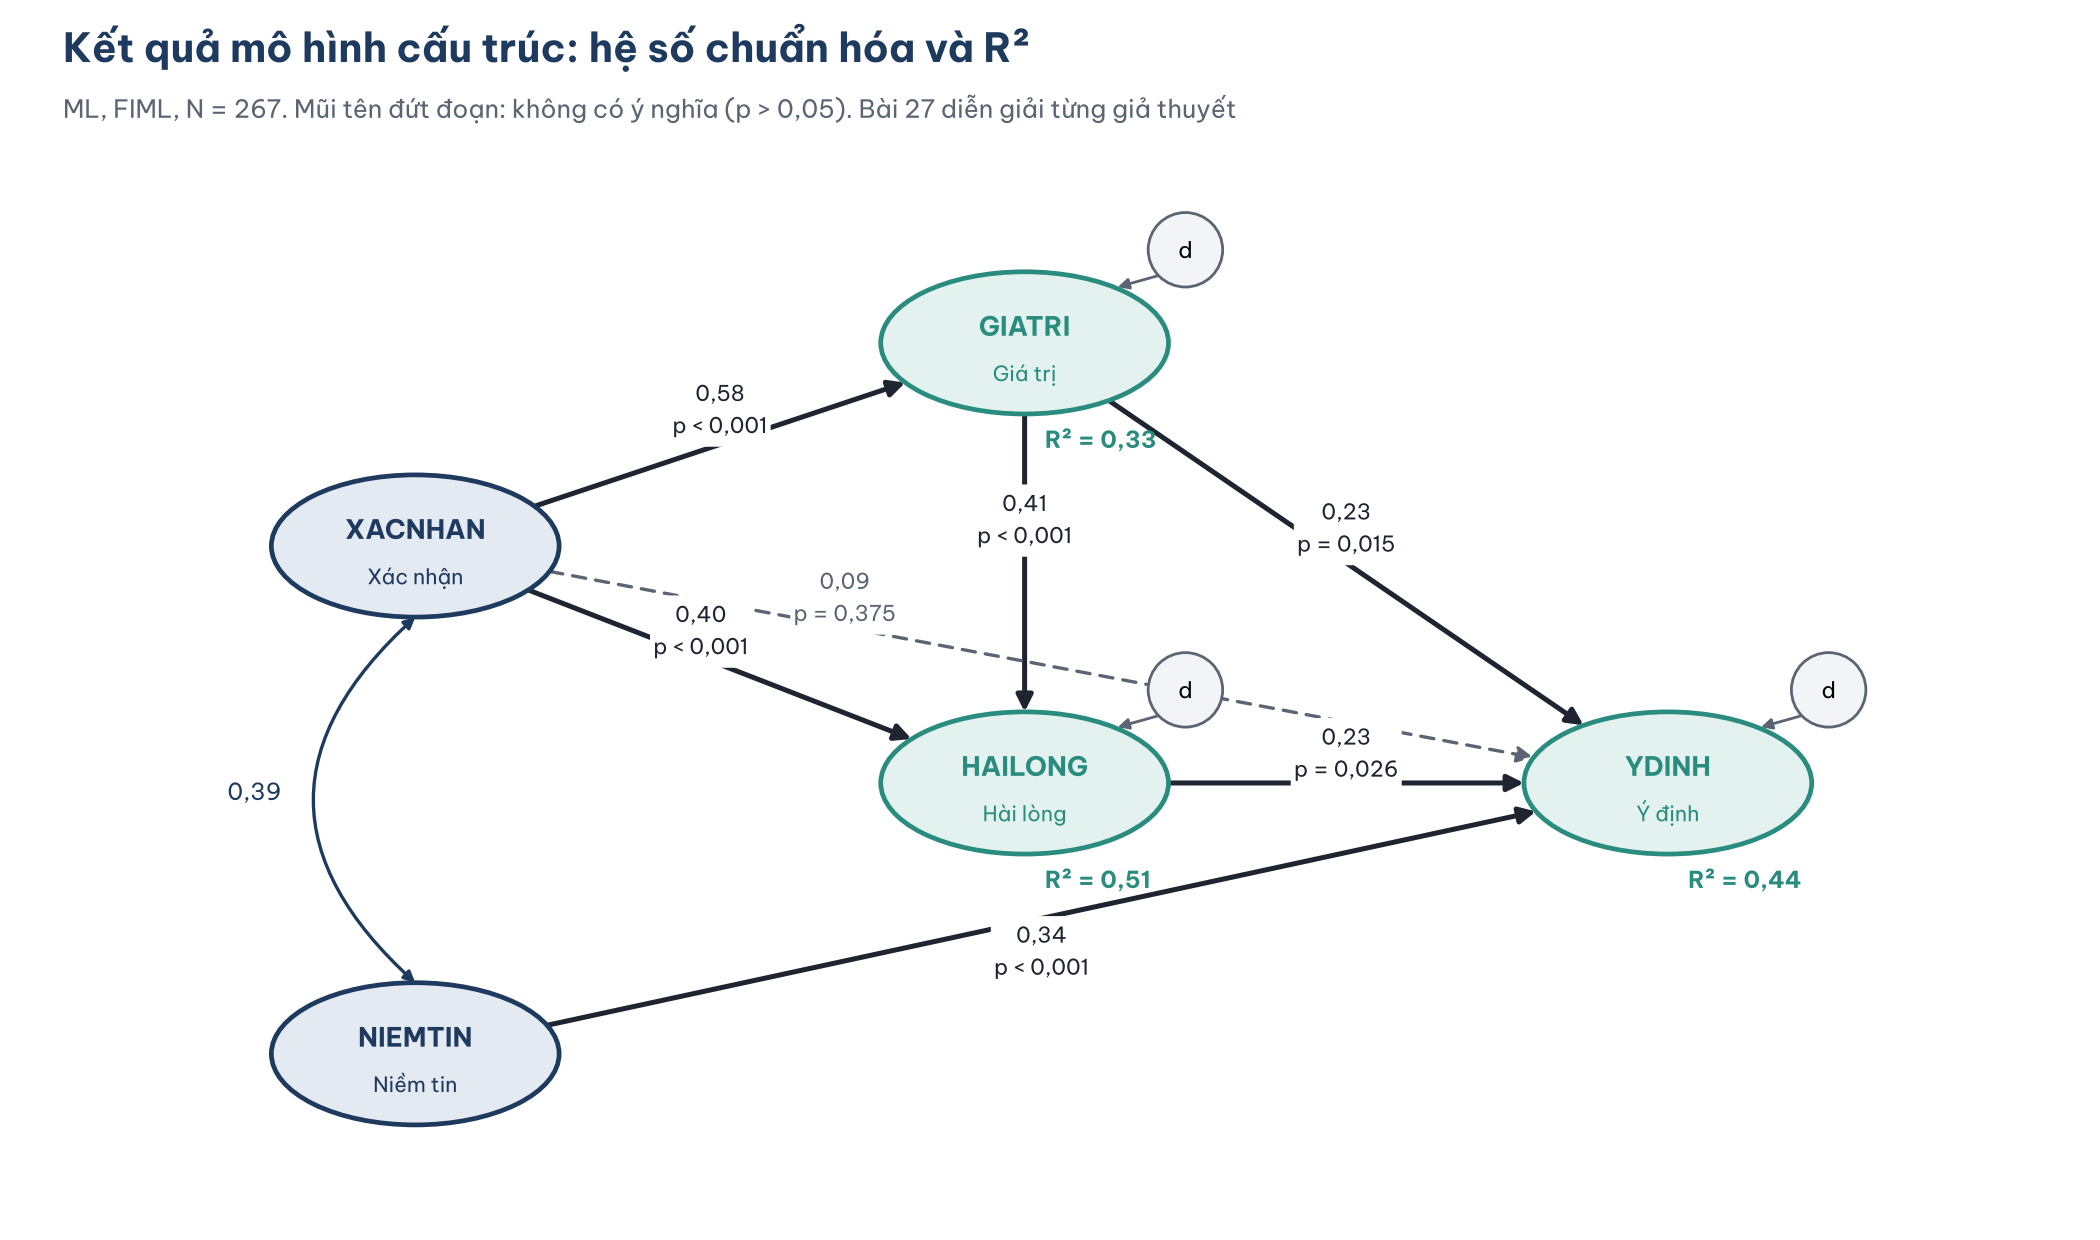
Hình 7. Hệ số đường dẫn chuẩn hóa, giá trị p và R² của ba biến nội sinh.
Bảng 4. Hệ số đường dẫn của bảy giả thuyết.
| Giả thuyết | Đường dẫn | Hệ số chưa chuẩn hóa (S.E.) | C.R. (z) | p | Hệ số chuẩn hóa |
|---|---|---|---|---|---|
| H1 | XACNHAN đến GIATRI | 0,627 (0,087) | 7,22 | < 0,001 | 0,577 |
| H2 | XACNHAN đến HAILONG | 0,412 (0,085) | 4,87 | < 0,001 | 0,399 |
| H3 | GIATRI đến HAILONG | 0,389 (0,077) | 5,02 | < 0,001 | 0,408 |
| H4 | XACNHAN đến YDINH | 0,088 (0,099) | 0,89 | 0,375 | 0,091 |
| H5 | GIATRI đến YDINH | 0,208 (0,085) | 2,44 | 0,015 | 0,233 |
| H6 | HAILONG đến YDINH | 0,212 (0,095) | 2,23 | 0,026 | 0,227 |
| H7 | NIEMTIN đến YDINH | 0,316 (0,071) | 4,46 | < 0,001 | 0,337 |
Sáu trong bảy đường dẫn có ý nghĩa ở mức 0,05; H4 không có ý nghĩa. Kết quả này trùng với hồi quy trên điểm trung bình ở bài hồi quy tuyến tính bội về chiều và ý nghĩa, nhưng các hệ số chuẩn hóa trong SEM lớn hơn vì đã loại sai số đo lường (bài AMOS và CB-SEM). Bài kiểm định giả thuyết trong SEM sẽ diễn giải từng giả thuyết, cách so sánh độ lớn hệ số và cách viết kết luận.
Hiệp phương sai giữa XACNHAN và NIEMTIN có tương quan 0,39 (p < 0,001), xác nhận việc cho hai biến ngoại sinh tương quan là cần thiết.
Trong AMOS, hệ số chưa chuẩn hóa nằm ở Estimates > Scalars > Regression Weights (cùng bảng với hệ số tải; các dòng có dạng GIATRI <--- XACNHAN), hệ số chuẩn hóa ở Standardized Regression Weights.
R² của biến nội sinh
R² cho biết tỷ lệ phương sai của mỗi biến nội sinh được các biến đứng trước giải thích (Hình 8, Bảng 5).
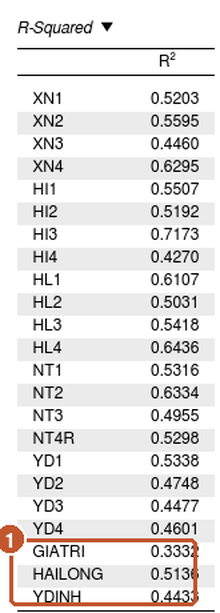
Hình 8. Bảng R-Squared: (1) R² của ba biến nội sinh. Các dòng trên là R² của từng câu hỏi (giống CFA).
Bảng 5. R² của ba biến nội sinh.
| Biến nội sinh | R² | Ý nghĩa |
|---|---|---|
| GIATRI | 0,333 | XACNHAN giải thích 33% biến thiên của giá trị cảm nhận |
| HAILONG | 0,514 | XACNHAN và GIATRI giải thích 51% biến thiên của sự hài lòng |
| YDINH | 0,443 | Bốn biến giải thích 44% biến thiên của ý định mua lại |
Phương sai chuẩn hóa của phần dư bằng 1 − R² (ví dụ 0,557 với YDINH). R² của YDINH (0,443) cao hơn rõ so với hồi quy ở bài hồi quy tuyến tính bội (0,315), cũng do SEM đã loại sai số đo lường.
Trong AMOS, R² nằm ở Estimates > Scalars > Squared Multiple Correlations, cùng bảng với R² của từng câu hỏi; trên sơ đồ chuẩn hóa, R² hiện ở góc trên bên phải mỗi biến nội sinh.
Sơ đồ của JASP
JASP cũng tự vẽ sơ đồ mô hình cấu trúc từ kết quả ước lượng (Hình 9).
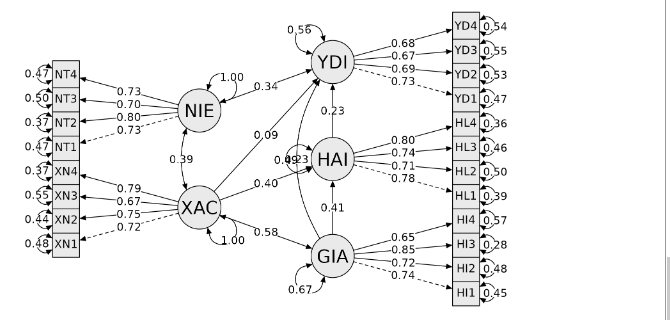
Hình 9. Sơ đồ do JASP tự vẽ với hệ số chuẩn hóa. Tên nhân tố bị rút gọn còn ba chữ cái.
Sơ đồ của JASP (vẽ bằng gói semPlot) đủ để kiểm tra khai báo: đúng số mũi tên, đúng chiều, có mũi tên hai chiều giữa XAC và NIE. Để đưa vào luận văn, nên vẽ lại gọn hơn như Hình 7 ở mục 3.
4. Tác động gián tiếp và tổng
Khi chọn Standardized estimates, JASP in thêm bảng Indirect Effects và Total Effects, kèm sai số chuẩn tính bằng phương pháp delta.
XACNHAN tác động đến YDINH theo ba đường gián tiếp (qua GIATRI, qua HAILONG, qua GIATRI rồi HAILONG). Tác động trực tiếp nhỏ và không có ý nghĩa (0,09), nhưng tác động tổng là 0,37 (p < 0,001). Đây là dấu hiệu của trung gian: xác nhận kỳ vọng ảnh hưởng đến ý định mua lại chủ yếu thông qua giá trị cảm nhận và sự hài lòng. Kiểm định chặt chẽ tác động gián tiếp cần bootstrap, nội dung bài biến trung gian trong SEM.
Khi chọn Indirect, direct & total effects trong Analysis Properties > Output, AMOS in thêm các bảng tác động gián tiếp và tổng. Với dữ liệu thiếu, AMOS in được ước lượng nhưng không tính được p và khoảng tin cậy (cần bootstrap, bài biến trung gian trong SEM).
5. Lỗi hay gặp: quên hiệp phương sai giữa biến ngoại sinh
Quên cho hai biến ngoại sinh tương quan làm độ phù hợp xấu đi rõ rệt (Hình 10).
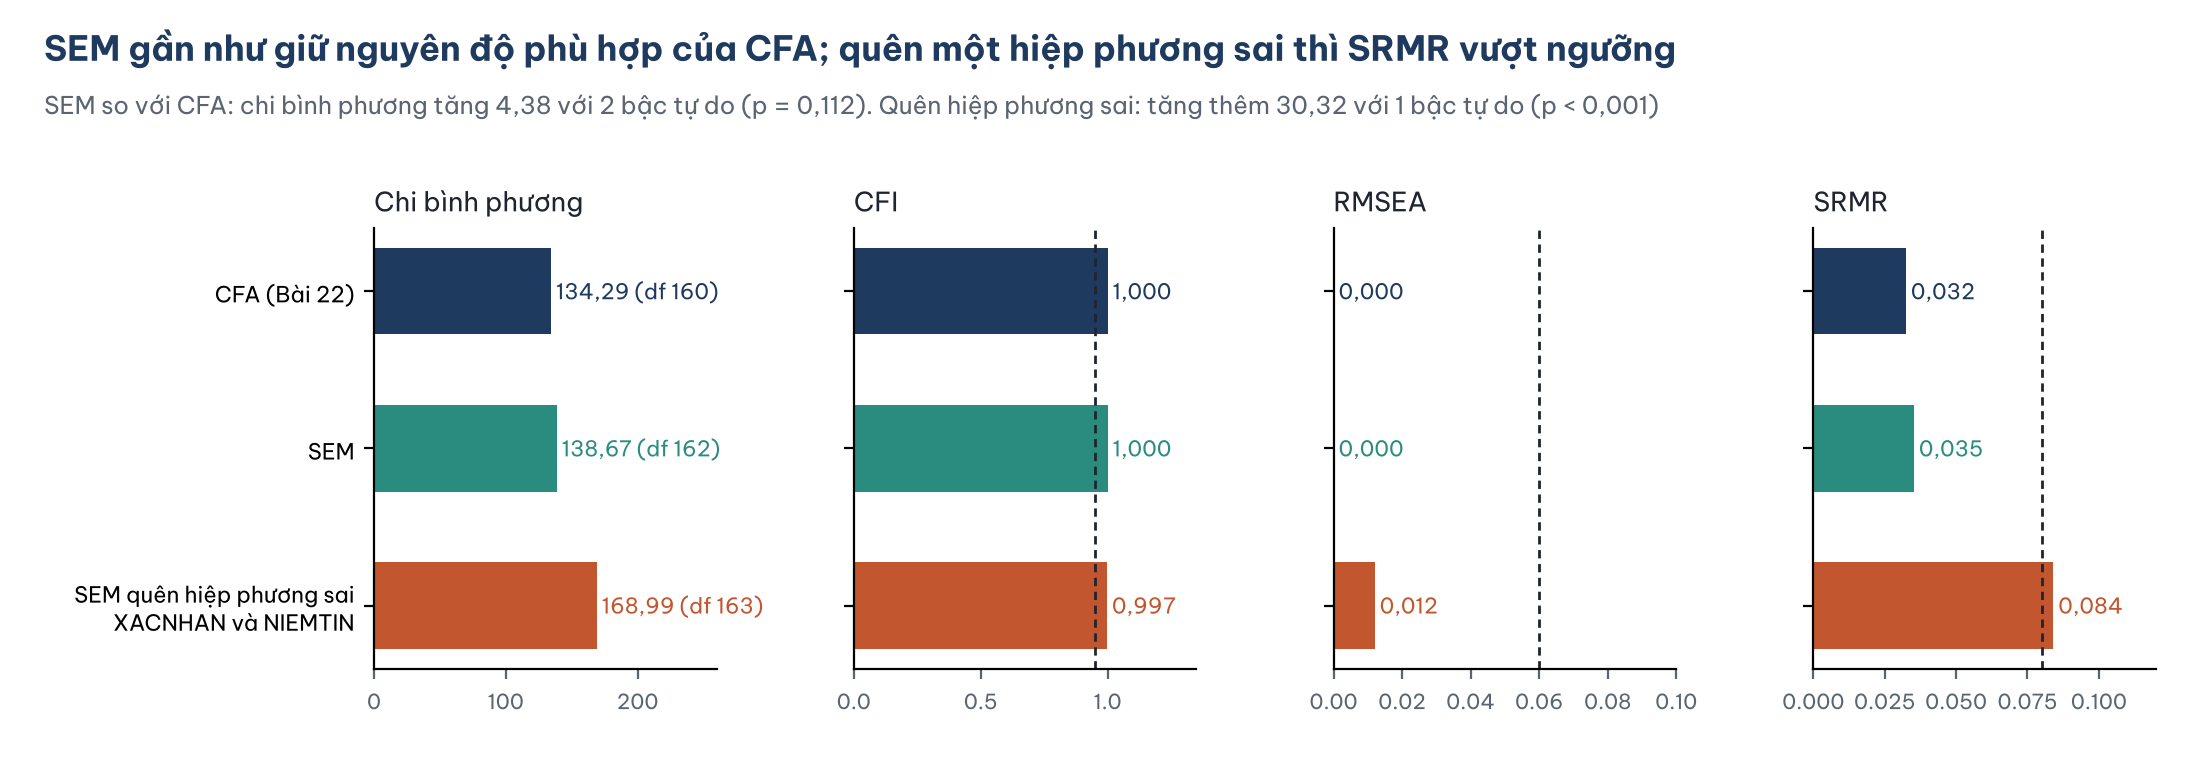
Hình 10. Chi bình phương, CFI, RMSEA và SRMR của CFA, SEM đúng và SEM quên hiệp phương sai XACNHAN và NIEMTIN.
Nếu không vẽ mũi tên hai chiều giữa XACNHAN và NIEMTIN, mô hình giả định hai khái niệm này không tương quan. Trên dữ liệu mẫu, chi bình phương tăng 30,32 với 1 bậc tự do (p < 0,001), SRMR tăng lên 0,084, vượt ngưỡng 0,08, trong khi CFI (0,997) và RMSEA (0,012) vẫn rất tốt. Đây là ví dụ cho lời khuyên ở bài chỉ số độ phù hợp của mô hình: đọc nhiều chỉ số. SRMR nhạy với loại sai sót này vì nó đo trực tiếp chênh lệch tương quan.
lavaan mặc định cho các biến ngoại sinh tiềm ẩn tương quan với nhau, nên dòng XACNHAN ~~ NIEMTIN trong cú pháp thật ra là thừa trong JASP. Bài vẫn viết ra để mô hình rõ ràng và giống sơ đồ AMOS. Người dùng AMOS phải tự vẽ mũi tên này.
Trong AMOS, lỗi này rất dễ xảy ra vì AMOS không tự thêm hiệp phương sai giữa các biến ngoại sinh (Byrne, 2016). Cách kiểm tra nhanh: mọi biến không có mũi tên chỉ vào (trừ sai số và phần dư) phải được nối với nhau bằng mũi tên hai chiều.
6. Trình bày kết quả
Mô hình cấu trúc phù hợp với dữ liệu: chi bình phương = 138,67; df = 162; p = 0,908; CFI = 1,000; TLI = 1,013; RMSEA = 0,000 (KTC 90% [0,000; 0,012]); SRMR = 0,035. So với mô hình đo lường, mô hình cấu trúc không làm giảm độ phù hợp có ý nghĩa (hiệu chi bình phương = 4,38 với 2 bậc tự do; p = 0,112). Mô hình giải thích 33,3% biến thiên của giá trị cảm nhận, 51,4% của sự hài lòng và 44,3% của ý định mua lại.
Bảng hệ số đường dẫn và sơ đồ có hệ số chuẩn hóa sẽ được trình bày cùng kết luận từng giả thuyết ở bài kiểm định giả thuyết trong SEM.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi chuyển từ CFA sang mô hình cấu trúc.
- Chạy SEM trước khi đánh giá mô hình đo lường. Hệ số đường dẫn không đáng tin nếu thang đo chưa đạt.
- Quên phần dư cho biến nội sinh (AMOS báo lỗi) hoặc quên hiệp phương sai giữa biến ngoại sinh (AMOS không báo lỗi, mô hình chỉ phù hợp kém hơn).
- Thêm đường dẫn theo chỉ số điều chỉnh để cải thiện độ phù hợp mà không có giả thuyết.
- Bỏ qua so sánh với CFA. Độ phù hợp của SEM phải đọc trong tương quan với CFA.
- Chỉ báo cáo hệ số có ý nghĩa và bỏ qua giả thuyết bị bác bỏ như H4.
Tài liệu tham khảo
Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
Byrne, B. M. (2016). Structural equation modeling with AMOS: Basic concepts, applications, and programming (3rd ed.). Routledge. https://www.routledge.com/Structural-Equation-Modeling-With-AMOS-Basic-Concepts-Applications-and/Byrne/p/book/9781138797031
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02