
HTMT VÀ GIÁ TRỊ PHÂN BIỆT TRONG SMARTPLS
Đọc ma trận HTMT, khoảng tin cậy bootstrap, tiêu chí Fornell-Larcker và hệ số tải chéo trong SmartPLS 4
Bài nên đọc trước
Bài đánh giá mô hình đo lường reflective đã cho thấy năm thang đo của mô hình sàn X đo ổn định và hội tụ. Bước cuối của việc đánh giá mô hình đo lường là giá trị phân biệt: mỗi thang đo có đo một khái niệm khác với các thang đo còn lại không. Với đề tài sàn X, câu hỏi đáng lo nhất là Giá trị cảm nhận và Sự hài lòng, hai khái niệm có liên quan chặt về lý thuyết.
Bài giá trị hội tụ và giá trị phân biệt đã giới thiệu HTMT và tiêu chí Fornell-Larcker trong CB-SEM. Bài này tập trung vào cách đọc ba bảng giá trị phân biệt của SmartPLS và vì sao trong PLS-SEM, HTMT là tiêu chí chính, còn Fornell-Larcker và hệ số tải chéo chỉ để tham khảo.
Về hình minh họa và con số. Ảnh chụp thật báo cáo của SmartPLS 4.1.2.1 (bản dùng thử; Ringle và cộng sự, 2026) cho mô hình
mo-hinh-san-xcủa bài nhập dữ liệu và vẽ mô hình trong SmartPLS, Casewise deletion, 254 người. Mọi con số được đối chiếu bằng R, filegia_tri_phan_biet.Rvà trùng với SmartPLS đến chữ số thứ ba. Khoảng tin cậy bootstrap của HTMT tính bằng R với 5000 mẫu.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
35-htmt-gia-tri-phan-bietcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Mở các bảng giá trị phân biệt
Trong báo cáo của thuật toán PLS-SEM (bài nhập dữ liệu và vẽ mô hình trong SmartPLS, mục 6), mở nhóm Quality criteria, rồi bấm mũi tên cạnh Discriminant validity. Mục này có sáu lựa chọn:
- Heterotrait-monotrait ratio (HTMT), xem dưới ba dạng: Matrix (ma trận), List (danh sách từng cặp) và Bar chart (biểu đồ cột).
- Congruence coefficient: một chỉ số khác, không dùng trong chuỗi bài.
- Fornell-Larcker criterion.
- Cross loadings (hệ số tải chéo).
2. HTMT: tiêu chí chính
HTMT (Henseler và cộng sự, 2015) so sánh tương quan giữa các câu hỏi của hai thang đo khác nhau với tương quan giữa các câu hỏi trong cùng một thang đo. HTMT gần 1 nghĩa là câu hỏi của hai thang đo tương quan với nhau mạnh gần bằng câu hỏi trong cùng thang đo: hai thang đo khó phân biệt. Cách tính chi tiết đã trình bày ở bài giá trị hội tụ và giá trị phân biệt.
Bước 1. Chọn Heterotrait-monotrait ratio (HTMT) – Matrix (Hình 1).
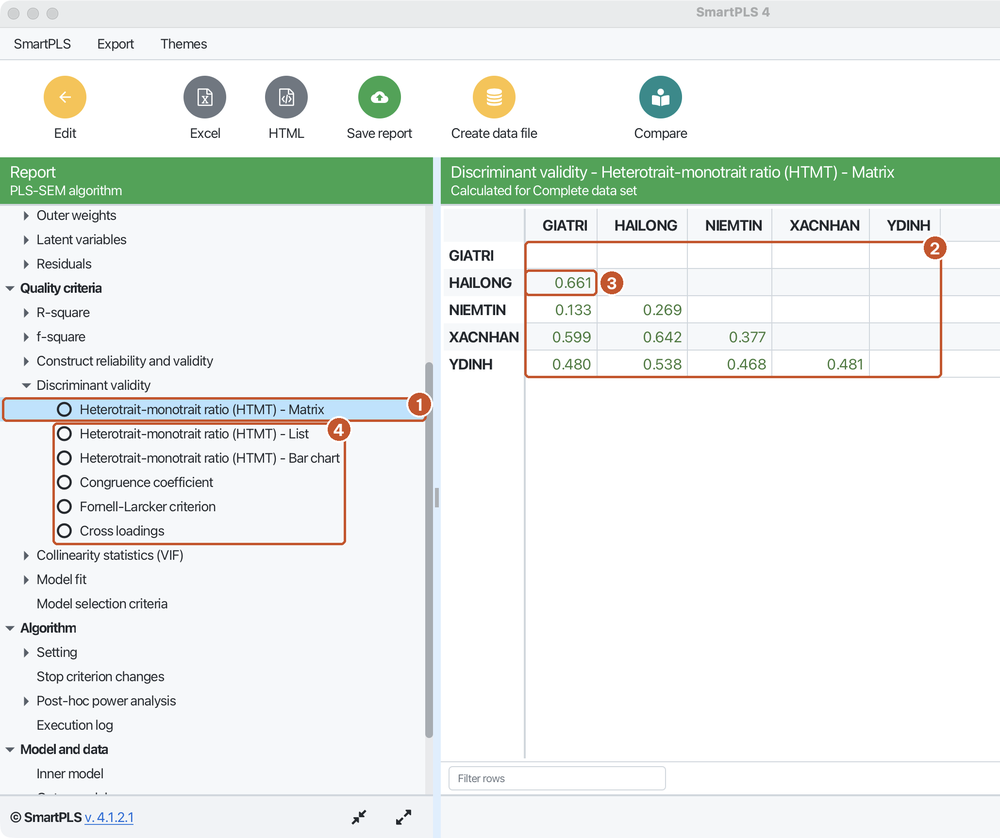
Hình 1. Ma trận HTMT: (1) mục HTMT – Matrix, (2) HTMT của mười cặp khái niệm ở nửa dưới ma trận, (3) cặp cao nhất, Giá trị và Hài lòng, (4) các bảng khác của mục Discriminant validity.
Ngưỡng (Henseler và cộng sự, 2015):
- Dưới 0,85 với các khái niệm khác nhau rõ về lý thuyết.
- Dưới 0,90 với các khái niệm gần nhau về lý thuyết, như Giá trị cảm nhận và Sự hài lòng.
Cách chặt chẽ hơn là kiểm tra HTMT có nhỏ hơn ngưỡng một cách có ý nghĩa thống kê không, bằng khoảng tin cậy bootstrap: cận trên của khoảng tin cậy một phía 95% (phân vị thứ 95) phải nhỏ hơn ngưỡng (Franke & Sarstedt, 2019; Hair và cộng sự, 2019) (Bảng 1).
Bảng 1. HTMT và khoảng tin cậy bootstrap của mười cặp khái niệm.
| Cặp khái niệm | HTMT | Khoảng tin cậy 95% | Phân vị 95 |
|---|---|---|---|
| Giá trị và Hài lòng | 0,661 | 0,554 đến 0,753 | 0,738 |
| Xác nhận và Hài lòng | 0,642 | 0,530 đến 0,735 | 0,720 |
| Xác nhận và Giá trị | 0,599 | 0,476 đến 0,703 | 0,686 |
| Hài lòng và Ý định | 0,538 | 0,419 đến 0,643 | 0,628 |
| Xác nhận và Ý định | 0,481 | 0,345 đến 0,602 | 0,581 |
| Giá trị và Ý định | 0,480 | 0,334 đến 0,604 | 0,589 |
| Niềm tin và Ý định | 0,468 | 0,341 đến 0,590 | 0,572 |
| Xác nhận và Niềm tin | 0,377 | 0,216 đến 0,519 | 0,499 |
| Hài lòng và Niềm tin | 0,269 | 0,105 đến 0,420 | 0,395 |
| Giá trị và Niềm tin | 0,133 | −0,039 đến 0,296 | 0,267 |
HTMT từ SmartPLS. Khoảng tin cậy percentile từ 5000 mẫu bootstrap, tính bằng R (seed 2026) (Hình 2).
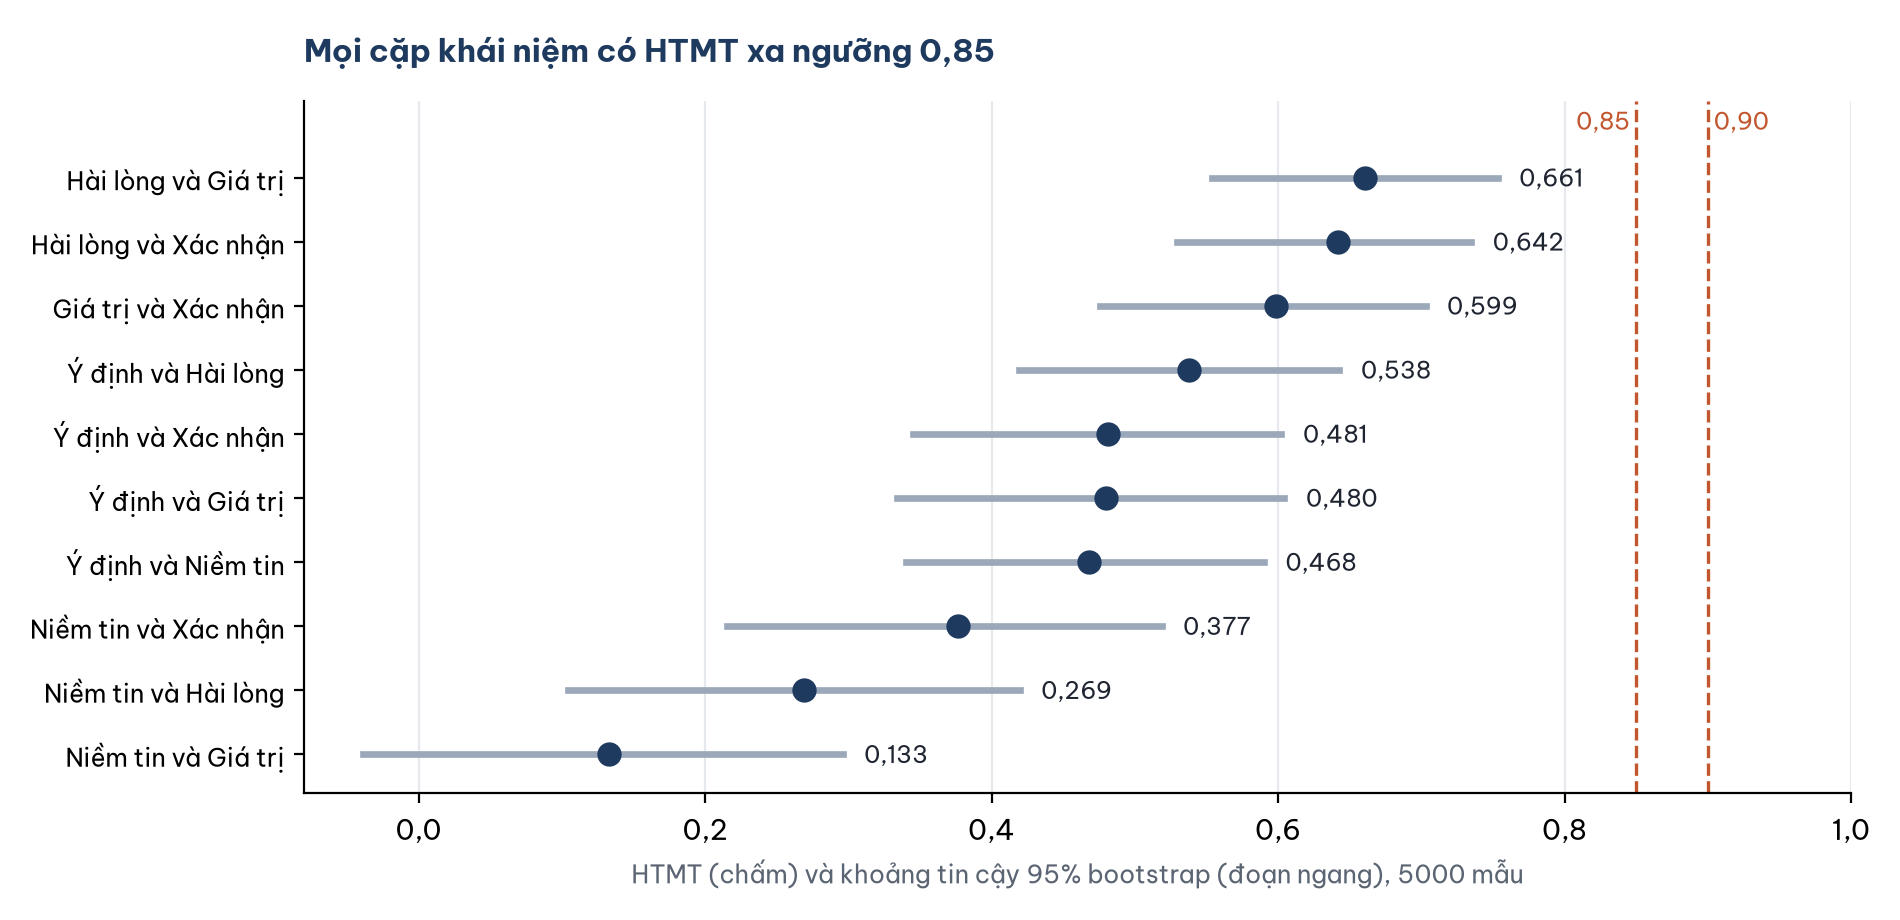
Hình 2. HTMT của mười cặp khái niệm (chấm) và khoảng tin cậy 95% bootstrap (đoạn ngang). Đường đứt đoạn là ngưỡng 0,85 và 0,90.
Kết quả: HTMT cao nhất là 0,661 (Giá trị và Hài lòng), phân vị 95 là 0,738, đều xa ngưỡng 0,85. Mọi cặp khái niệm đạt giá trị phân biệt. Kết quả gần với bài giá trị hội tụ và giá trị phân biệt (0,653 cho cùng cặp), chênh lệch nhỏ vì bài giá trị hội tụ và giá trị phân biệt tính trên 267 người với tương quan pairwise.
HTMT chỉ phụ thuộc vào tương quan giữa các câu hỏi, không phụ thuộc vào cách ước lượng mô hình. Vì vậy HTMT trong SmartPLS, JASP hay R đều cho cùng kết quả trên cùng dữ liệu và không bị thiên lệch như AVE ở bài đánh giá mô hình đo lường reflective.
Bài bootstrapping trong SmartPLS sẽ chạy bootstrap ngay trong SmartPLS và đối chiếu với các khoảng tin cậy ở bảng trên.
3. Tiêu chí Fornell-Larcker
Fornell và Larcker (1981): một khái niệm có giá trị phân biệt khi căn bậc hai AVE của nó lớn hơn tương quan của nó với mọi khái niệm khác.
Bước 2. Chọn Fornell-Larcker criterion (Hình 3). Đường chéo là căn bậc hai AVE; các ô còn lại là tương quan giữa hai biến tiềm ẩn.
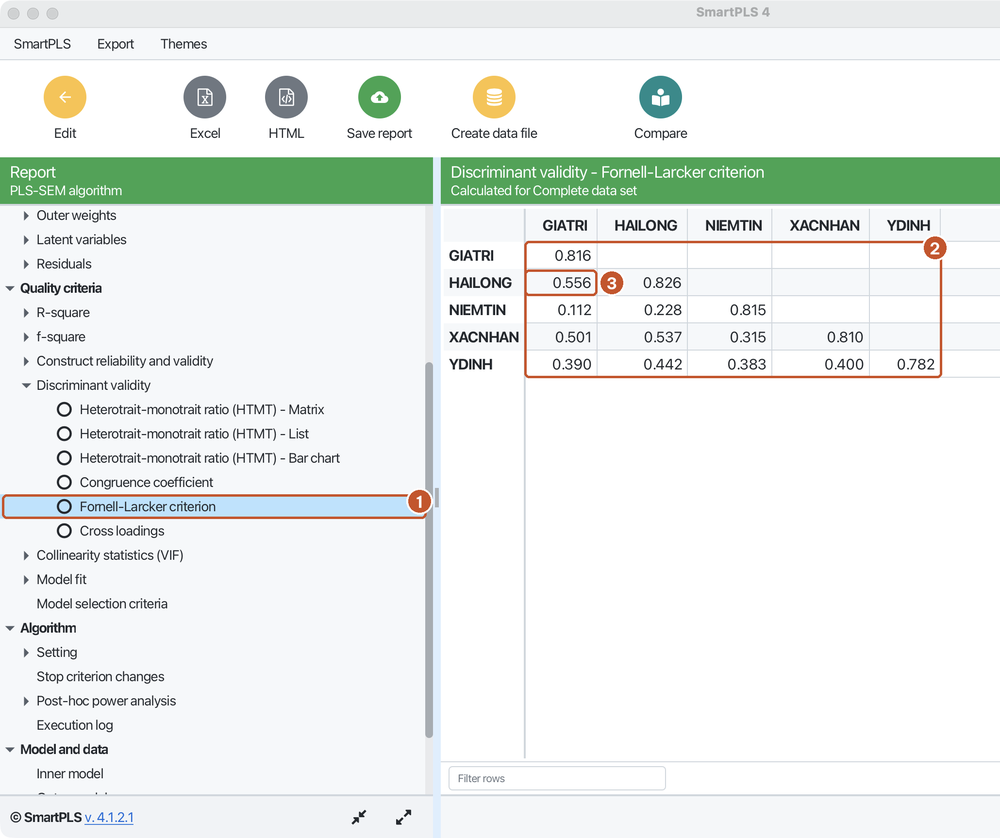
Hình 3. Tiêu chí Fornell-Larcker: (1) mục Fornell-Larcker criterion, (2) bảng với căn bậc hai AVE trên đường chéo, (3) tương quan cao nhất, giữa Giá trị và Hài lòng.
Kết quả: căn bậc hai AVE từ 0,782 (Ý định) đến 0,826 (Hài lòng), đều lớn hơn tương quan cao nhất 0,556 (Giá trị và Hài lòng). Tiêu chí đạt.
Vì sao không dựa vào Fornell-Larcker trong PLS-SEM? Trong PLS-SEM, tiêu chí này bị lệch về phía "dễ đạt" từ cả hai đầu:
- Căn bậc hai AVE bị đẩy cao, vì hệ số tải bị đẩy cao (bài đánh giá mô hình đo lường reflective).
- Tương quan giữa các biến tiềm ẩn bị kéo thấp, vì biến tổng hợp chứa sai số đo lường (bài SmartPLS và PLS-SEM).
Mô phỏng của Henseler và cộng sự (2015) cho thấy tiêu chí Fornell-Larcker thường không phát hiện được khi hai khái niệm thực ra không phân biệt. Hair và cộng sự (2019) vì thế khuyến nghị dùng HTMT thay cho Fornell-Larcker. Nhiều hội đồng vẫn yêu cầu bảng Fornell-Larcker; có thể báo cáo kèm, nhưng kết luận nên dựa trên HTMT.
4. Hệ số tải chéo
Hệ số tải chéo là tương quan của mỗi câu hỏi với điểm của mọi biến tiềm ẩn. Yêu cầu: mỗi câu hỏi tương quan với khái niệm của nó cao hơn với mọi khái niệm khác.
Bước 3. Chọn Cross loadings (Hình 4). Nếu bảng không hiện đủ 20 dòng, kéo thanh thu phóng ở góc dưới bên phải để thu nhỏ bảng.
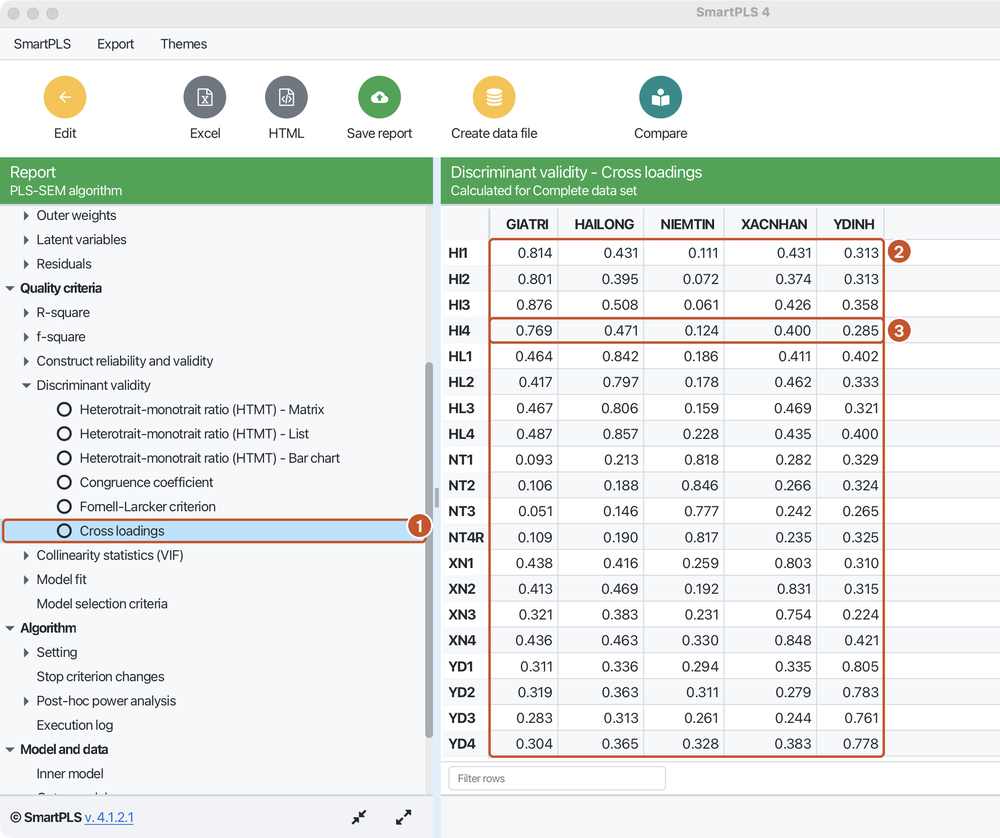
Hình 4. Hệ số tải chéo: (1) mục Cross loadings, (2) bảng tương quan của 20 câu hỏi với năm biến tiềm ẩn, (3) câu HI4, có khoảng cách nhỏ nhất giữa tải riêng và tải chéo.
Kết quả: mỗi câu hỏi có hệ số tải cao nhất trên khái niệm của chính nó. Khoảng cách nhỏ nhất là câu HI4: 0,769 trên Giá trị so với 0,471 trên Hài lòng, chênh 0,298. Tiêu chí đạt.
Cũng như Fornell-Larcker, hệ số tải chéo rất hiếm khi phát hiện vấn đề phân biệt trong PLS-SEM (Henseler và cộng sự, 2015), nên chỉ dùng để tham khảo: nếu một câu hỏi tải chéo cao hơn tải riêng, đó là dấu hiệu rõ ràng cần xem lại nội dung câu hỏi.
5. Khi HTMT vượt ngưỡng thì làm gì?
Dữ liệu sàn X không gặp trường hợp này, nhưng khi HTMT của một cặp vượt 0,85 hoặc 0,90, có thể xem xét theo thứ tự:
- Kiểm tra lý thuyết: hai khái niệm có thực sự khác nhau không, hay chỉ là hai cách gọi của cùng một khái niệm.
- Xem hệ số tải chéo để tìm câu hỏi tương quan cao với khái niệm kia. Câu hỏi có nội dung chồng lấn là ứng viên để xem lại.
- Cân nhắc gộp hai khái niệm nếu lý thuyết cho phép, rồi so sánh mô hình (bài chỉ số độ phù hợp của mô hình đã làm thử với Giá trị và Hài lòng trong CB-SEM).
Không loại câu hỏi chỉ để HTMT giảm xuống dưới ngưỡng mà không xét nội dung.
6. Trình bày kết quả
Đoạn dưới đây là một cách viết kết quả giá trị phân biệt trong luận văn.
Giá trị phân biệt được đánh giá bằng tỷ số HTMT (Henseler và cộng sự, 2015). HTMT của mười cặp khái niệm nằm trong khoảng 0,133 đến 0,661, đều thấp hơn ngưỡng thận trọng 0,85. Khoảng tin cậy bootstrap (5000 mẫu) cho thấy phân vị thứ 95 của HTMT cao nhất (Giá trị cảm nhận và Sự hài lòng) là 0,738, nhỏ hơn 0,85 (Franke & Sarstedt, 2019). Tiêu chí Fornell-Larcker và hệ số tải chéo cũng cho cùng kết luận. Các thang đo đạt giá trị phân biệt.
Bảng nên trình bày ma trận HTMT (như Hình 1) kèm cột khoảng tin cậy cho các cặp có HTMT cao nhất.
Bốn lỗi thường gặp
Các lỗi dưới đây hay gặp khi đánh giá giá trị phân biệt trong PLS-SEM.
- Chỉ báo cáo Fornell-Larcker trong nghiên cứu dùng PLS-SEM. Tiêu chí này dễ đạt và bỏ sót vấn đề.
- Dùng ngưỡng 0,90 cho mọi cặp để "an toàn". Ngưỡng 0,90 chỉ dành cho khái niệm gần nhau về lý thuyết; nêu rõ lý do khi dùng.
- Đọc nhầm nửa trên của ma trận. SmartPLS chỉ điền nửa dưới; ô trống không có nghĩa là bằng 0.
- Dùng HTMT cho thang đo formative. HTMT dành cho thang đo reflective (bài mô hình đo lường formative bàn về thang đo formative).
Tài liệu tham khảo
Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.2307/3151312
Franke, G., & Sarstedt, M. (2019). Heuristics versus statistics in discriminant validity testing: A comparison of four procedures. Internet Research, 29(3), 430–447. https://doi.org/10.1108/IntR-12-2017-0515
Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/EBR-11-2018-0203
Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
Ringle, C. M., Wende, S., & Becker, J.-M. (2026). SmartPLS 4 (Version 4.1.2.1) [Computer software]. SmartPLS GmbH. https://www.smartpls.com