
CHUẨN BỊ DỮ LIỆU KHẢO SÁT CHO CFA VÀ SEM
Kiểm tra phạm vi, đảo chiều câu ngược, xử lý dữ liệu thiếu rồi mở file trong JASP hoặc kết nối vào AMOS
Bài nên đọc trước
Ở bài vẽ mô hình đầu tiên, mô hình đầu tiên chạy được sau khi đổi kiểu biến trong JASP và chọn FIML. Trong thực tế, phần lớn lỗi khi chạy CFA, SEM lần đầu không nằm ở mô hình mà ở file dữ liệu: tên biến trùng với biến tiềm ẩn, câu hỏi đảo chiều chưa được mã hóa lại, kiểu biến khiến phần mềm dùng sai phương pháp ước lượng, hoặc ô trống bị xử lý theo mặc định không mong muốn. Bài này hướng dẫn chuẩn bị một file dữ liệu sạch cho CFA và SEM, quyết định cách xử lý dữ liệu thiếu, rồi mở và đồng bộ file đó trong JASP.
Phần chuẩn bị dữ liệu dùng PSPP (Free Software Foundation, 2023) với kết quả thật, từ file cú pháp chuan_bi_du_lieu_amos.sps. Phần phân tích dữ liệu thiếu dùng R và gói lavaan (Rosseel, 2012), file so_sanh_xu_ly_thieu.R. Ảnh JASP được chụp từ JASP 0.99.0 (JASP Team, 2026). Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
21-chuan-bi-du-lieu-cfa-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Sáu bước chuẩn bị file dữ liệu
Trước khi đưa vào JASP hoặc AMOS, file dữ liệu cần qua sáu bước chuẩn bị (Hình 1).
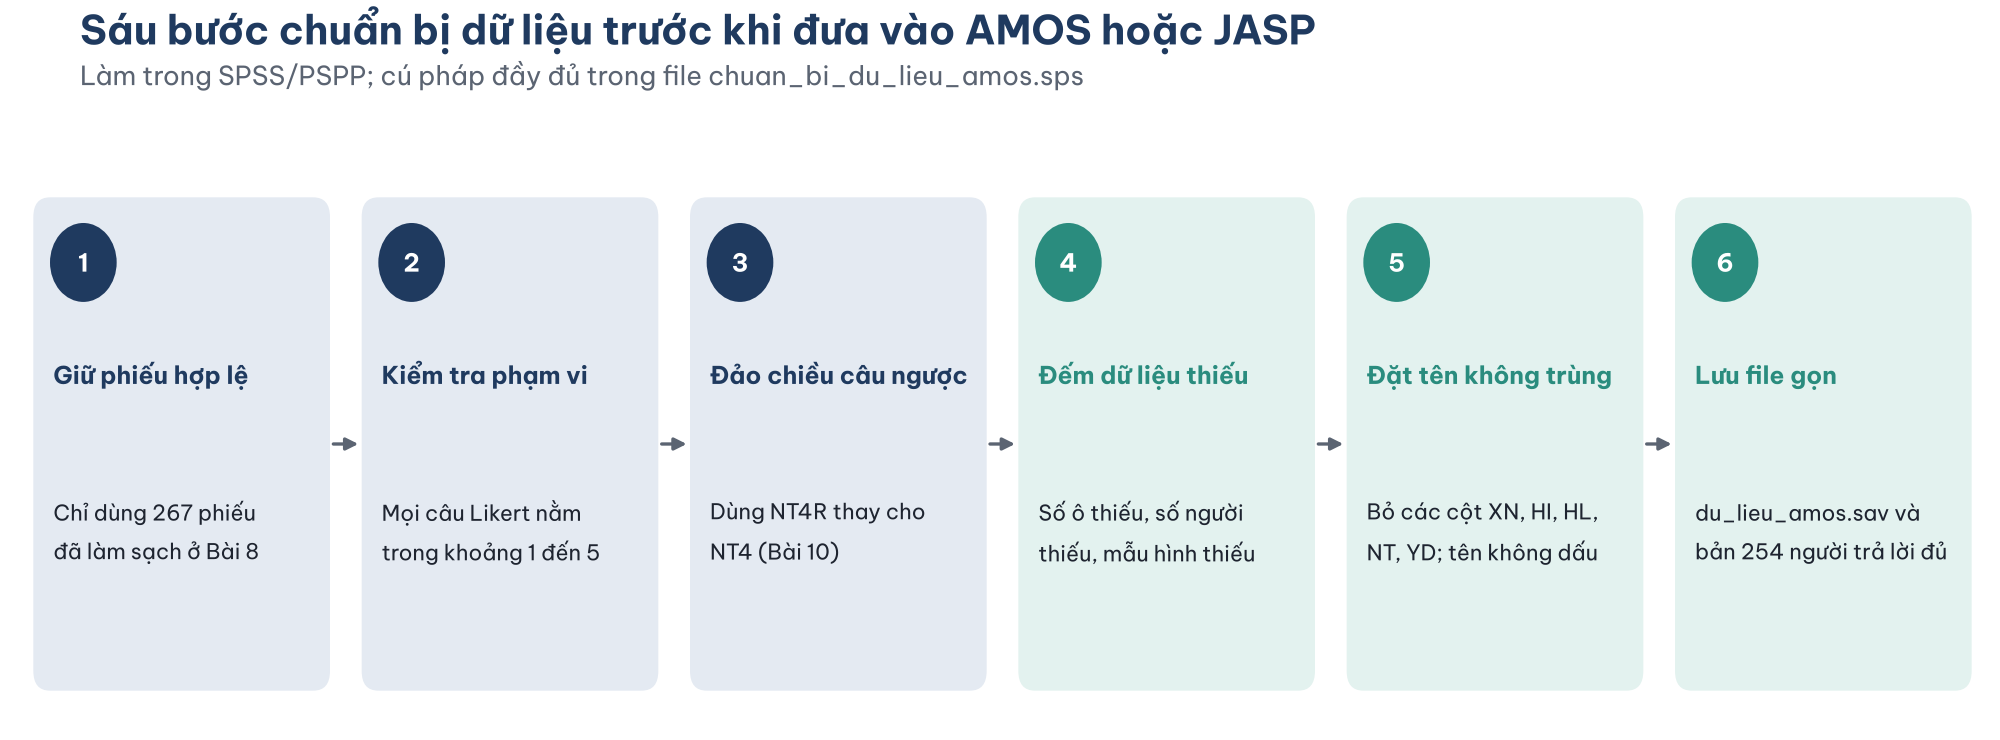
Hình 1. Sáu bước chuẩn bị file dữ liệu trong SPSS/PSPP trước khi đưa vào JASP hoặc AMOS.
Bước 1. Giữ phiếu hợp lệ
Chỉ dùng các phiếu đã qua bước làm sạch ở bài làm sạch dữ liệu: loại phiếu không qua câu gạn lọc, sai câu kiểm tra chú ý, trả lời một mức cho mọi câu. File du_lieu_phan_tich.sav còn 267 phiếu.
Bước 2. Kiểm tra phạm vi giá trị
Mọi câu hỏi Likert phải nằm trong khoảng 1 đến 5. Một giá trị 55 lọt vào (như lỗi ở câu HL2 phát hiện ở bài làm sạch dữ liệu) sẽ làm lệch toàn bộ ma trận hiệp phương sai mà phần mềm SEM không hề cảnh báo.
DESCRIPTIVES VARIABLES=XN1 XN2 XN3 XN4 HI1 HI2 HI3 HI4 HL1 HL2 HL3 HL4
    NT1 NT2 NT3 NT4R YD1 YD2 YD3 YD4
  /STATISTICS=MEAN STDDEV MIN MAX.
Kết quả chạy lệnh trên trong PSPP được trình bày ở Hình 2.
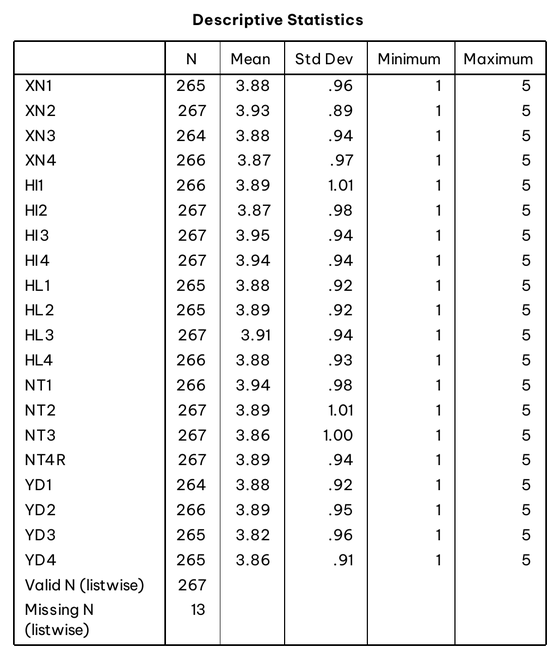
Hình 2. Kết quả trong PSPP. Cột Minimum và Maximum cho thấy mọi câu nằm trong khoảng 1 đến 5; cột N cho thấy số người trả lời từng câu.
Cột N cho biết mỗi câu có bao nhiêu người trả lời: từ 264 (XN3, YD1) đến 267. Lưu ý dòng Valid N (listwise) của PSPP 2.0.0 ghi 267, không khớp với thực tế (chỉ 254 người trả lời đủ cả 20 câu, xem Bước 4). Vì vậy bài dùng lệnh COUNT để đếm chính xác.
Bước 3. Đảo chiều câu hỏi ngược
Câu NT4 ("Tôi lo ngại sàn X không giữ cam kết") ngược chiều với các câu Niềm tin còn lại. Dùng NT4R (đã đảo chiều ở bài tính biến đại diện) trong mô hình, không dùng NT4. Nếu đưa nhầm NT4 vào, hệ số tải của câu này sẽ âm và độ tin cậy của thang đo giảm mạnh, như đã thấy với Cronbach's Alpha ở bài Cronbach's Alpha.
Bước 4. Đếm dữ liệu thiếu
COUNT SO_THIEU = XN1 XN2 XN3 XN4 HI1 HI2 HI3 HI4 HL1 HL2 HL3 HL4
    NT1 NT2 NT3 NT4R YD1 YD2 YD3 YD4 (MISSING).
FREQUENCIES SO_THIEU.
Phân bố số câu bỏ trống của mỗi người được trình bày ở Hình 3.
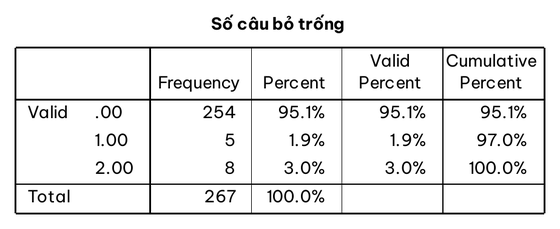
Hình 3. Phân bố số câu bỏ trống (trong 20 câu của mô hình) của mỗi người trả lời.
- 254 người (95,1%) trả lời đủ 20 câu.
- 5 người bỏ trống 1 câu, 8 người bỏ trống 2 câu.
- Tổng cộng 21 ô thiếu trên 5.340 ô (267 × 20), tức 0,39%.
Bước 5. Đặt tên biến không trùng
File du_lieu_phan_tich.sav có các cột XN, HI, HL, NT, YD (điểm trung bình tạo ở bài tính biến đại diện). Nếu giữ các cột này, bạn không được đặt các tên đó cho nhân tố, vì lavaan (bên trong JASP) sẽ báo lỗi trùng tên (bài vẽ mô hình đầu tiên). Cách gọn nhất là bỏ các cột điểm trung bình khỏi file dành cho CFA và SEM. Ngoài ra:
- Dùng tên không dấu, không khoảng trắng (XN1, NT4R), tối đa vài chục kí tự.
- Chuyển mã thiếu do người dùng khai báo (ví dụ 9 hoặc 99 nghĩa là "không trả lời") thành ô trống (system-missing). File mẫu không có mã loại này, nhưng đây là lỗi hay gặp khi nhập liệu từ Excel.
Bước 6. Lưu file gọn cho CFA và SEM
SAVE OUTFILE='du_lieu_amos.sav'
  /KEEP=ID GIOITINH NGHE THUNHAP NHOMTUOI
        XN1 XN2 XN3 XN4 HI1 HI2 HI3 HI4 HL1 HL2 HL3 HL4
        NT1 NT2 NT3 NT4R YD1 YD2 YD3 YD4 SO_THIEU.
File cú pháp đi kèm tạo ba file trong thư mục du-lieu (Bảng 1):
Bảng 1. Ba file dữ liệu tạo từ file cú pháp.
| File | Số người | Dùng khi |
|---|---|---|
du_lieu_amos.sav |
267 | CFA, SEM với FIML (mặc định của chuỗi bài) |
du_lieu_amos_du.sav |
254 | Cần bootstrap hoặc chỉ số điều chỉnh trong AMOS (mục 3); đối chiếu độ vững |
du_lieu_amos.csv |
267 | Phần mềm không đọc được file .sav |
Các biến nhóm (GIOITINH, NGHE, THUNHAP, NHOMTUOI) được giữ lại cho phân tích đa nhóm ở bài phân tích đa nhóm. File cú pháp cũng khai báo 20 câu hỏi là biến định lượng (VARIABLE LEVEL ... (SCALE)). Đây là bước quan trọng với JASP: JASP đọc kiểu biến từ file .sav và nếu câu hỏi là Ordinal, JASP sẽ ước lượng bằng DWLS thay vì ML (bài vẽ mô hình đầu tiên). Khai báo trước trong SPSS giúp bỏ qua bước đổi kiểu biến bằng tay trong JASP.
2. Dữ liệu thiếu có ngẫu nhiên không?
Cách xử lý dữ liệu thiếu phụ thuộc vào cơ chế gây ra nó (Enders, 2022):
- MCAR (missing completely at random): thiếu hoàn toàn ngẫu nhiên, không liên quan đến bất kỳ biến nào. Ví dụ người trả lời vô tình bỏ sót một dòng.
- MAR (missing at random): thiếu liên quan đến các biến có trong dữ liệu. Ví dụ người lớn tuổi hay bỏ trống câu về ứng dụng di động hơn.
- MNAR (missing not at random): thiếu liên quan đến chính giá trị bị thiếu. Ví dụ người rất không hài lòng cố tình bỏ trống câu về sự hài lòng.
Kiểm định MCAR của Little (Little, 1988) so sánh trung bình của các nhóm người có cùng mẫu hình thiếu. Giả thuyết H0 là dữ liệu thiếu hoàn toàn ngẫu nhiên. JASP, AMOS và PSPP không có kiểm định này; SPSS có trong mô-đun Missing Value Analysis. File so_sanh_xu_ly_thieu.R tính trực tiếp theo công thức của Little:
Chi bình phương = 223,26; df = 239; p = 0,760.
p lớn hơn 0,05 nên không bác bỏ giả thuyết MCAR: không có bằng chứng dữ liệu thiếu theo một quy luật nào. Lưu ý kiểm định này chỉ phát hiện được sai lệch khỏi MCAR, không chứng minh được dữ liệu là MCAR và không phân biệt được MAR với MNAR.
3. Chọn cách xử lý dữ liệu thiếu
Cách xử lý dữ liệu thiếu phụ thuộc vào cơ chế thiếu và phần mềm sẽ dùng (Hình 4).
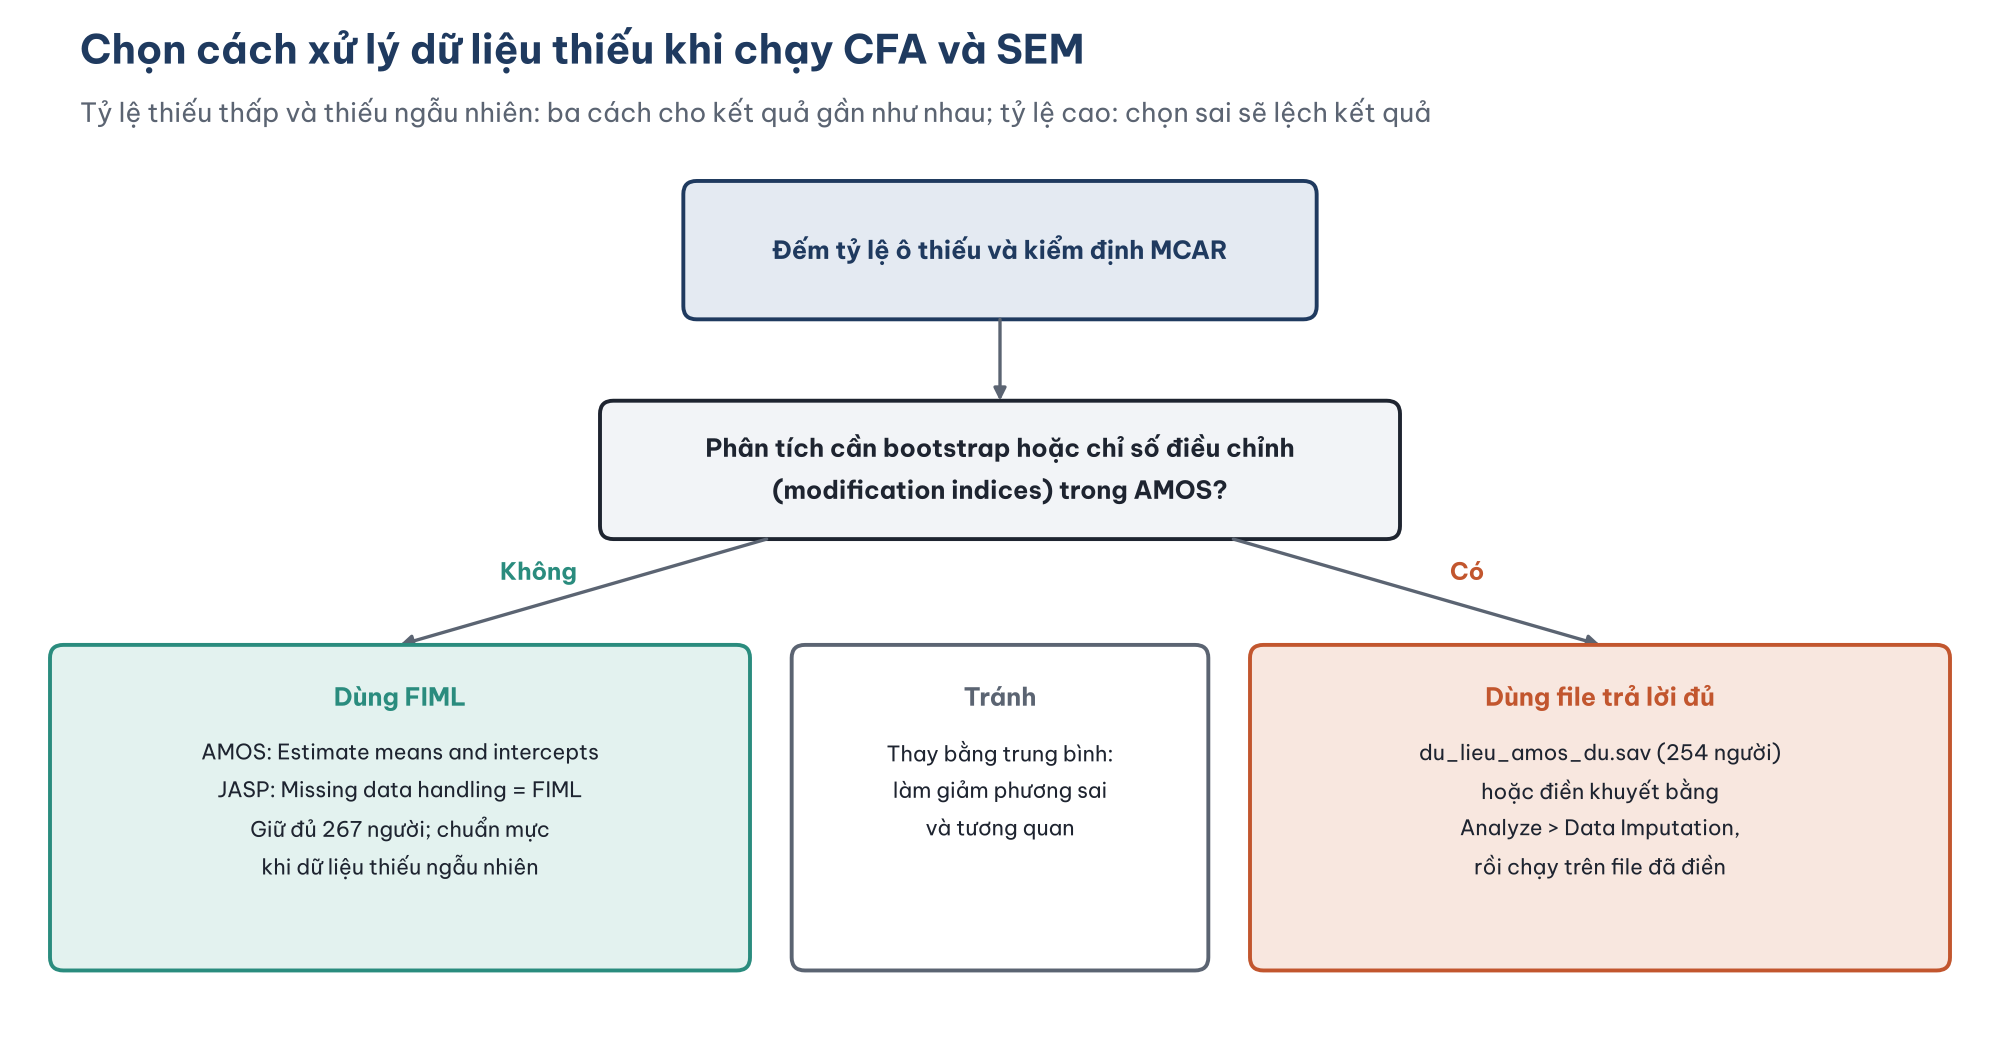
Hình 4. Quy trình chọn cách xử lý dữ liệu thiếu khi chạy CFA và SEM. Nhánh "Có" là giới hạn riêng của AMOS; JASP không có giới hạn này.
Có ba cách phổ biến:
- FIML (full information maximum likelihood). Ước lượng mô hình từ mọi thông tin có được của từng người, không bỏ ai. Đây là cách được khuyến nghị khi dữ liệu thiếu là MCAR hoặc MAR (Enders, 2022). Trong JASP: chọn Missing data handling = FIML trong mục Advanced của phân tích (mặc định là Listwise deletion).
- Xóa theo danh sách (listwise deletion). Loại mọi người có ít nhất một ô trống. Đơn giản, không lệch khi dữ liệu là MCAR, nhưng mất cỡ mẫu.
- Thay bằng trung bình (mean substitution). Điền ô trống bằng trung bình của câu đó. Cách này làm giảm phương sai và tương quan, nên không nên dùng (Enders, 2022).
So sánh ba cách trên dữ liệu mẫu
File so_sanh_xu_ly_thieu.R chạy mô hình đo lường 5 nhân tố (20 câu hỏi, sẽ phân tích kỹ ở bài phân tích nhân tố khẳng định (CFA)) theo ba cách (Bảng 2):
Bảng 2. So sánh ba cách xử lý dữ liệu thiếu trên dữ liệu mẫu.
| Cách xử lý | N | Chi bình phương (df = 160) | CFI | RMSEA | SRMR | Hệ số tải chuẩn hóa |
|---|---|---|---|---|---|---|
| Xóa theo danh sách | 254 | 137,05 | 1,000 | 0,000 | 0,035 | 0,67 đến 0,85 |
| FIML | 267 | 134,29 | 1,000 | 0,000 | 0,032 | 0,65 đến 0,85 |
| Thay bằng trung bình | 267 | 134,84 | 1,000 | 0,000 | 0,034 | 0,65 đến 0,85 |
Với chỉ 0,39% ô thiếu và dữ liệu MCAR, ba cách cho kết quả gần như trùng nhau: hệ số tải chuẩn hóa chênh lệch tối đa 0,014 giữa xóa theo danh sách và FIML. Kết luận này không áp dụng khi tỷ lệ thiếu cao (thường từ 5% trở lên) hoặc dữ liệu không thiếu ngẫu nhiên: khi đó lựa chọn sai có thể làm lệch đáng kể hệ số và sai số chuẩn.
Giới hạn của AMOS khi dữ liệu có ô trống
Khi chọn Estimate means and intercepts với dữ liệu có ô trống, AMOS không cung cấp một số kết quả (Byrne, 2016):
- Chỉ số điều chỉnh (modification indices), dùng để tìm chỗ cải thiện mô hình ở bài phân tích nhân tố khẳng định (CFA) và bài chỉ số độ phù hợp của mô hình.
- Bootstrap, dùng để kiểm định tác động gián tiếp ở bài biến trung gian trong SEM và hiệu chỉnh khi dữ liệu lệch chuẩn.
- Một số chỉ số phù hợp như GFI và AGFI.
Khi cần các kết quả này, có hai lựa chọn:
- Dùng file trả lời đủ
du_lieu_amos_du.sav(254 người). Với dữ liệu mẫu, kết quả gần như không đổi so với FIML như bảng trên. - Điền khuyết trong AMOS bằng Analyze > Data Imputation. AMOS có ba phương pháp: Regression imputation, Stochastic regression imputation và Bayesian imputation. AMOS tạo một file dữ liệu mới đã điền đủ và bạn chạy mô hình trên file đó. Nên dùng Stochastic regression hoặc Bayesian vì chúng giữ được độ biến thiên tự nhiên của dữ liệu.
Chuỗi bài dùng FIML với file 267 người làm mặc định và chuyển sang file 254 người ở những bài cần bootstrap. Khi viết luận văn, hãy ghi rõ cách xử lý đã chọn và lý do.
4. Mở và đồng bộ dữ liệu trong JASP
File đã chuẩn bị được mở trong JASP, kiểm tra lại dữ liệu thiếu và giữ liên kết với file gốc để cập nhật khi dữ liệu thay đổi.
Mở file đã chuẩn bị
JASP mở trực tiếp file .sav đã lưu ở Bước 6.
- Bấm biểu tượng ba gạch, chọn Open > Computer > Browse, rồi chọn
du_lieu_amos.sav(như bài vẽ mô hình đầu tiên). - Kiểm tra biểu tượng kiểu biến ở đầu các cột câu hỏi: phải là thước kẻ (Scale), nhờ khai báo
VARIABLE LEVELở Bước 6 (Hình 5, ô 1). Không cần đổi kiểu biến bằng tay như ở bài vẽ mô hình đầu tiên. - Kiểm tra ô trống: JASP hiển thị dấu chấm (Hình 5, ô 2) cho giá trị thiếu.
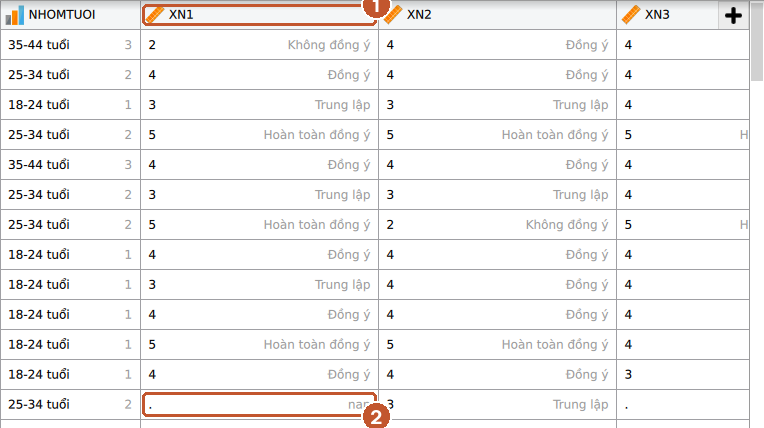
Hình 5. (1) Câu XN1 đã ở kiểu Scale ngay khi mở file, (2) ô thiếu của người thứ 13 hiển thị bằng dấu chấm.
Kiểm tra dữ liệu thiếu bằng Descriptives
Chọn Descriptives > Descriptive Statistics, đưa XN1 đến YD4 vào ô Variables, đánh dấu Transpose descriptives table để mỗi câu nằm trên một dòng (Hình 6).
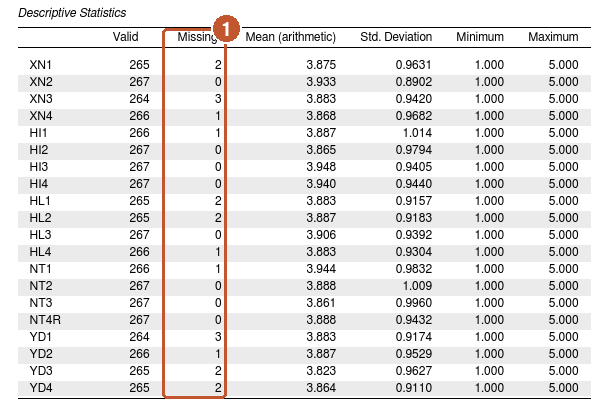
Hình 6. (1) Cột Missing cho số ô thiếu của từng câu, khớp với kết quả PSPP ở Hình 2.
Cột Missing cho thấy XN3 và YD1 thiếu nhiều nhất (3 ô); tổng 21 ô, khớp với PSPP.
Đồng bộ khi dữ liệu thay đổi
JASP lưu một bản sao dữ liệu trong file .jasp. Nếu sau đó bạn sửa file .sav trong SPSS (thêm phiếu, sửa lỗi nhập liệu), JASP có thể đồng bộ để cập nhật dữ liệu và chạy lại mọi phân tích:
- Bấm biểu tượng ba gạch, chọn Sync Data (Hình 7, ô 1).
- Bấm vào tên file nguồn trong mục Current File (Hình 7, ô 2), hoặc nhấn Ctrl+Y.
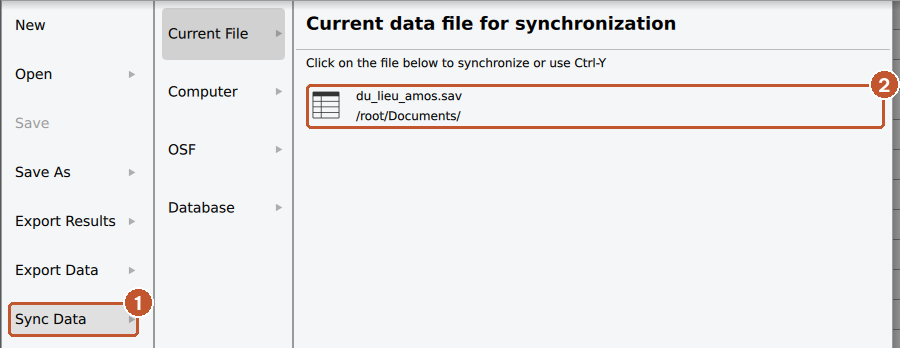
Hình 7. (1) Menu Sync Data, (2) file nguồn đang liên kết với phân tích.
Nếu đổi tên một biến trong SPSS, biến đó sẽ biến mất khỏi các phân tích đang dùng nó trong JASP; cần đưa lại biến mới vào.
Lưu file .jasp
Sau khi mở và kiểm tra, lưu bằng Ctrl+S thành bai-21-du-lieu.jasp. Các bài sau mở file này để chạy CFA (bài phân tích nhân tố khẳng định (CFA)) và SEM (bài mô hình cấu trúc SEM).
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, file đã chuẩn bị được kết nối vào mô hình qua hộp thoại Data Files (Hình 8).
Mở dữ liệu từ hộp thoại Data Files
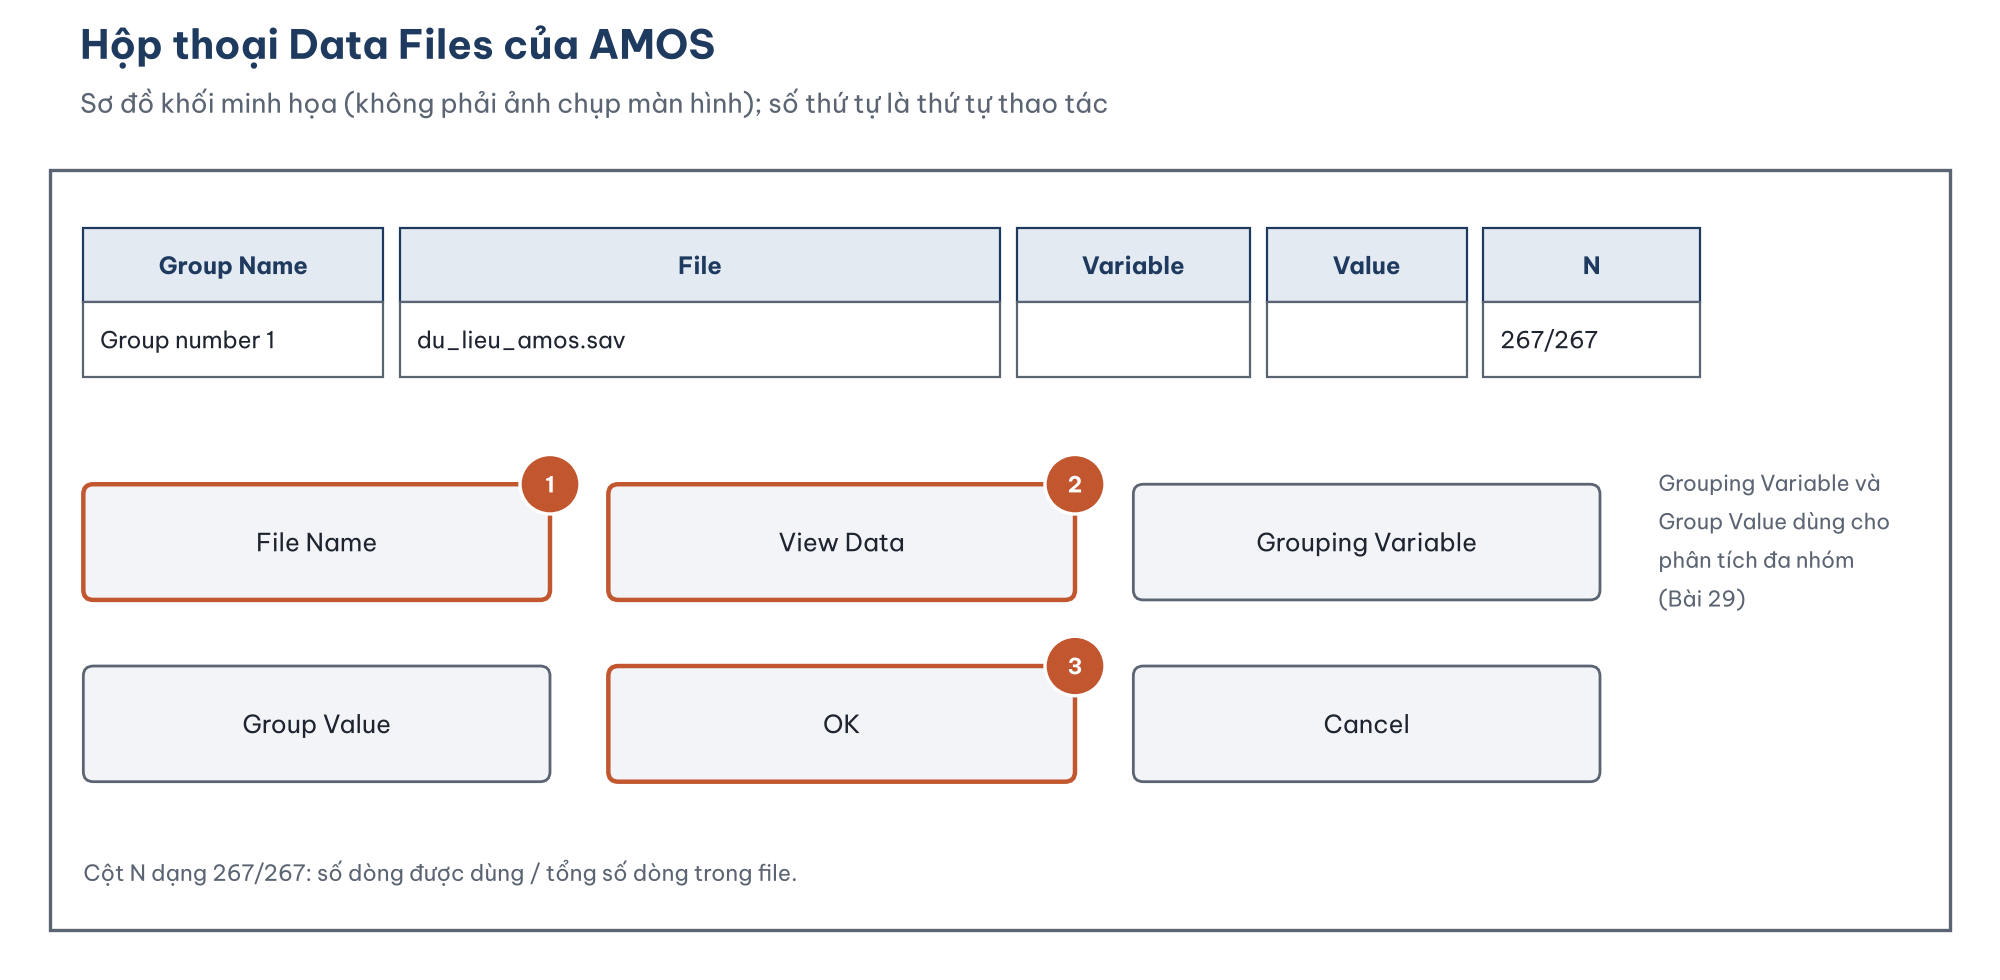
Hình 8. Sơ đồ khối hộp thoại Data Files. (1) Chọn file, (2) xem dữ liệu, (3) xác nhận.
- Mở File > Data Files (Ctrl+D), hoặc bấm biểu tượng Select data file(s) trong hộp công cụ.
- Bấm File Name (ô 1), chọn
du_lieu_amos.sav, rồi bấm Open. Muốn mở file Excel hoặc.csv, đổi ô Files of type ở góc dưới hộp thoại. - Kiểm tra cột N: phải hiện 267/267, nghĩa là AMOS đọc đủ 267 dòng của file.
- Bấm View Data (ô 2) nếu muốn mở file trong chương trình gốc (SPSS) để xem lại.
- Bấm OK (ô 3).
Hai nút Grouping Variable và Group Value dùng để chọn một nhóm con (ví dụ chỉ nữ) hoặc cho phân tích đa nhóm ở bài phân tích đa nhóm. Ở bài này để trống.
Mở AMOS từ SPSS
Nếu đang mở file trong SPSS Statistics, chọn Analyze > IBM SPSS Amos. AMOS mở ra và tự kết nối với file đang mở. Cần lưu file trong SPSS trước, vì AMOS đọc bản đã lưu trên đĩa, không đọc các thay đổi chưa lưu.
Kiểm tra danh sách biến
Mở View > Variables in Dataset (Ctrl+Shift+D). Danh sách phải có đủ XN1 đến YD4 (với NT4R thay cho NT4) và không còn các cột XN, HI, HL, NT, YD. Từ đây, kéo tên biến vào sơ đồ như ở bài vẽ mô hình đầu tiên.
Khi dữ liệu thay đổi
AMOS đọc file .sav mỗi lần chạy. Nếu sửa dữ liệu trong SPSS (ví dụ thêm phiếu), chỉ cần lưu file trong SPSS rồi chạy lại mô hình trong AMOS. Nếu đổi tên một biến, phải sửa tên đó trong sơ đồ AMOS, vì AMOS không tự cập nhật.
5. Năm lỗi thường gặp khi kết nối dữ liệu
Các lỗi dưới đây hay gặp khi đưa dữ liệu từ SPSS hoặc PSPP vào JASP.
- Giữ cột điểm trung bình trùng tên với nhân tố. lavaan trong JASP báo lỗi trùng tên.
- Đưa nhầm câu chưa đảo chiều. Hệ số tải âm, độ tin cậy giảm.
- Để câu hỏi ở kiểu Ordinal. JASP ước lượng bằng DWLS thay vì ML, kết quả không khớp với AMOS và với các bài hướng dẫn dùng ML.
- Dùng mã 9 hoặc 99 cho ô trống mà không chuyển thành system-missing. Các giá trị này bị tính như câu trả lời thật.
- Để mặc định Listwise deletion. JASP loại 13 người có ô trống mà không báo; chọn FIML trong mục Advanced của từng phân tích.
Với AMOS, ba lỗi riêng cần tránh là quên chọn Estimate means and intercepts khi dữ liệu có ô trống (AMOS dừng lại và yêu cầu chọn), vẽ cột điểm trung bình trùng tên với biến tiềm ẩn và sửa dữ liệu trong SPSS mà không lưu, vì AMOS đọc bản đã lưu trên đĩa.
Tài liệu tham khảo
Byrne, B. M. (2016). Structural equation modeling with AMOS: Basic concepts, applications, and programming (3rd ed.). Routledge. https://www.routledge.com/Structural-Equation-Modeling-With-AMOS-Basic-Concepts-Applications-and/Byrne/p/book/9781138797031
Enders, C. K. (2022). Applied missing data analysis (2nd ed.). Guilford Press. https://www.guilford.com/books/Applied-Missing-Data-Analysis/Craig-Enders/9781462549863
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02