
AMOS VÀ MÔ HÌNH CẤU TRÚC TUYẾN TÍNH CB-SEM
CB-SEM làm được gì mà hồi quy không làm được, khi nào nên chuyển từ SPSS sang AMOS cho mô hình cấu trúc
Bài nên đọc trước
Các bài về SPSS trong loạt bài đã đi trọn một vòng phân tích: làm sạch dữ liệu, kiểm tra độ tin cậy bằng Cronbach's Alpha, khám phá cấu trúc thang đo bằng EFA, rồi chạy hồi quy trên điểm trung bình của từng thang đo. Cách làm này có một giả định ngầm ít khi được nói ra: điểm trung bình của bốn câu hỏi được coi là đo chính xác khái niệm, không có sai số.
Bài này mở đầu cụm AMOS. Bài giải thích AMOS là gì, mô hình cấu trúc tuyến tính dựa trên hiệp phương sai (CB-SEM) khác hồi quy ở điểm nào và khi nào nên chuyển từ SPSS sang AMOS. Để thấy sự khác biệt bằng số liệu thật, bài chạy cùng một mô hình theo hai cách trên bộ dữ liệu mẫu 267 người: hồi quy như bài hồi quy tuyến tính bội và CB-SEM.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
19-amos-la-gi-cb-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. AMOS là gì?
IBM SPSS Amos (Analysis of Moment Structures) là phần mềm mô hình cấu trúc tuyến tính (structural equation modeling, SEM) của IBM, phiên bản hiện tại là Amos 32 (IBM Corp., 2026). Điểm mạnh làm nên sự phổ biến của AMOS là vẽ mô hình bằng sơ đồ: người dùng kéo thả hình bầu dục, hình chữ nhật và mũi tên trong cửa sổ Amos Graphics, rồi bấm chạy để ước lượng toàn bộ mô hình cùng lúc (Byrne, 2016).
Một số điểm cần biết trước khi học:
- Chỉ chạy trên Windows. AMOS là ứng dụng độc lập, không có bản cho macOS hay Linux.
- Đọc trực tiếp file .sav của SPSS. Dữ liệu đã làm sạch ở cụm bài SPSS dùng được ngay.
- Ước lượng mặc định là hợp lý cực đại (maximum likelihood, ML). Phương pháp này giả định dữ liệu xấp xỉ phân phối chuẩn đa biến.
- Có bootstrap để tính khoảng tin cậy cho tác động gián tiếp và hiệu chỉnh khi dữ liệu lệch chuẩn (Bollen-Stine).
- Là phần mềm thương mại. AMOS có trong một số gói SPSS Statistics hoặc được bán riêng.
2. CB-SEM là gì?
CB-SEM là phương pháp mà AMOS dùng để ước lượng mô hình.
Biến tiềm ẩn và biến quan sát
Các khái niệm trong mô hình mẫu, như Sự hài lòng hay Ý định mua lại, không đo trực tiếp được. Ta chỉ quan sát được câu trả lời cho bốn câu hỏi về mỗi khái niệm. Trong SEM:
- Biến tiềm ẩn (latent variable) là khái niệm không đo trực tiếp, ví dụ HL.
- Biến quan sát (observed variable) là từng câu hỏi, ví dụ HL1 đến HL4.
Mỗi câu trả lời được coi là gồm hai phần: phần phản ánh khái niệm chung và sai số đo lường riêng của câu hỏi đó (cách diễn đạt, cách người trả lời hiểu câu hỏi, sự ngẫu nhiên khi chọn mức).
Hai phần của một mô hình SEM
Mỗi mô hình SEM gồm hai phần gắn với nhau.
- Mô hình đo lường (measurement model): mỗi biến tiềm ẩn được đo bằng những câu hỏi nào và mỗi câu hỏi phản ánh khái niệm tốt đến đâu (hệ số tải). Kiểm định mô hình đo lường chính là phân tích nhân tố khẳng định (CFA), nội dung bài phân tích nhân tố khẳng định (CFA).
- Mô hình cấu trúc (structural model): các biến tiềm ẩn tác động lẫn nhau như thế nào, tức các giả thuyết nghiên cứu. Đây là nội dung của các bài về mô hình cấu trúc và kiểm định giả thuyết trong SEM.
Quy trình chuẩn là đánh giá mô hình đo lường trước, rồi mới đến mô hình cấu trúc (Anderson & Gerbing, 1988). Nếu thang đo không đạt, kết luận về giả thuyết không còn ý nghĩa.
Vì sao gọi là "dựa trên hiệp phương sai"?
CB-SEM tìm bộ tham số (hệ số tải, hệ số đường dẫn, phương sai sai số) sao cho ma trận hiệp phương sai do mô hình tái tạo càng gần càng tốt với ma trận hiệp phương sai của dữ liệu (Kline, 2023). Với 20 câu hỏi, dữ liệu có 20 × 21 / 2 = 210 phương sai và hiệp phương sai. Mô hình mẫu ước lượng 48 tham số tự do, nên còn 210 − 48 = 162 bậc tự do. Bậc tự do này cho phép kiểm định mức phù hợp của cả mô hình bằng chỉ số chi bình phương và các chỉ số như CFI, TLI, RMSEA, SRMR (bài chỉ số độ phù hợp của mô hình). Hồi quy không có khái niệm tương đương.
Kí hiệu trong sơ đồ AMOS
Sơ đồ AMOS dùng một bộ kí hiệu thống nhất cho biến và quan hệ (Hình 1).
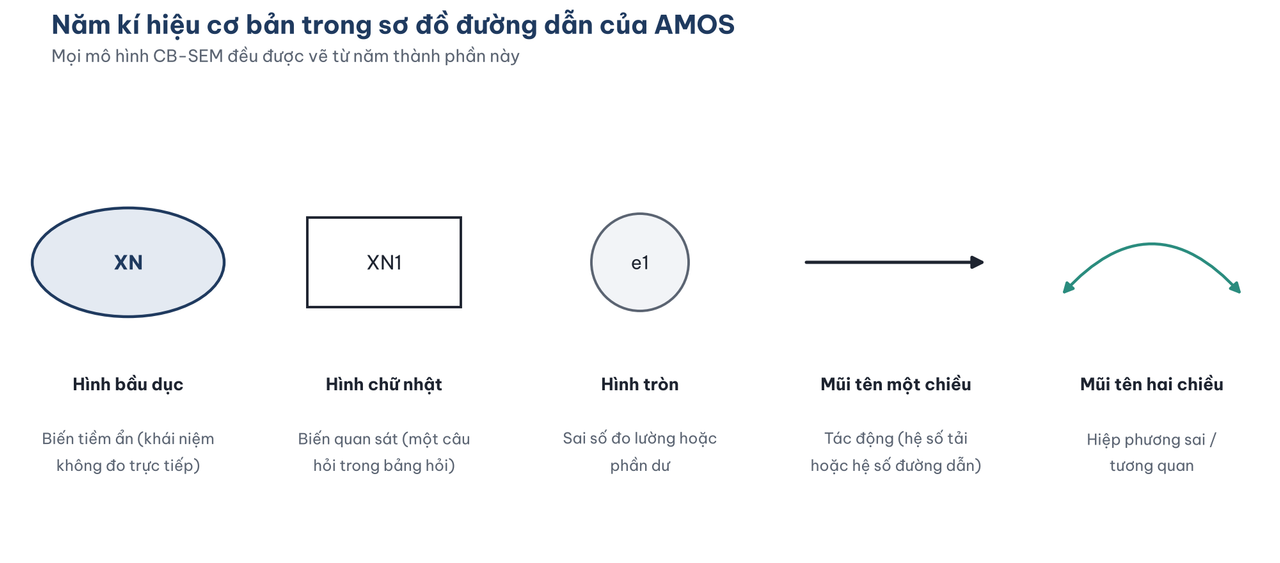
Hình 1. Năm kí hiệu cơ bản của sơ đồ đường dẫn: biến tiềm ẩn, biến quan sát, sai số, tác động và hiệp phương sai.
Mô hình nghiên cứu ý định mua lại trên sàn X, khi vẽ theo các kí hiệu này, trông như Hình 2.
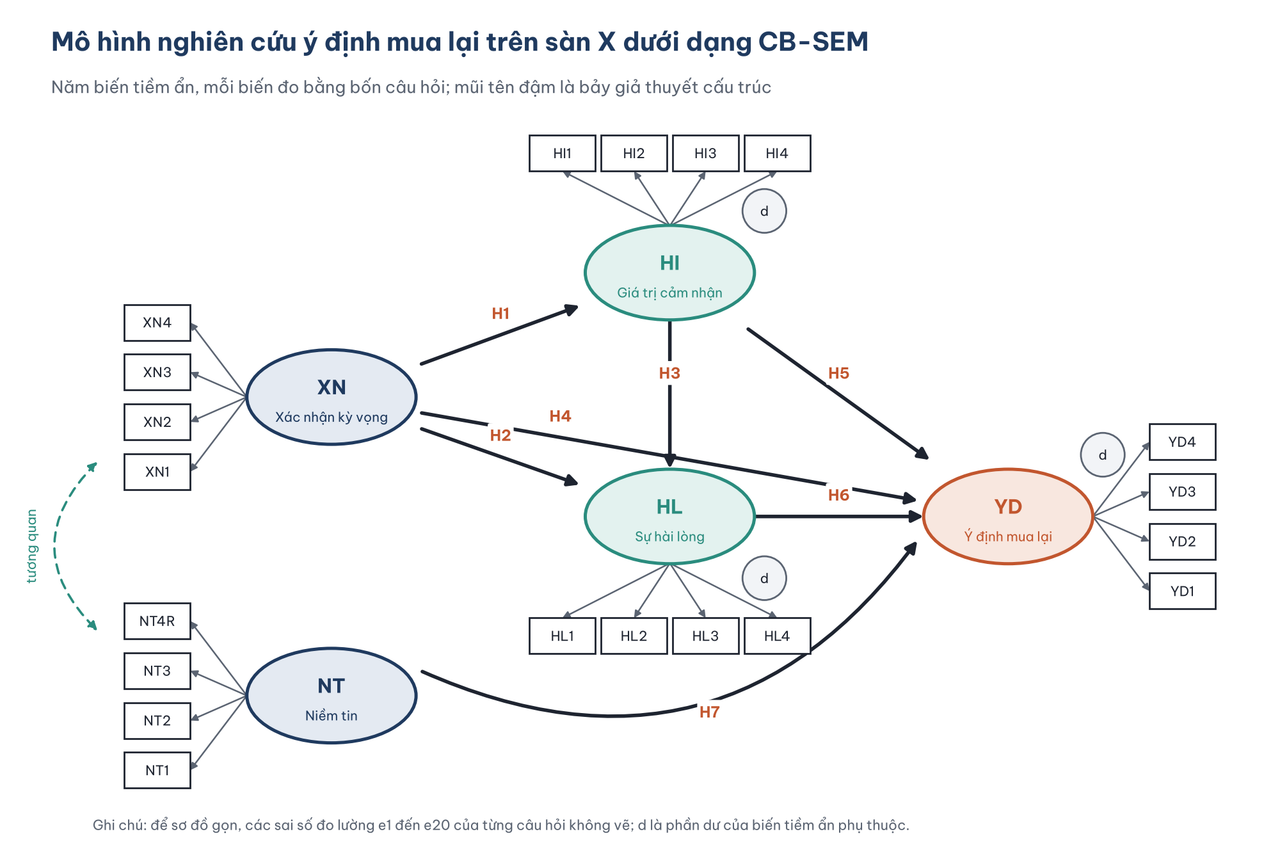
Hình 2. Mô hình nghiên cứu với năm biến tiềm ẩn (XN, HI, HL, NT, YD), 20 câu hỏi và bảy giả thuyết H1 đến H7. NT4R là câu NT4 đã đảo chiều ở bài tính biến đại diện.
3. Hồi quy và CB-SEM khác nhau thế nào?
Hồi quy và CB-SEM khác nhau ở hai điểm chính: cách xử lý sai số đo lường và cách ước lượng các phương trình.
Cách xử lý sai số đo lường
Đây là khác biệt quan trọng nhất giữa hai cách tiếp cận (Hình 3).
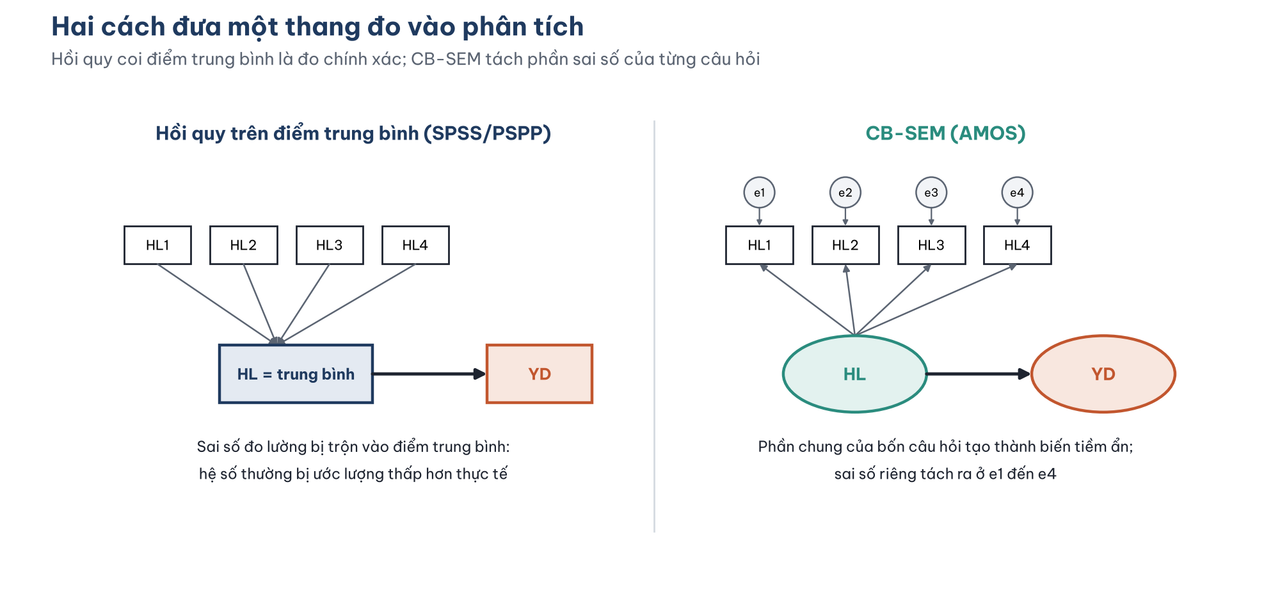
Hình 3. Hồi quy dùng điểm trung bình như một biến đo chính xác; CB-SEM tách sai số riêng của từng câu hỏi ra khỏi biến tiềm ẩn.
Khi lấy trung bình bốn câu hỏi, sai số đo lường của từng câu không biến mất mà bị trộn vào điểm trung bình. Sai số ngẫu nhiên làm tương quan giữa hai thang đo thấp hơn tương quan thật giữa hai khái niệm. Hiện tượng này gọi là suy giảm do sai số đo lường (attenuation) và hệ số hồi quy thường bị ước lượng thấp theo (Kline, 2023). CB-SEM ước lượng sai số của từng câu hỏi, nên hệ số giữa các biến tiềm ẩn đã được hiệu chỉnh.
Một khác biệt nữa: hồi quy ở bài hồi quy tuyến tính bội phải chạy ba phương trình riêng (HI theo XN; HL theo XN, HI; YD theo XN, HI, HL, NT). CB-SEM ước lượng cả bảy đường dẫn cùng lúc trong một mô hình.
So sánh trên cùng dữ liệu
File so_sanh_hoi_quy_sem.R đi kèm chạy cùng mô hình theo hai cách: hồi quy trên điểm trung bình (giống hệt bài hồi quy tuyến tính bội) và CB-SEM bằng ước lượng ML. Phần CB-SEM được tính bằng gói lavaan của R (Rosseel, 2012), dùng cùng phương pháp ML như AMOS. Hồi quy dùng 263 người có đủ dữ liệu, giống bài hồi quy tuyến tính bội. CB-SEM dùng cả 267 người: 21 ô dữ liệu còn thiếu (ở 13 người) được xử lý bằng FIML, tương đương tùy chọn Estimate means and intercepts trong AMOS.
Vì bộ dữ liệu mẫu là dữ liệu giả lập (xem du-lieu-mau/README.md), ta biết các hệ số thật trong tổng thể đã dùng để sinh dữ liệu. Đây là điều không bao giờ có với dữ liệu khảo sát thật và nó cho phép kiểm tra cách nào ước lượng gần sự thật hơn (Hình 4).
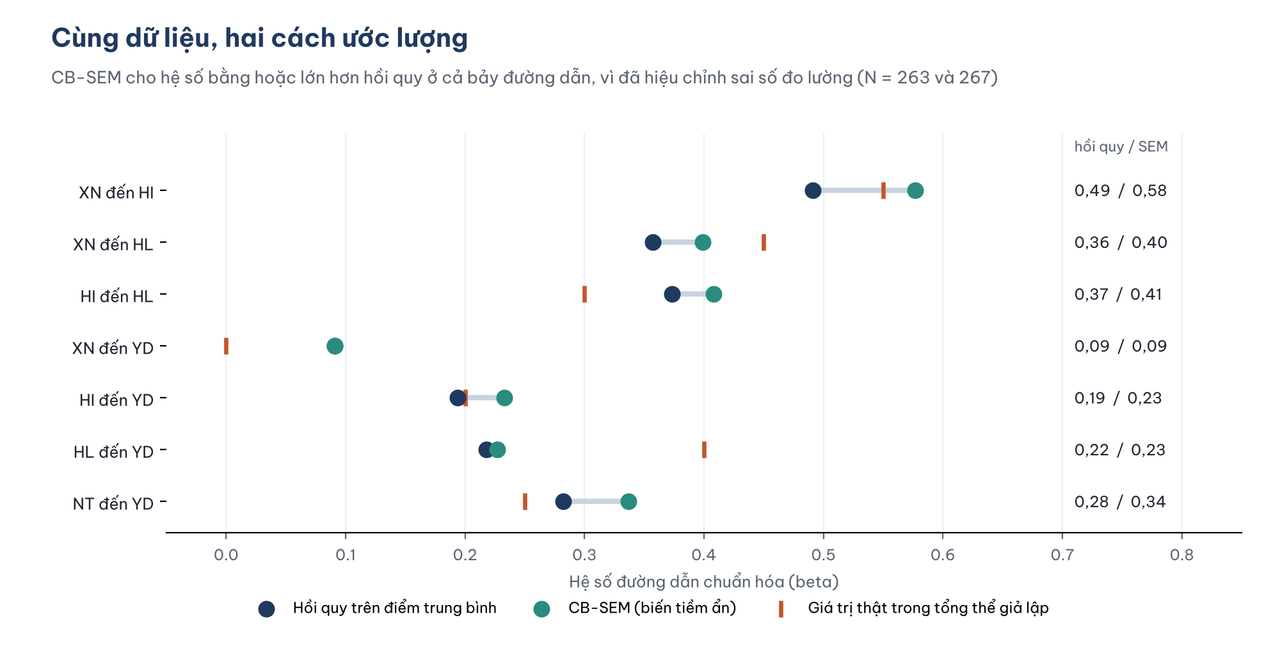
Hình 4. Hệ số đường dẫn chuẩn hóa ước lượng bằng hồi quy (xanh đậm) và CB-SEM (xanh ngọc), cùng giá trị thật trong tổng thể giả lập (vạch cam).
Bảng 1 ghi chi tiết các hệ số trong Hình 4.
Bảng 1. Hệ số đường dẫn chuẩn hóa ước lượng bằng hồi quy và CB-SEM.
| Đường dẫn | Hồi quy: beta | Hồi quy: p | CB-SEM: beta | CB-SEM: p | Giá trị thật |
|---|---|---|---|---|---|
| H1: XN đến HI | 0,49 | < 0,001 | 0,58 | < 0,001 | 0,55 |
| H2: XN đến HL | 0,36 | < 0,001 | 0,40 | < 0,001 | 0,45 |
| H3: HI đến HL | 0,37 | < 0,001 | 0,41 | < 0,001 | 0,30 |
| H4: XN đến YD | 0,09 | 0,168 | 0,09 | 0,372 | 0 |
| H5: HI đến YD | 0,19 | 0,003 | 0,23 | 0,012 | 0,20 |
| H6: HL đến YD | 0,22 | 0,001 | 0,23 | 0,023 | 0,40 |
| H7: NT đến YD | 0,28 | < 0,001 | 0,34 | < 0,001 | 0,25 |
| R² của YD | 0,315 | 0,443 |
Bốn điều rút ra từ bảng:
- CB-SEM cho hệ số bằng hoặc lớn hơn hồi quy ở cả bảy đường dẫn. Mức tăng rõ nhất ở H1 (0,49 lên 0,58) và H7 (0,28 lên 0,34). R² của ý định mua lại tăng từ 0,315 lên 0,443, vì phần phương sai do sai số đo lường đã được tách ra.
- Hiệu chỉnh không có nghĩa là chính xác hơn trong mọi trường hợp. H1 bằng CB-SEM gần giá trị thật (0,55) hơn hồi quy. Nhưng H3 và H7 bằng CB-SEM lại vượt giá trị thật, còn H6 thì cả hai cách đều thấp hơn nhiều so với 0,40. Một mẫu 267 người vẫn có sai số chọn mẫu và không phương pháp nào loại bỏ được sai số đó.
- Sai số chuẩn của CB-SEM lớn hơn. H5 có p = 0,003 với hồi quy nhưng 0,012 với CB-SEM; H6 từ 0,001 lên 0,023. CB-SEM thừa nhận thêm một nguồn bất định (sai số đo lường), nên khoảng tin cậy rộng hơn. Kết luận về ý nghĩa không đổi ở mẫu này, nhưng với mẫu nhỏ hơn có thể đổi.
- H4 không có ý nghĩa ở cả hai cách, đúng với giá trị thật bằng 0 của tổng thể giả lập.
Mô hình CB-SEM phù hợp với dữ liệu rất tốt: chi bình phương (CMIN) = 138,67; df = 162; p = 0,908; CFI = 1,000; RMSEA = 0,000 (KTC 90% [0,000; 0,012]); SRMR = 0,035. Hệ số tải chuẩn hóa từ 0,65 đến 0,85. Mức phù hợp "hoàn hảo" này là do dữ liệu được sinh ra từ đúng mô hình này. Với dữ liệu khảo sát thật, chi bình phương có ý nghĩa và CFI quanh 0,90 đến 0,95 là chuyện bình thường. Bài chỉ số độ phù hợp của mô hình sẽ hướng dẫn cách đọc các chỉ số này.
4. Khi nào nên dùng AMOS thay vì SPSS?
Bảng 2 gợi ý lựa chọn phần mềm theo từng tình huống nghiên cứu.
Bảng 2. Chọn SPSS hay AMOS theo tình huống nghiên cứu.
| Tình huống | Nên dùng | Lý do |
|---|---|---|
| So sánh trung bình giữa các nhóm, tương quan đơn giản, hồi quy với biến quan sát trực tiếp (tuổi, thu nhập, số lần mua) | SPSS | Không có biến tiềm ẩn, không cần mô hình đo lường |
| Khám phá cấu trúc thang đo mới, chưa rõ câu nào thuộc nhân tố nào | SPSS (EFA) | CFA cần biết trước cấu trúc |
| Khẳng định cấu trúc thang đo đã có lý thuyết: tính CR, AVE, giá trị phân biệt | AMOS (CFA) | Hồi quy và EFA không kiểm định được mô hình đo lường |
| Mô hình có nhiều biến phụ thuộc, có biến vừa là nguyên nhân vừa là kết quả (như HL) | AMOS (SEM) | Ước lượng mọi phương trình cùng lúc |
| Cần đánh giá mô hình lý thuyết có phù hợp với dữ liệu không | AMOS (SEM) | Có chi bình phương và các chỉ số phù hợp |
| Phân tích trung gian với khoảng tin cậy bootstrap, so sánh mô hình giữa các nhóm | AMOS | Có sẵn bootstrap và phân tích đa nhóm |
SPSS vẫn là bước không thể bỏ qua trước khi vào AMOS: làm sạch dữ liệu, xử lý giá trị thiếu, kiểm tra ngoại lai (bài làm sạch dữ liệu), thống kê mô tả (bài thống kê mô tả), đảo chiều câu hỏi (bài tính biến đại diện), Cronbach's Alpha (bài Cronbach's Alpha) và EFA (bài phân tích nhân tố khám phá).
5. Yêu cầu về dữ liệu của CB-SEM
Trước khi chạy CB-SEM, cần kiểm tra bốn điều kiện về dữ liệu.
- Kiểm tra cỡ mẫu. CB-SEM với ước lượng ML cần mẫu tương đối lớn. Không có con số cố định: cỡ mẫu cần thiết phụ thuộc vào số biến tiềm ẩn, số câu hỏi mỗi thang đo và độ lớn hệ số tải (Wolf và cộng sự, 2013). Bài cỡ mẫu đã tính cỡ mẫu mục tiêu 250 cho mô hình mẫu; sau làm sạch còn 267.
- Kiểm tra phân phối chuẩn đa biến. Ước lượng ML giả định dữ liệu chuẩn đa biến. Kiểm định Mardia trong AMOS (tùy chọn Tests for normality and outliers) sẽ được hướng dẫn ở bài phân tích nhân tố khẳng định (CFA). Khi dữ liệu lệch chuẩn, có thể dùng bootstrap Bollen-Stine thay vì bỏ CB-SEM (Kline, 2023).
- Kiểm tra thang đo là dạng kết quả (reflective): các câu hỏi là biểu hiện của cùng một khái niệm, nên tương quan cao với nhau. Thang đo dạng nguyên nhân (formative) phù hợp với PLS-SEM hơn (bài mô hình đo lường formative).
- Xử lý giá trị thiếu. AMOS chạy được khi có giá trị thiếu nếu chọn Estimate means and intercepts (FIML). Tuy nhiên, AMOS không cung cấp chỉ số điều chỉnh (modification indices) và bootstrap khi dữ liệu có giá trị thiếu (Byrne, 2016). Bài chuẩn bị dữ liệu cho CB-SEM sẽ hướng dẫn cách chuẩn bị dữ liệu cho tình huống này.
6. CB-SEM hay PLS-SEM?
CB-SEM (AMOS) và PLS-SEM (SmartPLS) đều ước lượng mô hình có biến tiềm ẩn, nhưng xuất phát từ mục tiêu khác nhau. CB-SEM phù hợp khi kiểm định một lý thuyết đã có nền tảng, thang đo dạng kết quả và quan tâm mô hình có phù hợp với dữ liệu không. PLS-SEM phù hợp khi mục tiêu là dự đoán, mô hình phức tạp hoặc có thang đo dạng nguyên nhân (Hair và cộng sự, 2022). Bài mô hình cấu trúc tuyến tính đã trình bày hai trường phái này ở mức khái niệm. Bài bộ ba SPSS, AMOS và SmartPLS đã có bảng so sánh tổng quan; bài SmartPLS và PLS-SEM sẽ đi sâu hơn.
7. Phần mềm miễn phí thay thế AMOS
AMOS chỉ chạy trên Windows và phải mua bản quyền. Nếu chưa có AMOS, có thể học CB-SEM bằng các công cụ miễn phí dùng cùng phương pháp ước lượng ML:
- lavaan (gói của R): viết mô hình bằng cú pháp ngắn gọn, như file
so_sanh_hoi_quy_sem.Rcủa bài này (Rosseel, 2012). - JASP và jamovi: giao diện bấm chọn giống SPSS, phần SEM chạy bằng lavaan bên dưới.
Với cùng dữ liệu, cùng mô hình và cùng phương pháp ML, các phần mềm này cho ước lượng trùng với AMOS. Khác biệt nằm ở cách nhập mô hình (vẽ sơ đồ hay viết cú pháp) và một số chỉ số phụ.
8. Lộ trình cụm bài AMOS
Các bài tiếp theo đi lần lượt từ mô hình đo lường đến mô hình cấu trúc (Hình 5).
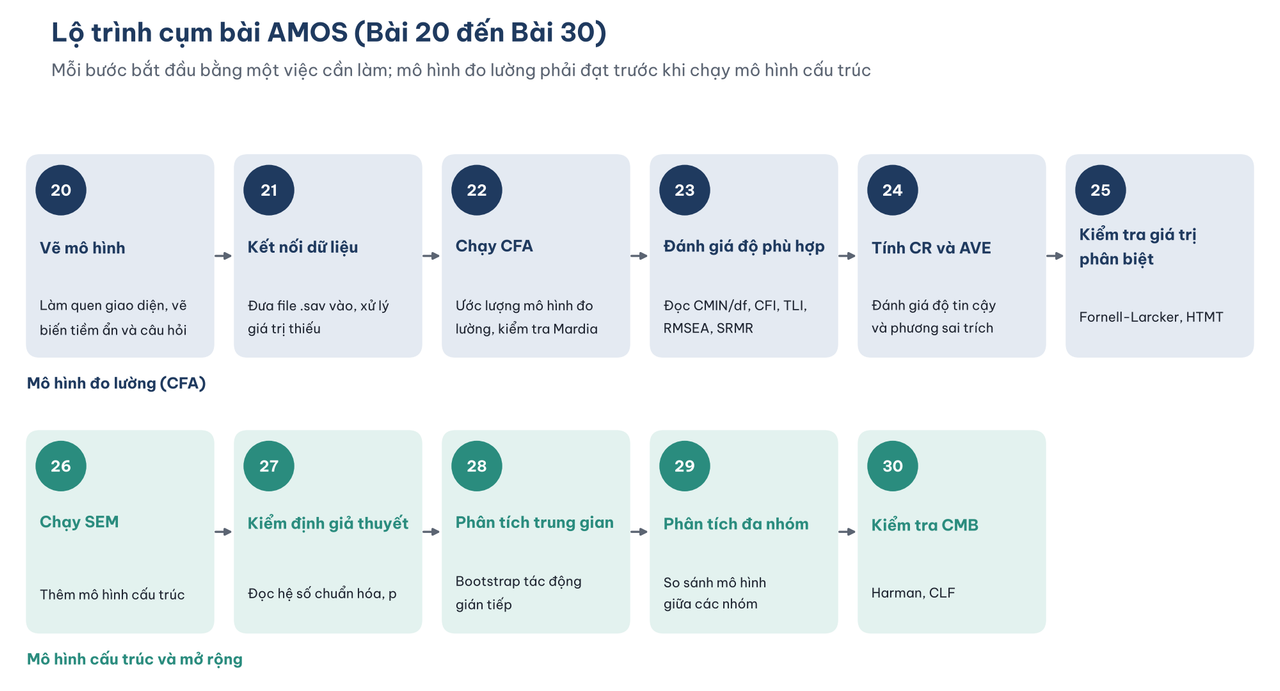
Hình 5. Các bài tiếp theo về CB-SEM, chia làm hai chặng: mô hình đo lường, rồi mô hình cấu trúc cùng các phân tích mở rộng.
Toàn bộ cụm bài dùng tiếp bộ dữ liệu du_lieu_phan_tich.sav và mô hình ở Hình 2, nên kết quả có thể đối chiếu trực tiếp với cụm bài SPSS.
Tài liệu tham khảo
Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
Byrne, B. M. (2016). Structural equation modeling with AMOS: Basic concepts, applications, and programming (3rd ed.). Routledge. https://www.routledge.com/Structural-Equation-Modeling-With-AMOS-Basic-Concepts-Applications-and/Byrne/p/book/9781138797031
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237