
PHÂN TÍCH ĐA NHÓM VÀ BIẾN ĐIỀU TIẾT TRONG SEM
Kiểm định bất biến đo lường, so sánh đường dẫn giữa hai nhóm và biến tương tác tiềm ẩn trong JASP, AMOS
Bài nên đọc trước
Bài mô hình cấu trúc SEM đến bài biến trung gian trong SEM ước lượng một mô hình cho toàn bộ người trả lời. Câu hỏi tự nhiên tiếp theo: mô hình đó có đúng như nhau cho mọi nhóm khách hàng không? Chẳng hạn, niềm tin có ảnh hưởng đến ý định mua lại của nữ mạnh hơn của nam không? Đó là câu hỏi về biến điều tiết (moderator).
Bài này làm hai việc:
- Phân tích đa nhóm theo giới tính: kiểm định bất biến đo lường, rồi so sánh bảy đường dẫn giữa Nam và Nữ.
- Biến điều tiết liên tục: kiểm định niềm tin có điều tiết tác động của sự hài lòng không, bằng biến tương tác tiềm ẩn.
Kết quả của cả hai đều không có ý nghĩa. Bài giữ nguyên kết quả đó và dùng nó để chỉ ra một lỗi diễn giải rất phổ biến: thấy một hệ số có ý nghĩa ở nhóm này, không có ý nghĩa ở nhóm kia, rồi kết luận có điều tiết.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026). Các con số được đối chiếu bằng gói lavaan của R (Rosseel, 2012), file da_nhom.R và dieu_tiet_lien_tuc.R: hai cách cho cùng kết quả đến chữ số thập phân thứ ba. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026).
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
29-phan-tich-da-nhom-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Biến điều tiết và hai cách kiểm định
Biến điều tiết làm thay đổi độ mạnh hoặc chiều của tác động giữa hai biến khác (Baron & Kenny, 1986). Nó khác biến trung gian ở bài biến trung gian trong SEM: biến trung gian là con đường mà tác động đi qua, còn biến điều tiết là điều kiện làm tác động mạnh lên hay yếu đi (Bảng 1).
Bảng 1. Hai loại biến điều tiết và cách kiểm định.
| Loại biến điều tiết | Ví dụ trong đề tài sàn X | Cách kiểm định trong CB-SEM |
|---|---|---|
| Biến nhóm (định danh) | Giới tính, nghề nghiệp, khu vực | Phân tích đa nhóm (multi-group) |
| Biến liên tục (thang đo) | Mức độ niềm tin | Biến tương tác tiềm ẩn đo bằng chỉ báo tích |
Không nên biến một biến liên tục thành biến nhóm bằng cách chia đôi theo trung vị: cách này làm mất thông tin, giảm lực kiểm định và có thể tạo ra kết quả giả (MacCallum và cộng sự, 2002). Phần 6 cho thấy điều đó trên dữ liệu thật.
2. Quy trình phân tích đa nhóm
So sánh đường dẫn giữa hai nhóm chỉ có ý nghĩa khi hai nhóm hiểu thang đo như nhau. Nếu nữ hiểu câu "Sàn X đáng tin cậy" khác nam, hệ số đường dẫn của hai nhóm đo hai thứ khác nhau. Vì vậy phải kiểm định bất biến đo lường (measurement invariance) trước (Vandenberg & Lance, 2000; Putnick & Bornstein, 2016) (Hình 1, Bảng 2).
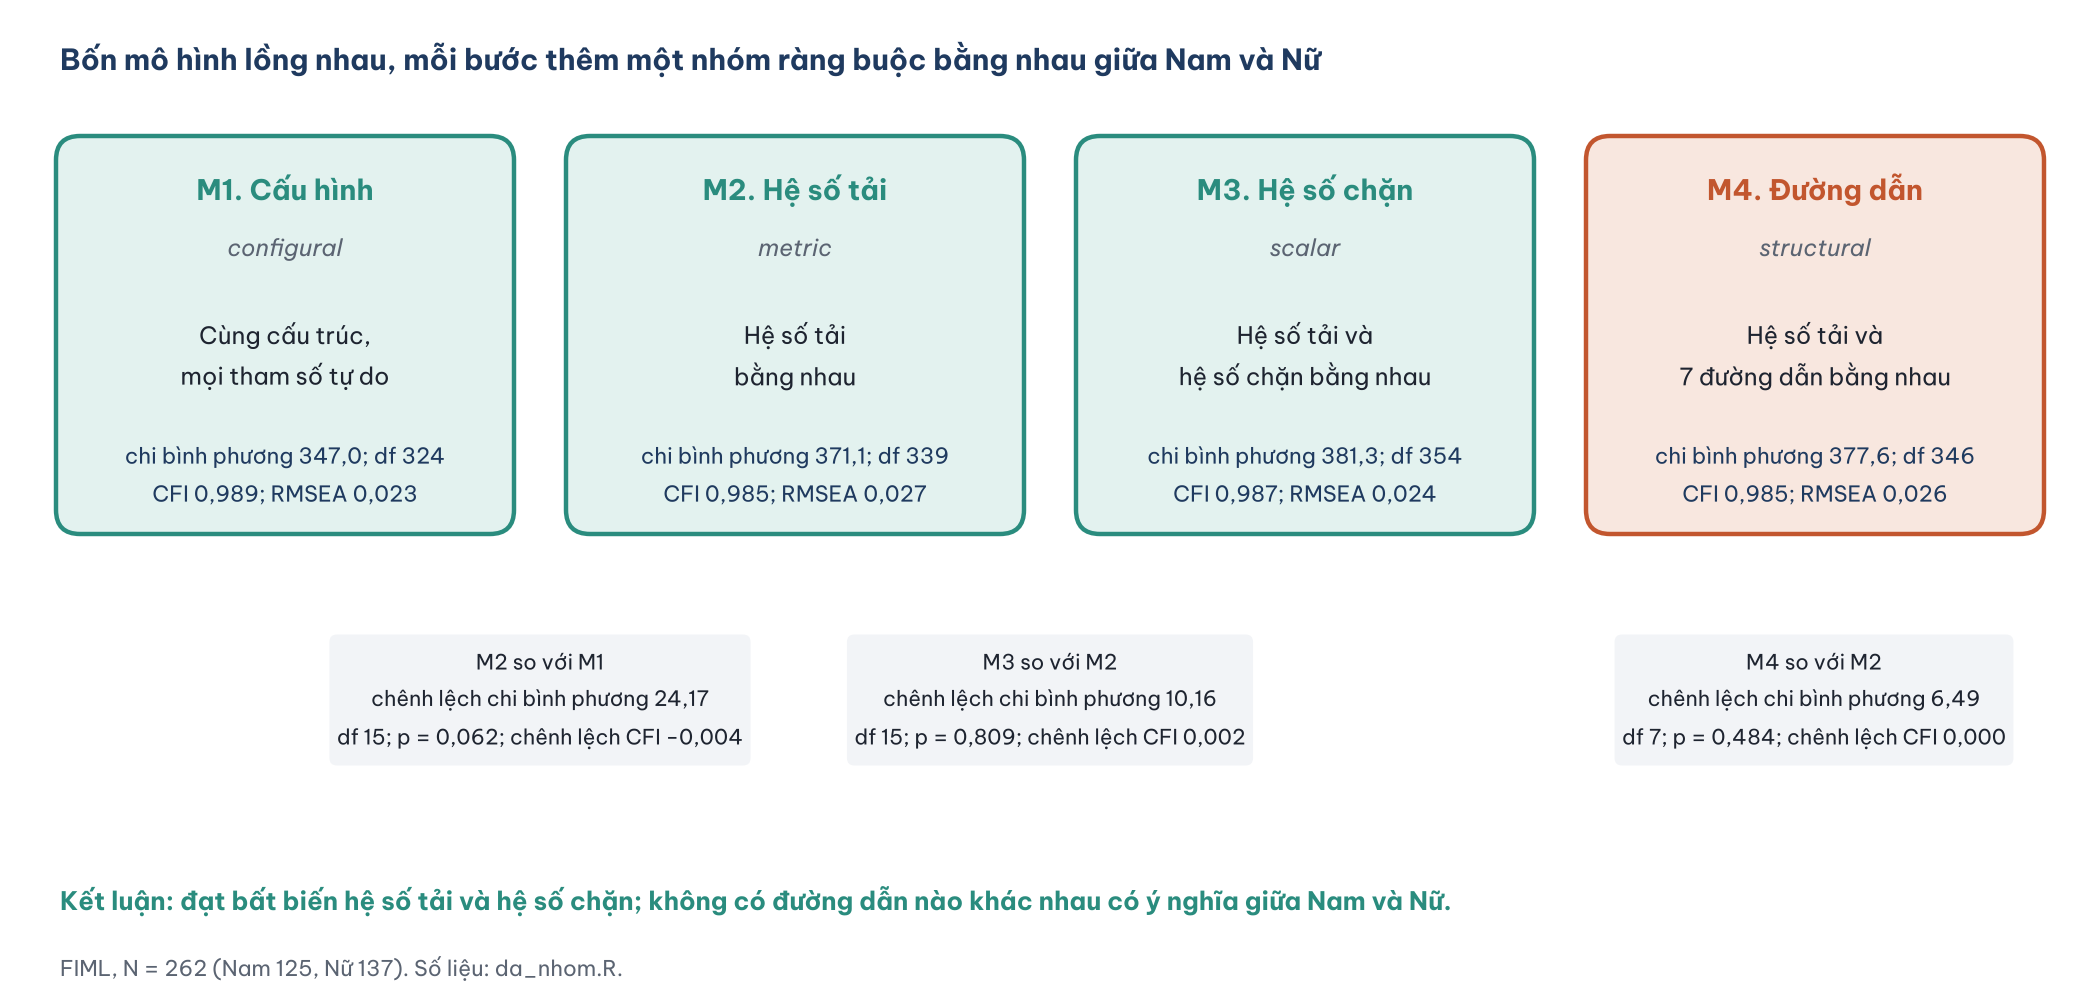
Hình 1. Bốn mô hình lồng nhau trong phân tích đa nhóm theo giới tính và kết quả so sánh.
Bảng 2. Bốn mô hình lồng nhau trong phân tích đa nhóm.
| Mô hình | Ràng buộc bằng nhau giữa hai nhóm | Câu hỏi trả lời | Cần cho |
|---|---|---|---|
| M1. Cấu hình (configural) | Không có, chỉ cùng cấu trúc | Hai nhóm có cùng mô hình đo lường không? | Mọi bước sau |
| M2. Hệ số tải (metric) | Hệ số tải | Mỗi câu hỏi gắn với khái niệm mạnh như nhau? | So sánh đường dẫn |
| M3. Hệ số chặn (scalar) | Hệ số tải và hệ số chặn | Cùng mức khái niệm thì cho cùng điểm câu hỏi? | So sánh trung bình tiềm ẩn |
| M4. Đường dẫn (structural) | Hệ số tải và 7 đường dẫn | Bảy đường dẫn có bằng nhau giữa hai nhóm? | Kết luận về điều tiết |
Mỗi bước được chấp nhận khi mô hình chặt hơn không làm độ phù hợp xấu đi đáng kể. Có hai tiêu chí, nên báo cáo cả hai:
- Kiểm định chênh lệch chi bình phương: p lớn hơn 0,05 thì chấp nhận ràng buộc. Tiêu chí này nhạy với cỡ mẫu (bài chỉ số độ phù hợp của mô hình).
- Chênh lệch CFI không giảm quá 0,01 (Cheung & Rensvold, 2002). Chen (2007) bổ sung: RMSEA không tăng quá 0,015; SRMR không tăng quá 0,030 ở bước hệ số tải và 0,010 ở bước hệ số chặn.
Cỡ mẫu từng nhóm cũng cần đủ, vì mỗi nhóm có một bộ tham số riêng. Mô hình sàn X có 68 tham số tự do mỗi nhóm trong M1; với 125 nam và 137 nữ, tỷ lệ chưa tới 2 người trên một tham số. Kết quả vẫn ước lượng được, nhưng lực kiểm định để phát hiện khác biệt nhỏ giữa hai nhóm là thấp. Cần ghi điều này vào phần hạn chế.
3. Chuẩn bị dữ liệu
Có 5 người chọn giới tính "Khác". Năm người không đủ để ước lượng một mô hình riêng, nên bị loại khỏi phân tích đa nhóm (không loại khỏi các phân tích khác). File cú pháp chuan_bi_bai29.sps (chạy được trên SPSS và PSPP, Free Software Foundation, 2023) tạo các file (Bảng 3):
Bảng 3. Các file dữ liệu cho phân tích đa nhóm.
| File | Số người | Dùng cho |
|---|---|---|
du_lieu_da_nhom.sav |
262 (Nam 125, Nữ 137), giữ ô thiếu | JASP với FIML |
du_lieu_da_nhom_du.sav |
250 (Nam 119, Nữ 131), trả lời đủ | AMOS |
du_lieu_tich.sav |
267, thêm 4 chỉ báo tích | Biến điều tiết liên tục, JASP |
du_lieu_tich_du.sav |
254 trả lời đủ, thêm 4 chỉ báo tích | Biến điều tiết liên tục, AMOS |
Phần chính của cú pháp:
GET FILE='../du-lieu/du_lieu_amos.sav'.
SELECT IF (GIOITINH = 1 OR GIOITINH = 2).
VALUE LABELS GIOITINH 1 'Nam' 2 'Nữ'.
VARIABLE LEVEL GIOITINH (NOMINAL).
SAVE OUTFILE='../du-lieu/du_lieu_da_nhom.sav'.
4. Chạy phân tích đa nhóm trong JASP
Trong JASP, phân tích đa nhóm dùng mô-đun SEM với biến nhóm GIOITINH và các tùy chọn Equality Constraints.
Bước 1. Mở dữ liệu và kiểm tra biến nhóm
Bước đầu là mở đúng file và kiểm tra kiểu của biến nhóm.
- Mở
du_lieu_da_nhom.savbằng nút menu ba gạch ở góc trên bên trái, chọn Open > Computer. - Kiểm tra cột GIOITINH: biểu tượng ba hình tròn (Nominal) và nhãn Nam, Nữ (Hình 2, ô 1 và 2).
- Kiểm tra 20 câu hỏi ở kiểu Scale (biểu tượng thước kẻ, ô 3). Nếu là Ordinal, JASP sẽ ước lượng bằng DWLS thay vì ML (bài vẽ mô hình đầu tiên).
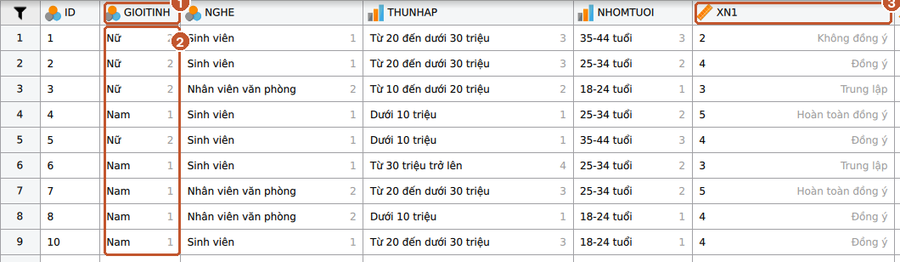
Hình 2. (1) Biến nhóm GIOITINH kiểu Nominal, (2) nhãn Nam, Nữ, (3) câu hỏi kiểu Scale.
Thứ tự nhóm trong JASP là thứ tự xuất hiện trong dữ liệu. Người đầu tiên trong file là nữ, nên JASP xếp Nữ là nhóm 1, Nam là nhóm 2. Điều này quan trọng ở Bước 4 và 5, khi viết nhãn theo nhóm.
Bước 2. Mô hình cấu hình (M1)
Mô hình cấu hình ước lượng cùng một cấu trúc cho hai nhóm mà không ràng buộc tham số nào.
- Chọn SEM > Structural Equation Modeling.
- Nhập cú pháp mô hình của bài mô hình cấu trúc SEM, thêm dòng cuối cố định trung bình tiềm ẩn bằng 0 (cần khi dùng FIML, xem bài mô hình cấu trúc SEM):
XACNHAN =~ XN1 + XN2 + XN3 + XN4
GIATRI  =~ HI1 + HI2 + HI3 + HI4
HAILONG =~ HL1 + HL2 + HL3 + HL4
NIEMTIN =~ NT1 + NT2 + NT3 + NT4R
YDINH   =~ YD1 + YD2 + YD3 + YD4
GIATRI  ~ XACNHAN
HAILONG ~ XACNHAN + GIATRI
YDINH   ~ XACNHAN + GIATRI + HAILONG + NIEMTIN
XACNHAN ~~ NIEMTIN
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1
- Kiểm tra Estimation Options: Missing data handling = (FI)ML (mặc định).
- Mở mục Multigroup SEM, chọn Grouping Variable = GIOITINH.
- Bấm Ctrl + Enter để chạy (Hình 3).
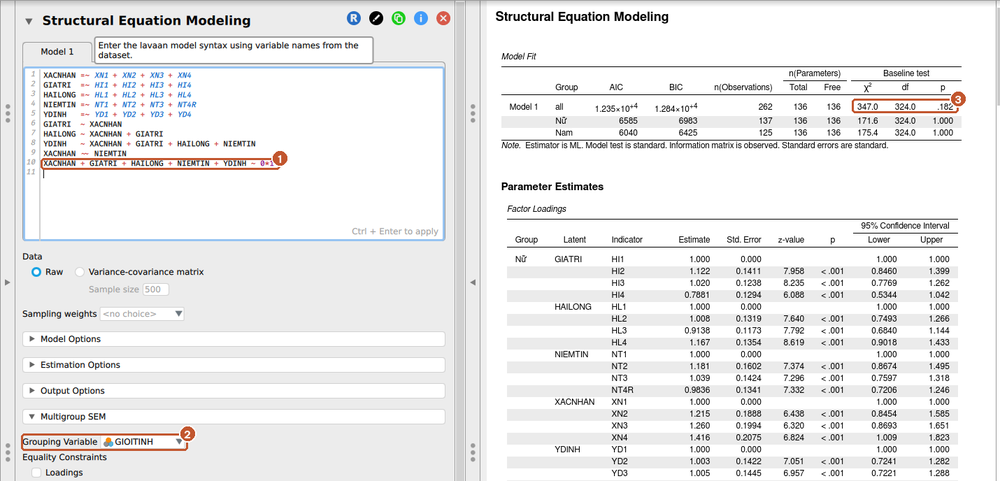
Hình 3. (1) Trung bình tiềm ẩn cố định bằng 0, (2) biến nhóm, (3) chi bình phương của mô hình cấu hình: 347,0 với 324 bậc tự do.
Bảng Model Fit có ba dòng: all là kết quả chung để báo cáo; hai dòng Nữ, Nam là phần chi bình phương của từng nhóm. Cột p của hai dòng này không dùng để kết luận.
Bước 3. Bất biến hệ số tải (M2) và hệ số chặn (M3)
Hai mô hình tiếp theo lần lượt ràng buộc hệ số tải, rồi thêm hệ số chặn bằng nhau giữa hai nhóm.
- Đánh dấu Equality Constraints > Loadings. JASP chạy lại ngay (Hình 4).
- Ghi chi bình phương và bậc tự do: 371,1 và 339.
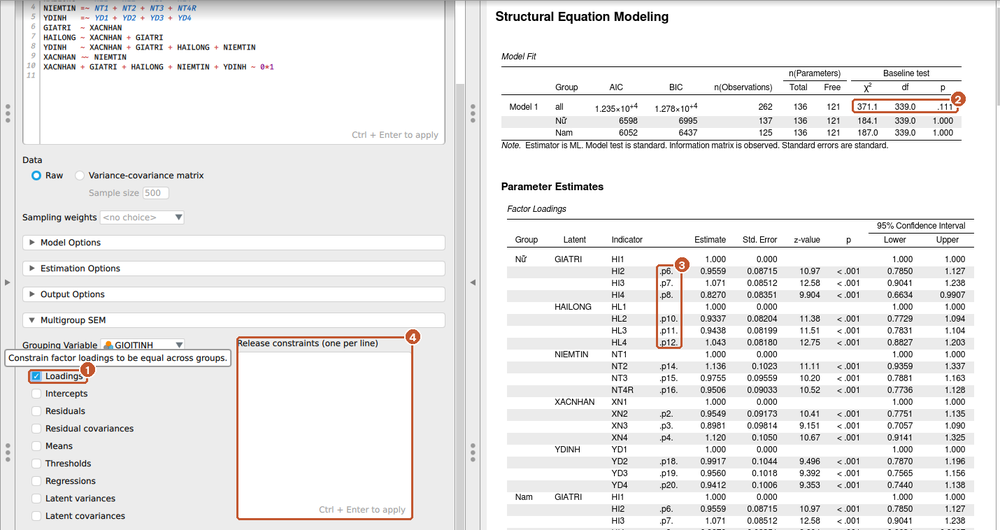
Hình 4. (1) Ràng buộc hệ số tải, (2) độ phù hợp của M2, (3) nhãn chung .p6., .p7. cho hệ số tải của hai nhóm, (4) ô Release constraints để nới riêng từng ràng buộc khi chỉ đạt bất biến một phần.
Để kiểm định hệ số chặn:
- Đánh dấu thêm Intercepts.
- Sửa dòng cuối cú pháp thành
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ c(0, NA)*1. Số 0 cố định trung bình tiềm ẩn của nhóm 1 (Nữ, nhóm tham chiếu);NAđể trung bình của nhóm 2 (Nam) tự do. Nếu giữ0*1cho cả hai nhóm, mọi khác biệt về mức trung bình sẽ bị dồn vào hệ số chặn và kiểm định bị sai. - Bấm Ctrl + Enter (Hình 5).
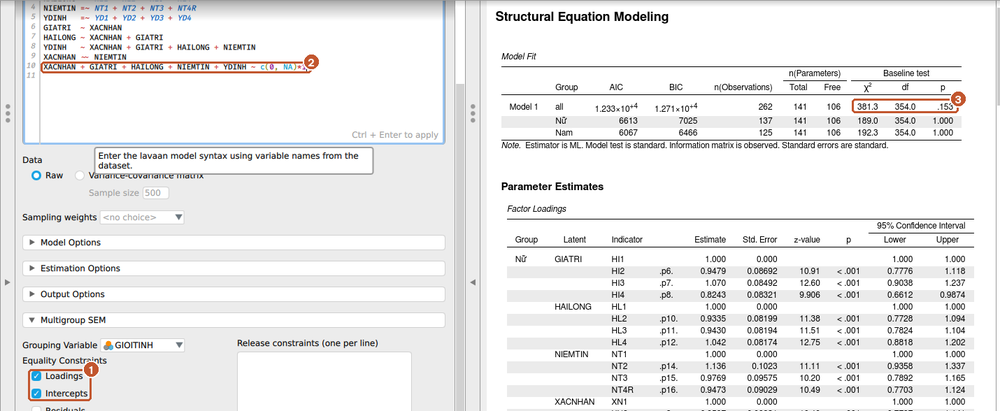
Hình 5. (1) Ràng buộc hệ số tải và hệ số chặn, (2) trung bình tiềm ẩn nhóm Nam được tự do, (3) độ phù hợp của M3: 381,3 với 354 bậc tự do.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, hai nhóm được khai báo trên cùng một sơ đồ và AMOS tự tạo các mô hình lồng nhau (Hình 6). Thao tác dưới đây dùng file người trả lời đủ (du_lieu_da_nhom_du.sav, 250 người), nên các con số trong AMOS chênh nhẹ so với kết quả FIML của JASP ở các mục sau nhưng cho cùng kết luận.
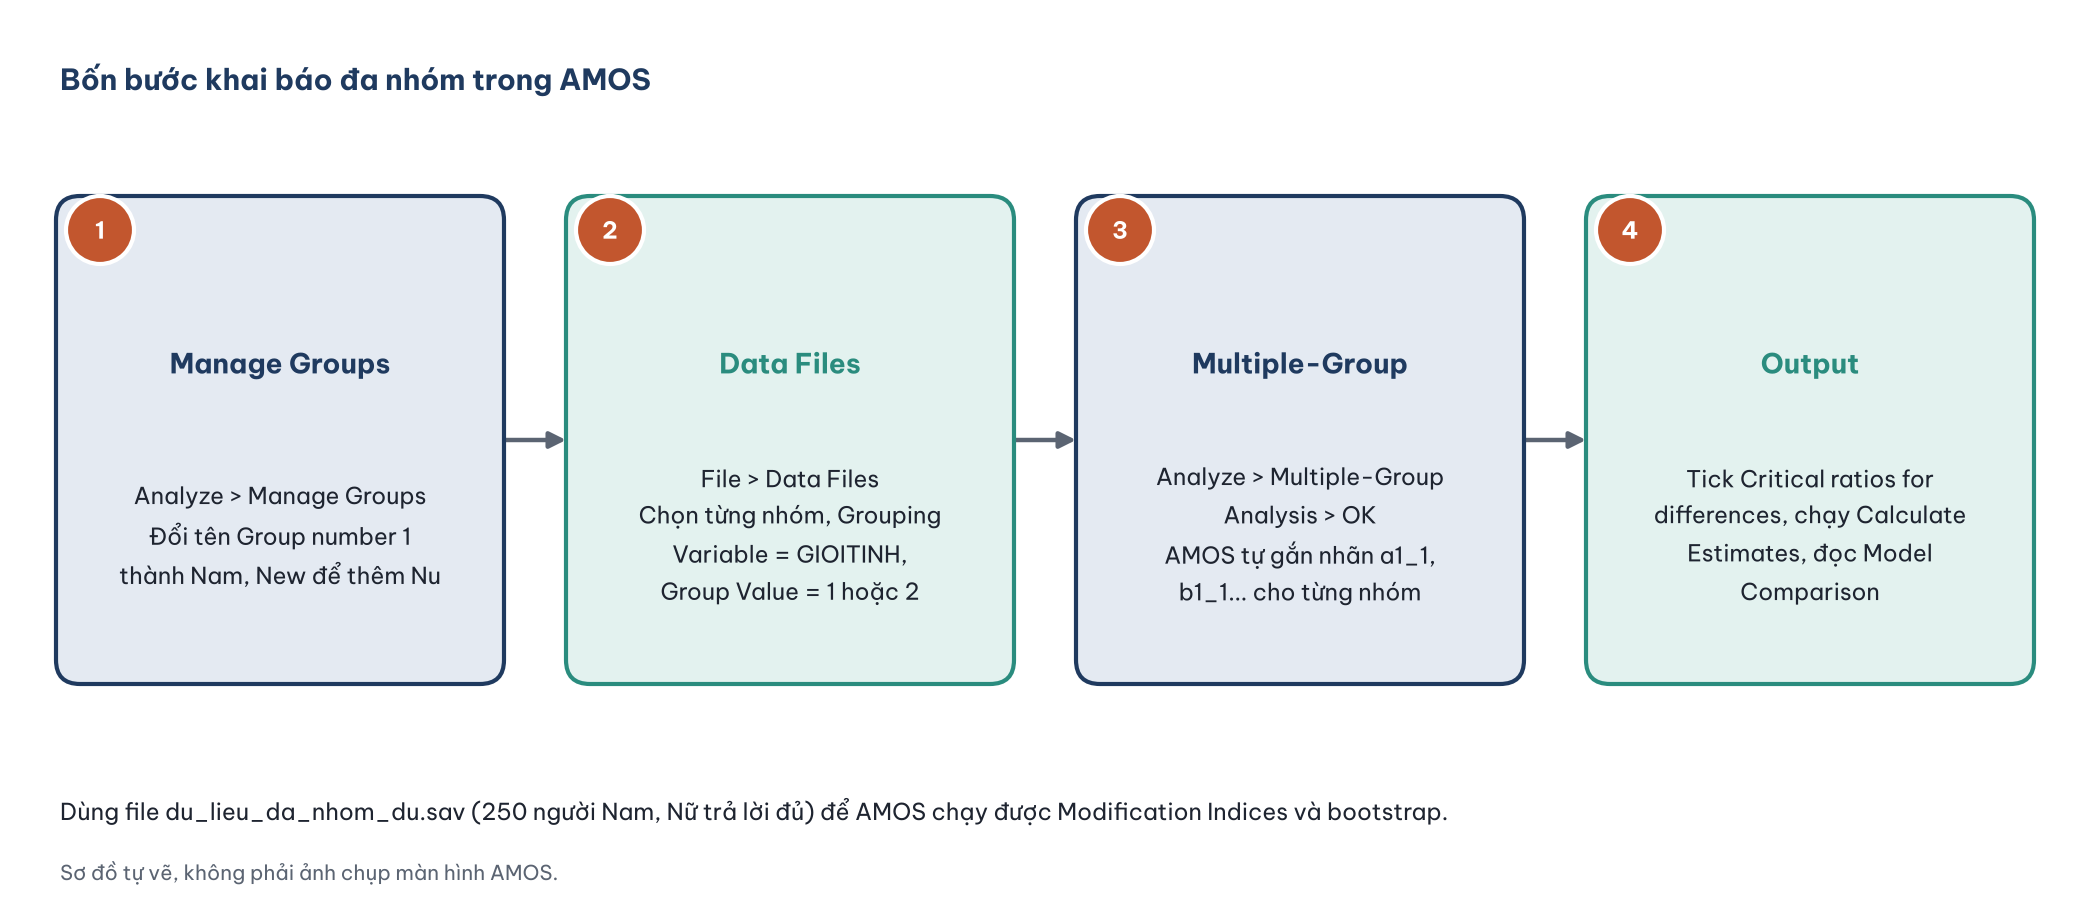
Hình 6. Bốn bước khai báo đa nhóm trong AMOS (sơ đồ tự vẽ).
Bước 1. Mở mô hình và khai báo nhóm
- Mở file mô hình SEM của bài mô hình cấu trúc SEM (
.amw). - Chọn Analyze > Manage Groups. Đổi Group Name từ "Group number 1" thành Nam. Bấm New, đặt tên nhóm thứ hai là Nu, rồi Close.
- Chọn File > Data Files. Chọn dòng Nam, bấm File Name và mở
du_lieu_da_nhom_du.sav. Bấm Grouping Variable, chọn GIOITINH. Bấm Group Value, chọn 1. - Lặp lại bước 3 cho dòng Nu với cùng file và Group Value = 2. Cột N phải hiện 119/250 và 131/250.
AMOS dùng chung một sơ đồ cho hai nhóm: không cần vẽ lại mô hình. Danh sách nhóm hiện ở khung bên trái màn hình vẽ; bấm vào tên nhóm để xem sơ đồ và kết quả của nhóm đó.
Bước 2. Bật ước lượng trung bình và hệ số chặn
Kiểm định bất biến hệ số chặn cần cấu trúc trung bình:
- Chọn View > Analysis Properties, thẻ Estimation.
- Đánh dấu Estimate means and intercepts.
- Chuyển sang thẻ Output, đánh dấu Standardized estimates và Critical ratios for differences.
Khi đã bật cấu trúc trung bình, trung bình các biến tiềm ẩn được cố định bằng 0. Ở mô hình hệ số chặn, cần cố định trung bình tiềm ẩn bằng 0 ở nhóm Nam (nhóm tham chiếu) và để tự do ở nhóm Nu, để phần chênh lệch giữa hai nhóm không bị dồn vào hệ số chặn (Byrne, 2016). Kiểm tra bằng cách chọn nhóm Nu, nhấp đúp từng hình elip, xem thẻ Parameters, ô Mean.
Bước 3. Tạo các mô hình lồng nhau
- Chọn Analyze > Multiple-Group Analysis. AMOS báo sẽ gắn nhãn cho mọi tham số; bấm OK.
- Xem hộp thoại (Hình 7). Mỗi cột là một mô hình; mỗi hàng là một nhóm tham số được ràng buộc bằng nhau giữa hai nhóm.
- Giữ ba cột đầu và bỏ chọn các cột còn lại, rồi bấm OK.
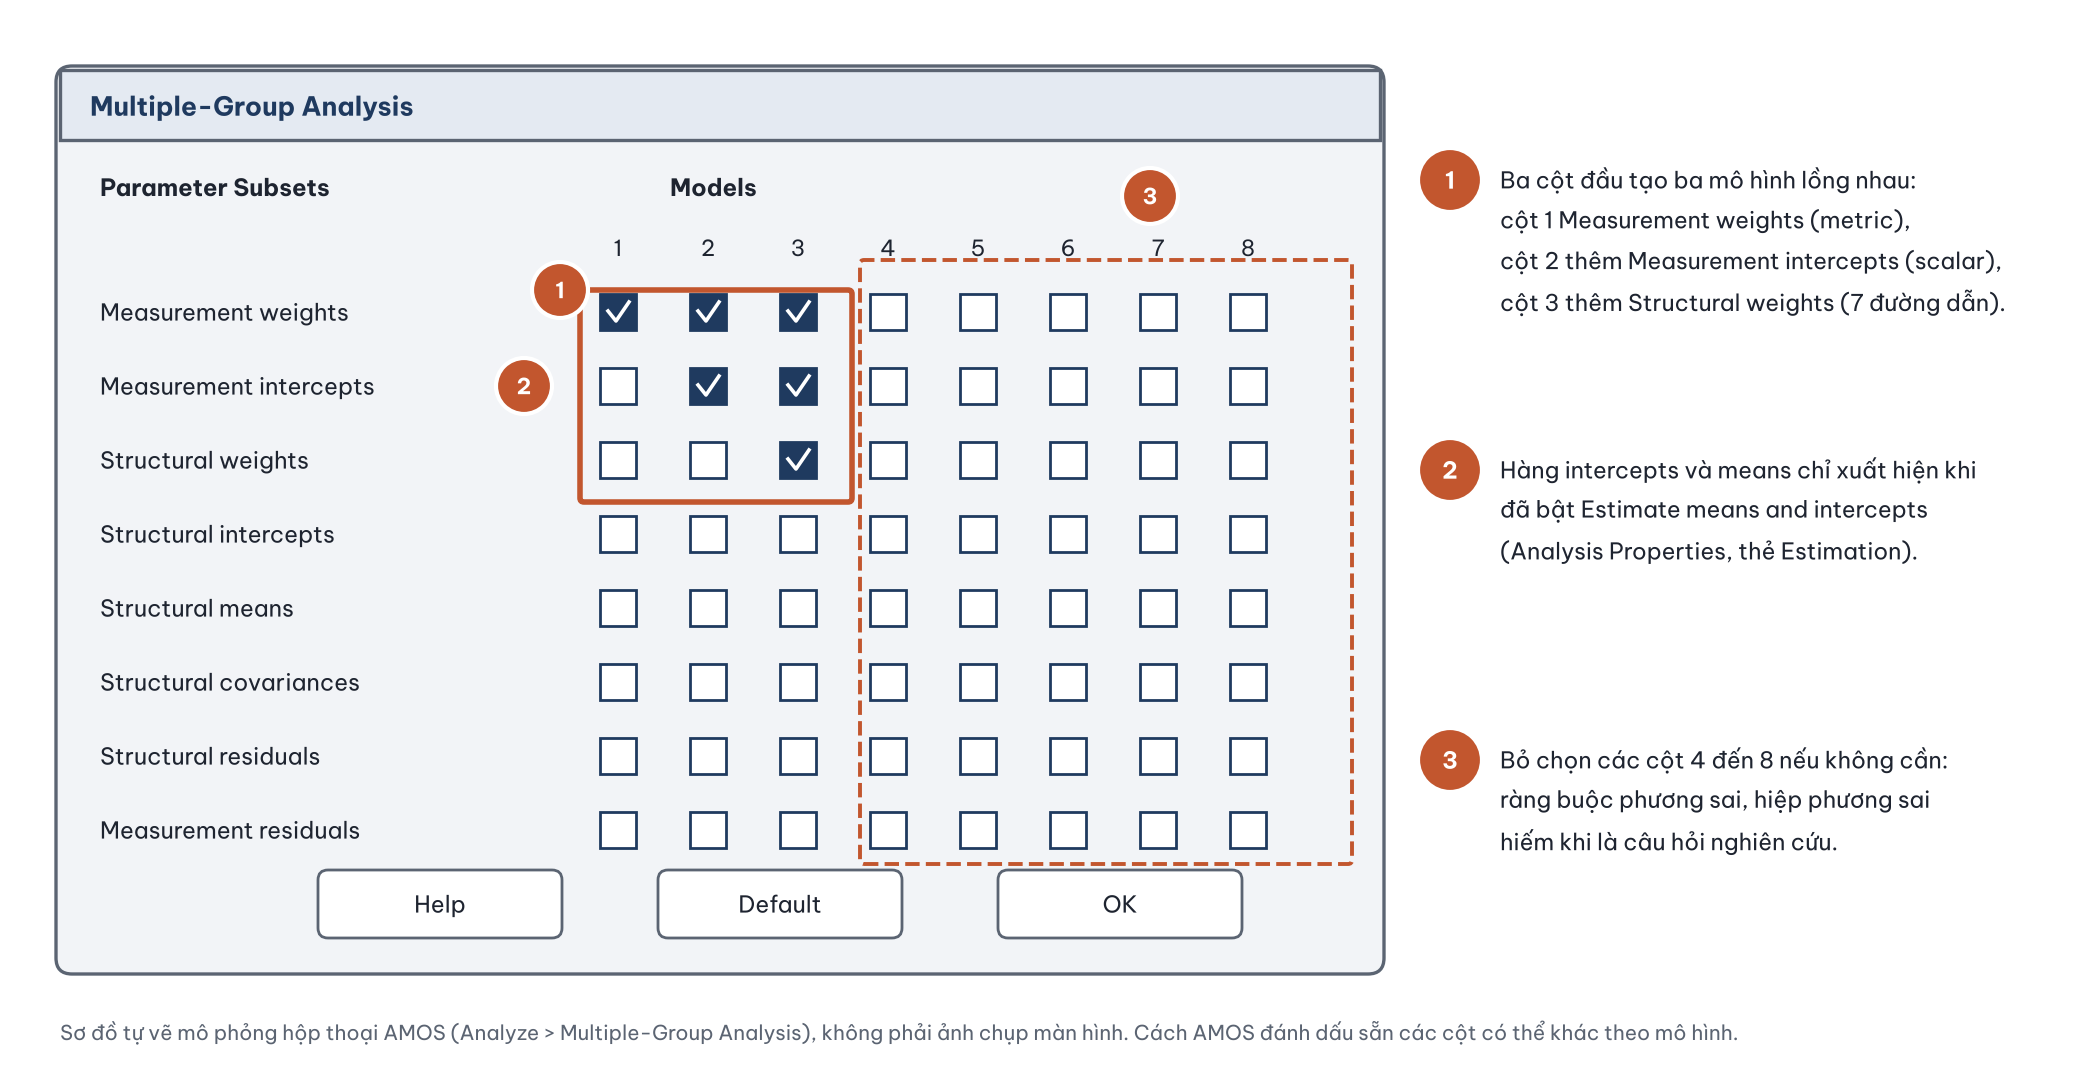
Hình 7. (1) Ba mô hình cần dùng, (2) hàng hệ số chặn chỉ có khi đã ước lượng trung bình, (3) các cột ràng buộc phương sai, hiệp phương sai thường không cần (sơ đồ tự vẽ).
AMOS gắn nhãn theo nhóm: hệ số tải là a1_1, a2_1... ở nhóm 1 và a1_2, a2_2... ở nhóm 2; đường dẫn là b1_1, b2_1.... Khung Models bên trái hiện Unconstrained, Measurement weights, Measurement intercepts, Structural weights.
Bước 4. Chạy và đọc kết quả
- Bấm Analyze > Calculate Estimates.
- Mở View > Text Output, mục Model Fit: đọc chi bình phương (CMIN), CFI, RMSEA của từng mô hình.
- Mở mục Model Comparison: AMOS in sẵn chênh lệch chi bình phương. Đọc bảng "Assuming model Unconstrained to be correct" cho bước hệ số tải và bảng "Assuming model Measurement weights to be correct" cho bước hệ số chặn.
Mô hình Structural weights của AMOS khi đã bật trung bình gồm cả ràng buộc hệ số chặn. Muốn kiểm định đường dẫn chỉ trên nền bất biến hệ số tải (mô hình M4), chạy thêm một lần không bật Estimate means and intercepts: khi đó cột Structural weights chỉ gồm hệ số tải và đường dẫn. Bảng kết quả bên dưới có cả hai cách.
5. Kết quả bất biến đo lường
Bảng 4 tổng hợp độ phù hợp của các mô hình lồng nhau và kết quả so sánh từng bước.
Bảng 4. Kết quả kiểm định bất biến đo lường.
| Mô hình | Chi bình phương (df) | CFI | RMSEA | SRMR | So sánh: chênh lệch chi bình phương (df), p | Chênh lệch CFI |
|---|---|---|---|---|---|---|
| M1. Cấu hình | 346,97 (324) | 0,989 | 0,023 | 0,053 | ||
| M2. Hệ số tải | 371,13 (339) | 0,985 | 0,027 | 0,063 | M2 với M1: 24,17 (15), p = 0,062 | −0,004 |
| M3. Hệ số chặn | 381,30 (354) | 0,987 | 0,024 | 0,064 | M3 với M2: 10,16 (15), p = 0,809 | +0,002 |
JASP chỉ in chi bình phương trong Model Fit. CFI, RMSEA và SRMR có trong Output Options > Additional fit measures; bảng trên lấy từ lavaan và khớp với JASP. Chênh lệch chi bình phương tính tay: 371,13 − 346,97 = 24,17 với 339 − 324 = 15 bậc tự do; p tính bằng hàm =CHISQ.DIST.RT(24.17; 15) trong Excel.
Đọc kết quả:
- Mô hình cấu hình phù hợp tốt (CFI 0,989; RMSEA 0,023): hai nhóm có cùng cấu trúc năm nhân tố.
- Bất biến hệ số tải đạt, nhưng sát ngưỡng theo chi bình phương: p = 0,062 (FIML) và 0,068 (dữ liệu đủ). Chênh lệch CFI chỉ −0,004, nhỏ hơn nhiều so với ngưỡng 0,01. SRMR tăng 0,010, dưới ngưỡng 0,030 của Chen (2007).
- Bất biến hệ số chặn đạt rõ ràng (p = 0,809; CFI không giảm).
Kiểm định điểm (score test) trên M2 cho biết câu nào lệch nhiều nhất: hệ số tải của HI2 (chi bình phương 1 bậc tự do = 5,78; p = 0,016). Với 15 hệ số tải được kiểm định cùng lúc, một giá trị p cỡ 0,016 là điều dễ xảy ra do ngẫu nhiên (ngưỡng Bonferroni là 0,05/15 = 0,003) và kiểm định tổng thể không bác bỏ bất biến. Vì vậy bài không nới ràng buộc của HI2. Nếu kiểm định tổng thể bị bác bỏ, cách xử lý là bất biến một phần (partial invariance): nới ràng buộc của một vài câu lệch nhiều nhất, miễn là mỗi nhân tố còn ít nhất hai câu được ràng buộc (Byrne, 2016).
Sau khi đạt bất biến hệ số chặn, có thể so sánh trung bình tiềm ẩn giữa hai nhóm. Bảng Intercepts của mô hình M3 (Hình 8) cho trung bình nhóm Nam so với nhóm Nữ (bằng 0):
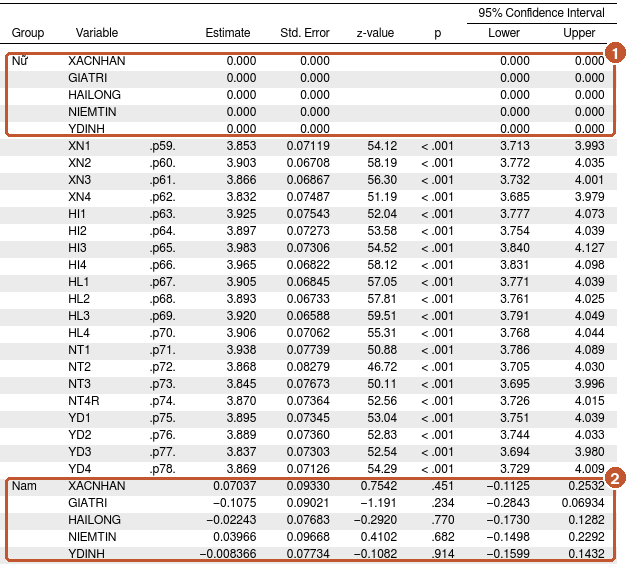
Hình 8. (1) Trung bình tiềm ẩn nhóm Nữ cố định bằng 0, (2) trung bình tiềm ẩn nhóm Nam so với nhóm Nữ.
Trung bình tiềm ẩn. Không khái niệm nào có trung bình khác nhau giữa nam và nữ: chênh lệch lớn nhất là giá trị cảm nhận, nam thấp hơn nữ 0,11 điểm (p = 0,234); ý định mua lại gần như bằng nhau (chênh lệch 0,01; p = 0,914). Kết luận này chỉ đúng vì đã đạt bất biến hệ số chặn. So sánh điểm trung bình giữa hai nhóm khi chưa kiểm định bất biến (ví dụ dùng kiểm định t trên điểm trung bình, bài T-test) ngầm giả định điều này.
AMOS không in SRMR trong Model Fit; SRMR trong bảng tính bằng lavaan. Có thể lấy SRMR trong AMOS bằng Plugins > Standardized RMR (bài chỉ số độ phù hợp của mô hình).
6. So sánh đường dẫn giữa Nam và Nữ
Khi đã có bất biến đo lường, có thể so sánh các đường dẫn cấu trúc giữa hai nhóm.
Một lỗi cần biết của JASP 0.99.0
Cách tự nhiên là bỏ Intercepts, khôi phục dòng ~ 0*1 và đánh dấu Equality Constraints > Regressions. Khi chạy thử, chi bình phương không đổi (vẫn 371,1 với 339 bậc tự do), nghĩa là ràng buộc không được áp dụng. Đặt nhãn chung trong cú pháp, như c(h1, h1)*XACNHAN, cũng cho kết quả y hệt và một cảnh báo "modifier label specified multiple times" khi bật Output Options > Show warnings.
Nguyên nhân: để tính bảng Indirect Effects và Total Effects, JASP tự gắn nhãn riêng cho từng đường dẫn ở từng nhóm, đè lên ràng buộc của người dùng. JASP chỉ bỏ qua bước này khi cú pháp có ít nhất một tham số định nghĩa bằng :=. Vì vậy, cách làm đúng là: đặt nhãn trong cú pháp và thêm ít nhất một dòng :=. Bảng Regression Coefficients của bước trước (hai nhóm có hệ số khác nhau, Hình 9) cho thấy rõ ràng buộc đã không được áp dụng.
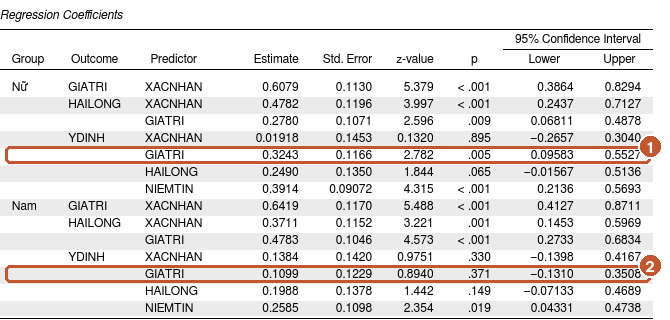
Hình 9. Hệ số đường dẫn từng nhóm trong mô hình hệ số tải bằng nhau: (1) GIATRI đến YDINH ở nhóm Nữ, (2) cùng đường ở nhóm Nam.
Cách 1. Ràng buộc cả bảy đường dẫn cùng lúc (M4)
Cách thứ nhất kiểm định chung: ràng buộc cả bảy đường dẫn bằng nhau giữa hai nhóm.
- Bỏ Intercepts, giữ Loadings.
- Sửa cú pháp: gắn nhãn chung cho hai nhóm và thêm một tham số định nghĩa. Tác động gián tiếp
XN_GT_YDđược chọn vì có ý nghĩa với đề tài (bài biến trung gian trong SEM), không chỉ để lách lỗi:
GIATRI  ~ c(h1, h1)*XACNHAN
HAILONG ~ c(h2, h2)*XACNHAN + c(h3, h3)*GIATRI
YDINH   ~ c(h4, h4)*XACNHAN + c(h5, h5)*GIATRI + c(h6, h6)*HAILONG + c(h7, h7)*NIEMTIN
XACNHAN ~~ NIEMTIN
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1
XN_GT_YD := h1*h5
- Bấm Ctrl + Enter. Số tham số tự do giảm từ 121 xuống 114 và bậc tự do tăng từ 339 lên 346: ràng buộc đã có hiệu lực (Hình 10, Bảng 5).
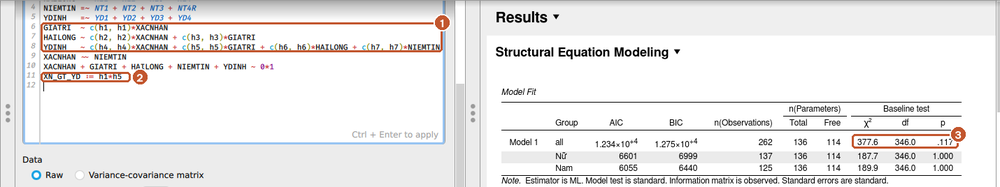
Hình 10. (1) Bảy đường dẫn có nhãn chung cho hai nhóm, (2) tham số định nghĩa giúp JASP giữ nhãn của người dùng, (3) độ phù hợp của M4: 377,6 với 346 bậc tự do.
Bảng 5. Kiểm định ràng buộc bảy đường dẫn.
| Mô hình | Chi bình phương (df) | CFI | So sánh: chênh lệch chi bình phương (df), p | Chênh lệch CFI |
|---|---|---|---|---|
| M2. Hệ số tải | 371,13 (339) | 0,985 | ||
| M4. Đường dẫn | 377,62 (346) | 0,985 | M4 với M2: 6,49 (7), p = 0,484 | 0,000 |
Ràng buộc bảy đường dẫn bằng nhau không làm mô hình xấu đi. Xét chung, giới tính không điều tiết mô hình.
Trong AMOS, chạy lại Multiple-Group Analysis không bật Estimate means and intercepts, giữ hai cột Measurement weights và Structural weights, rồi đọc dòng Structural weights trong mục Model Comparison. Trên dữ liệu đủ, chênh lệch chi bình phương là 7,13 với 7 bậc tự do (p = 0,415), cùng kết luận.
Cách 2. Kiểm định từng đường dẫn
Kiểm định chung có thể che một khác biệt ở một đường. Để kiểm định từng đường, gắn nhãn riêng cho từng nhóm và định nghĩa hiệu số. Nhớ rằng nhóm 1 là Nữ, nhóm 2 là Nam:
GIATRI  ~ c(h1nu, h1nam)*XACNHAN
HAILONG ~ c(h2nu, h2nam)*XACNHAN + c(h3nu, h3nam)*GIATRI
YDINH   ~ c(h4nu, h4nam)*XACNHAN + c(h5nu, h5nam)*GIATRI + c(h6nu, h6nam)*HAILONG + c(h7nu, h7nam)*NIEMTIN
XACNHAN ~~ NIEMTIN
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1
hieu_H1 := h1nam - h1nu
hieu_H2 := h2nam - h2nu
hieu_H3 := h3nam - h3nu
hieu_H4 := h4nam - h4nu
hieu_H5 := h5nam - h5nu
hieu_H6 := h6nam - h6nu
hieu_H7 := h7nam - h7nu
Hình 11 là cú pháp sau khi đặt nhãn riêng cho từng nhóm.
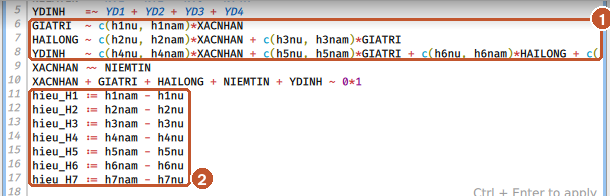
Hình 11. (1) Nhãn riêng cho nhóm Nữ (vị trí thứ nhất) và nhóm Nam (vị trí thứ hai), (2) bảy hiệu số Nam trừ Nữ.
Chi bình phương vẫn là 371,1 (mô hình M2), vì không có thêm ràng buộc nào. Bảng Defined Parameters cho kiểm định z của từng hiệu số (Hình 12, Hình 13, Bảng 6). Đây chính là Critical ratios for differences của AMOS.
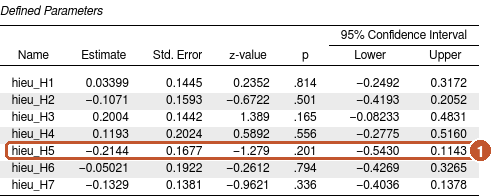
Hình 12. Hiệu số đường dẫn giữa nam và nữ; (1) đường giá trị cảm nhận đến ý định: Nam thấp hơn Nữ 0,214, z = −1,28, p = 0,201.
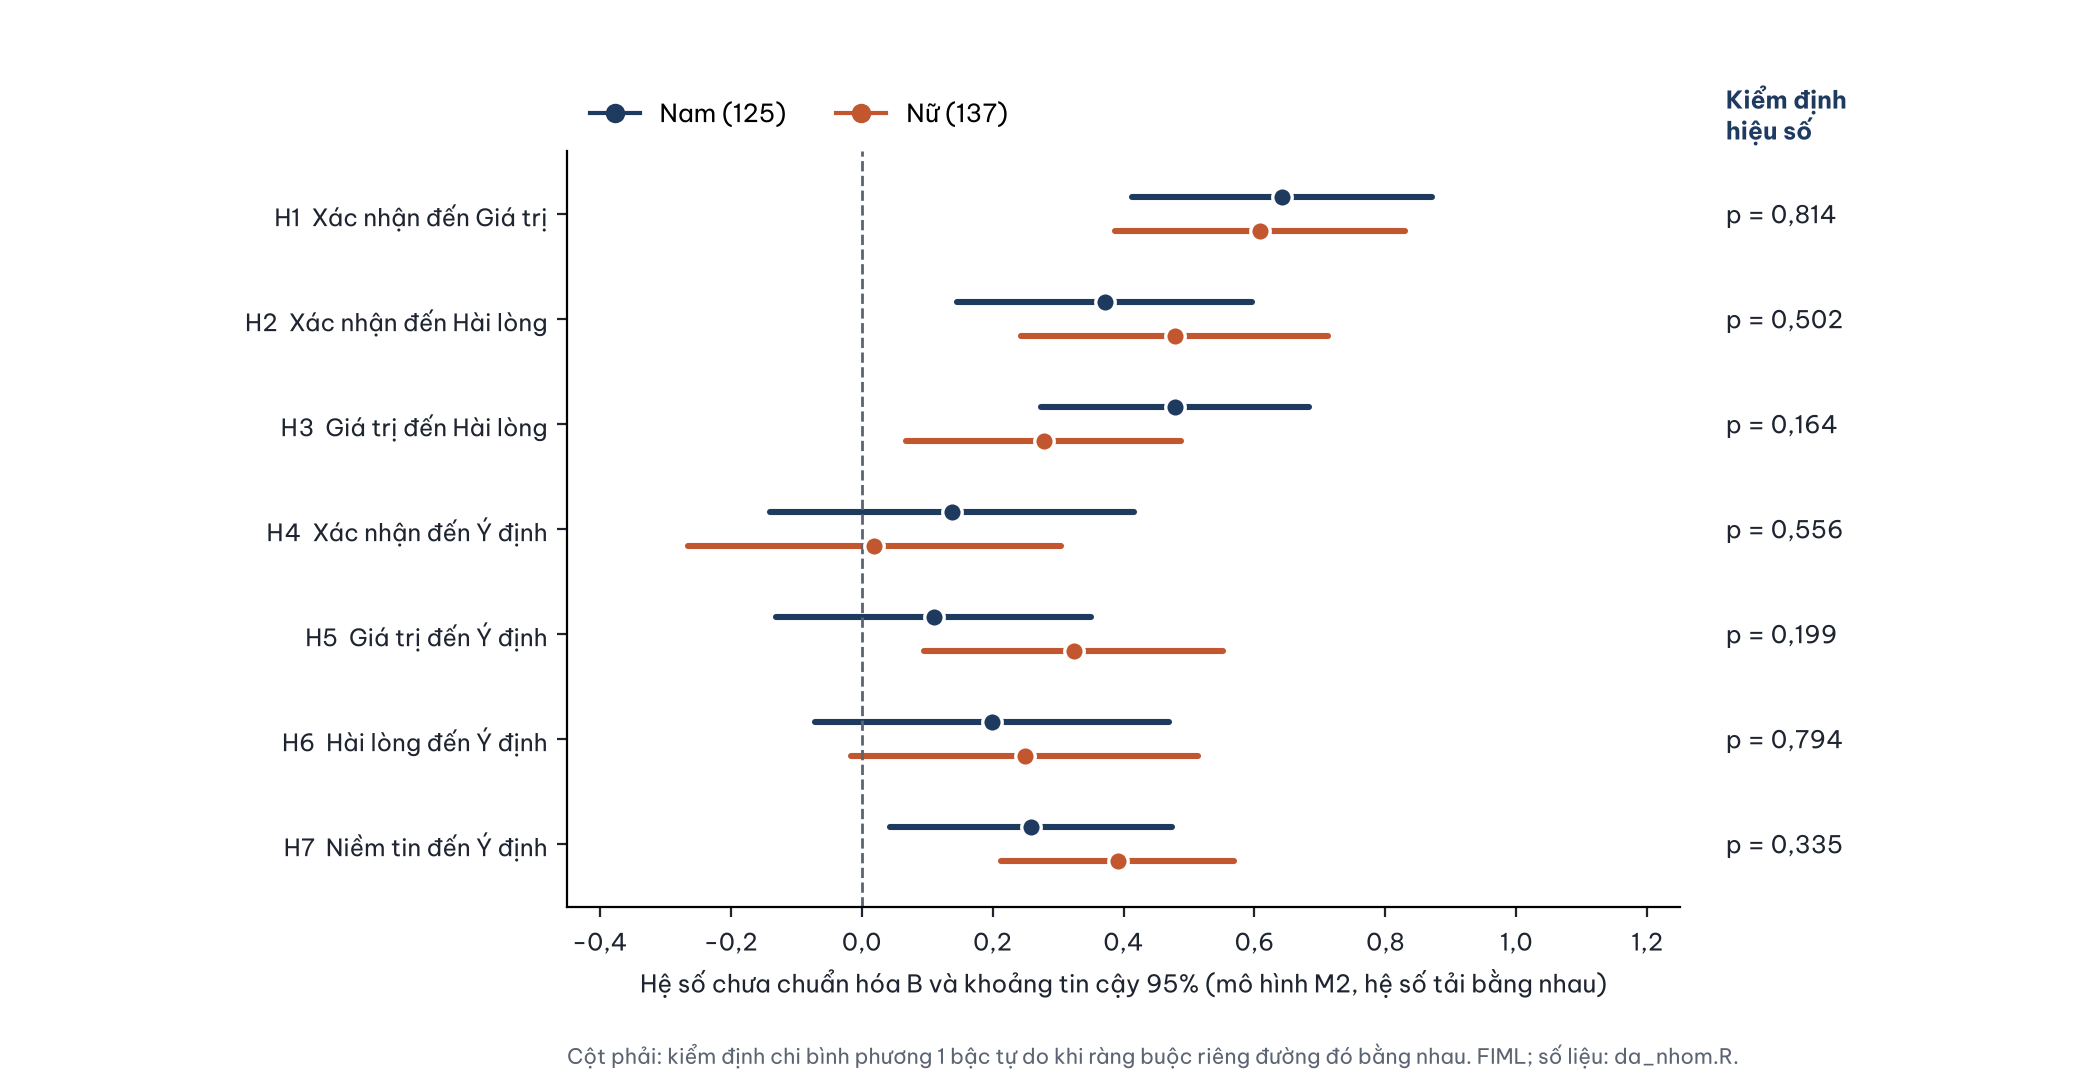
Hình 13. Hệ số đường dẫn chưa chuẩn hóa và khoảng tin cậy 95% của hai nhóm (mô hình M2).
Bảng 6. Hệ số đường dẫn của Nam và Nữ.
| Giả thuyết | Nam: B (p) | Nữ: B (p) | z của hiệu (JASP) | Chênh lệch chi bình phương (1 df), p |
|---|---|---|---|---|
| H1. Xác nhận đến Giá trị | 0,642 (< 0,001) | 0,608 (< 0,001) | 0,24 | 0,06; p = 0,814 |
| H2. Xác nhận đến Hài lòng | 0,371 (0,001) | 0,478 (< 0,001) | −0,67 | 0,45; p = 0,502 |
| H3. Giá trị đến Hài lòng | 0,478 (< 0,001) | 0,278 (0,009) | 1,39 | 1,94; p = 0,164 |
| H4. Xác nhận đến Ý định | 0,138 (0,330) | 0,019 (0,895) | 0,59 | 0,35; p = 0,556 |
| H5. Giá trị đến Ý định | 0,110 (0,371) | 0,324 (0,005) | −1,28 | 1,65; p = 0,199 |
| H6. Hài lòng đến Ý định | 0,199 (0,149) | 0,249 (0,065) | −0,26 | 0,07; p = 0,794 |
| H7. Niềm tin đến Ý định | 0,259 (0,019) | 0,391 (< 0,001) | −0,96 | 0,93; p = 0,335 |
FIML, N = 262. z của hiệu = (Nam − Nữ) / sai số chuẩn của hiệu. Cột cuối: ràng buộc riêng đường đó bằng nhau, so với M2 (tính bằng lavaan; trong JASP làm bằng cách đổi nhãn riêng của đường đó thành nhãn chung).
Kiểm định chung có thể che một khác biệt ở một đường. Có hai cách kiểm định riêng từng đường trong AMOS:
- Ràng buộc từng đường: trong mô hình Measurement weights, đặt cùng một nhãn cho đường dẫn đó ở hai nhóm (ví dụ đổi
b5_2thànhb5_1trong Object Properties của nhóm Nu), chạy lại và so sánh chi bình phương với M2 (1 bậc tự do). Cách gọn hơn: trong Manage Models, tạo mô hình mới với ràng buộcb5_1 = b5_2. - Critical ratios for differences: AMOS in ma trận Pairwise Parameter Comparisons trong Text Output. Tìm ô giao giữa
b5_1vàb5_2: giá trị tuyệt đối lớn hơn 1,96 thì hai hệ số khác nhau ở mức 5%. Đọc ma trận này trong mô hình Measurement weights, vì khi đó hai nhóm có cùng thang đo.
Lỗi diễn giải cần tránh
Nhìn vào H5: hệ số có ý nghĩa ở nhóm Nữ (p < 0,01) nhưng không có ý nghĩa ở nhóm Nam (p gần 0,4). Rất dễ viết: "giá trị cảm nhận chỉ ảnh hưởng đến ý định mua lại của nữ, giới tính điều tiết quan hệ này". Kết luận đó sai. Kiểm định trực tiếp hiệu số cho p khoảng 0,2: hai hệ số không khác nhau có ý nghĩa. Khoảng tin cậy của hai nhóm trong Hình 13 chồng lên nhau gần hết.
"Có ý nghĩa" và "không có ý nghĩa" khác nhau không có nghĩa là hai hệ số khác nhau có ý nghĩa (Gelman & Stern, 2006). Một hệ số 0,32 với p = 0,005 và một hệ số 0,11 với p = 0,37 hoàn toàn có thể đến từ cùng một giá trị thật, chỉ khác nhau do sai số chọn mẫu. Kết luận về điều tiết phải dựa trên kiểm định hiệu số, không dựa trên việc so sánh hai giá trị p.
Ghi chú về lực kiểm định: với khoảng 125 người mỗi nhóm, sai số chuẩn của hiệu số đường dẫn H5 là khoảng 0,17. Hiệu số thật phải lớn cỡ 0,47 thì kiểm định mới có lực 80%. Kết quả "không khác biệt" ở đây nên được viết là chưa phát hiện khác biệt, không phải "chứng minh hai nhóm như nhau".
7. Biến điều tiết liên tục: biến tương tác tiềm ẩn
Giả thuyết bổ sung: niềm tin càng cao, tác động của sự hài lòng đến ý định mua lại càng yếu, vì khách hàng tin sàn đã có lý do để quay lại dù lần mua này chưa thật hài lòng. Kiểm định bằng tích HAILONG × NIEMTIN.
Trong CB-SEM, tích của hai biến tiềm ẩn không quan sát được. Có ba cách xử lý chính (Marsh và cộng sự, 2004) (Bảng 7):
Bảng 7. Các cách tạo biến tương tác tiềm ẩn.
| Cách | Ý tưởng | Phần mềm |
|---|---|---|
| Chỉ báo tích (product indicators) | Tạo biến tiềm ẩn tương tác đo bằng tích các câu hỏi | AMOS, JASP, lavaan |
| LMS, QML | Ước lượng trực tiếp tương tác bằng hợp lý cực đại | Mplus, gói R nlsem |
| Điểm nhân tố hoặc điểm trung bình | Nhân điểm, rồi chạy hồi quy | SPSS, PROCESS; bỏ qua sai số đo lường |
Bài dùng chỉ báo tích, ghép cặp và lấy tâm kép (Marsh và cộng sự, 2004; Lin và cộng sự, 2010), vì làm được trên cả AMOS và JASP:
- Ghép cặp: HL1 với NT1, HL2 với NT2, HL3 với NT3, HL4 với NT4R. Mỗi câu chỉ dùng một lần, nên 4 chỉ báo tích không có sai số tương quan với nhau.
- Lấy tâm từng câu: trừ trung bình của câu đó.
- Nhân theo cặp.
- Lấy tâm lần hai: trừ trung bình của tích. Bước này giúp không phải ước lượng thêm cấu trúc trung bình phức tạp (Lin và cộng sự, 2010).
Phần B của chuan_bi_bai29.sps làm bốn bước này bằng AGGREGATE và COMPUTE, lưu thành du_lieu_tich.sav với các biến HLxNT1 đến HLxNT4. Chỉ báo tích giống hệt hàm indProd() của gói semTools (Jorgensen và cộng sự, 2022) đến chữ số thập phân thứ 15 (Hình 14).
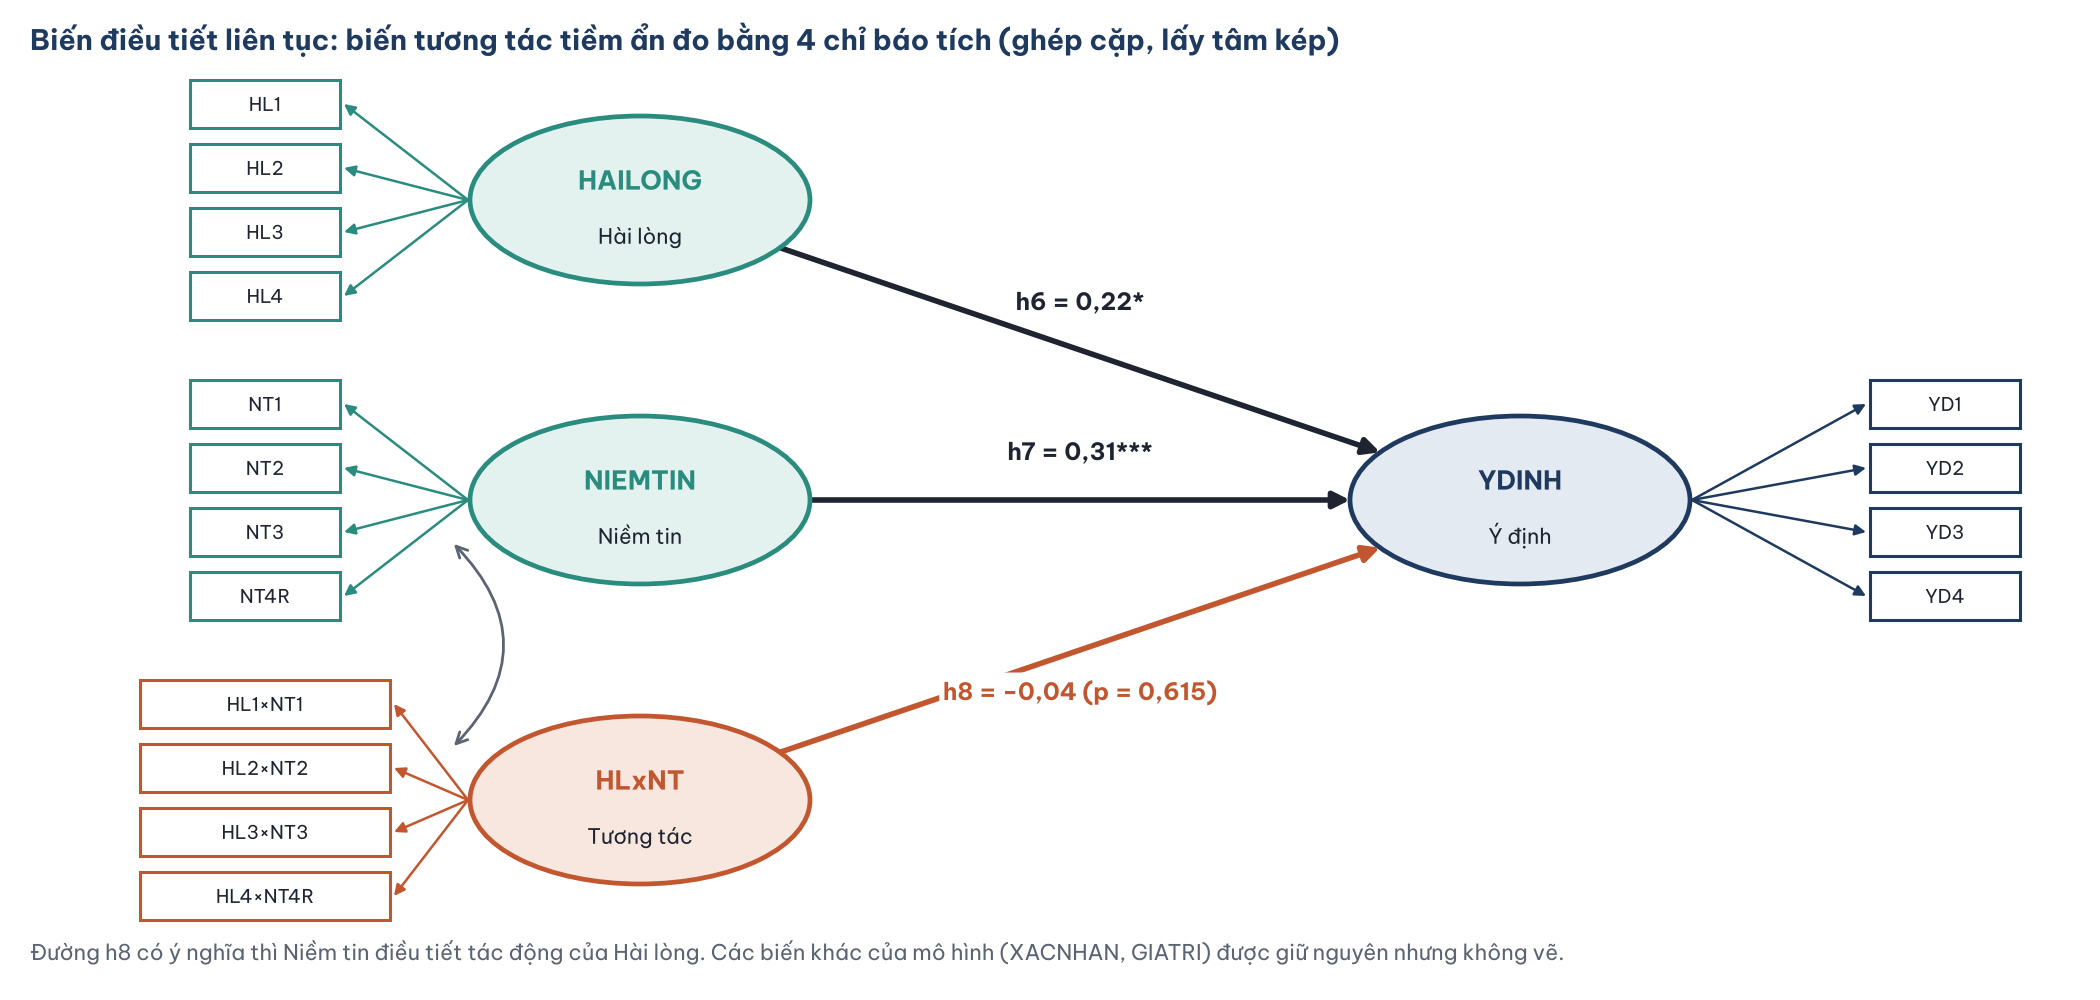
Hình 14. Biến tương tác HLxNT đo bằng 4 chỉ báo tích, tác động đến ý định mua lại qua đường h8.
Thao tác trong JASP
Mô hình có biến tương tác tiềm ẩn chạy trong một phân tích SEM mới, không dùng biến nhóm.
- Mở
du_lieu_tich.sav. Kiểm tra HLxNT1 đến HLxNT4 ở kiểu Scale. - Mở một phân tích Structural Equation Modeling mới (không dùng biến nhóm).
- Nhập cú pháp:
XACNHAN =~ XN1 + XN2 + XN3 + XN4
GIATRI  =~ HI1 + HI2 + HI3 + HI4
HAILONG =~ HL1 + HL2 + HL3 + HL4
NIEMTIN =~ NT1 + NT2 + NT3 + NT4R
YDINH   =~ YD1 + YD2 + YD3 + YD4
HLxNT   =~ HLxNT1 + HLxNT2 + HLxNT3 + HLxNT4
GIATRI  ~ XACNHAN
HAILONG ~ XACNHAN + GIATRI
YDINH   ~ XACNHAN + GIATRI + h6*HAILONG + h7*NIEMTIN + h8*HLxNT
XACNHAN ~~ NIEMTIN + HLxNT
NIEMTIN ~~ vNT*NIEMTIN + HLxNT
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH + HLxNT ~ 0*1
doc_NT_thap := h6 - h8*sqrt(vNT)
doc_NT_tb   := h6
doc_NT_cao  := h6 + h8*sqrt(vNT)
Nhãn vNT gắn cho phương sai của NIEMTIN, để tính độ dốc đơn giản (simple slopes) của HAILONG tại niềm tin thấp (trung bình trừ 1 độ lệch chuẩn), trung bình và cao (cộng 1 độ lệch chuẩn). Ba dòng := cũng giúp JASP giữ nguyên nhãn h6, h7, h8 (phần 6) (Hình 15, Hình 16, Hình 17).
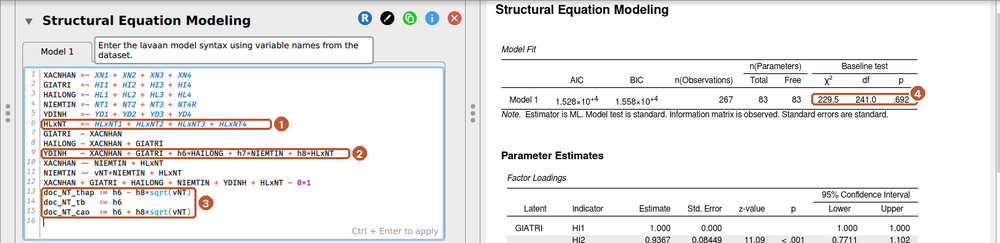
Hình 15. (1) Biến tương tác đo bằng 4 chỉ báo tích, (2) đường h8, (3) độ dốc đơn giản, (4) độ phù hợp: chi bình phương 229,5 với 241 bậc tự do.
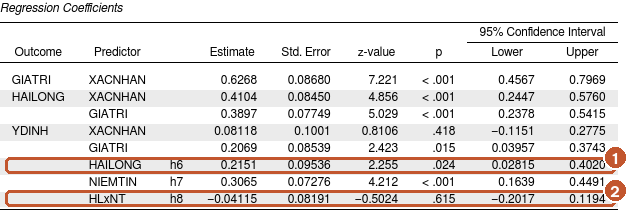
Hình 16. (1) Tác động của HAILONG khi NIEMTIN ở mức trung bình, (2) hệ số tương tác h8 = −0,041; p = 0,615.
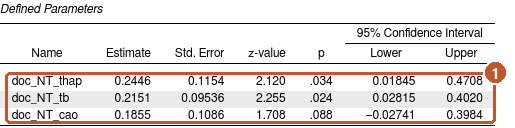
Hình 17. (1) Độ dốc của HAILONG tại ba mức NIEMTIN.
Thao tác trong AMOS
Nếu bạn dùng AMOS thay cho JASP, biến tương tác tiềm ẩn được vẽ thêm trên sơ đồ SEM, dùng file người trả lời đủ có sẵn bốn chỉ báo tích.
- Mở mô hình SEM của bài mô hình cấu trúc SEM, chọn File > Data Files và mở
du_lieu_tich_du.sav(254 người trả lời đủ). - Vẽ thêm một biến tiềm ẩn bằng nút Draw a latent variable or add an indicator to a latent variable, nhấp 4 lần để có 4 biến quan sát.
- Gán tên biến quan sát bằng View > Variables in Dataset: kéo HLxNT1 đến HLxNT4 vào 4 ô vuông. Đặt tên biến tiềm ẩn là HLxNT (nhấp đúp, thẻ Text).
- Vẽ mũi tên một chiều từ HLxNT đến YDINH; đặt nhãn h8 (nhấp đúp mũi tên, thẻ Parameters, ô Regression weight).
- Vẽ hiệp phương sai (mũi tên hai chiều) giữa HLxNT với XACNHAN và với NIEMTIN, giống các biến ngoại sinh khác.
- Đặt tên sai số của 4 chỉ báo tích bằng Plugins > Name Unobserved Variables, rồi chạy Calculate Estimates.
Không cần vẽ hiệp phương sai giữa sai số của các chỉ báo tích, vì mỗi câu hỏi gốc chỉ xuất hiện trong một tích.
AMOS không tính sẵn độ dốc đơn giản. Có thể tính bằng Estimands (bài biến trung gian trong SEM) hoặc tính tay: độ dốc = h6 + h8 × mức NIEMTIN, với mức NIEMTIN là ± căn bậc hai phương sai của NIEMTIN (bảng Variances). Kết quả FIML:
Kết quả (FIML, N = 267)
Kết quả của mô hình có biến tương tác tiềm ẩn được trình bày ở Bảng 8.
Bảng 8. Kết quả mô hình có biến tương tác tiềm ẩn.
| Đường dẫn đến YDINH | B | SE | p | KTC 95% | Beta |
|---|---|---|---|---|---|
| XACNHAN | 0,081 | 0,100 | 0,418 | [−0,115; 0,277] | 0,084 |
| GIATRI | 0,207 | 0,085 | 0,015 | [0,040; 0,374] | 0,231 |
| HAILONG (h6) | 0,215 | 0,095 | 0,024 | [0,028; 0,402] | 0,229 |
| NIEMTIN (h7) | 0,307 | 0,073 | < 0,001 | [0,164; 0,449] | 0,327 |
| HLxNT (h8) | −0,041 | 0,082 | 0,615 | [−0,202; 0,119] | −0,038 |
Đọc kết quả:
- Hệ số tương tác h8 âm (đúng chiều giả thuyết) nhưng rất nhỏ và không có ý nghĩa (p = 0,615; khoảng tin cậy chứa 0). R² của ý định mua lại chỉ tăng từ 0,444 lên 0,445 khi thêm tương tác (f² = 0,0003). Niềm tin không điều tiết tác động của sự hài lòng.
- h6 bây giờ là tác động của sự hài lòng khi niềm tin ở mức trung bình, không còn là "tác động chung" như bài mô hình cấu trúc SEM. Đây là cách đọc đúng của hệ số chính khi có biến tương tác.
- Bỏ qua các chỉ số độ phù hợp của mô hình có chỉ báo tích: tích của hai biến không có phân phối chuẩn nên chi bình phương ML không còn chính xác. Mục đích của mô hình này là kiểm định h8 (Hình 18).
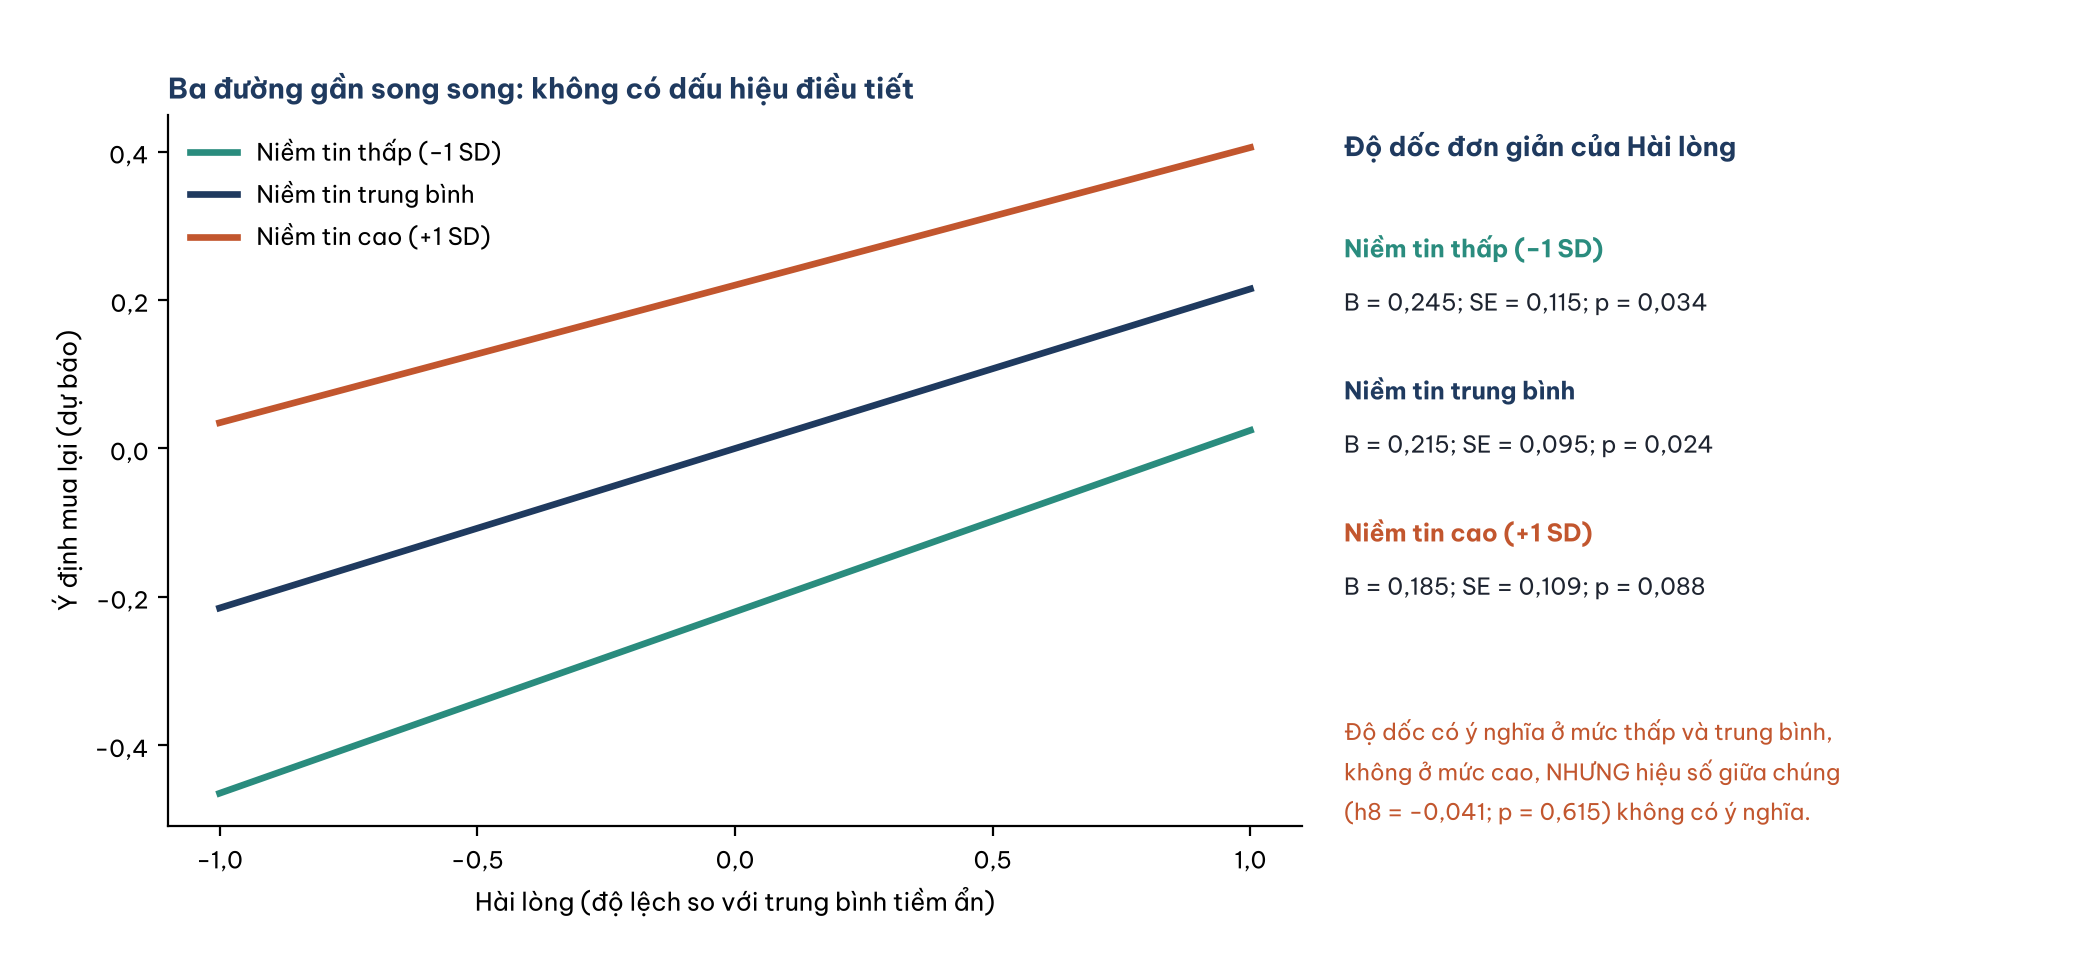
Hình 18. Tác động của sự hài lòng đến ý định mua lại tại ba mức niềm tin (FIML, N = 267).
Hình 18 lặp lại bài học của phần 6 dưới dạng khác: độ dốc của sự hài lòng có ý nghĩa khi niềm tin thấp (p = 0,034) và trung bình (p = 0,024), không có ý nghĩa khi niềm tin cao (p = 0,088). Nhưng ba độ dốc (0,245; 0,215; 0,185) gần như bằng nhau và ba đường gần song song. Kiểm định điều tiết là kiểm định h8, không phải đếm xem độ dốc nào qua ngưỡng 0,05.
Thử chia đôi theo trung vị. Nếu chia khách hàng thành nhóm niềm tin thấp (điểm trung bình NT từ 4 trở xuống, 151 người) và cao (trên 4, 116 người) rồi chạy đa nhóm, tác động của sự hài lòng là 0,279 (p = 0,035) ở nhóm thấp và 0,205 (p = 0,234) ở nhóm cao. Lại một cặp "có ý nghĩa, không có ý nghĩa", nhưng hiệu số không có ý nghĩa (chênh lệch chi bình phương 0,12; p = 0,733). Cách chia đôi còn tạo hai nhóm lệch cỡ vì nhiều người có điểm đúng bằng 4 (trung vị) và gộp người 3,75 điểm với người 1 điểm vào cùng một nhóm (MacCallum và cộng sự, 2002).
8. Trình bày kết quả
Phân tích đa nhóm theo giới tính được thực hiện với ước lượng FIML trên 262 người (nam 125, nữ 137; 5 người chọn giới tính khác bị loại vì nhóm quá nhỏ). Mô hình cấu hình phù hợp tốt (chi bình phương = 346,97; df = 324; CFI = 0,989; RMSEA = 0,023). Ràng buộc hệ số tải bằng nhau không làm giảm đáng kể độ phù hợp (chênh lệch chi bình phương = 24,17; df = 15; p = 0,062; chênh lệch CFI = −0,004) và ràng buộc thêm hệ số chặn cũng vậy (chênh lệch chi bình phương = 10,16; df = 15; p = 0,809; chênh lệch CFI = +0,002), cho thấy thang đo đạt bất biến hệ số tải và hệ số chặn giữa hai giới (Cheung & Rensvold, 2002). Ràng buộc bảy hệ số đường dẫn bằng nhau không làm giảm độ phù hợp (chênh lệch chi bình phương = 6,49; df = 7; p = 0,484) và không có hệ số nào khác nhau có ý nghĩa giữa hai nhóm khi kiểm định riêng (p từ 0,164 đến 0,814). Giới tính không điều tiết các quan hệ trong mô hình. Biến tương tác tiềm ẩn giữa sự hài lòng và niềm tin, đo bằng bốn chỉ báo tích ghép cặp và lấy tâm kép (Lin và cộng sự, 2010), không có tác động có ý nghĩa đến ý định mua lại (B = −0,041; KTC 95% [−0,202; 0,119]). Với khoảng 130 người mỗi nhóm, lực kiểm định để phát hiện khác biệt nhỏ giữa các nhóm còn hạn chế.
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi phân tích đa nhóm và kiểm định biến điều tiết.
- So sánh giá trị p của hai nhóm thay vì kiểm định hiệu số: kết luận "có điều tiết" vì hệ số có ý nghĩa ở nhóm này, không ở nhóm kia.
- Bỏ qua bất biến đo lường và so sánh đường dẫn hoặc điểm trung bình ngay.
- Chỉ dùng chênh lệch chi bình phương với mẫu lớn: khác biệt rất nhỏ cũng có ý nghĩa. Báo cáo kèm chênh lệch CFI, RMSEA, SRMR.
- Chia đôi biến liên tục theo trung vị để làm đa nhóm.
- Viết "hai nhóm như nhau" khi kiểm định không có ý nghĩa với cỡ nhóm nhỏ. Viết "không phát hiện khác biệt" và nêu hạn chế về lực kiểm định.
Tài liệu tham khảo
Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
Byrne, B. M. (2016). Structural equation modeling with AMOS: Basic concepts, applications, and programming (3rd ed.). Routledge. https://www.routledge.com/Structural-Equation-Modeling-With-AMOS-Basic-Concepts-Applications-and/Byrne/p/book/9781138797031
Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling, 9(2), 233–255. https://doi.org/10.1207/S15328007SEM0902_5
Free Software Foundation. (2023). GNU PSPP (Version 2.0.0) [Computer software]. https://www.gnu.org/software/pspp/
Gelman, A., & Stern, H. (2006). The difference between "significant" and "not significant" is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006X152649
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2022). semTools: Useful tools for structural equation modeling (R package version 0.5-6) [Computer software]. https://CRAN.R-project.org/package=semTools
Lin, G.-C., Wen, Z., Marsh, H. W., & Lin, H.-S. (2010). Structural equation models of latent interactions: Clarification of orthogonalizing and double-mean-centering strategies. Structural Equation Modeling, 17(3), 374–391. https://doi.org/10.1080/10705511.2010.488999
MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
Marsh, H. W., Wen, Z., & Hau, K.-T. (2004). Structural equation models of latent interactions: Evaluation of alternative estimation strategies and indicator construction. Psychological Methods, 9(3), 275–300. https://doi.org/10.1037/1082-989X.9.3.275
Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Vandenberg, R. J., & Lance, C. E. (2000). A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Organizational Research Methods, 3(1), 4–70. https://doi.org/10.1177/109442810031002