
KIỂM ĐỊNH GIẢ THUYẾT TRONG MÔ HÌNH SEM
Đọc hệ số chuẩn hóa, giá trị p, khoảng tin cậy bootstrap, độ lớn f² và so sánh hai hệ số đường dẫn
Bài nên đọc trước
Bài mô hình cấu trúc SEM đã chạy mô hình cấu trúc và ghi nhận sáu trong bảy đường dẫn có ý nghĩa. Bài này đi sâu vào câu hỏi mà phần kết quả của mọi luận văn phải trả lời: từng giả thuyết được ủng hộ hay không và mạnh đến đâu. Bài hướng dẫn đọc đúng hệ số chưa chuẩn hóa và chuẩn hóa, giá trị p và khoảng tin cậy, đo độ lớn tác động bằng f², so sánh hai hệ số bằng kiểm định thay vì bằng mắt và viết kết luận cho cả giả thuyết không được ủng hộ.
Ảnh được chụp từ JASP 0.99.0 (JASP Team, 2026), mở tiếp phân tích SEM của bài mô hình cấu trúc SEM. Các con số được đối chiếu bằng gói lavaan của R (Rosseel, 2012), file kiem_dinh_gia_thuyet.R đi kèm. Hình về AMOS là sơ đồ tự vẽ, không phải ảnh chụp màn hình; tên menu và mục kết quả ghi đúng giao diện tiếng Anh của AMOS (IBM Corp., 2026) (Hình 1).
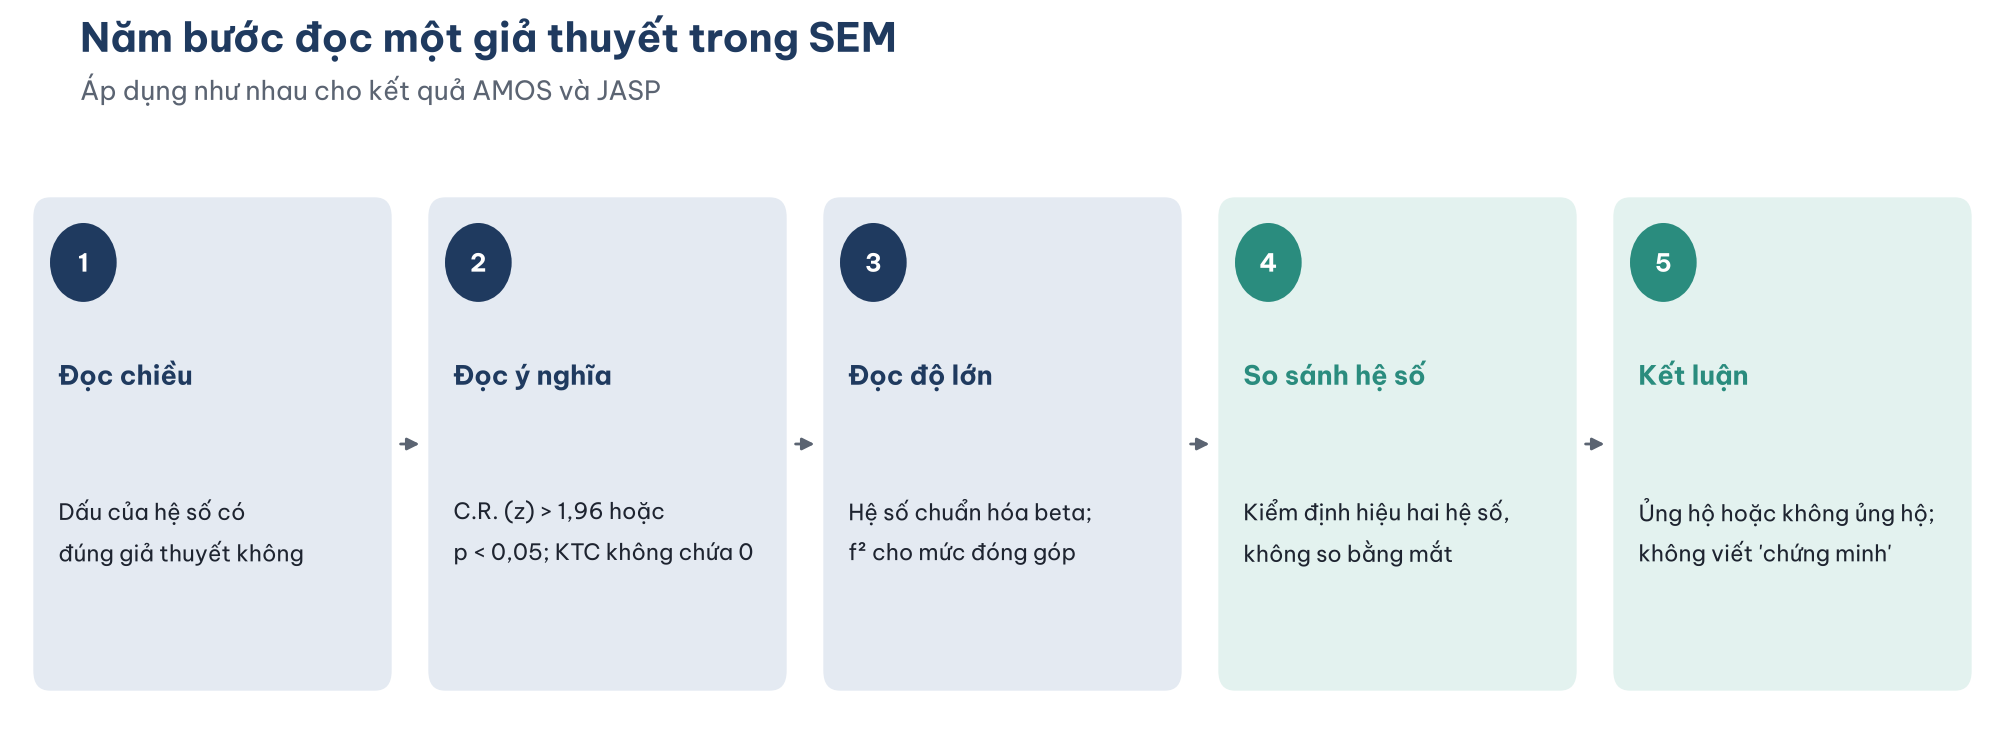
Hình 1. Năm bước đọc một giả thuyết trong SEM.
Dữ liệu mẫu. Dữ liệu và script dùng trong bài nằm ở thư mục
27-kiem-dinh-gia-thuyet-semcủa kho dữ liệu mẫu trên GitHub. Muốn tải cả kho, bấm Code > Download ZIP rồi giải nén và giữ nguyên cấu trúc thư mục.
1. Hệ số chưa chuẩn hóa và chuẩn hóa
Mỗi đường dẫn có hai hệ số:
- Hệ số chưa chuẩn hóa (B): khi biến nguyên nhân tăng một đơn vị, biến kết quả tăng B đơn vị, giữ các biến khác không đổi. Đơn vị của biến tiềm ẩn là đơn vị của câu hỏi có hệ số tải cố định bằng 1 (bài vẽ mô hình đầu tiên), nên B khó diễn giải trực tiếp. Kiểm định ý nghĩa (S.E., C.R., p) được tính trên B.
- Hệ số chuẩn hóa (beta): khi biến nguyên nhân tăng một độ lệch chuẩn, biến kết quả tăng beta độ lệch chuẩn. Beta dùng để so sánh độ lớn giữa các đường dẫn trong cùng một mô hình.
Theo Kline (2023), nên báo cáo cả hai, hoặc ít nhất beta kèm p.
2. Đặt nhãn và đọc kết quả trong JASP
Mở phân tích SEM của bài mô hình cấu trúc SEM và sửa phần mô hình cấu trúc để đặt nhãn h1 đến h7 trước tên biến nguyên nhân (Hình 2):
GIATRI ~ h1*XACNHAN
HAILONG ~ h2*XACNHAN + h3*GIATRI
YDINH ~ h4*XACNHAN + h5*GIATRI + h6*HAILONG + h7*NIEMTIN
XACNHAN ~~ NIEMTIN
XACNHAN + GIATRI + HAILONG + NIEMTIN + YDINH ~ 0*1
# So sanh hai he so: Niem tin va Hai long den Y dinh
hieu_NT_HL := h7 - h6
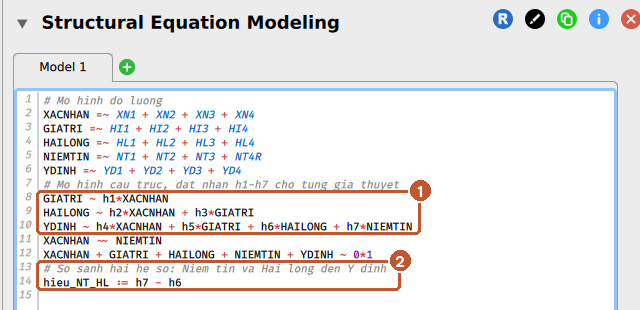
Hình 2. (1) Nhãn h1 đến h7 đặt trước biến nguyên nhân, (2) tham số định nghĩa để so sánh h7 với h6 (mục 6).
Nhãn không làm thay đổi kết quả; nó chỉ đặt tên cho tham số để dùng lại. Dòng := định nghĩa một tham số mới tính từ các tham số có nhãn; JASP in nó trong bảng Defined Parameters (Hình 3).
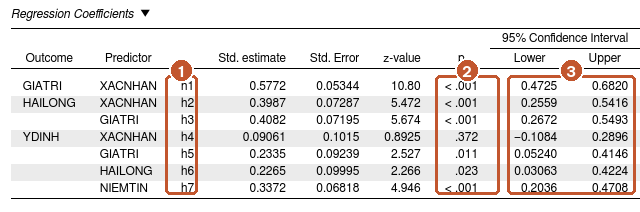
Hình 3. Bảng Regression Coefficients với Standardization = All. (1) Nhãn của từng đường dẫn, (2) giá trị p, (3) khoảng tin cậy 95% của hệ số chuẩn hóa.
Với Standardization = All, cột Std. estimate là beta và khoảng tin cậy là của beta. Đổi Standardization về None trong Output Options để xem B và khoảng tin cậy của B. Cột z-value tương đương C.R. của AMOS.
Muốn khoảng tin cậy bootstrap, chọn Standard errors = Bootstrap trong Estimation Options (mặc định 1000 mẫu, có thể tăng). Với 267 người và FIML, mỗi lần chạy mất vài phút.
Làm trong AMOS
Nếu bạn dùng AMOS thay cho JASP, hệ số đường dẫn và kiểm định của chúng nằm trong mục Estimates của Text Output.
Mở View > Text Output (F10), mục Estimates (Bảng 1):
Bảng 1. Các bảng cần đọc trong mục Estimates của AMOS.
| Bảng | Nội dung | Dòng cần đọc |
|---|---|---|
| Regression Weights | B, S.E., C.R., P và nhãn (Label) | GIATRI <--- XACNHAN và các đường dẫn cấu trúc khác |
| Standardized Regression Weights | beta | cùng các dòng trên |
| Squared Multiple Correlations | R² | GIATRI, HAILONG, YDINH |
Cột C.R. (critical ratio) là B chia S.E., tương đương thống kê z. Cột P in ba dấu sao (***) khi p < 0,001; khi báo cáo, ghi "p < 0,001". Bảng Regression Weights gộp cả hệ số tải và hệ số đường dẫn; hệ số đường dẫn là các dòng có hai biến tiềm ẩn ở hai đầu mũi tên.
AMOS không in khoảng tin cậy cho hệ số khi không chạy bootstrap. Để có khoảng tin cậy (mục 4), chạy trên file trả lời đủ du_lieu_amos_du.sav với Analysis Properties > Bootstrap: đánh dấu Perform bootstrap (2000 mẫu), Percentile confidence intervals và Bias-corrected confidence intervals (mức 95). Kết quả nằm ở mục Estimates > Scalars > Regression Weights, chuyển giữa Estimates và Bootstrap Confidence ở khung dưới bên trái của cửa sổ Text Output.
Đặt nhãn cho đường dẫn
Bấm đúp vào mũi tên, gõ nhãn (ví dụ h7) vào ô Regression weight của hộp Object Properties. Nhãn hiện trong cột Label và cần cho việc so sánh hai hệ số ở mục 6. Có thể đặt nhãn tự động cho mọi tham số bằng Plugins > Name Parameters, đánh dấu Regression weights.
3. Kết quả bảy giả thuyết
Hệ số chuẩn hóa và khoảng tin cậy của bảy giả thuyết được vẽ ở Hình 4 và tóm tắt ở Bảng 2.
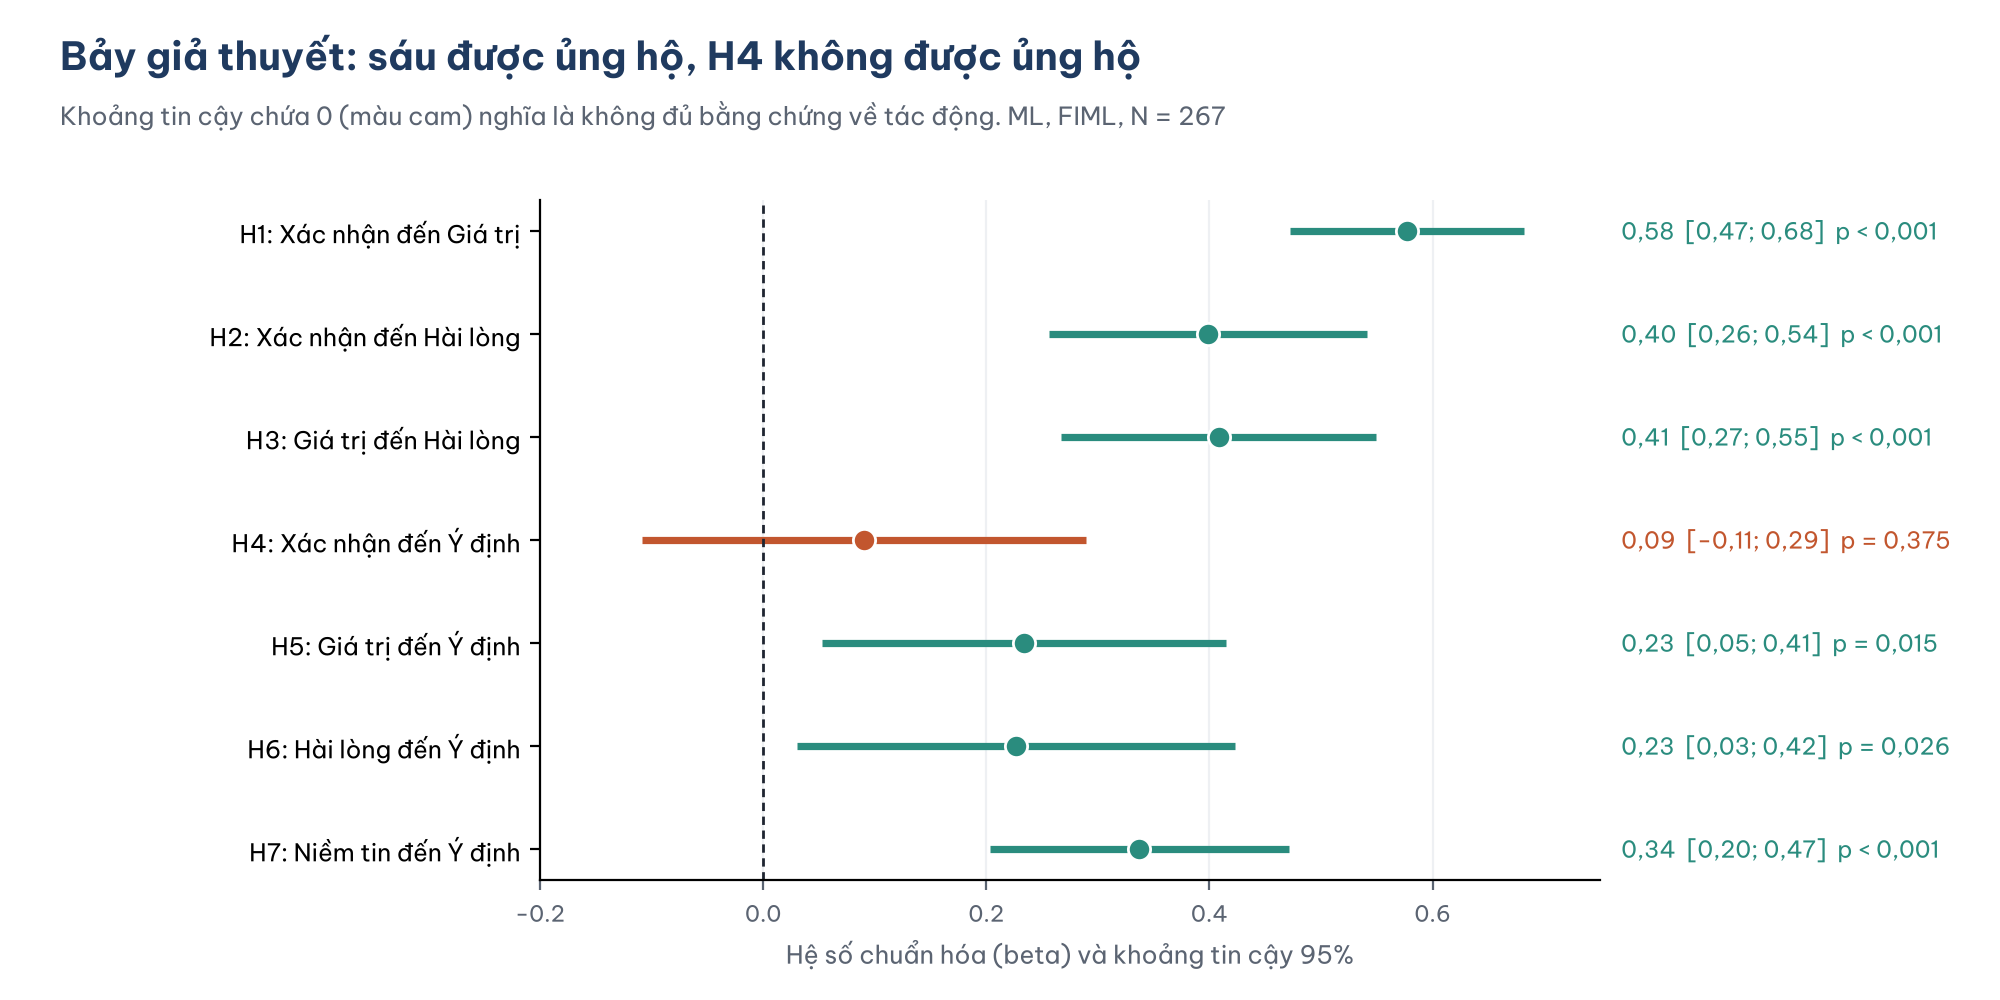
Hình 4. Hệ số chuẩn hóa và khoảng tin cậy 95% của bảy giả thuyết.
Bảng 2. Kết quả kiểm định bảy giả thuyết.
| Giả thuyết | Đường dẫn | B | S.E. | C.R. | p | beta [KTC 95%] | Kết luận |
|---|---|---|---|---|---|---|---|
| H1 | Xác nhận đến Giá trị | 0,627 | 0,087 | 7,22 | < 0,001 | 0,58 [0,47; 0,68] | Ủng hộ |
| H2 | Xác nhận đến Hài lòng | 0,412 | 0,085 | 4,87 | < 0,001 | 0,40 [0,26; 0,54] | Ủng hộ |
| H3 | Giá trị đến Hài lòng | 0,389 | 0,077 | 5,02 | < 0,001 | 0,41 [0,27; 0,55] | Ủng hộ |
| H4 | Xác nhận đến Ý định | 0,088 | 0,099 | 0,89 | 0,375 | 0,09 [−0,11; 0,29] | Không ủng hộ |
| H5 | Giá trị đến Ý định | 0,208 | 0,085 | 2,44 | 0,015 | 0,23 [0,05; 0,41] | Ủng hộ |
| H6 | Hài lòng đến Ý định | 0,212 | 0,095 | 2,23 | 0,026 | 0,23 [0,03; 0,42] | Ủng hộ |
| H7 | Niềm tin đến Ý định | 0,316 | 0,071 | 4,46 | < 0,001 | 0,34 [0,20; 0,47] | Ủng hộ |
ML, FIML, N = 267. B: hệ số chưa chuẩn hóa; beta: hệ số chuẩn hóa.
Đọc từng giả thuyết theo năm bước ở Hình 1, ví dụ H7:
- Đọc chiều. beta = 0,34 dương, đúng chiều giả thuyết (niềm tin cao hơn thì ý định mua lại cao hơn).
- Đọc ý nghĩa. C.R. = 4,46 > 1,96; p < 0,001; khoảng tin cậy [0,20; 0,47] không chứa 0.
- Đọc độ lớn. Khi niềm tin tăng một độ lệch chuẩn, ý định mua lại tăng 0,34 độ lệch chuẩn, giữ nguyên ba biến còn lại.
- So sánh. Hệ số lớn nhất trong bốn biến dự đoán ý định, nhưng chưa chắc lớn hơn có ý nghĩa (mục 6).
- Kết luận. H7 được ủng hộ.
Diễn giải H4 không được ủng hộ
H4 có p = 0,375 và khoảng tin cậy chứa 0. Cách viết đúng: "không có bằng chứng cho tác động trực tiếp của xác nhận kỳ vọng đến ý định mua lại khi đã tính đến giá trị cảm nhận, sự hài lòng và niềm tin". Không viết "xác nhận kỳ vọng không ảnh hưởng đến ý định mua lại", vì:
- Không có ý nghĩa thống kê không chứng minh tác động bằng 0 (bài T-test). Khoảng tin cậy cho thấy tác động thật có thể nằm trong khoảng −0,11 đến 0,29.
- Xác nhận kỳ vọng vẫn có tác động tổng đáng kể (0,37) qua giá trị cảm nhận và sự hài lòng (bài mô hình cấu trúc SEM). Kết quả này gợi ý tác động trung gian hoàn toàn, sẽ kiểm định ở bài biến trung gian trong SEM.
Dữ liệu mẫu được giả lập với tác động trực tiếp bằng 0 (bài AMOS và CB-SEM), nên kết quả không ủng hộ H4 ở đây khớp với thực tế của tổng thể giả lập.
4. Khoảng tin cậy và bootstrap
Giá trị p và khoảng tin cậy ở trên dựa trên giả định phân phối chuẩn của ước lượng. Bootstrap không cần giả định này: rút 2000 mẫu lặp có hoàn lại từ dữ liệu, ước lượng lại mô hình mỗi lần, rồi lấy phân vị 2,5% và 97,5% của các hệ số làm khoảng tin cậy (Kline, 2023) (Hình 5).
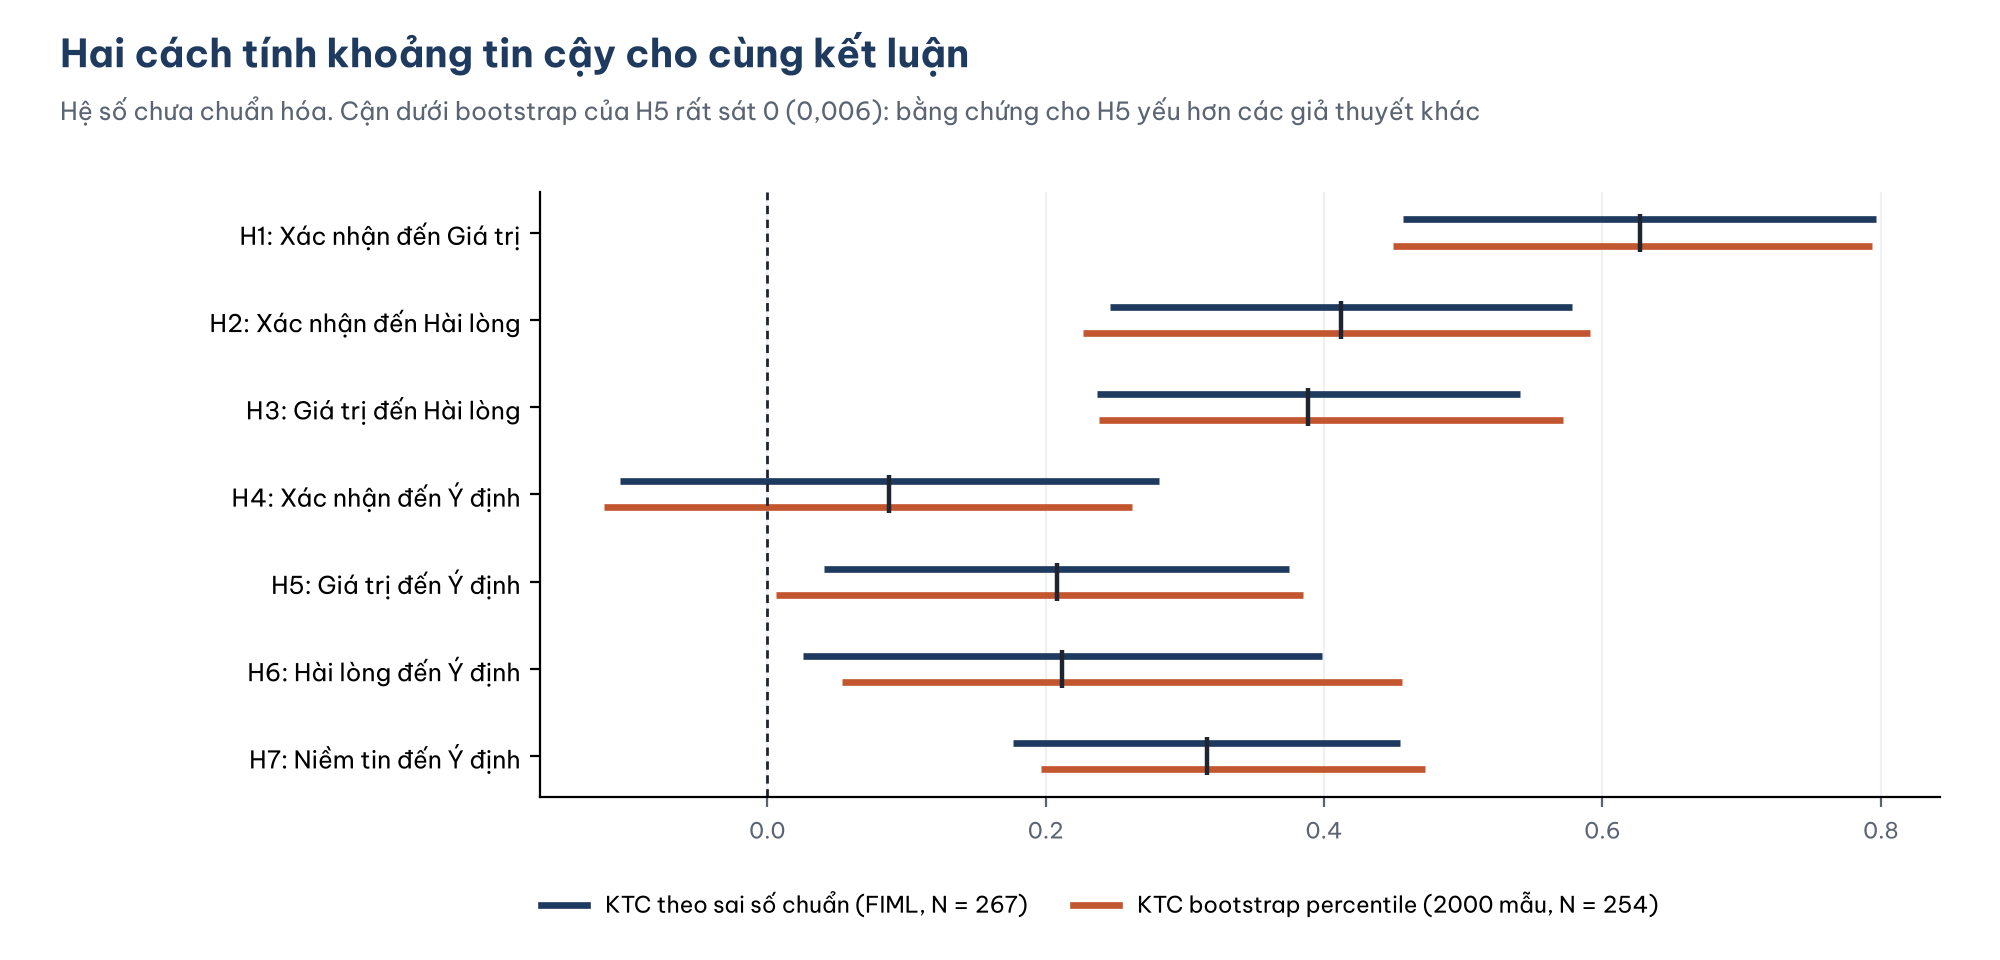
Hình 5. Khoảng tin cậy 95% của hệ số chưa chuẩn hóa: theo sai số chuẩn (FIML, 267 người) và bootstrap percentile (2000 mẫu, 254 người trả lời đủ).
Hai cách cho cùng kết luận ở cả bảy giả thuyết. Cận dưới bootstrap của H5 chỉ là 0,006, rất sát 0: bằng chứng cho tác động của giá trị cảm nhận đến ý định mua lại yếu hơn các giả thuyết khác và kết luận có thể thay đổi ở mẫu khác. Đây là thông tin đáng báo cáo mà riêng giá trị p = 0,015 không cho thấy.
Bootstrap đặc biệt nên dùng khi dữ liệu lệch chuẩn (hệ số Mardia vượt 5, bài phân tích nhân tố khẳng định (CFA)) hoặc khi kiểm định tác động gián tiếp (bài biến trung gian trong SEM).
5. Độ lớn tác động: f²
beta cho biết độ lớn của từng đường dẫn, nhưng không trực tiếp cho biết mỗi biến đóng góp bao nhiêu vào R². Hệ số f² (Cohen, 1988) đo mức R² giảm khi bỏ một đường dẫn:
f² = (R² đầy đủ − R² khi bỏ đường dẫn) / (1 − R² đầy đủ)
Ngưỡng của Cohen: 0,02 là nhỏ, 0,15 là trung bình, 0,35 là lớn. Mỗi lần bỏ một đường dẫn đến YDINH, chạy lại mô hình và ghi R² của YDINH (Hình 6, Bảng 3):
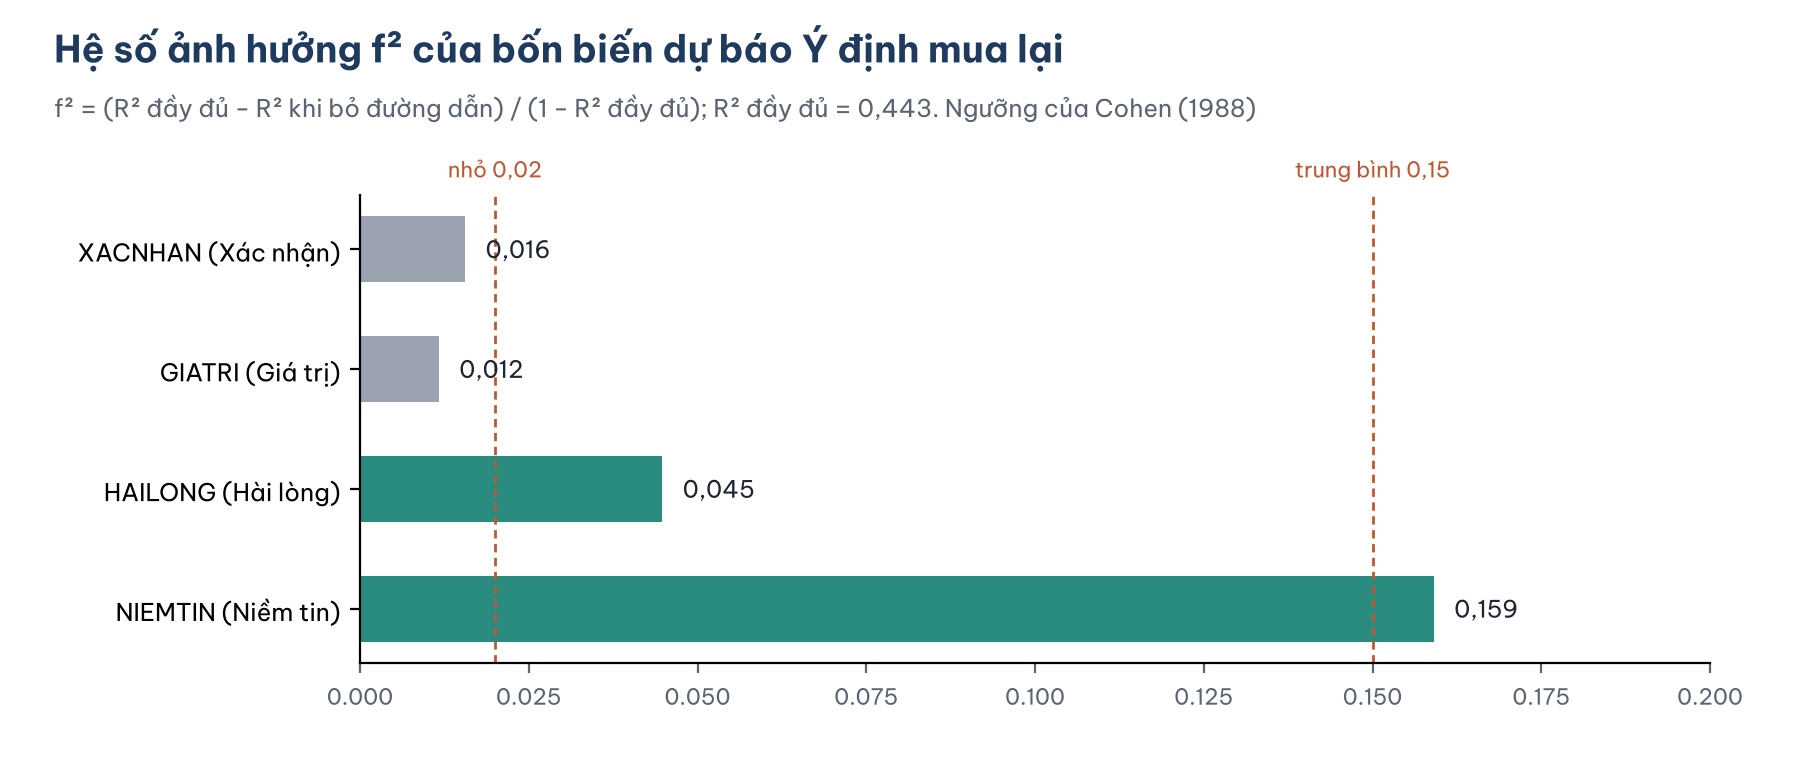
Hình 6. f² của bốn biến dự đoán Ý định mua lại.
Bảng 3. f² của bốn biến dự đoán Ý định mua lại.
| Biến dự đoán | R² của YDINH khi bỏ đường dẫn | f² | Mức |
|---|---|---|---|
| NIEMTIN | 0,355 | 0,159 | trung bình |
| HAILONG | 0,418 | 0,045 | nhỏ |
| XACNHAN | 0,435 | 0,016 | không đáng kể |
| GIATRI | 0,437 | 0,012 | không đáng kể |
R² đầy đủ của YDINH = 0,443.
Kết quả đáng chú ý: GIATRI có beta = 0,23 và có ý nghĩa, nhưng f² chỉ 0,012. Lý do là khi bỏ đường dẫn trực tiếp từ GIATRI đến YDINH, phần lớn tác động của GIATRI vẫn truyền qua HAILONG (GIATRI tác động đến HAILONG với beta = 0,41), nên R² của YDINH hầu như không giảm. f² đo đóng góp riêng của đường dẫn trực tiếp, không đo tầm quan trọng tổng thể của biến.
f² là chỉ số phổ biến trong PLS-SEM (Hair và cộng sự, 2022) và ít được dùng trong CB-SEM; AMOS và JASP không tính sẵn. File kiem_dinh_gia_thuyet.R tính tự động; trong AMOS, làm thủ công bằng cách xóa từng mũi tên, chạy lại và đọc Squared Multiple Correlations.
6. So sánh hai hệ số: đừng so bằng mắt
NIEMTIN có beta = 0,34, HAILONG có beta = 0,23. Có thể kết luận "niềm tin quan trọng hơn sự hài lòng trong việc dự đoán ý định mua lại" không? Chỉ khi hiệu giữa hai hệ số có ý nghĩa. Hai khoảng tin cậy [0,20; 0,47] và [0,03; 0,42] chồng lấn nhiều, gợi ý câu trả lời là không.
Trong JASP, dòng hieu_NT_HL := h7 - h6 đã thêm ở mục 2 tạo tham số định nghĩa bằng hiệu hai hệ số. JASP in kiểm định z cho tham số này (Hình 7):
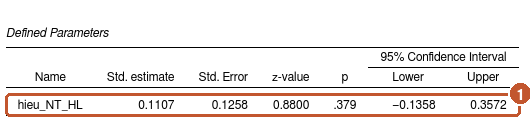
Hình 7. (1) Hiệu giữa hệ số của Niềm tin và Sự hài lòng đến Ý định mua lại.
Với Standardization = All, JASP in hiệu của hai beta và kiểm định của nó; với None, hiệu của hai B. Hai cách cho cùng kết luận ở đây (Bảng 4).
Bảng 4. Kiểm định hiệu hai hệ số của Niềm tin và Sự hài lòng.
| Hiệu | S.E. | z | p | KTC 95% | |
|---|---|---|---|---|---|
| beta(NIEMTIN) − beta(HAILONG) | 0,111 | 0,126 | 0,88 | 0,379 | [−0,14; 0,36] |
| B(NIEMTIN) − B(HAILONG) | 0,104 | 0,119 | 0,87 | 0,384 | [−0,13; 0,34] |
Hiệu không có ý nghĩa. Kết luận đúng: niềm tin và sự hài lòng đều tác động có ý nghĩa đến ý định mua lại và không có bằng chứng rằng tác động của niềm tin mạnh hơn. Viết "niềm tin là yếu tố quan trọng nhất" chỉ dựa trên việc 0,34 lớn hơn 0,23 là một lỗi rất phổ biến (Gelman & Stern, 2006).
Trong AMOS, kiểm định hiệu hai hệ số bằng một trong hai cách:
- Critical ratios for differences. Đặt nhãn cho mọi tham số (Plugins > Name Parameters), đánh dấu Critical ratios for differences trong Analysis Properties > Output. Mục Pairwise Parameter Comparisons trong Text Output in ma trận tỷ số tới hạn cho hiệu của mọi cặp tham số; tìm ô giao giữa h6 và h7. Trị tuyệt đối lớn hơn 1,96 nghĩa là hai hệ số khác nhau có ý nghĩa ở mức 0,05.
- So sánh mô hình. Ở bảng Models (bên trái cửa sổ), bấm đúp Default model, thêm mô hình mới với ràng buộc
h6 = h7. Mục Model Comparison in hiệu chi bình phương.
Cả hai cách so sánh hệ số chưa chuẩn hóa. Vì NIEMTIN và HAILONG có thang đo tương tự (Likert năm mức, hệ số tải đầu tiên cố định bằng 1), so sánh này có ý nghĩa; với các biến có đơn vị khác nhau, cần thận trọng.
7. Trình bày kết quả
Bảng ở mục 3 là định dạng nên dùng: giả thuyết, đường dẫn, B, S.E., C.R., p, beta và kết luận. Thêm khoảng tin cậy nếu có. Đoạn văn mẫu:
Kết quả mô hình cấu trúc ủng hộ sáu trong bảy giả thuyết. Xác nhận kỳ vọng tác động cùng chiều đến giá trị cảm nhận (H1: beta = 0,58; p < 0,001) và sự hài lòng (H2: beta = 0,40; p < 0,001); giá trị cảm nhận tác động đến sự hài lòng (H3: beta = 0,41; p < 0,001). Ý định mua lại chịu tác động của niềm tin (H7: beta = 0,34; p < 0,001), giá trị cảm nhận (H5: beta = 0,23; p = 0,015) và sự hài lòng (H6: beta = 0,23; p = 0,026). Không có bằng chứng cho tác động trực tiếp của xác nhận kỳ vọng đến ý định mua lại (H4: beta = 0,09; p = 0,375; KTC 95% [−0,11; 0,29]). Khoảng tin cậy bootstrap (2000 mẫu) cho cùng kết luận, dù cận dưới của H5 rất sát 0. Hiệu giữa tác động của niềm tin và sự hài lòng đến ý định mua lại không có ý nghĩa (hiệu beta = 0,11; p = 0,379).
Năm lỗi thường gặp
Các lỗi dưới đây hay gặp khi kiểm định và viết kết luận cho giả thuyết trong SEM.
- Viết "chứng minh" hay "khẳng định" giả thuyết. Dữ liệu cắt ngang chỉ cho phép nói giả thuyết được ủng hộ hoặc không được ủng hộ.
- Diễn giải H4 là "không ảnh hưởng" và bỏ qua tác động gián tiếp.
- So sánh hệ số bằng mắt để xếp hạng "yếu tố quan trọng nhất".
- Dùng hệ số chuẩn hóa để kiểm định ý nghĩa. Kiểm định dựa trên B và S.E.; beta để so sánh độ lớn.
- Diễn giải nhân quả từ dữ liệu khảo sát một thời điểm. Đường dẫn trong SEM thể hiện quan hệ theo giả thuyết; tính nhân quả đến từ lý thuyết và thiết kế nghiên cứu, không từ phần mềm.
Tài liệu tham khảo
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysisfor-the-Behavioral-Sciences/Cohen/p/book/9780805802832
Gelman, A., & Stern, H. (2006). The difference between "significant" and "not significant" is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006X152649
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE Publications. https://collegepublishing.sagepub.com/products/a-primer-on-partial-least-squares-structural-equation-modeling-pls-sem-3-270548
IBM Corp. (2026). IBM SPSS Amos (Version 32) [Computer software]. IBM Corp. https://www.ibm.com/products/structural-equation-modeling-sem
JASP Team. (2026). JASP (Version 0.99.0) [Computer software]. https://jasp-stats.org/
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02